
Together AI, Fireworks AI et Groq vendent tous le même argument : pointez votre client OpenAI existant vers une nouvelle URL de base, échangez la clé, et obtenez des modèles à poids ouverts pour une fraction du coût. Cet argument est vrai. Ce qui est faux, c’est que comparer leurs niveaux gratuits soit aussi simple que d’aligner trois nombres côte à côte, car deux des trois fournisseurs ne publient pas de nombre fixe du tout.
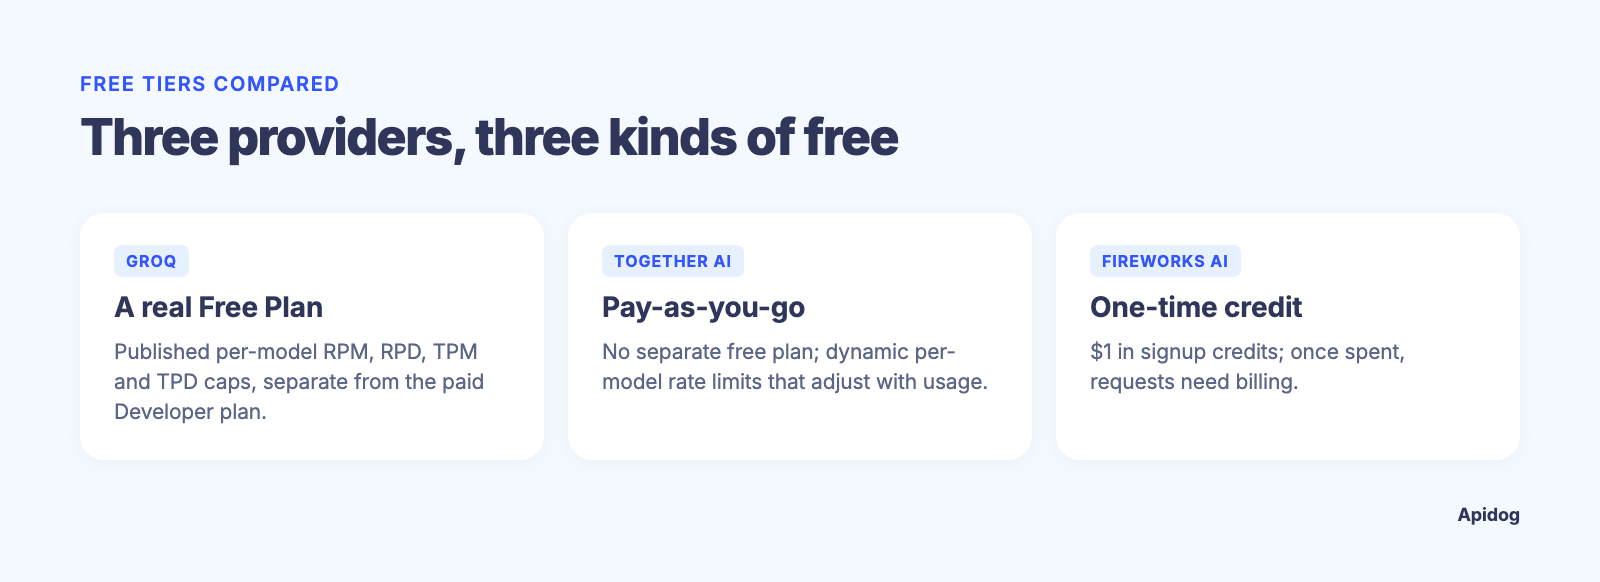
Groq est l’exception : sa page sur les limites de débit publie réellement de vrais chiffres pour le plan gratuit, par modèle, dans un onglet que la plupart des lecteurs parcourent rapidement en route vers l’onglet Developer Plan juste à côté. Together AI nous a clairement dit, dans sa propre documentation, qu’il n’a aucune limite fixe par modèle à publier ; votre plafond évolue en fonction de votre utilisation. Fireworks AI lie son accès gratuit à un solde de crédit unique plutôt qu’à un niveau de forfait. Trois conceptions différentes, et un article « quel niveau gratuit est le plus grand » ne peut toujours pas réduire cela à un seul nombre.
TL;DR
Groq, Together AI et Fireworks AI exposent tous un point de terminaison compatible OpenAI, donc passer de l’un à l’autre se résume à une URL de base et une clé API, pas à une réécriture. Groq divise l’accès en un plan gratuit et un plan Developer payant, et contrairement aux deux autres, il publie de vrais chiffres pour le plan gratuit par modèle, comme 30 RPM / 1K RPD / 8K TPM / 200K TPD sur gpt-oss-120b et gpt-oss-20b. Together AI ne publie pas de chiffres fixes pour le niveau gratuit ; sa documentation indique que les limites évoluent dynamiquement avec votre capacité en direct et votre utilisation récente réussie. Fireworks AI donne aux nouveaux comptes un solde de crédit unique (1 $, selon sa page de tarification) plutôt qu’une allocation gratuite récurrente. La décision qui compte plus que le chiffre principal est quels modèles vous avez réellement besoin et comment le plafond de chaque fournisseur se comporte une fois que vous l’atteignez. Apidog vous permet d’enregistrer une requête et d’échanger l’URL de base et la clé par environnement, afin que vous puissiez mesurer les trois vous-même au lieu de faire confiance à un tableau.
Une seule forme d’API, trois clés
Les trois fournisseurs reproduisent délibérément le schéma OpenAI Chat Completions. C’est pourquoi les guides de migration pour ces outils se lisent de la même manière à chaque fois : changez base_url, changez l’en-tête Authorization, conservez le reste de votre code. La base compatible OpenAI de Groq est https://api.groq.com/openai/v1/. Celle de Together AI est https://api.together.ai/v1, confirmée directement dans sa documentation de démarrage rapide. Celle de Fireworks AI est https://api.fireworks.ai/inference/v1, selon son guide de compatibilité OpenAI.
Cette forme partagée est pourquoi un test comparatif vaut la peine : ajouter un quatrième ou cinquième fournisseur coûte quelques minutes, pas une refonte. Nous couvrons la mécanique de gestion de ce type de configuration multi-fournisseurs dans comment gérer les URL de base entre environnements dans Apidog, et si vous évaluez les options de routage plus largement, notre tour d’horizon des alternatives à OpenRouter couvre où chacun de ces trois s’inscrit dans ce tableau.
Ce que vous pouvez réellement vérifier sur chaque niveau gratuit
Voici la comparaison construite uniquement à partir de ce que chaque fournisseur déclare publiquement en septembre 2026. Lorsqu’un fournisseur ne divulgue pas de nombre, le tableau le dit au lieu de deviner.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Modèle d’accès gratuit | Plan gratuit (séparé du plan Developer payant) | Paiement à l’usage dès l’inscription ; pas de nom « plan gratuit » distinct | Crédit d’inscription unique |
| Allocation gratuite documentée | Publié par modèle : gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD ; compound 30 RPM, 250 RPD, 70K TPM (selon les limites de débit de Groq, consulté le 2026-09-15) |
Non publié sous forme de nombres fixes ; décrit comme dynamique par organisation | 1 $ de crédits gratuits selon la tarification de Fireworks |
| Comment les limites sont façonnées | Plafonds RPM/RPD/TPM/TPD par modèle, appliqués au niveau de l’organisation | Débit dynamique par modèle, s’ajuste selon votre capacité en direct et votre utilisation récente réussie | Basé sur les dépenses ; une fois le crédit utilisé, les requêtes nécessitent l’activation de la facturation |
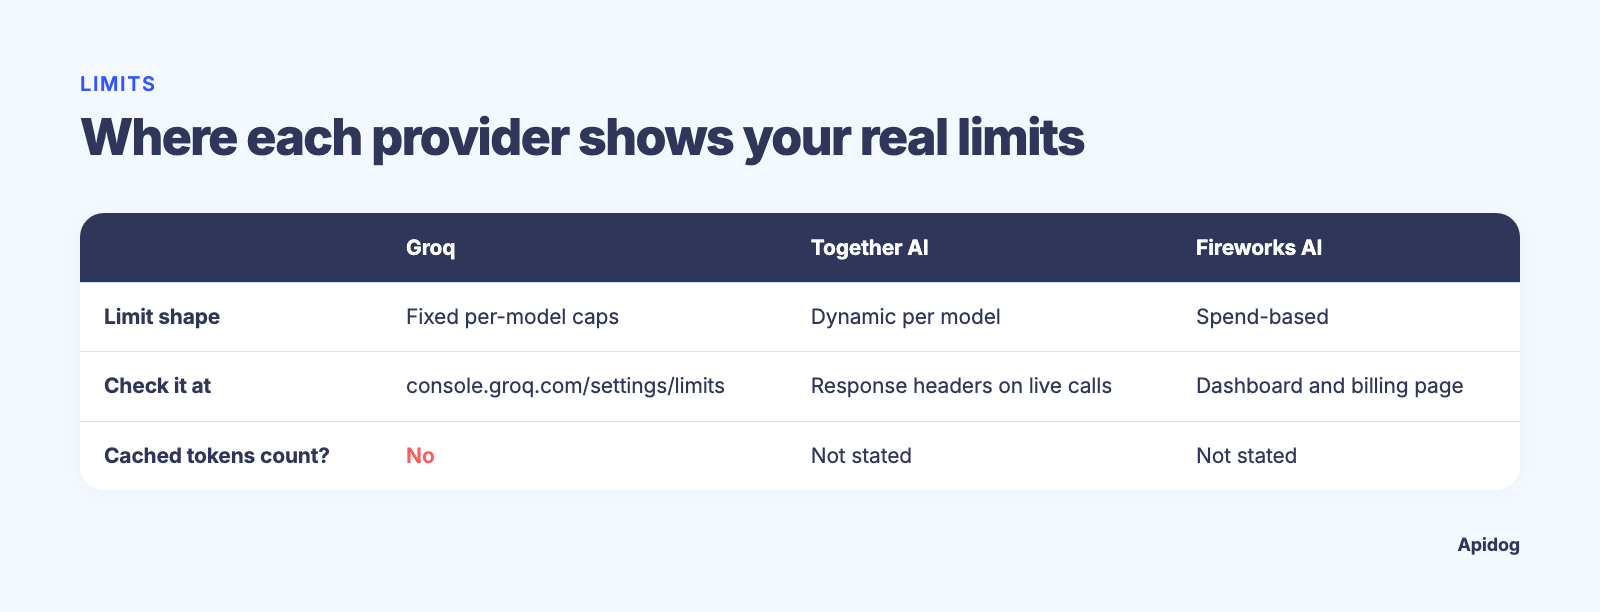
| Où vérifier vos propres chiffres | console.groq.com/settings/limits |
En-têtes de réponse sur les appels en direct, par ex. x-ratelimit-reset |
Tableau de bord du compte et page de facturation |
| Les jetons mis en cache comptent-ils dans les limites ? | Non, selon la propre documentation de Groq | Non indiqué dans les pages que nous avons consultées | Non indiqué dans les pages que nous avons consultées |
Deux choses ressortent lorsque vous lisez réellement les pages sources au lieu d’un résumé de fiche technique. Premièrement, les chiffres du plan gratuit de Groq ci-dessus sont des valeurs par défaut publiées ; la même page comporte également un onglet Developer Plan avec des plafonds plus élevés, et console.groq.com/settings/limits fait autorité si les vôtres diffèrent. Deuxièmement, la limitation de débit de Together AI n’est pas du tout un tableau. Sa propre page sur les limites de débit indique clairement qu’« il n’existe aucune limite fixe par modèle publiée », et que votre plafond augmente avec un « trafic soutenu et réussi ». C’est un modèle sensiblement différent d’une ligne statique de niveau gratuit, et cela signifie que la réponse honnête à « quel est le RPM gratuit de Together » est « vérifiez vos en-têtes de réponse », et non un nombre tiré d’un tableau.
Si vous souhaitez les analyses approfondies par fournisseur avec des chiffres vérifiables pour un produit à la fois, consultez nos articles complémentaires sur le niveau gratuit de l’API Groq et le niveau gratuit de l’API Cerebras. Cet article est le hub ; ces deux-là font le travail d’exploration par fournisseur en entier.
Requêtes vs jetons, fixe vs dynamique
La véritable différence de conception entre ces trois n’est pas la taille de l’allocation gratuite, c’est la forme du plafond.
Le modèle de Groq est celui que la plupart des développeurs connaissent déjà pour avoir travaillé avec des limites de débit ailleurs : un plafond fixe par fenêtre de temps, divisé en RPM, RPD, TPM et TPD, et il s’applique au niveau de l’organisation plutôt que par clé API. Cela signifie que si vous créez trois clés pour trois services sous un même compte Groq, elles partagent un seul pool. Notre guide général sur les limites de débit de l’API GPT couvre cette même structure RPM/TPM plus en profondeur si vous n’avez jamais travaillé avec des plafonds basés sur les jetons.
Le modèle de Together AI récompense un trafic régulier et réussi au lieu de punir le trafic en rafale avec un mur rigide. Un compte calme et un compte lourd mais bien comporté n’obtiennent pas le même plafond, car le plafond s’ajuste à l’historique récent de votre compte et à la capacité en direct du modèle à ce moment-là. C’est une bonne nouvelle si votre charge de travail est fiable, et une véritable inconnue si votre trafic est de nature irrégulière.
Fireworks AI contourne presque entièrement la conception des limites de débit pour les nouveaux utilisateurs en liant la période gratuite à un solde en dollars plutôt qu’à une fenêtre de débit de requêtes. Vous n’êtes pas plafonné par la vitesse à laquelle vous appelez l’API ; vous êtes plafonné par le coût de vos appels avant que le solde ne s’épuise. Cela fait passer la question de planification de « combien de requêtes par minute » à « combien de jetons 1 $ peut-il acheter au prix par jeton de ce modèle », ce qui dépend entièrement du modèle que vous choisissez.
Ce sont différents paris sur le type d’utilisation contre lequel un niveau « gratuit » devrait protéger : volume soutenu, pics soudains ou dépense totale. Quel que soit celui contre lequel vous construisez, vous finirez par atteindre un 429, et la façon dont un fournisseur signale ce moment compte autant que le nombre qui l’a déclenché. Notre guide de dépannage en cas de dépassement de limite de débit explique comment lire ces en-têtes de réponse et construire une logique de nouvelle tentative qui n’aggrave pas le problème.
Prouvez-le vous-même en cinq minutes
Étant donné qu’une grande partie de ces données se trouve derrière un écran de connexion ou un en-tête de réponse en direct, le chemin le plus rapide vers une réponse réelle n’est pas un autre article de fiche technique, c’est un test que votre agent de codage exécute contre les trois. Avec Apidog CLI, c’est une seule invite. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Le jeton provient d’Apidog sous Account Settings, API Access Token. Ensuite, donnez à l’agent une invite :
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Les commandes qu’il exécute, vérifiées par rapport à Apidog CLI 2.2.7 :
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Changer de fournisseur n’est plus qu’un ID d’environnement, pas une réécriture. Les en-têtes sont l’endroit où le plafond dynamique de Together AI apparaît en temps réel et où vous pouvez confirmer que votre organisation Groq correspond au tableau publié du plan gratuit. Gardez aussi la latence dans la comparaison : un modèle techniquement gratuit mais lent n’est pas réellement moins cher une fois que vous comptez le temps passé à le contourner. Cela transforme trois pages marketing en un seul ensemble de données comparable depuis votre propre compte. Vous exécutez la comparaison en continu dans une construction d’agent plus large ? Notre guide sur les outils de test d’API pour les agents IA couvre cela, et Apidog CLI dans Cursor montre la configuration de l’agent.
Quel niveau gratuit correspond à votre cas d’usage
En se basant uniquement sur ce qui est vérifiable aujourd’hui, quelques recommandations honnêtes :
- Des plafonds par modèle prévisibles que vous pouvez lire sans vous connecter : Groq publie de vrais chiffres pour le plan gratuit (30 RPM / 1K RPD / 8K TPM / 200K TPD sur les modèles
gpt-oss), et sa fenêtre de contexte de 131 072 jetons surllama-3.1-8b-instant,llama-3.3-70b-versatileet les modèlesopenai/gpt-osscouvre un large éventail de charges de travail à poids ouverts sur un seul point de terminaison. - Un trafic régulier et bien comporté, sans intérêt à suivre les limites de débit : Le modèle dynamique de Together AI correspond à ce schéma ; une utilisation réussie soutenue augmente votre propre plafond au fil du temps au lieu de vous plafonner à un nombre fixé le premier jour.
- Aucune friction de configuration, à l’aise avec l’idée d’atteindre un mur de dépenses : L’accès gratuit basé sur le crédit de Fireworks AI teste le prix réel par jeton dès le premier appel, utile lorsque la vraie question est le coût à l’échelle plutôt que le nombre de requêtes.
Les trois hébergent différents sous-ensembles de modèles à poids ouverts, et un modèle qui convient à votre tâche chez un fournisseur pourrait ne pas exister chez un autre.
FAQ
Together AI, Fireworks AI et Groq utilisent-ils tous le SDK OpenAI ? Oui. Les trois documentent des points de terminaison compatibles OpenAI, donc la bibliothèque client standard openai fonctionne avec n’importe lequel d’entre eux une fois que vous changez l’URL de base et la clé.
Quel fournisseur a le plus grand niveau gratuit ? Pas d’une manière que vous pouvez comparer directement. Groq publie de vrais chiffres pour le plan gratuit par modèle (30 RPM / 1K RPD / 8K TPM / 200K TPD sur gpt-oss-120b/gpt-oss-20b), Together AI ne fixe aucun nombre du tout, et Fireworks AI lie l’accès gratuit à un solde de crédit unique plutôt qu’à une allocation. Vérifiez console.groq.com/settings/limits si les vôtres diffèrent.
Les limites de débit s’appliquent-elles par clé API ou par compte ? Pour Groq, les limites s’appliquent au niveau de l’organisation, donc plusieurs clés sous un même compte partagent le même pool, selon sa propre documentation sur les limites de débit. Together AI et Fireworks AI ne le précisent pas explicitement dans les pages que nous avons consultées ; vérifiez dans votre propre tableau de bord avant de supposer le contraire.
Que se passe-t-il lorsque j’atteins une limite de débit chez l’un de ces fournisseurs ? Vous obtiendrez une réponse HTTP 429. Les détails diffèrent ; consultez notre guide de dépassement de limite de débit pour savoir comment lire les en-têtes de nouvelle tentative que renvoient la plupart des API compatibles OpenAI, et construire une logique de backoff au lieu de deviner.
Existe-t-il un moyen plus rapide de les comparer que de lire chaque page de documentation moi-même ? Demandez à votre agent de codage d’exécuter un cas de test Apidog CLI contre trois environnements, comme décrit ci-dessus. Vingt minutes avec Apidog CLI vous en diront plus sur votre charge de travail réelle que n’importe quel tableau comparatif, y compris celui-ci.