
Pour exécuter Qwen 3.8 27B en local, installez Ollama et lancez ollama pull qwen3.8:27b, puis ollama run qwen3.8:27b. La version par défaut est un téléchargement 4 bits de 18 Go, donc prévoyez un GPU avec 24 Go de VRAM ou un Mac avec 32 Go de mémoire unifiée. Les poids sont sous licence Apache-2.0, donc le modèle lui-même ne coûte rien. Votre seul budget, c'est le matériel et l'électricité.
C'est la version courte. Le reste de ce guide couvre les quatre runners qui valent le coup (Ollama, LM Studio, llama.cpp et MLX), la mémoire requise par chaque quantification, les débits attendus sur du matériel réel, et comment faire tester le point de terminaison local par votre agent de code avec Apidog CLI une fois qu'il est opérationnel.
Nouveau dans la famille ? Ce qu'est Qwen 3.8 présente le fleuron Max de 2,4 T de paramètres. Ce guide porte sur son petit frère dense qui tient sur votre bureau.
Qu'est-ce que Qwen 3.8 27B ?
Qwen 3.8 27B est un modèle vision-langage dense de 27 milliards de paramètres de l'équipe Qwen d'Alibaba, publié en août 2026 sous licence Apache-2.0. Il lit le texte, les images et la vidéo, réfléchit avant de répondre par défaut, et offre une fenêtre de contexte native de 262 144 tokens extensible jusqu'à 1 million de tokens avec le scaling YaRN.
La fiche officielle du modèle liste ces spécifications :
| Spécification | Qwen 3.8 27B |
|---|---|
| Paramètres | 27B dense (le Hub en liste 28B en incluant l'encodeur de vision) |
| Couches | 64, un hybride de blocs Gated DeltaNet et Gated Attention |
| Contexte | 262 144 natif, jusqu'à 1 000 000 avec YaRN |
| Entrées | Texte, image, vidéo |
| Réflexion | Activée par défaut, reasoning_effort à xhigh, medium ou low |
| Extras | Couches de prédiction multi-tokens (MTP) |
| Licence | Apache-2.0 |
Sur la table de référence de Qwen elle-même, il obtient 61,7 sur SWE-bench Pro, 73,0 sur Terminal Bench 2.1 et 89,2 sur GPQA Diamond. Ce sont des chiffres du fournisseur. Notre analyse des benchmarks de Qwen 3.8 explique comment lire ce tableau, y compris quelles lignes Qwen a construites en interne.
Pourquoi c'est important en local : un modèle dense de 27B en 4 bits tient sur un seul GPU grand public, avec l'appel d'outils, la vision et la réflexion dans le même fichier.
Quelle quantité de RAM et de VRAM faut-il pour Qwen 3.8 27B ?
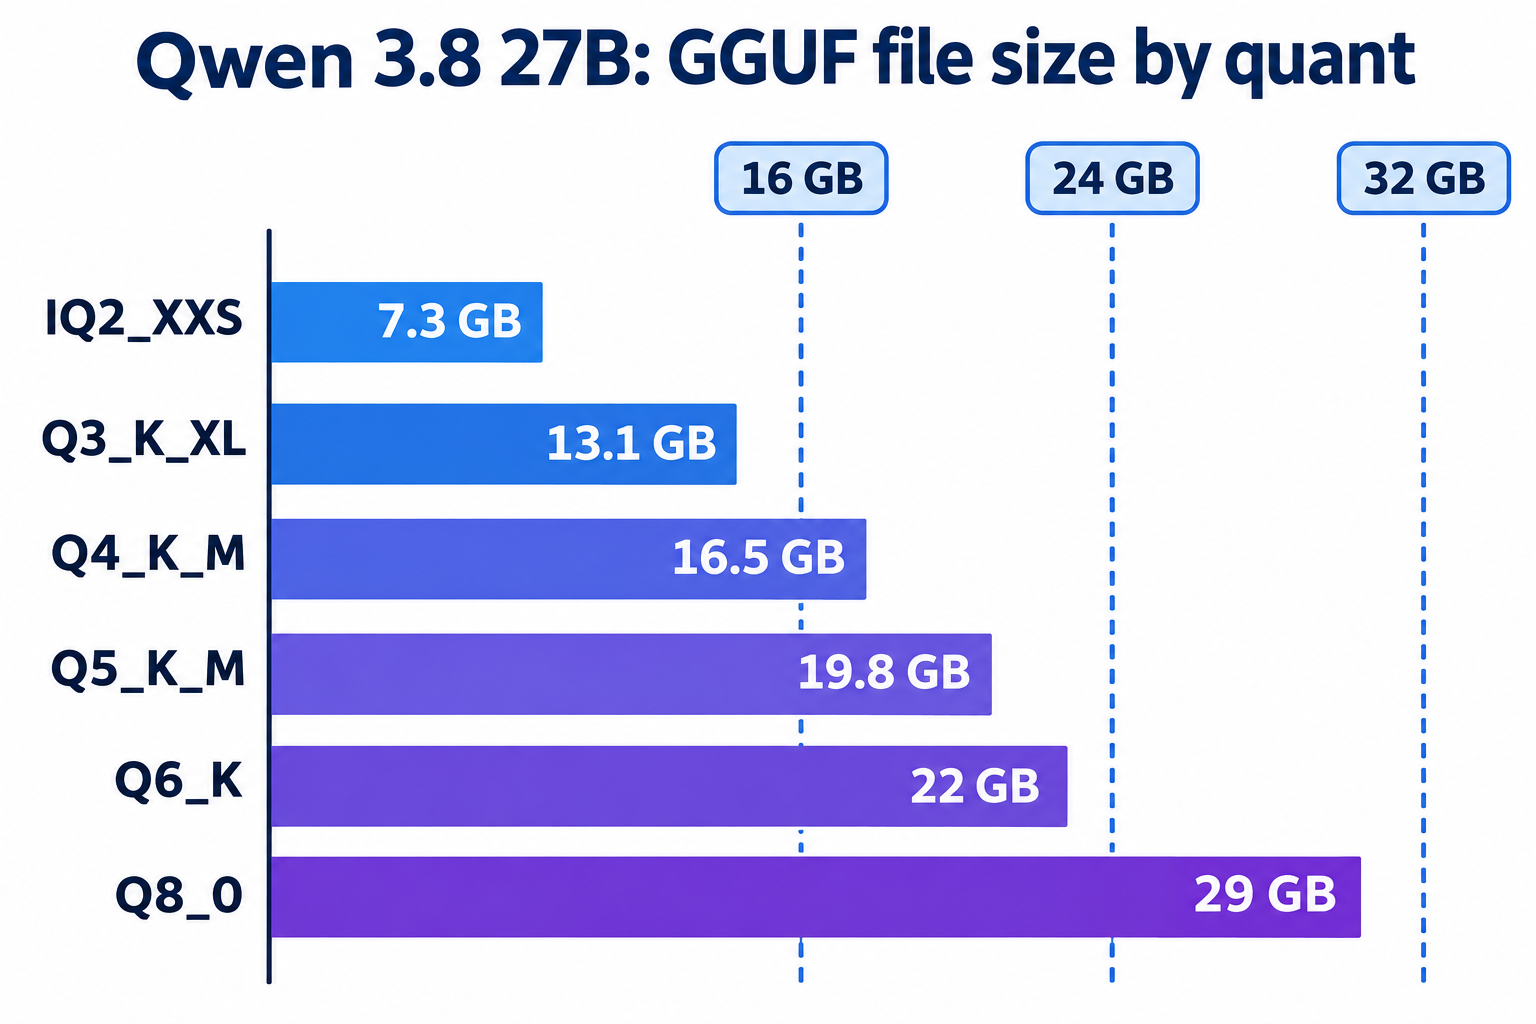
Prévoyez la taille du fichier de votre quantification plus 3 à 6 Go pour le cache KV et le runtime. Pour le Q4_K_M par défaut, cela signifie 24 Go de VRAM sur un GPU ou un Mac de 32 Go.
Voici les tailles des fichiers GGUF du dépôt de quantifications d'unsloth, vérifiées le 9 novembre 2026 :
| Quantification | Taille du fichier | Matériel réaliste |
|---|---|---|
| UD-IQ2_XXS | 7,27 Go | Mac 16 Go ou GPU 12 Go, perte de qualité noticeable |
| UD-Q3_K_XL | 13,1 Go | GPU 16 Go, Mac 24 Go |
| UD-Q4_K_M | 16,5 Go | GPU 24 Go, Mac 32 Go (le point optimal) |
| UD-Q5_K_M | 19,8 Go | GPU 24 Go avec un contexte court, Mac 32 Go |
| UD-Q6_K | 22 Go | GPU 32 Go, Mac 48 Go |
| Q8_0 | 29 Go | GPU 48 Go, Mac 64 Go |
Le projecteur de vision (mmproj-F16.gguf) ajoute 928 Mo si vous voulez l'entrée d'images. Le tag par défaut qwen3.8:27b d'Ollama fait 18 Go car il inclut la vision.
La longueur de contexte est le coût caché. Le calcul de dimensionnement de llm-speed place Q4_K_M à environ 21,9 Go avec un contexte de 32 000 tokens. C'est pourquoi les cartes de 24 Go sont le plancher pratique pour le Q4, et pourquoi vous ne devriez pas charger la fenêtre complète de 262K sauf si vous avez de la mémoire à gaspiller.
Sur Mac, rappelez-vous que macOS réserve une partie de la mémoire unifiée pour le système. Un Mac de 24 Go peut techniquement charger Q4_K_M, mais il restera peu de place pour le contexte ou votre navigateur. Nous choisirions Q3_K_XL là.
Quelle est la vitesse de Qwen 3.8 27B en local ?
Attendez-vous à environ 38 à 44 tokens par seconde sur une RTX 3090 ou 4090 en Q4_K_M avec llama.cpp, et 65 à 75 sur une RTX 5090. Un Mac Studio avec M3 Ultra décode à environ 25 à 27 tokens par seconde.
Nous n'avons pas fait ces benchmarks nous-mêmes. Ce sont des exécutions mesurées publiées par llm-speed, avec le matériel et le runtime qu'ils indiquent :
| Matériel | Quantification / runtime | Décodage tok/s | Pré-remplissage tok/s |
|---|---|---|---|
| RTX 3090 24 Go | Q4_K_M, llama.cpp | 38,6 (chat court, 4K ctx) | 482 |
| RTX 4090 24 Go | Q4_K_M, llama.cpp | 43,4 (chat court, 4K ctx) | 448 |
| RTX 5090 32 Go | Q4_K_M, llama.cpp | 75,2 (chat court, 4K ctx) | 563 |
| L40S 45 Go | Q4_K_M, llama.cpp | 34,3 (chat court) | 569 |
| M3 Ultra 96 Go | Q4_K_M, llama.cpp | 25,2 (chat court) | 45 |
| M3 Ultra 96 Go | 4 bits, MLX 0.31.3 | 27,3 (chat court) | 12 |
La vitesse de décodage baisse à peine avec le contexte sur GPU : le 4090 faisait encore 39,0 tok/s après un prompt de 33 133 tokens. Le pré-remplissage est là où les Macs décrochent. Sur un prompt de 11 827 tokens, le M3 Ultra a traité environ 283 tok/s, contre environ 2 000 à 3 000 sur le 4090, donc une grande base de code signifie des dizaines de secondes avant le premier token.
La réflexion mange aussi votre budget temps. Quand Simon Willison a demandé à un Qwen 3.8 27B local d'identifier des jeux à partir de poids de modèles bruts, une réponse a pris 46 minutes et 43 506 tokens de raisonnement. Pour les tâches quotidiennes, abaissez reasoning_effort à low ou désactivez la réflexion.
Exécuter Qwen 3.8 27B avec Ollama
Ollama est le chemin le plus rapide sur n'importe quel OS. Installez-le depuis ollama.com, puis :
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Sur Apple Silicon, essayez le tag qwen3.8:27b-mlx, qui utilise le backend MLX à la même taille de 18 Go.
Le contexte par défaut d'Ollama est petit, ce qui casse les longues sessions d'agent. Augmentez-le avant de démarrer le serveur :
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama expose aussi une API compatible OpenAI sur http://localhost:11434/v1, donc tout SDK OpenAI fonctionne en changeant l'URL de base :
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Vous le voulez dans un agent de code ? Ollama fournit des raccourcis de lancement : ollama launch claude --model qwen3.8 démarre Claude Code sur le modèle local, et ollama launch opencode --model qwen3.8 fait la même chose pour OpenCode.
L'exécuter avec LM Studio
LM Studio est le choix si vous voulez une interface graphique et des paramètres de chargement par modèle. Cherchez Qwen 3.8 27B, téléchargez la version lmstudio-community/Qwen3.8-27B-GGUF en Q4_K_M (16,8 Go) et chargez-la.
Un paramètre compte : augmentez la longueur de contexte au chargement du modèle. Simon Willison a constaté que le contexte par défaut de 8 192 tokens échouait avec des erreurs sur son long prompt et a dû charger une fenêtre plus grande.
Ouvrez ensuite l'onglet Développeur et démarrez le serveur local, ou lancez lms server start depuis un terminal. Le point de terminaison compatible OpenAI se trouve sur http://localhost:1234/v1.
L'exécuter avec llama.cpp
llama.cpp vous donne le plus de contrôle et alimente la plupart des benchmarks ci-dessus. Sur macOS ou Linux :
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf télécharge la quantification directement depuis Hugging Face, --jinja applique le modèle de chat du modèle (nécessaire pour les appels d'outils et la réflexion), -c définit le contexte et -ngl 99 place toutes les couches sur le GPU. Les valeurs d'échantillonnage sont les recommandations de Qwen pour le mode réflexion. Pour le mode sans réflexion, la fiche du modèle suggère une température de 0,7, top_p 0,8, top_k 20 et presence_penalty 1,5.
Pour désactiver la réflexion pour une requête, envoyez "chat_template_kwargs": {"enable_thinking": false} dans le corps.
L'exécuter avec MLX sur un Mac
MLX est le framework de tableaux d'Apple et est généralement le runtime le plus rapide sur Apple Silicon pour le décodage. Installez mlx-lm et utilisez la conversion 4 bits de mlx-community :
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server expose une route /v1/chat/completions compatible OpenAI. L'organisation mlx-community publie aussi des variantes 8 bits, mxfp4 et MTP si vous voulez échanger de la mémoire contre de la qualité ou de la vitesse.
Faire tester le point de terminaison local par votre agent de code avec Apidog CLI
Chaque runner sert la même structure compatible OpenAI, mais chacun gère les blocs de réflexion, les appels d'outils et les timeouts différemment. Avant de pointer une application vers localhost, faites construire à votre agent de code un test reproductible avec Apidog CLI, pour qu'un template cassé ou une limite de contexte apparaisse en secondes, pas en pleine tâche.
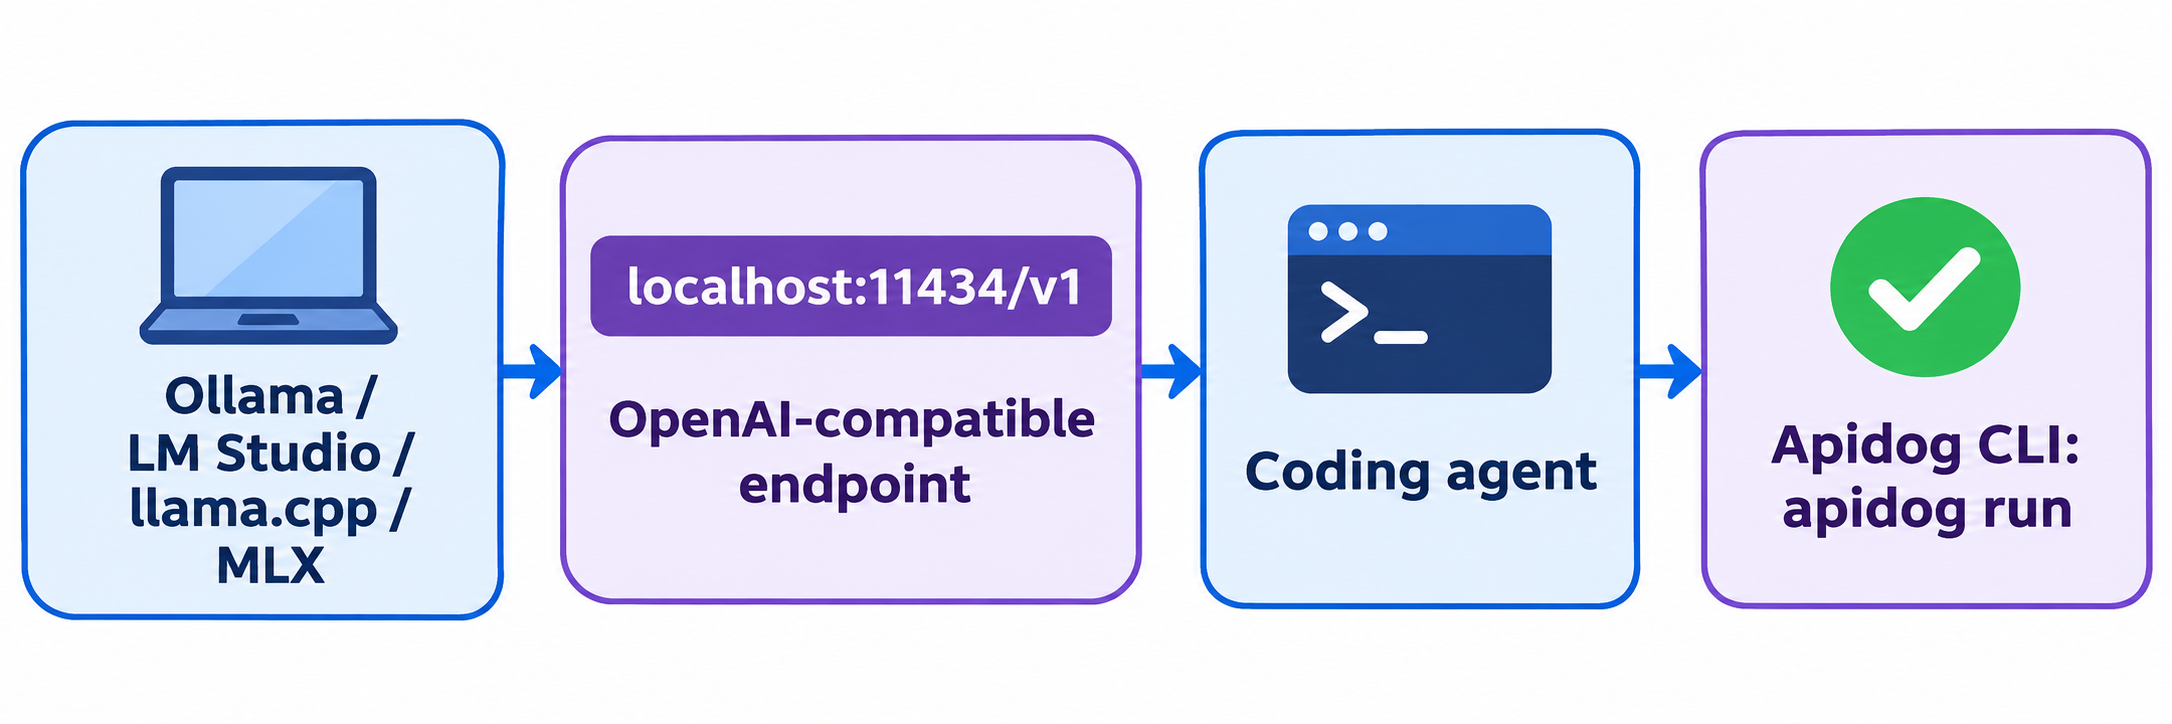
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite à Claude Code, Codex ou Cursor un seul prompt :
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
L'agent lit chaque schéma de payload, valide son JSON, crée les ressources et exécute le cas :
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
Le long --timeout-request compte ici : un modèle de 27B en mode réflexion peut prendre des minutes sur un Mac. Changez l'URL de base pour http://localhost:1234/v1 ou :8080/v1 et le même cas vérifie LM Studio, llama.cpp ou MLX. Pour plus de configurations d'agent, voir Apidog CLI dans Claude Code et la référence de la commande apidog run. Le plan Gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
Local vs l'API Qwen 3.8 hébergée
L'exécution en local garde les prompts sur votre machine, fonctionne hors ligne et ne coûte rien par token. Le compromis, c'est la vitesse et l'échelle : un point de terminaison hébergé sert le bien plus grand Qwen 3.8-Max avec 1M de contexte et sans attente de pré-remplissage. Si vous avez besoin du fleuron, lisez notre guide de l'API Qwen 3.8 ou les moyens d'accès gratuits. Pour le codage agentique avec l'une ou l'autre taille, Qwen 3.8 pour le codage compare les configurations de harness.
FAQ
Qwen 3.8 27B est-il gratuit à exécuter en local ? Oui. Les poids sont sous Apache-2.0 sur Hugging Face, et Ollama, LM Studio, llama.cpp et MLX sont gratuits. Vous ne payez que le matériel et l'électricité.
Puis-je exécuter Qwen 3.8 27B sur un Mac de 16 Go ? Seulement en quantifications 2 bits comme UD-IQ2_XXS (7,27 Go) avec un contexte court, et la qualité baisse nettement. Un Mac de 32 Go exécutant Q4_K_M est la configuration confortable.
Qwen 3.8 27B fonctionne-t-il sur une RTX 3090 ? Oui. Q4_K_M tient dans 24 Go avec de la place pour un contexte de 16K à 32K, et llm-speed a mesuré environ 38 tokens par seconde sur llama.cpp.
Comment désactiver le mode réflexion ? Envoyez "chat_template_kwargs": {"enable_thinking": false} sur llama.cpp ou vLLM, ou abaissez reasoning_effort à low. Qwen recommande une température de 0,7 et top_p 0,8 pour le mode sans réflexion.
Le modèle local prend-il en charge les images ? Oui. Le tag de 18 Go d'Ollama inclut la vision. Avec llama.cpp, téléchargez le fichier mmproj-F16.gguf en plus du modèle.
Quelle est la différence entre Qwen 3.8 27B et Qwen 3.8-Max ? Max est un fleuron mixture-of-experts de 2,4 T de paramètres servi via l'API d'Alibaba. Le 27B est un modèle dense assez petit pour un seul GPU ou un Mac de 32 Go.