
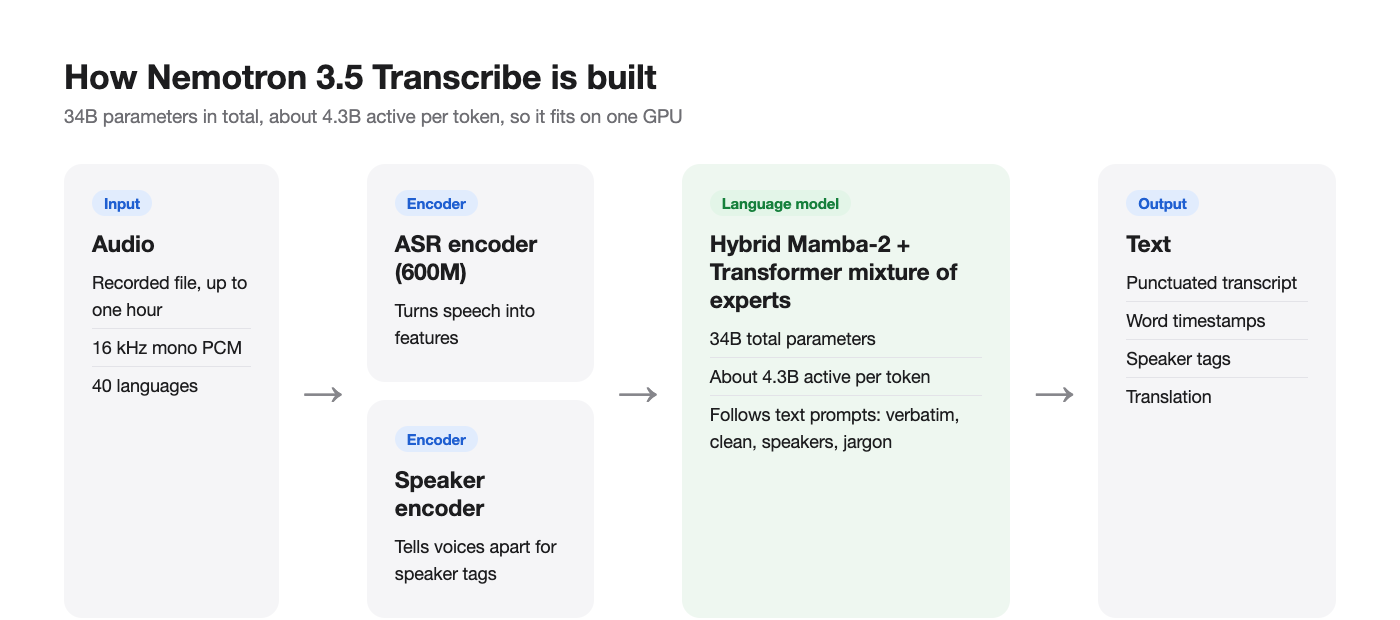
Vous pouvez exécuter le nouveau Nemotron 3.5 Transcribe de NVIDIA sur un seul GPU et transcrire des enregistrements d'une heure dans 40 langues sans payer à la minute ni envoyer l'audio à qui que ce soit. C'est le meilleur modèle à poids ouverts du classement Open ASR de Hugging Face, il est publié sous la licence OpenMDW-1.1 adaptée à un usage commercial, et NVIDIA a publié les poids BF16, FP8 et NVFP4 le jour de la sortie, le 28 octobre 2026.
Ce guide couvre le matériel nécessaire, les trois façons de l'exécuter (vLLM, SGLang-Omni et Transformers), les commandes exactes de la fiche modèle officielle, et les paramètres qui posent problème. Toutes les commandes ont été copiées depuis la fiche le 29 octobre 2026.
Nouveau avec ce modèle ? Notre guide gratuit explique ce qu'il fait et comment il se classe. Vous n'avez pas de GPU ? L'API hébergée coûte 0,002 $ par minute.
Pourquoi l'exécuter localement
- Aucune facturation à la minute. Chez DeepInfra à 0,002 $ par minute, 10 000 heures coûtent 1 200 $. Sur votre propre GPU, cela coûte de l'électricité.
- Confidentialité. Les appels clients, la dictée médicale et les enregistrements juridiques ne quittent jamais votre réseau.
- Ensemble complet de fonctionnalités. La voie vLLM prend en charge les horodatages de mots, la diarisation des locuteurs, la traduction et les invites contextuelles. Certains points de terminaison hébergés n'en exposent qu'une partie.
- Affinage. Le billet de lancement de NVIDIA montre un affinage médical réduisant le WER de 30,8 % à 11,8 %. Vous ne pouvez le faire qu'avec les poids.
Matériel : ce qui l'exécute
Le modèle a 34B de paramètres au total et environ 4,3B actifs, donc les poids sont volumineux même si le calcul par token est faible. La cible de référence de NVIDIA est un H100 80 Go en BF16. Le tableau de compatibilité sur la fiche modèle :
| GPU | Précisions | Environnements d'exécution |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 Go | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 Go | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 Go) | NVFP4 uniquement | vLLM 0.32.0, Transformers, GGML |
Choisissez le checkpoint pour votre carte :
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Une carte 24 Go comme la RTX 4090 n'est pas sur la liste, et Apple Silicon n'est pas pris en charge. Les systèmes d'exploitation sont Linux, ou Windows via WSL2. GGML fonctionne aussi sur Windows natif, mais le billet de lancement de NVIDIA indique que la version locale de NeMo-Speech.cpp est encore « bientôt disponible ».
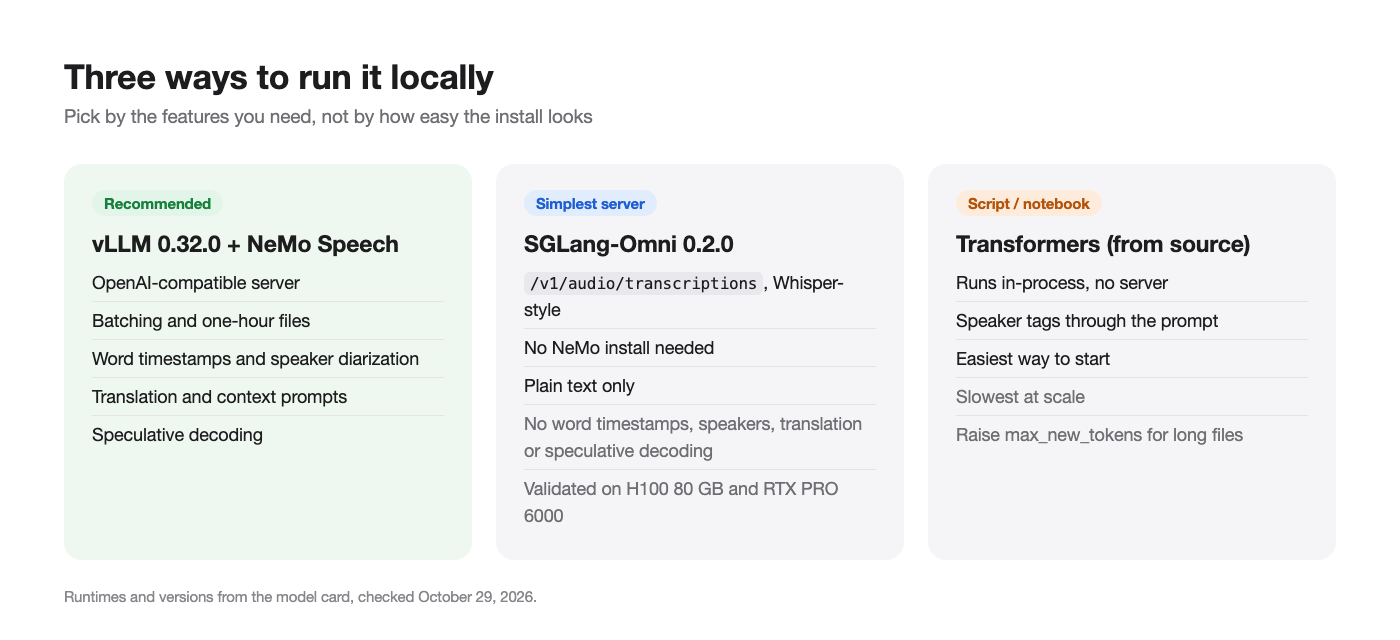
Option 1 : serveur vLLM (recommandé)
vLLM vous donne un point de terminaison compatible OpenAI avec traitement par lots, fichiers d'une heure, décodage spéculatif et horodatages de mots. Il nécessite vLLM 0.32.0 plus la dernière branche principale de NeMo Speech, qui fournit le plugin vLLM du modèle.
Installation
La fiche utilise uv et Python 3.13 :
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) lui permet de décoder les fichiers M4A et autres formats compressés sans FFmpeg système. OpenCV est présent car vLLM en a besoin et les paramètres de dépendances de NeMo l'omettent.
Démarrer le serveur
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Les options à comprendre :
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600relève la limite audio de vLLM de 600 secondes à une heure. Oubliez-le et les fichiers longs échouent.VLLM_USE_V2_MODEL_RUNNER=0conserve le runner V1, dont les horodatages de mots ont besoin.--speculative-configactive la prédiction multi-token avec huit jetons de brouillon (MTP8). Sur un H100, NVIDIA a mesuré un RTFx anglais par lots de 270 avec MTP8 et 410 avec MTP2, alors essayez"num_speculative_tokens":2si vous vous souciez plus du débit que de la latence.--middleware ... ctc_timestamp_middlewareet--trust-request-mm-kwargspermettent aux requêtes de demander des horodatages de mots.- Les paramètres ciblent un H100 80 Go. Sur d'autres cartes, réduisez
--gpu-memory-utilization,--max-model-lenou--max-num-seqs.
Le serveur écoute sur 127.0.0.1:8000. Ajoutez --host 0.0.0.0 pour y accéder depuis d'autres machines de votre réseau.
Envoyer un fichier
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Remplacez l'instruction textuelle par n'importe quelle invite de tâche. Pour une réunion avec plusieurs voix :
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Les requêtes d'horodatage de mots ont des règles : un enregistrement par requête, stream=false et n=1. La réponse inclut alors un objet ctc_timestamps avec les mots, les heures de début et de fin en secondes, et les étiquettes de locuteur.
Option 2 : SGLang-Omni pour la transcription simple
Si vous n'avez besoin que de texte à partir de fichiers entiers, SGLang-Omni 0.2.0 est plus simple et n'a pas besoin de NeMo. Il est validé sur un H100 80 Go et un RTX PRO 6000 Blackwell avec le checkpoint BF16 ou FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Cette route /v1/audio/transcriptions correspond à la forme utilisée par l'API Whisper d'OpenAI, donc le code client Whisper existant n'a souvent besoin que d'une nouvelle URL de base. Le compromis : pas d'horodatages de mots, d'étiquettes de locuteur, de traduction ou de décodage spéculatif dans cette intégration.
Option 3 : Transformers dans un script
Pour les notebooks et les tâches ponctuelles, exécutez-le en cours de processus avec Hugging Face Transformers installé depuis la source :
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
C'est la façon la plus simple de commencer et la plus lente d'exécuter à l'échelle. Augmentez max_new_tokens pour les fichiers longs : une heure dense peut produire environ 20 000 jetons.
Quelle est sa vitesse sur votre propre GPU ?
Le chiffre phare de NVIDIA est de 2 238 secondes d'audio par seconde sur un RTX PRO 6000 Blackwell, avec des poids NVFP4 et un décodage spéculatif DFlash2, et 0,13 seconde pour renvoyer un clip de 30 secondes. Lisez la note de bas de page : ces chiffres proviennent du NIM optimisé, dont les changements de service ne sont pas encore open source. La fiche indique que l'intégration vLLM ouverte devrait être environ deux fois plus lente.
Pour la transcription anglaise par lots sur H100 en BF16, la fiche liste ces nombres RTFx (secondes d'audio par seconde de calcul) :
| Décodage spéculatif | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Même la ligne la plus lente traite une heure d'audio en moins de 15 secondes de temps GPU sur du travail par lots. Si vous voulez le modèle de brouillon DFlash2, notez que vLLM 0.32.0 a besoin d'un petit correctif de la fiche, DFlash2 désactive les horodatages de mots, et vous ne devriez pas le combiner avec MTP.
Problèmes courants et solutions
- Fichiers longs coupés à 10 minutes. Vous avez ignoré
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - Pas d'horodatages dans la réponse. Vérifiez
VLLM_USE_V2_MODEL_RUNNER=0, l'option--middleware, et que la requête astream=falseet un seul enregistrement. - Mémoire insuffisante sur les petites cartes. Passez au checkpoint FP8 ou NVFP4 et réduisez
--max-num-seqs. - Phrases répétées à la fin d'une transcription. La fiche recommande une garde de boucle de génération sur les sorties finales. Limitez
max_tokenset supprimez les répétitions. - Mauvaise orthographe des noms. Ajoutez
Context terms: <names>à l'invite. - Voix de fond dans la transcription. Essayez l'invite expérimentale en champ proche de la fiche, qui a réduit le WER sur l'audio mixte de 27,32 % à 4,78 % dans le test de NVIDIA.
Si vous débutez avec vLLM lui-même, notre explication de vLLM couvre comment il traite les requêtes par lots et gère la mémoire GPU.
Laissez votre agent de codage tester le serveur local avec Apidog CLI
Un modèle local n'est utile que si son point de terminaison reste correct à travers les mises à niveau de vLLM, les ajustements d'invite et les échanges de checkpoint. Laissez votre agent de codage s'en charger avec Apidog CLI, en exécutant des vérifications contre http://127.0.0.1:8000 depuis la même machine.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez une invite à votre agent :
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
L'agent lit le schéma, valide sa charge utile, écrit les cas et les exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Exécutez-le après chaque mise à niveau du serveur, ou intégrez apidog run ... -r junit dans CI comme montré dans Apidog CLI dans un pipeline CI/CD. Pour la configuration de l'agent, voir Apidog CLI dans Claude Code.
FAQ
Puis-je exécuter Nemotron 3.5 Transcribe sur une RTX 4090 ? Elle n'est pas sur la liste de compatibilité de NVIDIA. La plus petite carte grand public listée est la RTX 5090 avec le checkpoint NVFP4.
Fonctionne-t-il sur un Mac ? Aucun environnement d'exécution officiel ne prend en charge Apple Silicon au 29 octobre 2026.
L'utilisation locale est-elle gratuite pour les produits commerciaux ? La licence OpenMDW-1.1 autorise l'utilisation commerciale et non commerciale. Lisez le texte de la licence pour les conditions d'attribution avant de livrer.
Peut-il transcrire de l'audio en direct ? Non. C'est un modèle hors ligne pour les fichiers enregistrés. NVIDIA propose un modèle distinct Nemotron 3.5 ASR Streaming pour l'utilisation en direct.
Quel est le plus rapide, vLLM ou SGLang-Omni ? NVIDIA ne publie pas de comparaison directe. Utilisez vLLM lorsque vous avez besoin d'horodatages, de locuteurs ou de traduction, et SGLang-Omni pour le serveur texte uniquement le plus simple.
Comment se classe-t-il par rapport aux autres modèles locaux ? Il devance tous les modèles à poids ouverts sur le classement Open ASR du 28 octobre. Notre liste des meilleurs modèles open source de reconnaissance vocale le compare avec Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral et Whisper.
Exécutez-le
Téléchargez le checkpoint qui correspond à votre GPU, démarrez vLLM avec la limite audio d'une heure et le middleware d'horodatage, et envoyez un fichier WAV via le client OpenAI. Ensuite, laissez votre agent exécuter des vérifications Apidog contre le point de terminaison local afin que chaque mise à niveau prouve qu'il transcrit toujours avant que vous ne lui fassiez confiance avec de vrais enregistrements.