
Pour exécuter ERNIE 5.5 Flash en local, installez vLLM 0.32.0 ainsi que le plugin vLLM-ERNIE de Baidu, puis lancez vllm serve baidu/ERNIE-5.5-Flash-Base avec parallélisme des données et des experts sur un nœud multi-GPU. Vous obtenez un serveur compatible OpenAI sur le port 8000. Le hic : les poids ouverts actuels correspondent au modèle Base, un checkpoint de pré-entraînement qui continue du texte, et non un modèle de chat.
Ci-dessous : ce que vous pouvez télécharger, la configuration matérielle indiquée par Baidu, les commandes exactes de serve et comment tester l’endpoint. Toutes les commandes et tous les chiffres ci-dessous proviennent de la fiche modèle Hugging Face de Baidu et du dépôt vLLM-ERNIE, vérifiés le 12 novembre 2026.
Le modèle ne vous dit rien ? Commencez par ce qu’est ERNIE 5.5 Flash. Si vous voulez le modèle de chat sans cluster de GPU, le guide de l’API ERNIE 5.5 Flash est la voie la plus rapide.
Que pouvez-vous exécuter en local aujourd’hui ?
Vous pouvez exécuter ERNIE 5.5 Flash Base, publié sur Hugging Face en FP8 et BF16. C’est un modèle sparse mixture-of-experts de 280 milliards de paramètres, avec 14 milliards de paramètres actifs par token, entraîné sur 33,5 T de tokens. ERNIE 5.5 Flash Preview, ajusté pour le chat, n’est pour l’instant accessible que via l’API ; Baidu annonce que ses poids arriveront « bientôt » sous Apache 2.0.
Voici comment les deux versions se comparent pour un auto-hébergement :
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Qu’est-ce que c’est | Checkpoint à la fin du pré-entraînement | Premier modèle post-entraîné (chat, raisonnement, agent) |
| Poids | Hugging Face et ModelScope, FP8 et BF16 | Non publiés au 12 novembre 2026 |
| Endpoint appelé | /v1/completions (continuation de texte) |
Chat completions avec raisonnement et outils |
| Licence | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 promis à la sortie |
| Où l’utiliser dès maintenant | Vos propres GPU | API Qianfan, OpenRouter |
Aujourd’hui, la collection ERNIE-5.5-Flash de Baidu ne contient que les deux checkpoints Base, et le README de vLLM-ERNIE marque le modèle de chat « Coming soon ». L’annonce de sortie de Preview ne donne aucune date.
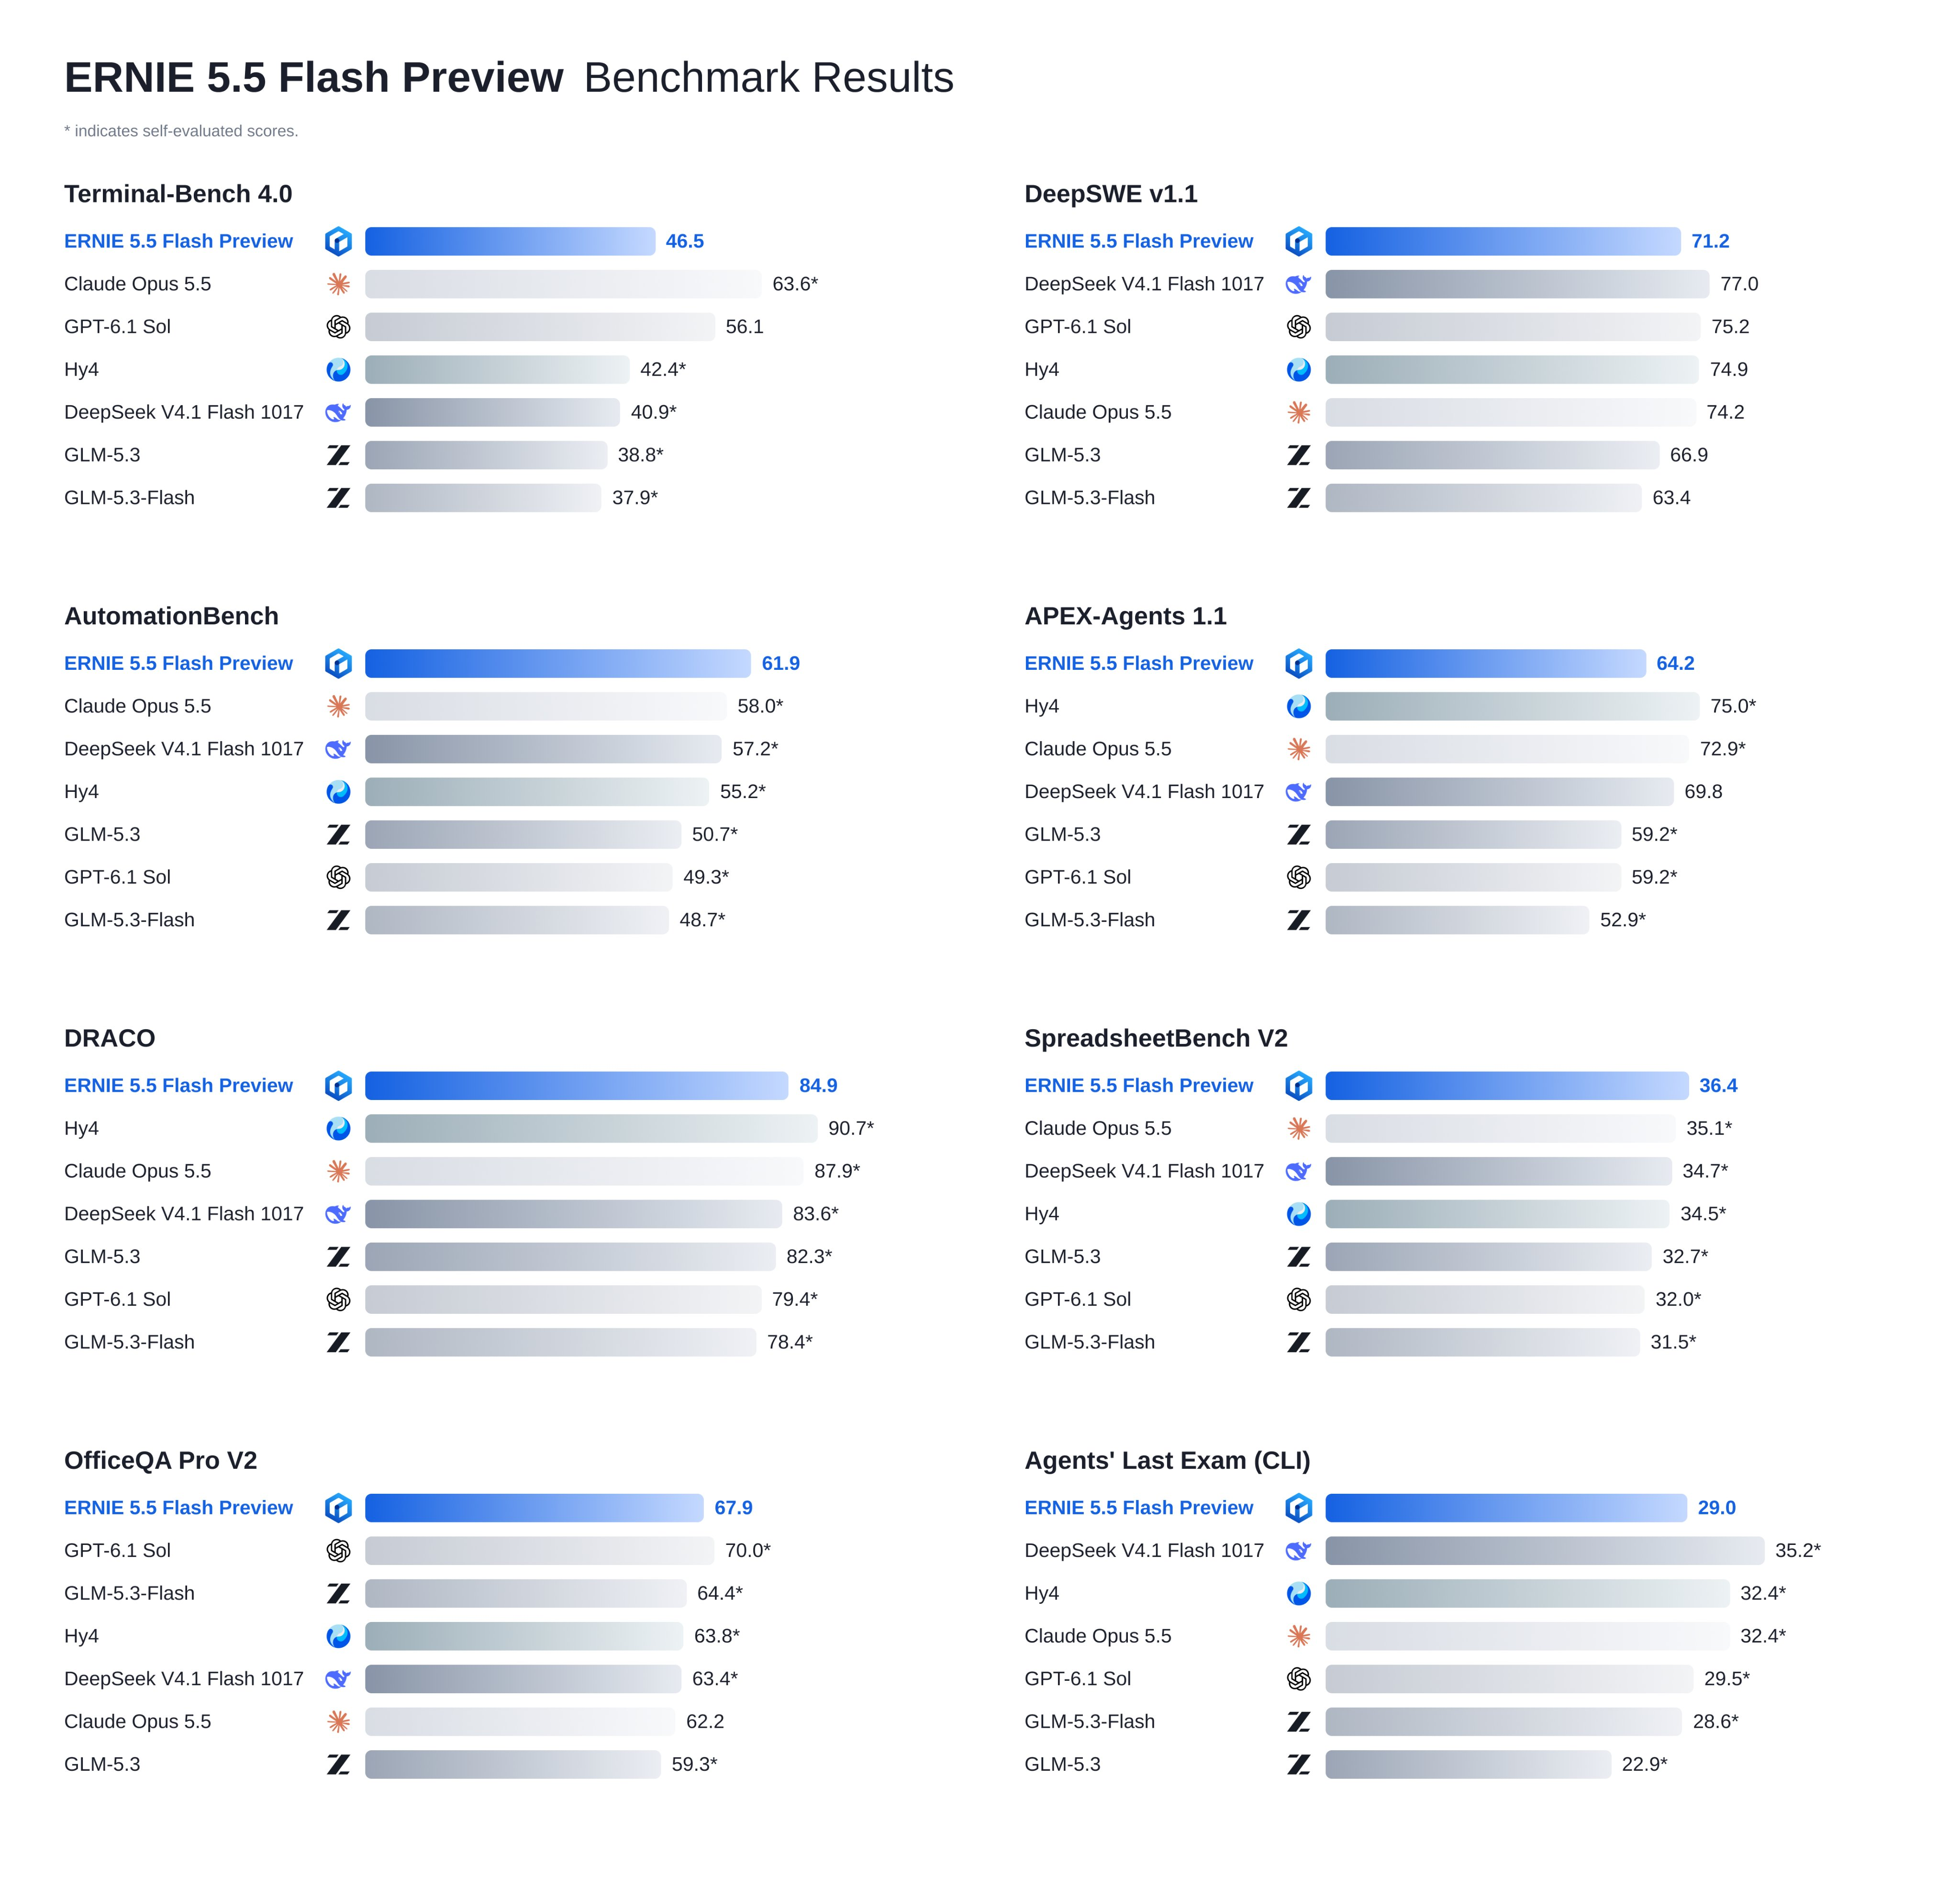
Si vous voulez un assistant de code aujourd’hui, un modèle Base en local ne vous en offrira pas. En revanche, si vous cherchez un point de départ pour du fine-tuning ou de la recherche en few-shot, c’est précisément ce à quoi sert Base.
Configuration matérielle requise pour ERNIE 5.5 Flash
Les poids FP8 occupent environ 280 Go de mémoire GPU et les poids BF16 environ 560 Go : il s’agit donc d’un travail pour serveur multi-GPU, pas pour un ordinateur portable. Le README de vLLM-ERNIE liste les nombres de GPU minimaux pour contenir les poids, et le plugin ne fonctionne que sur des GPU NVIDIA.
| Mémoire GPU par carte | FP8 (~280 Go de poids) | BF16 (~560 Go de poids) |
|---|---|---|
| 288 Go | 2 GPU | 4 GPU |
| 192 Go | 4 GPU | 8 GPU (ou 2 nœuds x 4 GPU) |
| 80 Go | 8 GPU | 2 nœuds x 8 GPU |
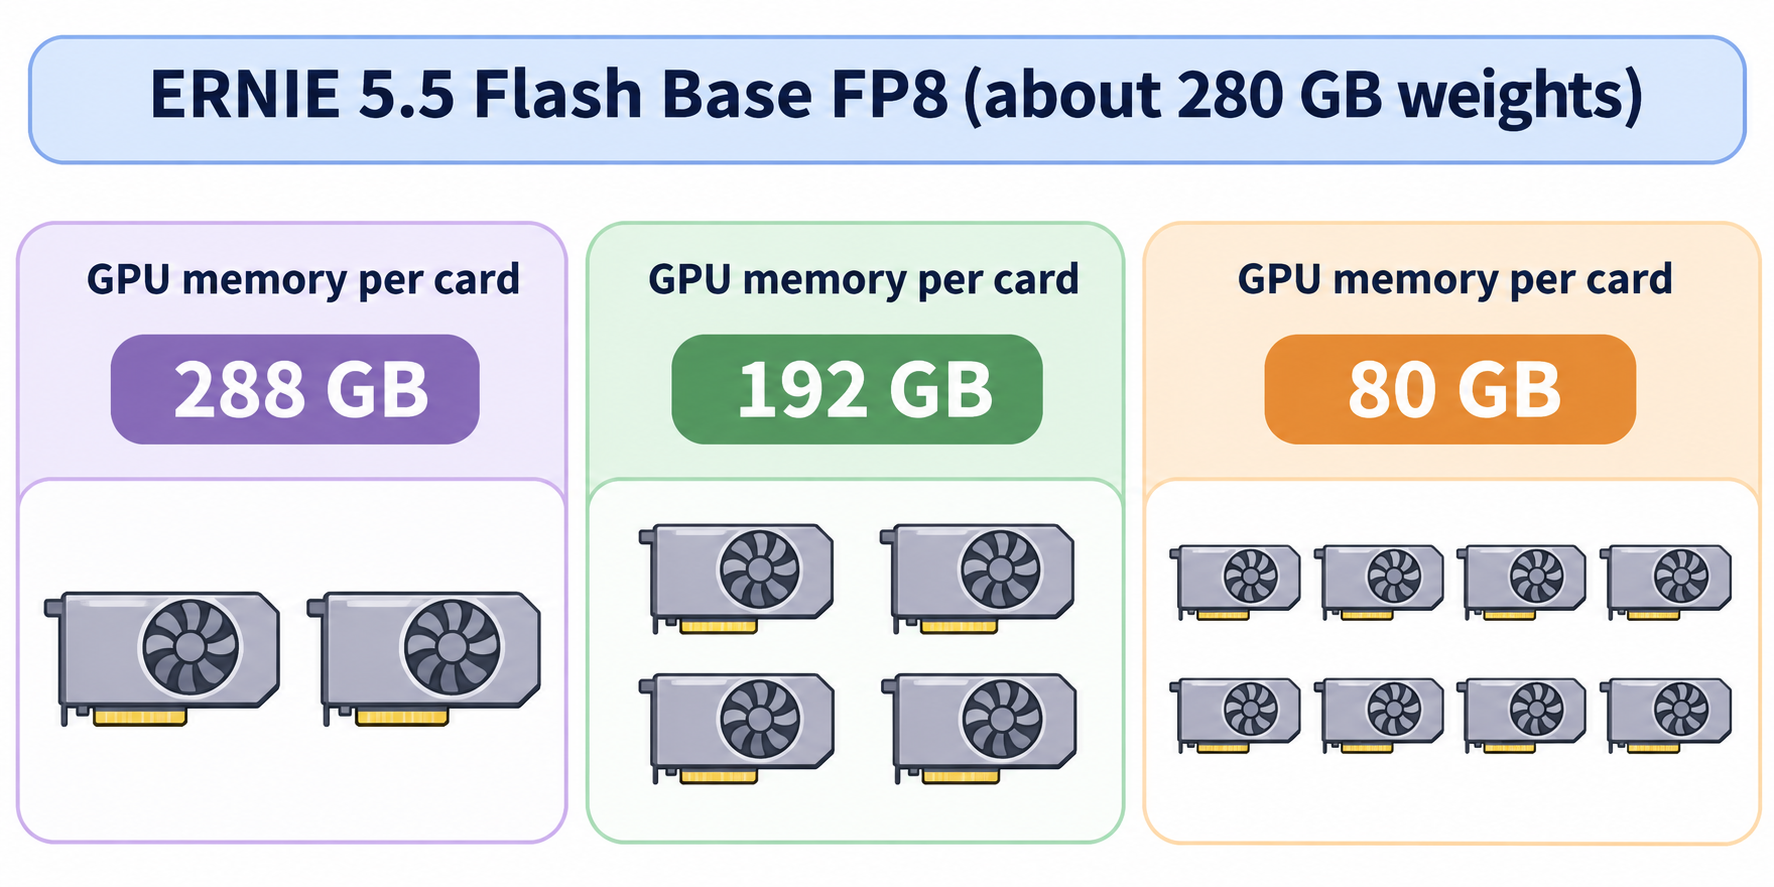
Ce sont les minimums pour charger les poids. Le cache KV a besoin de place en plus, c’est pourquoi la longueur de contexte que vous pouvez servir dépend de vos cartes :
- GPU de 80 Go : servez le FP8 sur 8 GPU avec
--data-parallel-size 8et--gpu-memory-utilization 0.93. Jusqu’à 262 144 tokens tiennent ; 1M non. - Contexte de 1M de tokens : les valeurs de Baidu sont prévues pour des GPU dotés de 184 GiB de mémoire, avec une utilisation réduite à 0,85 car un préfill de 1M de tokens nécessite des dizaines de Go de mémoire temporaire.
- L’architecture compte : les commandes FP8 passent
--moe-backend humming, qui prend en charge l’activation SiTU du modèle avec des poids FP8 sur les GPU Blackwell. Sur les GPU Hopper, retirez ce flag et conservez le kernel MoE par défaut de vLLM.
« En local » signifie du matériel que vous contrôlez : un nœud de 8 GPU loué, un serveur on-premise ou un cluster de laboratoire.
Installer vLLM et le plugin ERNIE
vLLM ne prend pas en charge l’architecture ERNIE 5.5 (Ernie5_5_MoeForCausalLM) d’emblée. Baidu la fournit sous forme de plugin qui s’exécute sur la roue vLLM 0.32.0 publiée, sans modification. Créez un environnement Python 3.12 et installez les deux :
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
Le plugin se charge via le point d’entrée vllm.general_plugins de vLLM dans chaque processus vLLM. Si vllm serve indique ensuite Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, c’est que le plugin n’est pas installé dans l’environnement qui exécute vllm, ou que VLLM_PLUGINS est défini sans y inclure ernie.
Pour récupérer les poids depuis ModelScope plutôt que depuis Hugging Face, définissez VLLM_USE_MODELSCOPE=True. Les noms des dépôts sont identiques sur les deux hubs. Si vLLM est nouveau pour vous, notre présentation de vLLM explique le serveur et son API compatible OpenAI.
La commande vllm serve pour ERNIE 5.5 Flash
Voici la commande FP8 du README de vLLM-ERNIE, pour un nœud de 4 GPU au contexte d’entraînement de 128K avec le décodage spéculatif ECHO activé :
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Ce que fait chaque choix, d’après les notes de Baidu :
- Attention en parallélisme de données plus MoE en parallélisme d’experts (
--data-parallel-size 4 --enable-expert-parallel) contient le plus de cache KV et offre le meilleur débit. Le parallélisme de tenseurs (--tensor-parallel-size2, 4 ou 8) réduit la latence à faible concurrence mais contient moins de cache KV. - Cache KV en FP8 (
--kv-cache-dtype fp8) stocke le cache en FP8 ;autole conserve en BF16. - Décodage spéculatif ECHO réutilise la dernière couche du modèle comme draft intégré. Ici, il esquisse 2 étapes ; 1 ou 3 fonctionnent aussi. Supprimez
--speculative-configpour servir sans draft.
La fiche modèle montre une variante plus courte sur le port 30000, sans la configuration spéculative.
Sécurisez le serveur. Ces commandes se lient à 0.0.0.0 sans authentification. Le README de Baidu recommande d’ajouter --api-key <key> ou de se lier à 127.0.0.1, sauf si le réseau est de confiance. Faites l’un des deux avant d’exposer le port.
BF16 et contexte de 1M
BF16 s’exécute sur deux nœuds de 4 GPU (DP8 plus EP8) avec --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} et --data-parallel-hybrid-lb ; le second nœud ajoute --data-parallel-start-rank 4. Copiez la commande complète depuis le README ; elle définit aussi l’interface réseau entre les nœuds.
Pour toute la fenêtre de 1 048 576 tokens, passez --max-model-len 1048576 et --gpu-memory-utilization 0.85, et réduisez --max-num-seqs pour que le cache KV de chaque rang puisse contenir des requêtes complètes de 1M de tokens.
Appeler l’endpoint compatible OpenAI
vLLM expose des routes au style OpenAI, mais un modèle Base n’a pas de template de chat : vous appelez donc /v1/completions avec un prompt brut. Pour un usage few-shot, placez les exemples dans le prompt et arrêtez-vous à la fin d’une réponse :
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
Le README de Baidu indique que le texte de la complétion renvoie 36. Trois détails piègent souvent :
- Passez
"temperature": 0pour un décodage glouton. Legeneration_config.jsondu modèle définitdo_sample=false,temperature=1.0ettop_p=0.95. vLLM applique la température et le top_p mais ignoredo_sample, donc vous échantillonnez sauf si vous le surchargez. - N’ajoutez pas vous-même
<|ERNIE_MASK|>. Le tokenizer l’ajoute en préfixe (token id 2) aux prompts de complétion. - Faites correspondre le nom du modèle. Utilisez
baidu/ERNIE-5.5-Flash-Base-BF16lorsque vous servez les poids BF16.
Tout SDK OpenAI fonctionne si vous pointez base_url vers http://<host>:8000/v1 et appelez les complétions, pas les chat completions.
Base ou Preview : lequel choisir ?
Utilisez Base si vous prévoyez de l’entraîner davantage ; utilisez Preview si vous avez besoin d’un assistant fonctionnel tout de suite. Base vous donne un contrôle total et des données qui ne quittent jamais vos serveurs. Preview vous offre le chat, le raisonnement et l’appel d’outils, mais uniquement via Qianfan ou OpenRouter.
Lorsque les poids Preview sortiront, le plugin sera déjà prêt pour eux. Le README documente les flags supplémentaires, marqués « Coming soon » : --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, plus un modèle de draft DSpark pour le décodage spéculatif. Le raisonnement reviendra dans reasoning_content et les appels d’outils dans message.tool_calls : le même serveur que vous construisez aujourd’hui deviendra un backend de chat avec un simple échange de poids et trois flags.
La licence est l’autre différence. Base est distribué sous l’ERNIE 5.5 Flash Base Model License Agreement v1.0, et non sous Apache 2.0. Lisez la licence complète avant de construire un produit dessus. Au 12 novembre 2026, elle stipulait :
- L’usage non commercial est gratuit, sans préavis requis.
- L’usage commercial, lorsque le produit concerné génère jusqu’à 50 millions de dollars américains par an, est exempt de frais de licence, mais vous devez afficher « Powered by ERNIE » et envoyer à Baidu un préavis unique.
- Au-delà de 50 millions de dollars par an, vous devez d’abord obtenir une autorisation écrite distincte de Baidu.
- Le « Territory » de la licence exclut l’Union européenne, le Royaume-Uni et la Corée du Sud.
Pour un modèle open-weights plus petit que vous pouvez auto-héberger avec moins de GPU, consultez notre guide sur l’auto-hébergement de GLM-5.3.
Laissez votre agent de code tester l’endpoint avec Apidog CLI
Un déploiement vLLM tout neuf a besoin d’un test de fumée que vous pouvez relancer après chaque changement de flag : statut, schéma de réponse et tokens par seconde. Confiez cela à votre agent de code et à l’Apidog CLI plutôt que de retaper du curl.
Configurez le CLI une seule fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Puis donnez à Claude Code, Codex ou Cursor un seul prompt :
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
L’agent lit le schéma du payload, le valide, écrit le cas de test et l’exécute :
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
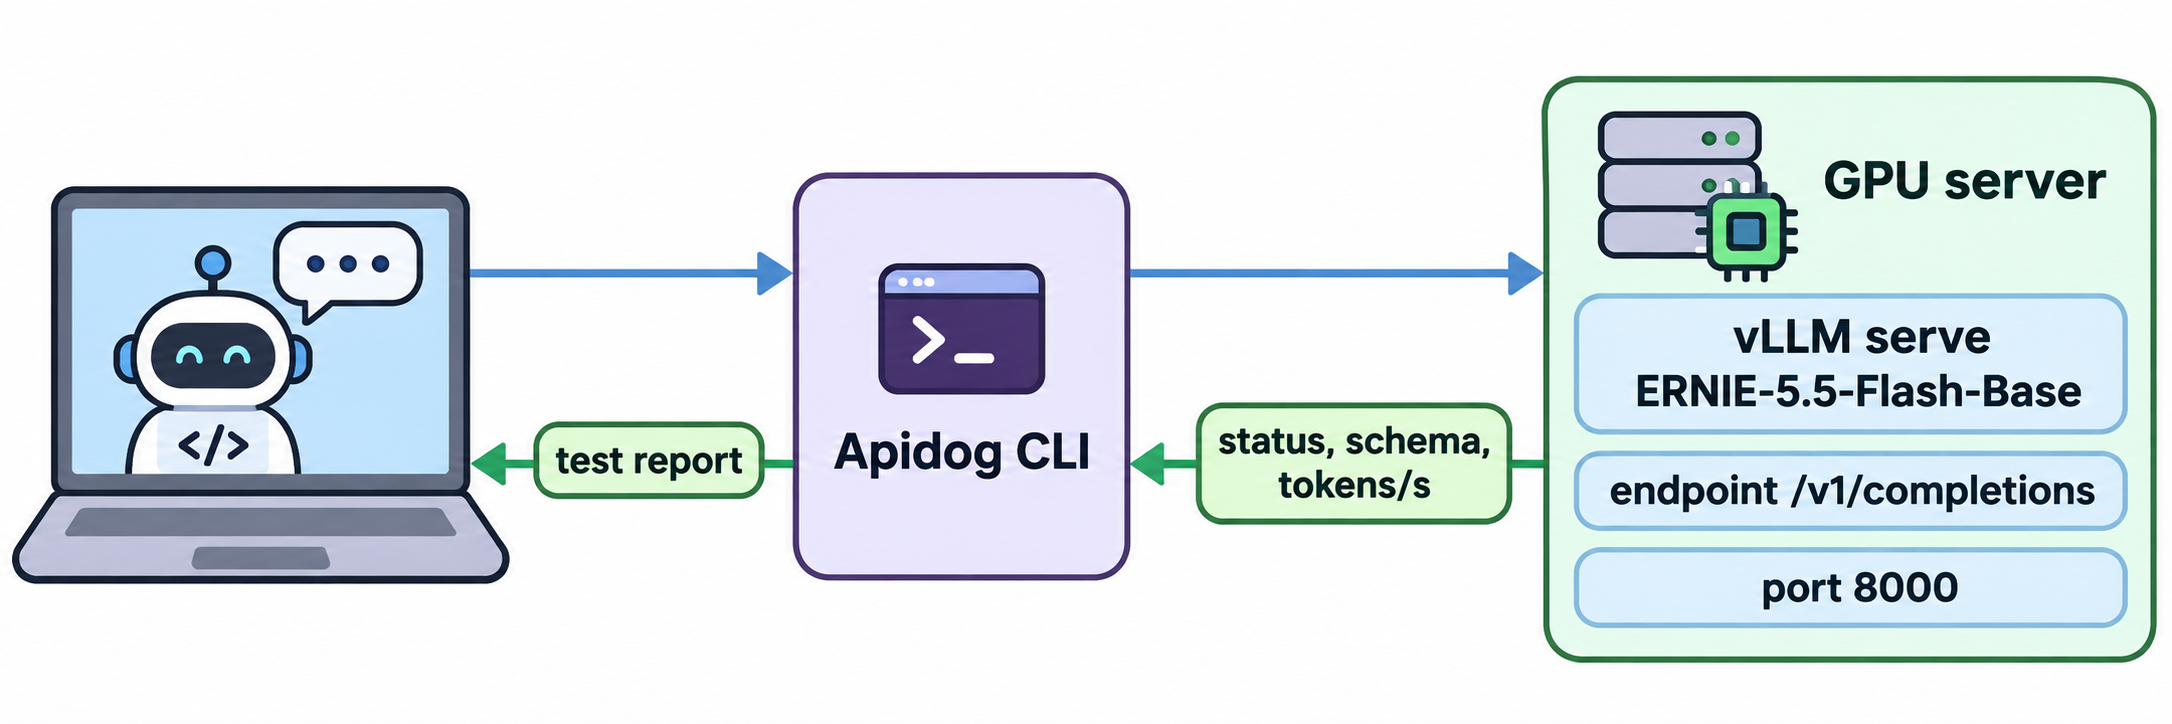
Exécutez le CLI depuis une machine pouvant joindre le port 8000. Si vous avez défini --api-key sur le serveur, demandez à l’agent de le stocker dans une variable d’environnement et de l’envoyer comme token Bearer. Relancez le même cas de test après avoir changé --tensor-parallel-size, désactivé le décodage spéculatif ou augmenté --max-model-len, et vous obtenez une comparaison à conditions égales. Ajoutez -r junit et la même exécution s’intègre dans votre CI. Pour la configuration de l’agent pas à pas, consultez Apidog CLI dans Claude Code. Le plan gratuit Apidog couvre jusqu’à 4 utilisateurs.
FAQ
Puis-je exécuter ERNIE 5.5 Flash sur un seul GPU grand public ? Non. Les poids FP8 font environ 280 Go, et la configuration minimale indiquée par Baidu est de 2 GPU de 288 Go chacun. Avec des cartes de 80 Go, il vous en faut 8. Utilisez Preview via l’API si vous n’avez pas ce matériel.
Les poids d’ERNIE 5.5 Flash Preview sont-ils disponibles ? Pas au 12 novembre 2026. Baidu annonce qu’ils seront open-sourcés sous Apache 2.0 bientôt, et le plugin vLLM-ERNIE liste le modèle de chat comme « Coming soon ». Seuls les poids Base (FP8 et BF16) sont sur Hugging Face.
Pourquoi /v1/chat/completions échoue-t-il sur le modèle Base ? Base n’a reçu aucun entraînement au chat et n’a pas de template de chat. Baidu le sert via /v1/completions avec un prompt textuel brut. Placez des exemples few-shot dans le prompt et utilisez une séquence d’arrêt.
vLLM prend-il en charge ERNIE 5.5 nativement ? Pas dans le cœur de vLLM. Vous avez besoin du plugin vLLM-ERNIE de Baidu par-dessus vLLM 0.32.0. Il ne fonctionne que sur des GPU NVIDIA. SGLang sert aussi le modèle via une image Docker dédiée, nommée sur la fiche modèle.
Puis-je utiliser ERNIE 5.5 Flash Base commercialement ? Oui, sous conditions. Les produits générant jusqu’à 50 millions de dollars par an peuvent l’utiliser sans frais de licence, avec l’attribution « Powered by ERNIE » et un préavis unique à Baidu. Au-delà, une autorisation écrite est requise, et le territoire de la licence exclut l’UE, le Royaume-Uni et la Corée du Sud.