
Vous pouvez faire tourner DeepSeek V4 Flash localement sans GPU grâce à llama-modchip, un ensemble de patches llama.cpp open source qui réduit le modèle 284B à un GGUF de 56,56 Gio à 1,71 bits par poids. Sur une puce de portable AMD Zen 5 à 16 cœurs avec 64 Go de RAM, il effectue le préremplissage à environ 44 tokens par seconde et décode à 9 à 15 tokens par seconde, sans aucun swap.
Ce guide couvre le matériel, les commandes, le compromis sur la qualité et la façon dont votre agent de codage peut tester le point de terminaison local.
Ce que fait réellement llama-modchip
llama-modchip est un ensemble de patches de noyaux ggml et llama.cpp, de transcodeurs de quantification et d'outils d'exécution pour faire tourner des modèles épars Mixture-of-Experts entièrement en RAM système. Sa version v2.4.0 cible deux tailles de modèles : le DeepSeek-V4-Flash 284B sur des machines de 64 Go et les modèles MoE 30B sur des machines de 16 à 32 Go.
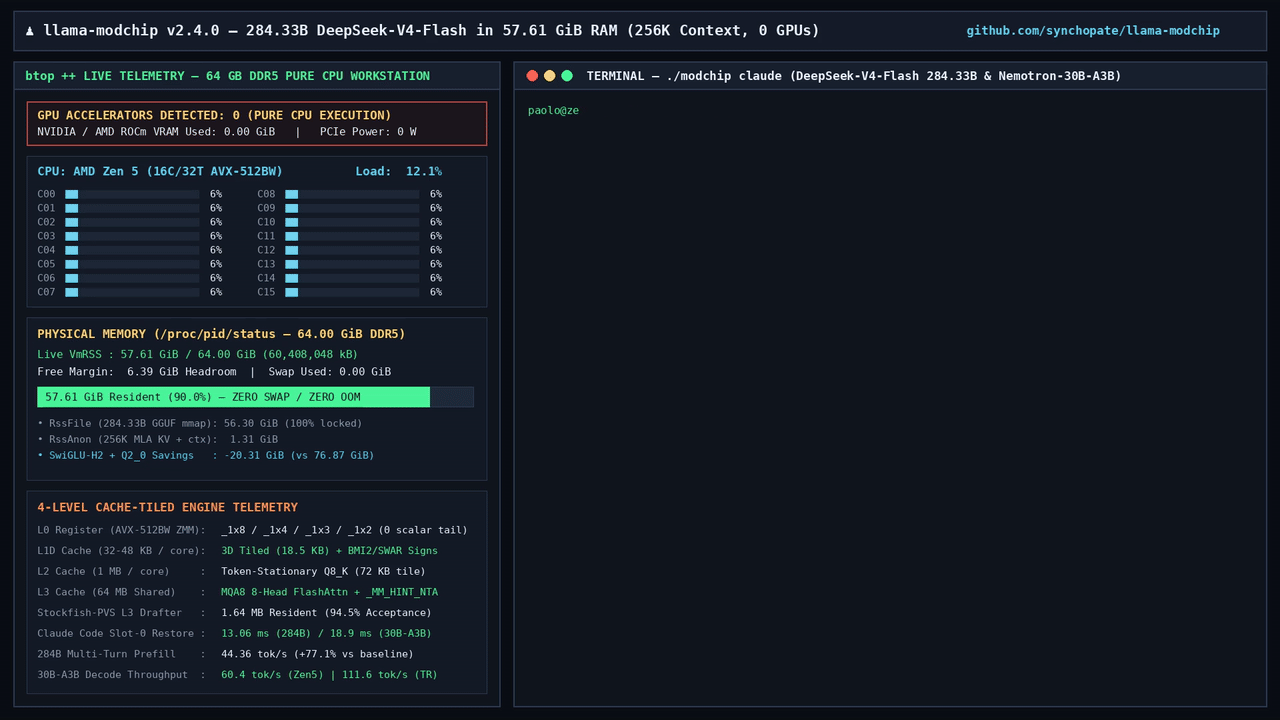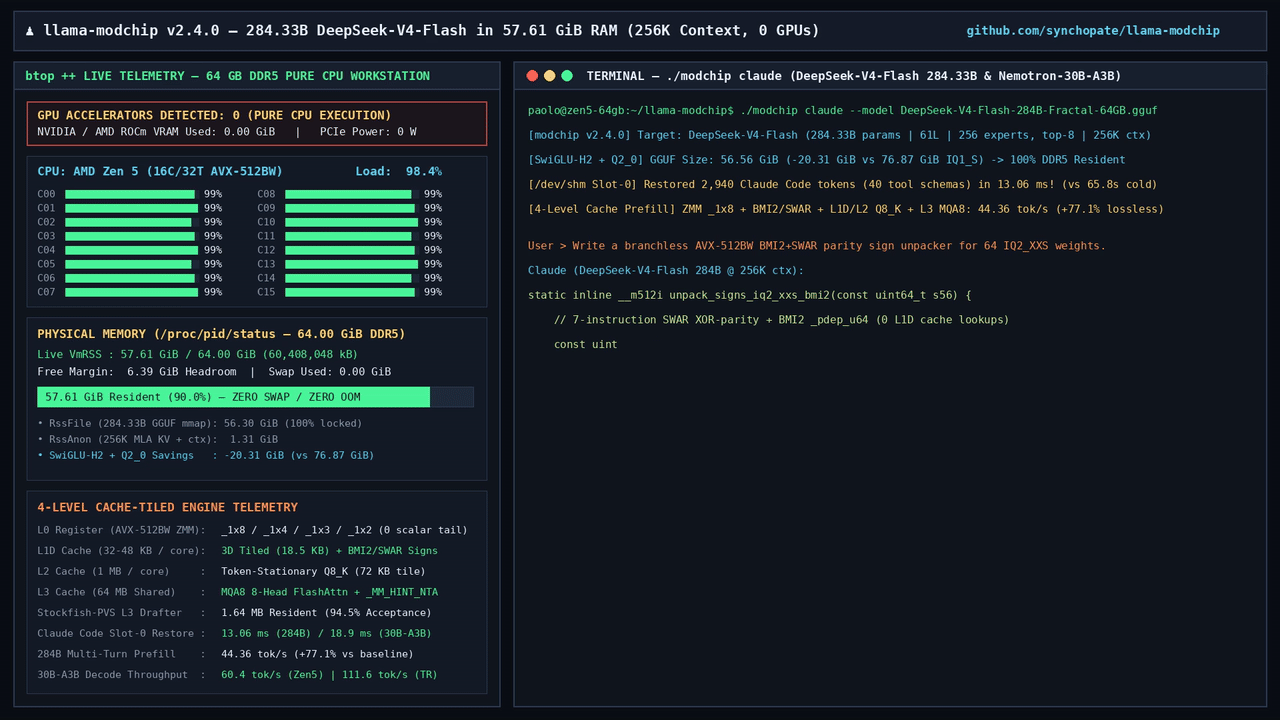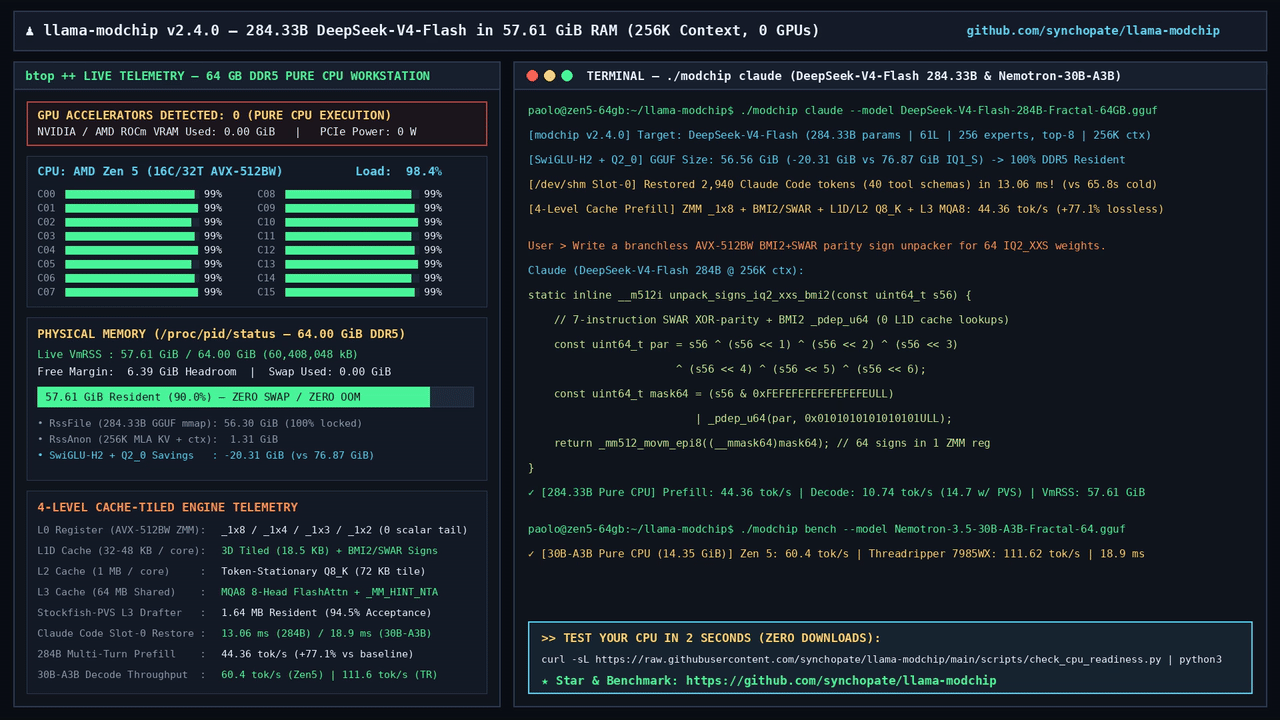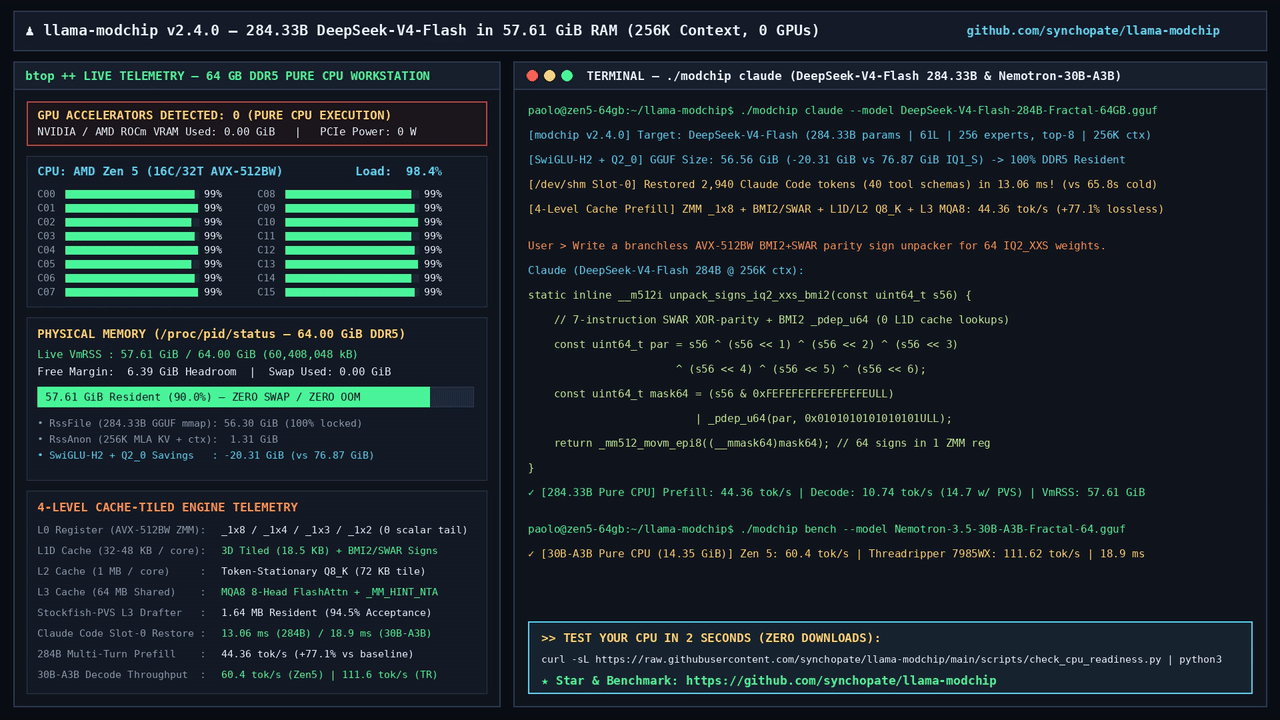
Le projet a été publié sur Hacker News le 8 novembre 2026 et a dépassé 370 points. Le dépôt est sous licence Apache 2.0.
Trois éléments permettent au 284B de tenir :
- Un checkpoint plus petit. La version standard
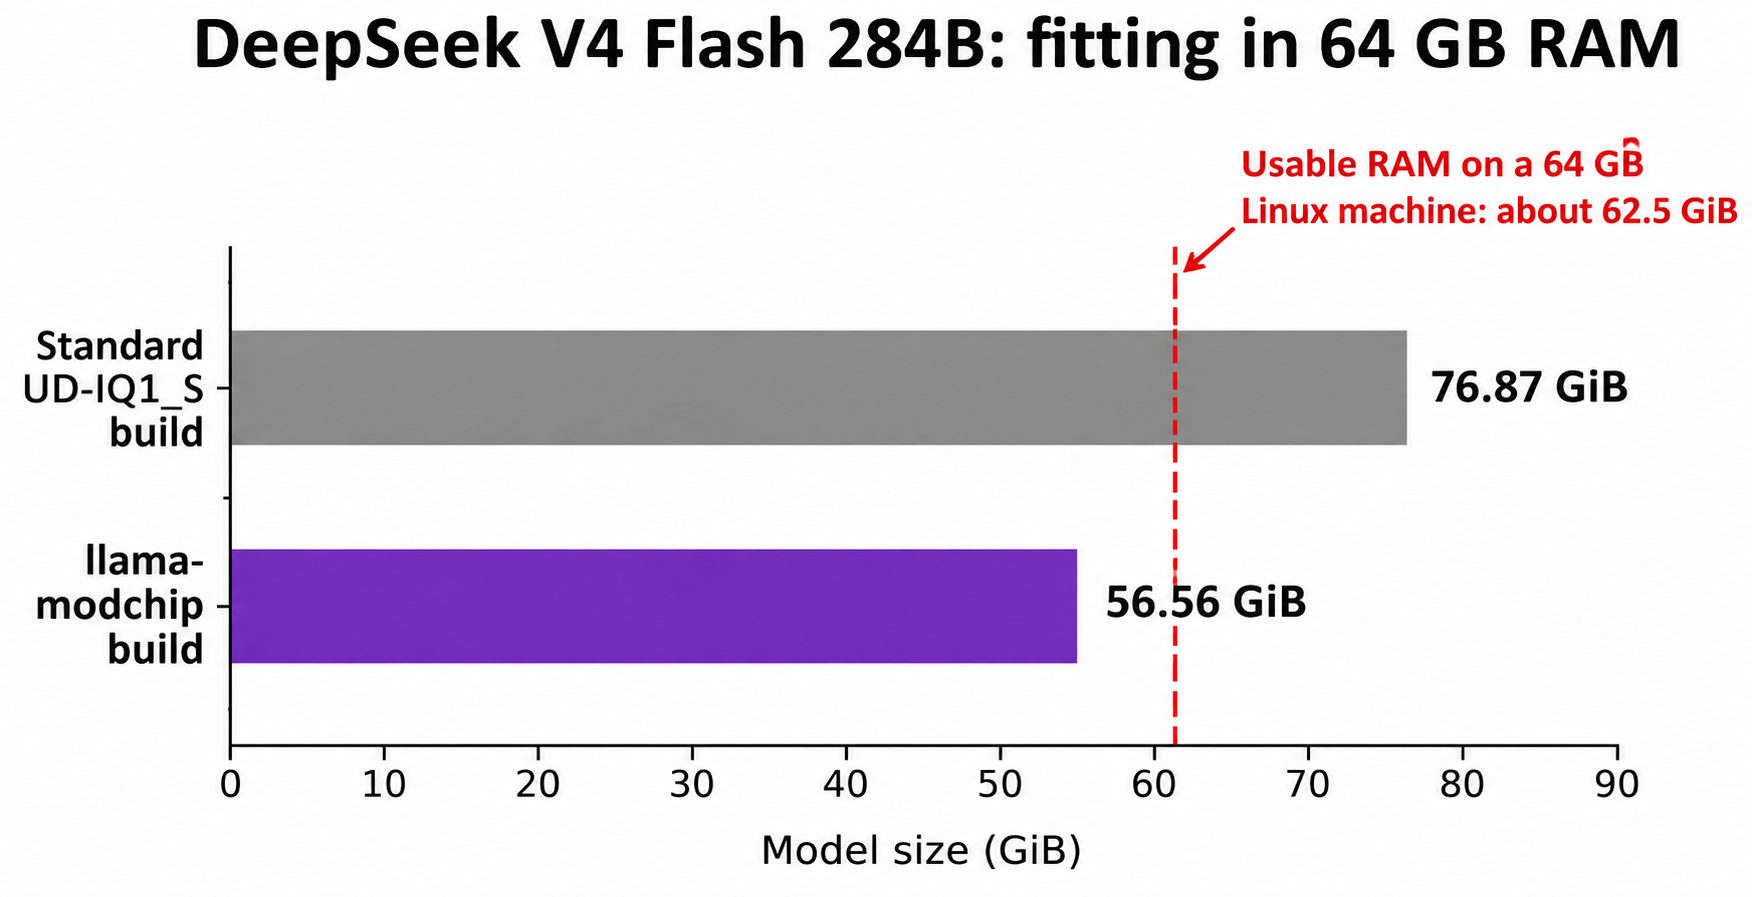
UD-IQ1_Sd'Unsloth fait 76,87 Gio, soit plus que les environ 62,5 Gio utilisables sur une machine Linux de 64 Go. llama-modchip le transcode en 56,56 Gio. - Tuiling du cache CPU. Les noyaux de préremplissage répartissent le travail entre les registres et le cache L1 à L3 : 25,0 à 44,36 tokens par seconde sur un Zen 5 à 16 cœurs, soit un gain de 77 %.
- Drafting auto-spéculatif. Un drafteur n-gram de 1,64 Mo fait passer le décodage d'environ 9 à 14,7 tokens par seconde au maximum.
Par défaut, les 6 experts routés plus l'expert partagé s'exécutent à chaque couche, donc rien n'est élagué.
Le matériel nécessaire pour faire tourner DeepSeek V4 Flash localement
Vous avez besoin de 64 Go de RAM système et d'un CPU x86_64 récent, idéalement avec AVX-512. Tous les chiffres du 284B dans ce guide ont été mesurés par le mainteneur sur une seule machine : un AMD Ryzen 9 9955HX (16 cœurs, 32 threads, 64 Mo de L3) avec 64 Go de DDR5 sous Linux, sans GPU.
| Votre machine | RAM | Ce que le README associe | Vitesse annoncée (0 GPU) |
|---|---|---|---|
| Portable ou mini PC | 16 à 32 Go | Nemotron-3.5-30B-A3B, 14,35 Gio | 25,0 à 60,4 tok/s |
| Desktop ou serveur | 64 Go | DeepSeek-V4-Flash 284B, 56,56 Gio | 44,4 tok/s préremplissage, 9,1 à 14,7 tok/s décodage |
| Station de travail 8 canaux | 128 Go+ | DeepSeek 284B ou Nemotron 30B | 111,62 tok/s (30B uniquement) |
- La mémoire culmine à 57,61 à 58,9 Gio en contexte 256K, sous le plafond des 62,5 Gio utilisables. Fermez tout le reste avant de le charger.
- Le binaire précompilé est réservé à Linux x86_64 (
llama-server-modchip-linux-x86_64). Le script d'installation./modchipcouvre Linux et macOS. Les résultats Apple Silicon dans le README concernent les modèles 30B, pas le 284B. [VÉRIFIER] si le 284B tourne sur un Mac de 64 Go. - La bande passante mémoire est le facteur limitant. La FAQ indique qu'une carte serveur à 8 ou 12 canaux multiplie le décodage par environ 3 à 4 par rapport à une DDR5 bi-canal.
Le dépôt fournit une vérification de compatibilité qui ne télécharge aucun modèle :
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Lisez le script avant de le rediriger vers Python.
Comment faire tourner DeepSeek V4 Flash sans GPU, étape par étape
Voie 1 : l'installation guidée
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat ouvre un chat en terminal avec les tokens par seconde en direct. Autres sous-commandes :
| Commande | Ce qu'elle fait |
|---|---|
./modchip web |
Chat web et télémétrie sur http://127.0.0.1:8787 |
./modchip bench |
Test de vitesse de 30 secondes avec une fiche de scores partageable |
./modchip claude |
Lance Claude Code connecté au moteur local |
./modchip status / stop |
Vérifie l'état de préparation ou arrête les services en arrière-plan |
Voie 2 : le serveur direct
Cette méthode récupère le GGUF et le serveur précompilé depuis le dépôt Hugging Face et le démarre sur le port 8080 :
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Définissez -t selon votre nombre de cœurs physiques. L'exemple utilise un contexte de 32K ; les chiffres en 256K utilisent -c 262144.
Un piège : le llama.cpp standard, Ollama et LM Studio ne peuvent pas charger ce fichier. Le checkpoint utilise un type de tenseur personnalisé (ID 40), donc les versions non patchées échouent avec unknown tensor type 40. Utilisez le script ./modchip ou le binaire fourni.
Le serveur est un llama-server llama.cpp patché, il prend donc en charge la route style OpenAI /v1/chat/completions :
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
La passerelle sur le port 8787
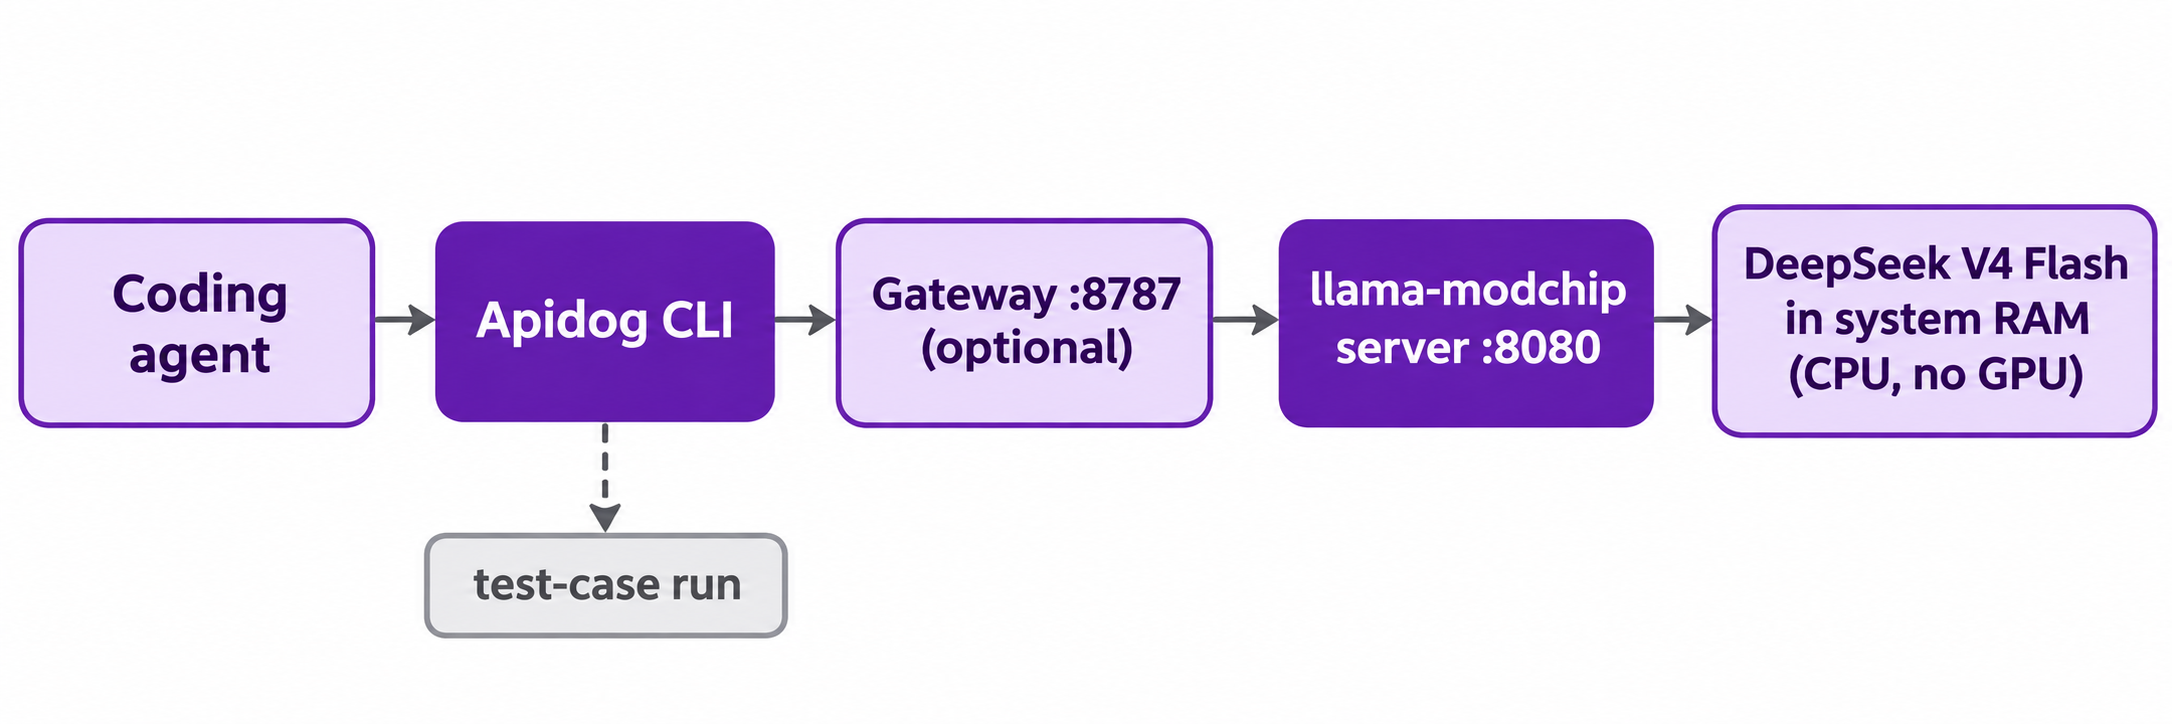
gateway/sse_gateway.py est un proxy sur 127.0.0.1:8787 qui transmet au moteur (définissez l'amont avec LLAMA_BACKEND_URL). Il expose /v1/chat/completions, /v1/messages, /v1/models et /health. Définissez GATEWAY_API_KEY et il exigera un jeton bearer. ./modchip claude pointe Claude Code vers cette passerelle.
Vitesse et qualité : ce que coûte 1,71 bits par poids
Les chiffres de vitesse sont réels mais spécifiques. Voici le tableau du mainteneur pour DeepSeek-V4-Flash en contexte 256K sur le Ryzen 9 9955HX :
| Configuration | Préremplissage | Décodage | Décodage avec drafteur |
|---|---|---|---|
UD-IQ1_S non patché (76,87 Gio) |
OOM ou swap sur 64 Go | 5,91 tok/s | N/A |
| v2.4.0 par défaut (Top-6, 56,56 Gio) | 43,16 à 44,36 tok/s | 9,06 à 9,95 tok/s | 11,5 à 14,7 tok/s |
| Top-5 sur les couches tardives | 43,16 à 44,36 tok/s | 9,68 à 9,87 tok/s | 12,2 à 15,1 tok/s |
| Top-4 plus SwiGLU gate-first | 43,16 à 44,36 tok/s | 10,12 à 10,74 tok/s | 13,0 à 16,0 tok/s |
Vous passez aux lignes plus rapides avec LLAMA_MOE_TOP_K=5 ou 4. Le README indique que le Top-5 ajoute environ 0,42 % de perplexité par rapport à son propre paramétrage par défaut.
Deux réserves revenaient sans cesse sur Hacker News :
- « Sans perte » signifie sans perte par rapport au fichier 1,71 bpw, pas par rapport aux poids d'origine. La similarité cosinus de 1,00000 compare les runtimes patché et non patché sur le même checkpoint comprimé, où la plupart des experts routés sont en
IQ1_S(environ 1,56 bits). Les commentateurs ont souligné que la qualité baisse généralement en dessous de 4 bits, et le README ne contient aucune comparaison avec une sortie en pleine précision. - Le préremplissage est le goulot d'étranglement pour les agents. À 44 tokens par seconde, un prompt de 10 000 tokens prend environ 225 secondes avant le premier token de sortie. Les instantanés KV (restauration en 13,1 à 32,6 ms pour un prompt Claude Code à 40 outils) aident lors des tours répétés, pas en contexte neuf.
Une dernière chose : il s'agit du checkpoint V4-Flash 0731 de juillet. DeepSeek a depuis publié V4.1 Flash. Si les poids les plus récents vous importent, lisez d'abord comment DeepSeek V4.1 Flash se compare à V4 Pro et V4 Flash.
Traitez le 284B local comme un modèle privé et hors ligne pour les brouillons, les traitements par lots et les expérimentations, et testez-le d'abord sur vos propres prompts.
Laissez votre agent de codage tester le point de terminaison local avec Apidog CLI
Un modèle local reste une API : répond-il, le JSON est-il valide, le dernier changement d'option a-t-il cassé quelque chose ? Votre agent de codage peut exécuter ces vérifications avec Apidog CLI, qui fonctionne sur votre machine et atteint directement 127.0.0.1. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install ajoute la compétence Apidog afin que votre agent connaisse les commandes. Donnez ensuite à l'agent, par exemple Claude Code, un seul prompt :
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
L'agent lit les schémas, valide ses charges utiles, puis écrit et exécute :
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (en millisecondes) est important : un modèle 284B limité par le CPU est assez lent pour déclencher un timeout par défaut.
L'intérêt, c'est la comparaison : pointez un second environnement vers l'API hébergée de DeepSeek, exécutez le même cas de test, et voyez où la quantification locale dérive. Ajoutez --upload-report pour consulter les exécutions dans l'application. Voir Apidog CLI dans Claude Code et le guide d'installation d'Apidog CLI. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
CPU local vs GPU vs API hébergée
| Option | Ce qu'il vous faut | Idéal pour |
|---|---|---|
| llama-modchip sur CPU | 64 Go de RAM, CPU x86_64 moderne | Travail privé et hors ligne sans facture d'API, si vous acceptez un préremplissage lent |
| Serving GPU avec vLLM ou SGLang | Beaucoup de VRAM ou une machine multi-GPU | Auto-hébergement rapide et en meilleure précision |
| API hébergée DeepSeek | Une clé API | Sortie de pleine qualité à vitesse production |
Pour la voie GPU, suivez comment faire tourner DeepSeek V4 localement, qui couvre vLLM et SGLang. Pour les calculs mémoire du checkpoint le plus récent, voir comment faire tourner DeepSeek V4.1 Flash localement. Pour tester n'importe quel modèle local en tant qu'API, voir tester les LLM locaux en tant qu'API.
FAQ
Peut-on vraiment faire tourner DeepSeek V4 Flash sans GPU ?
Oui, avec llama-modchip et 64 Go de RAM. Le mainteneur annonce 44,36 tokens par seconde en préremplissage et 9 à 15 tokens par seconde en décodage sur un Ryzen 9 9955HX à 16 cœurs, avec la totalité du modèle de 56,56 Gio en RAM et aucun swap.
Cela fonctionne-t-il avec Ollama ou LM Studio ?
Non. Le checkpoint utilise un type de tenseur personnalisé, et llama.cpp non patché, Ollama et LM Studio le rejettent avec unknown tensor type 40. Utilisez le script ./modchip du dépôt ou le binaire llama-server-modchip-linux-x86_64 fourni.
Et si je n'ai que 16 ou 32 Go de RAM ?
Utilisez plutôt un MoE 30B. Le README associe ce niveau au Nemotron-3.5-30B-A3B sous forme de fichier de 14,35 Gio et annonce 25,0 à 60,4 tokens par seconde sur CPU.
Quelle est la qualité de la sortie à 1,71 bits par poids ?
Le projet ne compare pas avec le DeepSeek en pleine précision, et les commentateurs de Hacker News étaient sceptiques à cette taille. Testez vos prompts contre l'API hébergée avant de vous y fier.
Le serveur local est-il compatible OpenAI ?
Oui. C'est un llama-server llama.cpp patché, donc /v1/chat/completions fonctionne sur le port 8080. La passerelle optionnelle sur le port 8787 sert également /v1/messages, la route style Anthropic utilisée par Claude Code.
Mon agent de codage peut-il tester le modèle local automatiquement ?
Oui. Installez Apidog CLI, exécutez apidog skill install, et demandez à votre agent de créer un environnement pointant vers http://127.0.0.1:8080 et un cas de test pour /v1/chat/completions. Il exécute ensuite apidog test-case run et signale les échecs.