
La série Qwen d'Alibaba continue de repousser les limites des grands modèles linguistiques, et Qwen3-Next-80B-A3B se distingue comme un excellent exemple d'efficacité rencontrant la haute performance. Les ingénieurs et les développeurs recherchent des modèles offrant un raisonnement robuste sans la surcharge computationnelle des géants denses. Ce modèle répond directement à cette demande, affichant 80 milliards de paramètres tout en n'activant que 3 milliards par jeton. Par conséquent, les équipes obtiennent des vitesses d'inférence plus rapides et des coûts de formation réduits, ce qui le rend idéal pour les déploiements réels.
Dans cet article, vous explorerez les composants essentiels de Qwen3-Next-80B-A3B, disséquerez son architecture innovante, examinerez les données de performance empiriques et maîtriserez son API grâce à des étapes pratiques. De plus, vous intégrerez des outils comme Apidog pour améliorer votre flux de travail. À la fin, vous posséderez les connaissances nécessaires pour déployer efficacement ce modèle dans vos applications.
Qu'est-ce qui définit Qwen3-Next-80B-A3B ? Caractéristiques clés et innovations
Qwen3-Next-80B-A3B émerge de la famille Qwen d'Alibaba en tant que modèle MoE (Mixture of Experts) sparse optimisé à la fois pour la vitesse et la capacité. Les développeurs n'activent qu'une fraction de ses paramètres pendant l'inférence, ce qui se traduit par des économies de ressources substantielles. Plus précisément, ce modèle utilise une configuration MoE ultra-sparse avec 512 experts, acheminant vers 10 par jeton, ainsi qu'un expert partagé. En conséquence, il rivalise avec les performances de ses homologues plus denses comme Qwen3-32B tout en consommant beaucoup moins d'énergie.
De plus, le modèle prend en charge la prédiction multi-jetons, une technique qui accélère le décodage spéculatif. Cette fonctionnalité permet au modèle de générer plusieurs jetons simultanément, augmentant le débit lors des étapes de décodage. Les développeurs apprécient cela pour les applications nécessitant des réponses rapides, telles que les chatbots ou les outils d'analyse en temps réel.
La série comprend des variantes adaptées à des besoins spécifiques : le modèle de base pour le pré-entraînement général, la version instruct pour les tâches conversationnelles affinées, et la variante thinking pour les chaînes de raisonnement avancées. Par exemple, Qwen3-Next-80B-A3B-Thinking excelle dans la résolution de problèmes complexes, surpassant des modèles comme Gemini-2.5-Flash-Thinking sur les benchmarks. De plus, il gère 119 langues, permettant des déploiements multilingues sans ré-entraînement.
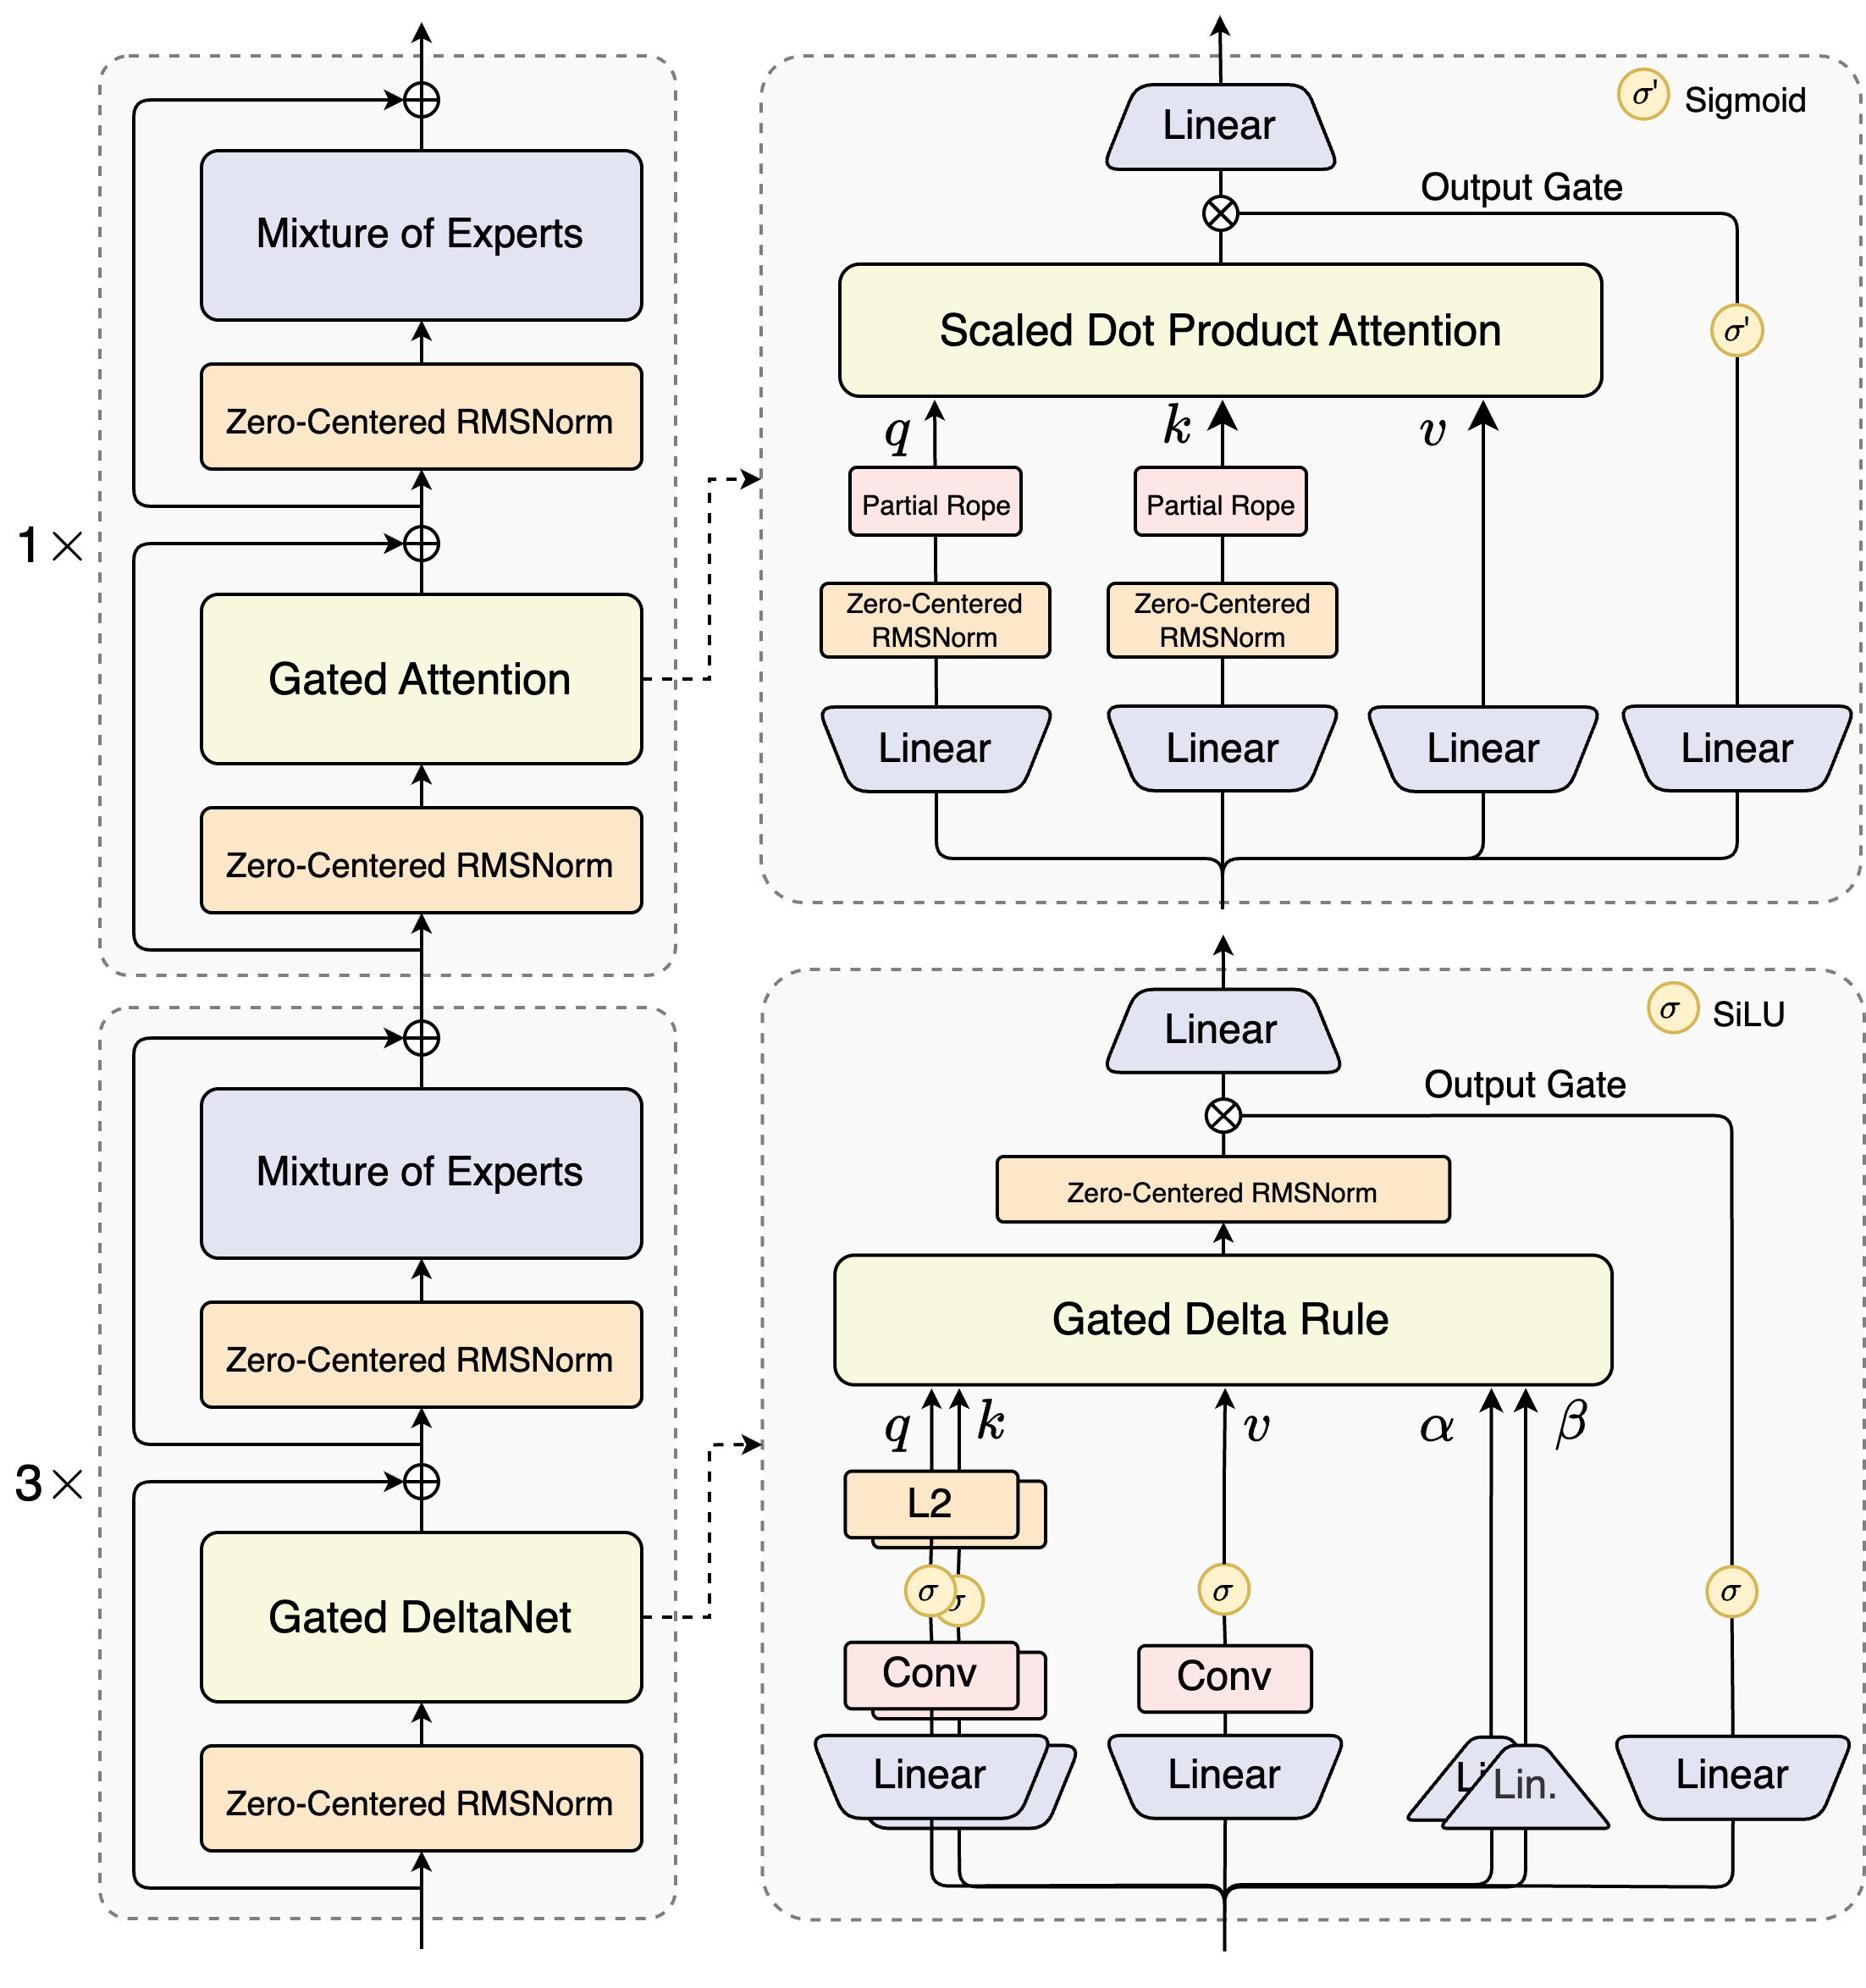
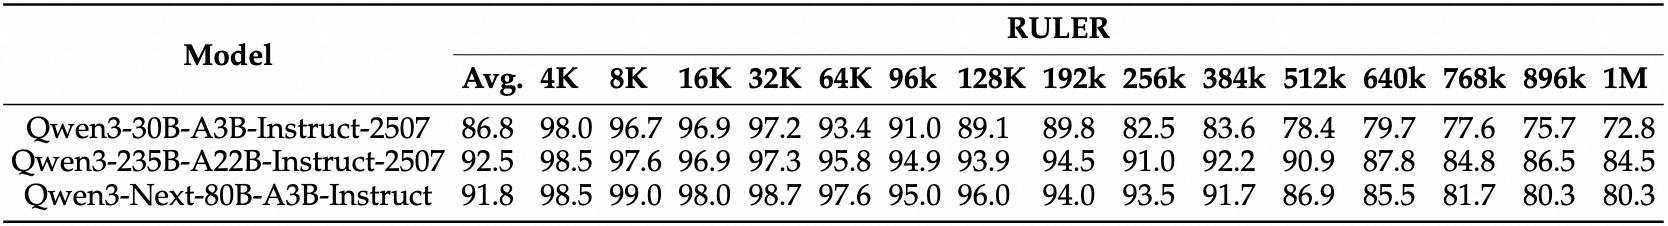
Les détails de l'entraînement révèlent d'autres efficacités. Les ingénieurs d'Alibaba pré-entraînent ce modèle en utilisant des méthodes efficaces en termes de mise à l'échelle, n'entraînant que 10 % du coût par rapport à Qwen3-32B. Ils exploitent une disposition hybride sur 48 couches avec une dimension cachée de 2048, assurant une distribution équilibrée des calculs. Par conséquent, le modèle démontre une compréhension supérieure des contextes longs, maintenant la précision au-delà de 32K jetons là où d'autres échouent.
En pratique, ces fonctionnalités permettent aux développeurs de mettre à l'échelle des solutions d'IA de manière rentable. Que vous construisiez des moteurs de recherche d'entreprise ou des générateurs de contenu automatisés, Qwen3-Next-80B-A3B constitue l'épine dorsale d'applications innovantes. S'appuyant sur cette base, la section suivante examine les éléments architecturaux qui rendent de telles efficacités possibles.
Disséquer l'architecture de Qwen3-Next-80B-A3B : Un plan technique
Les architectes de Qwen3-Next-80B-A3B introduisent une conception hybride qui combine des mécanismes de gating avec des techniques de normalisation avancées. Au cœur se trouve une couche MoE (Mixture of Experts), où les experts se spécialisent dans des chemins de calcul distincts. Le modèle achemine les entrées dynamiquement, activant un sous-ensemble pour minimiser la surcharge. Par exemple, le bloc d'attention gated traite les requêtes, les clés et les valeurs via des embeddings RoPE partiels et des couches RMSNorm centrées sur zéro, améliorant la stabilité dans les longues séquences.
Considérez le module d'attention par produit scalaire mis à l'échelle. Il intègre des projections linéaires suivies de portes de sortie modulées par des activations sigmoïdes. Cette configuration permet un contrôle précis du flux d'informations, évitant la dilution dans les espaces de haute dimension. De plus, la RMSNorm centrée sur zéro précède et suit ces opérations, centrant les activations autour de zéro pour atténuer les problèmes de gradient pendant l'entraînement.
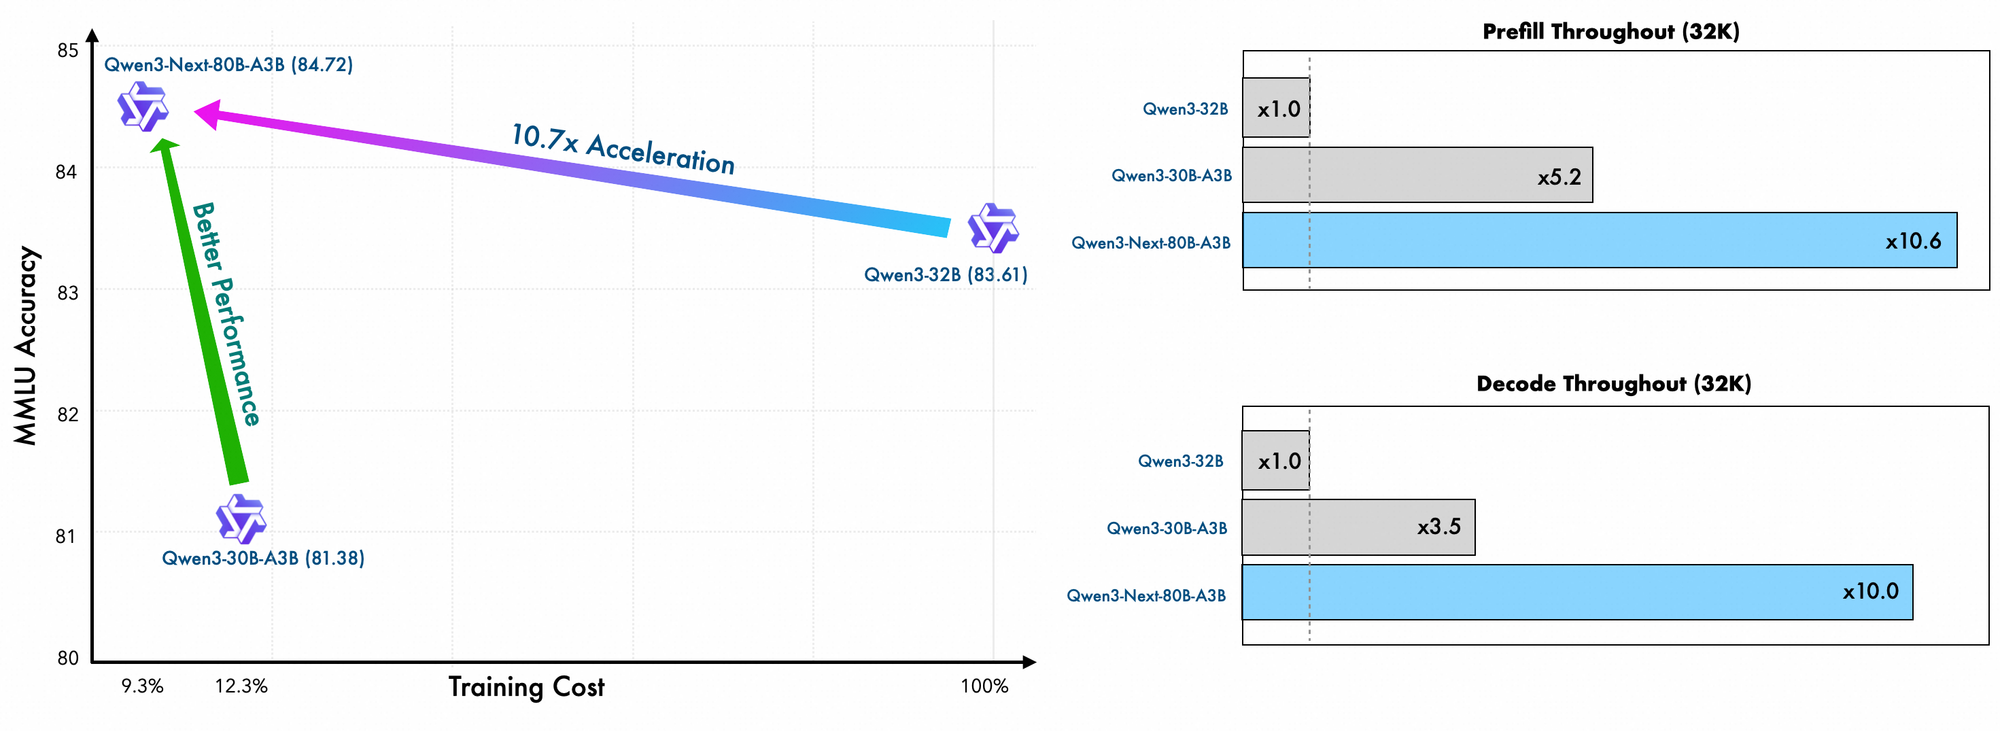
Le diagramme illustre deux blocs principaux : le supérieur se concentre sur l'attention gated avec attention par produit scalaire mis à l'échelle, tandis que l'inférieur met l'accent sur le DeltaNet gated. Dans le chemin d'attention (expansion 1x), les entrées passent par une RMSNorm centrée sur zéro, puis dans le cœur de l'attention gated. Ici, les projections de requête (q), clé (k) et valeur (v) utilisent un RoPE partiel pour l'encodage positionnel. Après l'attention, une autre RMSNorm et des couches linéaires alimentent le MoE, qui utilise une sortie gated par sigmoïde.
En passant au chemin DeltaNet (expansion 3x), l'architecture utilise une règle Delta gated pour des prédictions raffinées. Elle présente une normalisation L2 sur q et k, des couches convolutionnelles pour l'extraction de caractéristiques locales, et des activations SiLU pour la non-linéarité. La porte de sortie, combinée à une projection linéaire, assure des sorties multi-jetons cohérentes. La conception de ce bloc prend en charge le décodage spéculatif du modèle, où il prédit plusieurs jetons à l'avance, vérifiés lors des passages ultérieurs.
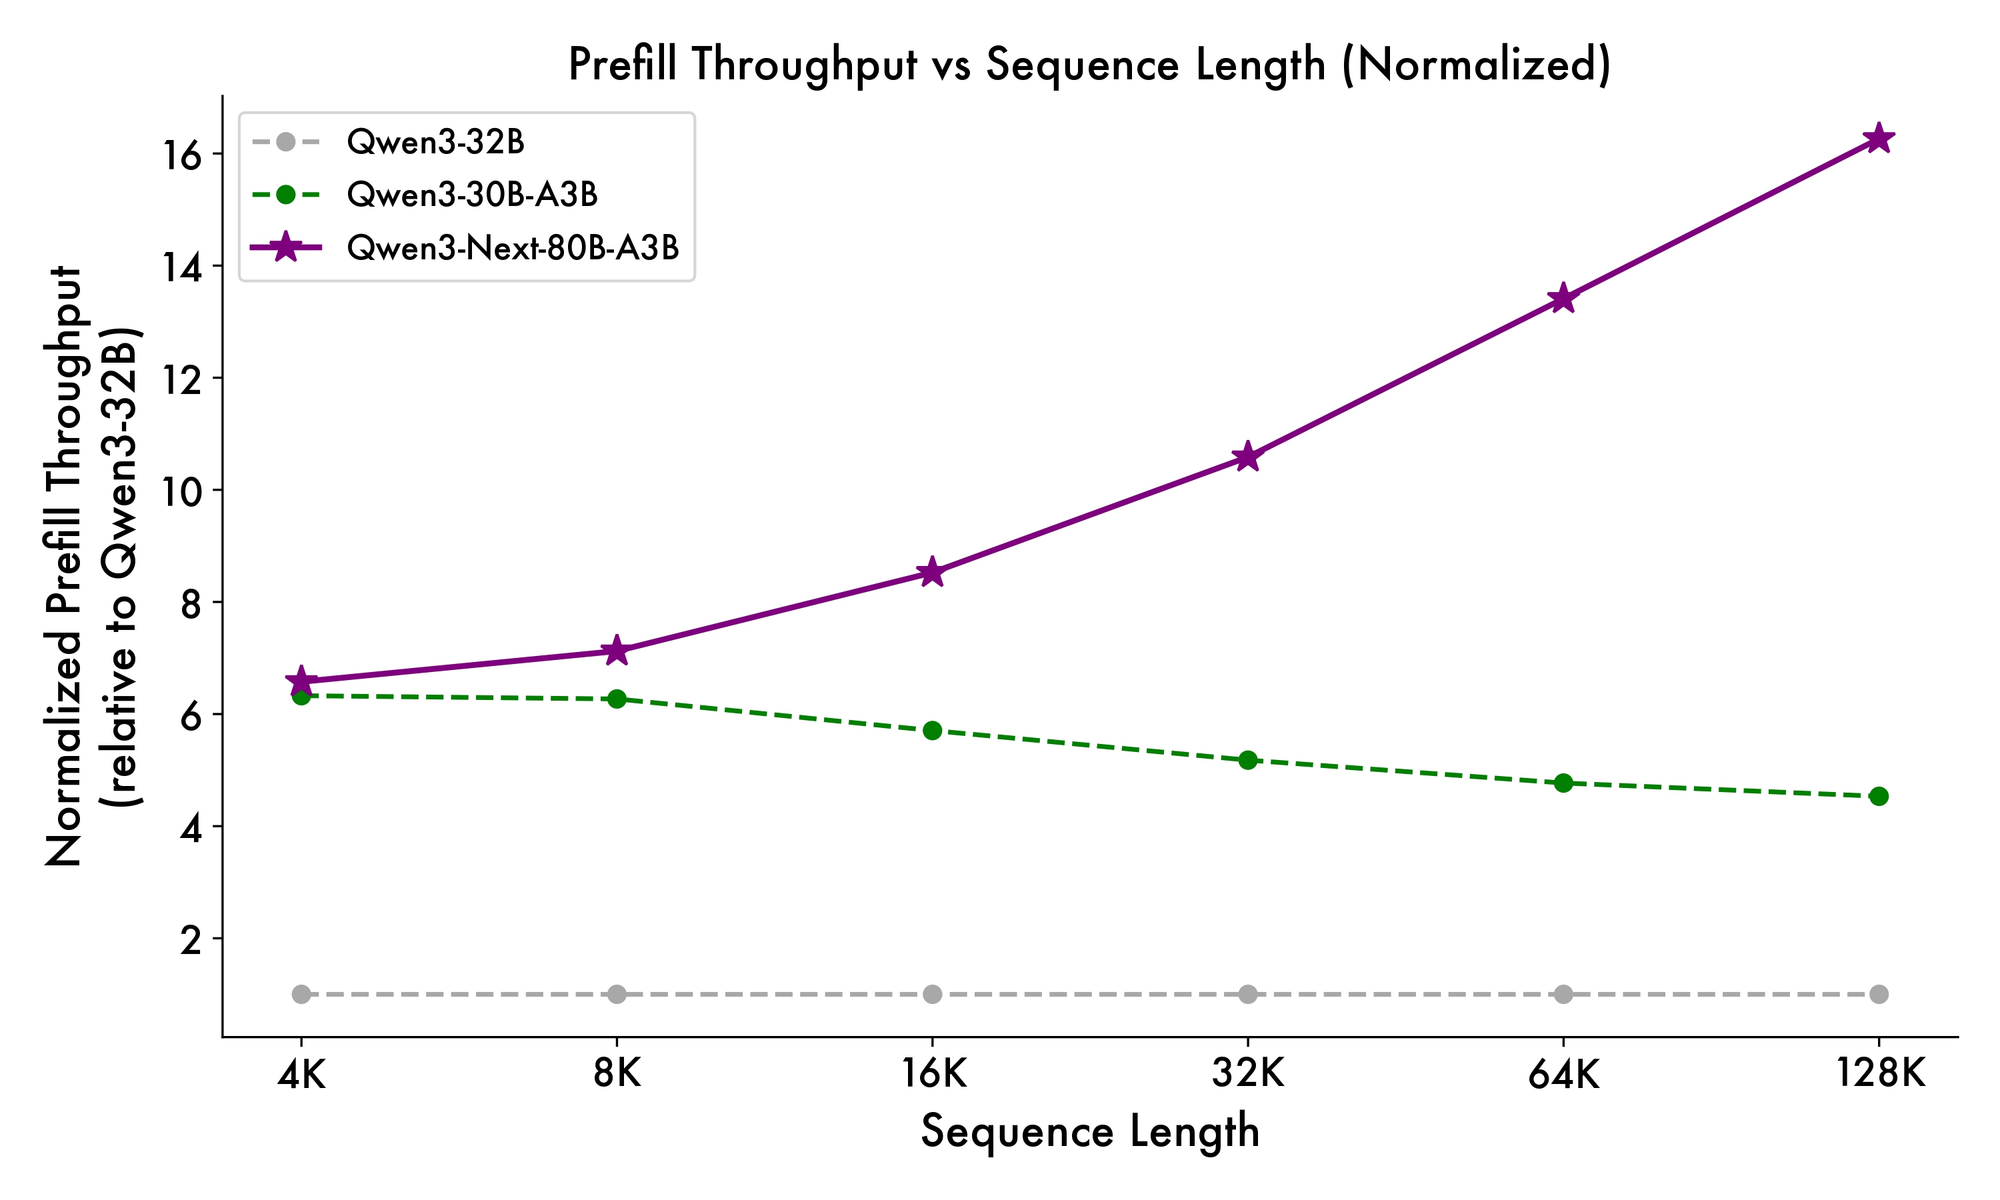
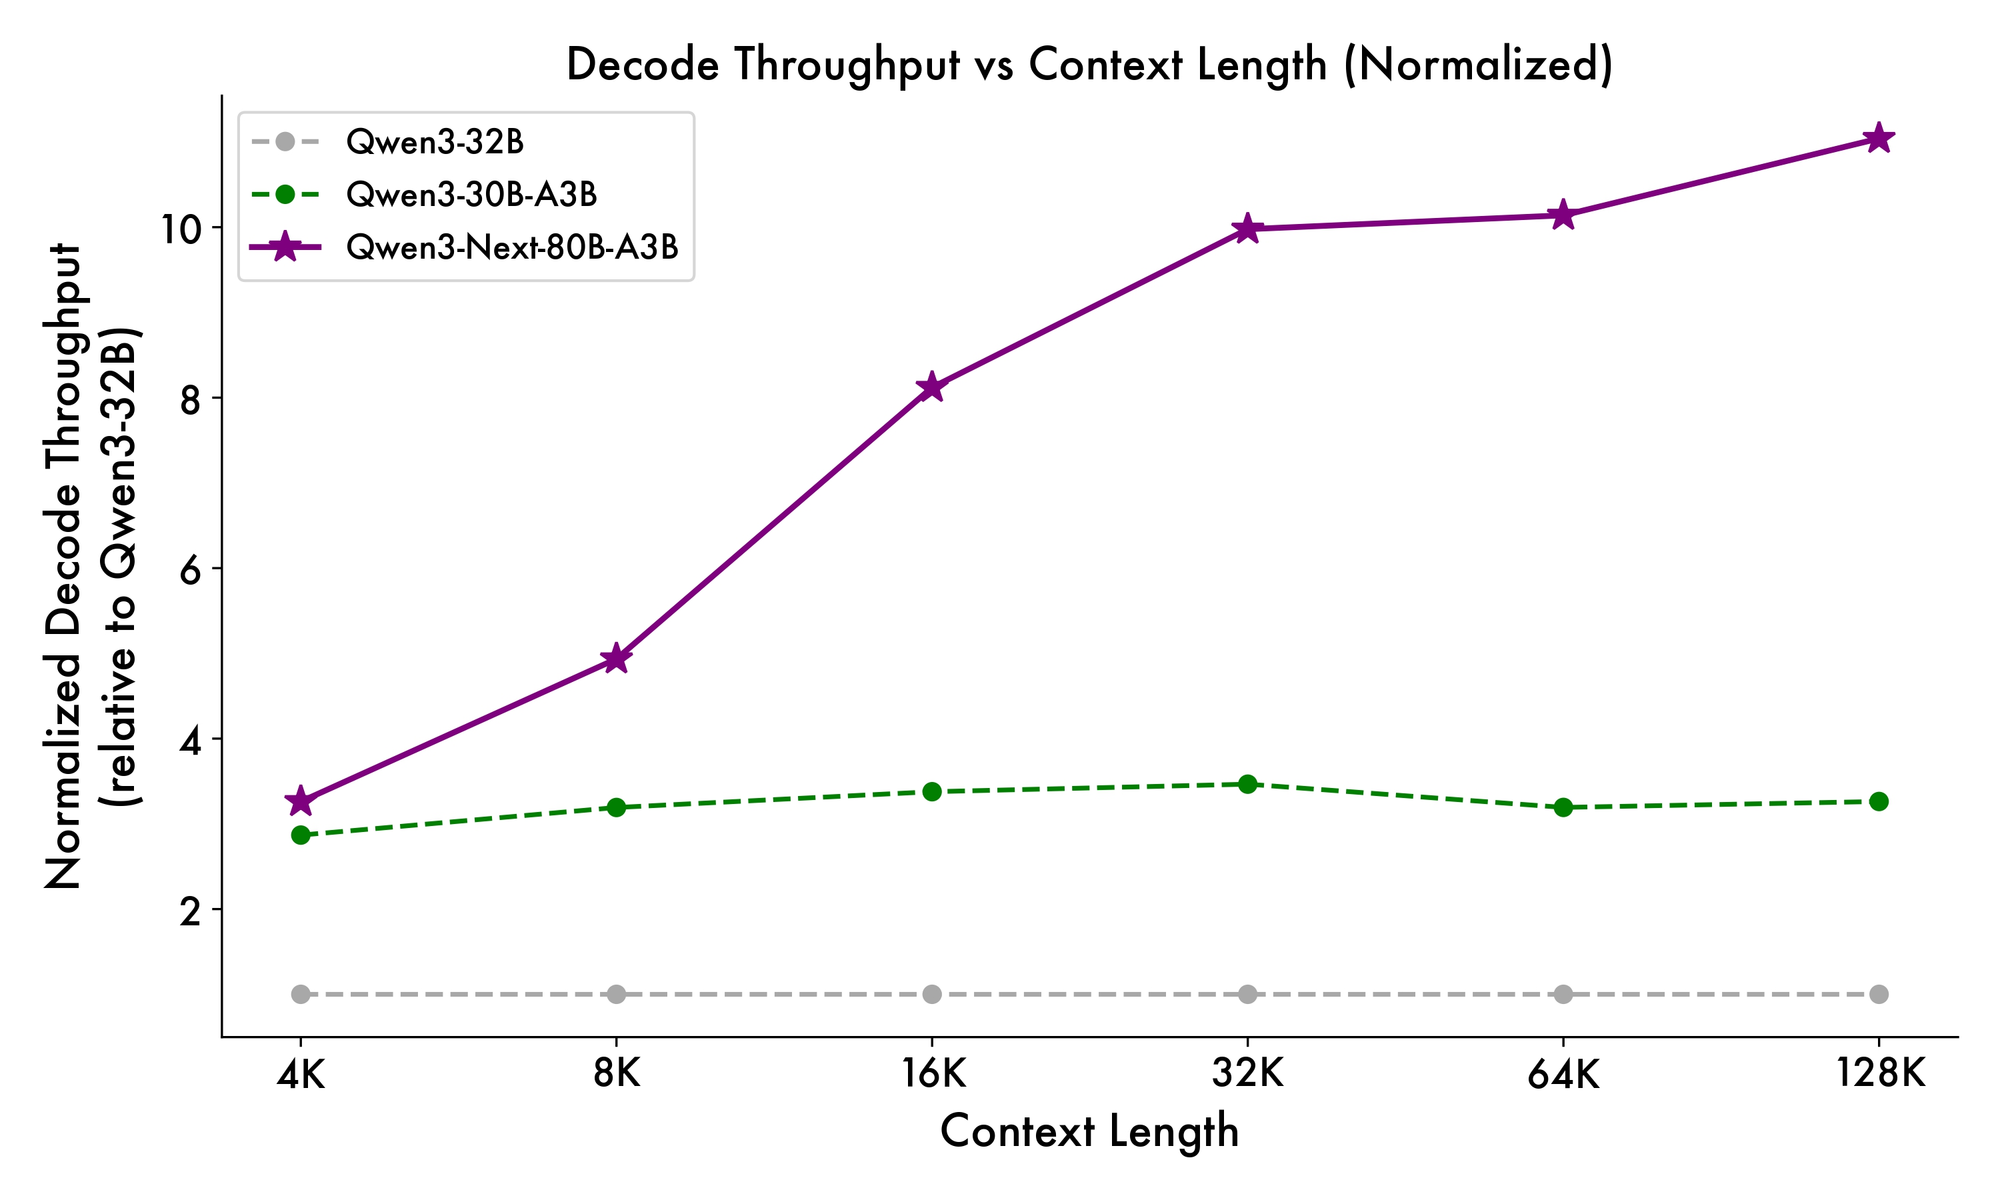
De plus, la structure globale intègre un expert partagé dans le MoE pour gérer les motifs communs à travers les jetons, réduisant ainsi la redondance. Les embeddings de corde partiels dans les projections préservent l'invariance rotationnelle pour des contextes étendus. Comme en témoignent les benchmarks, cette configuration produit un débit près de 7 fois supérieur à des longueurs de contexte de 4K par rapport à Qwen3-32B. Au-delà de 32K jetons, les vitesses dépassent 10x, ce qui le rend adapté aux tâches d'analyse de documents ou de génération de code.
Les développeurs bénéficient de cette modularité lors du réglage fin. Vous pouvez échanger des experts ou ajuster les seuils de routage pour spécialiser le modèle dans des domaines comme la finance ou la santé. En substance, l'architecture optimise non seulement le calcul mais favorise également l'adaptabilité. Avec ces informations, vous allez maintenant voir comment ces éléments se traduisent en gains de performance mesurables.
Évaluation de Qwen3-Next-80B-A3B : Les métriques de performance qui comptent
Les évaluations empiriques positionnent Qwen3-Next-80B-A3B comme un leader en IA axée sur l'efficacité. Sur des benchmarks standard comme MMLU et HumanEval, le modèle de base surpasse Qwen3-32B malgré l'utilisation d'un dixième des paramètres actifs. Plus précisément, il atteint 78,5 % sur MMLU pour les connaissances générales, devançant les concurrents de 2 à 3 points dans les sous-ensembles de raisonnement.
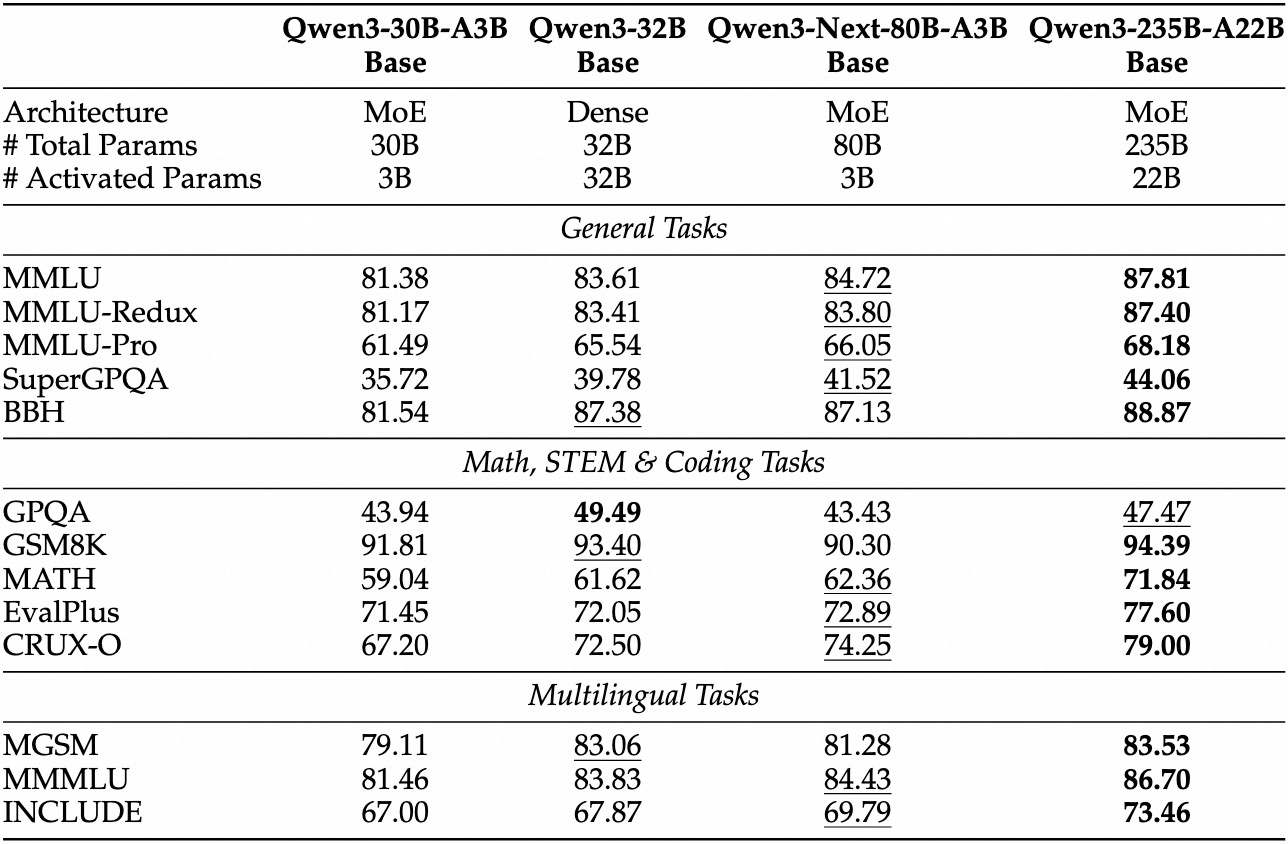
Pour la variante instruct, les tâches conversationnelles révèlent des forces dans le suivi des instructions. Il obtient un score de 85 % sur MT-Bench, démontrant des dialogues multi-tours cohérents. Pendant ce temps, le modèle thinking brille dans les scénarios de chaîne de pensée, atteignant 92 % sur GSM8K pour les problèmes de mathématiques — surpassant Qwen3-30B-A3B-Thinking de 4 %.
La vitesse d'inférence est une pierre angulaire de son attrait. À un contexte de 4K, le débit de décodage atteint 4 fois celui de Qwen3-32B, et jusqu'à 10 fois pour des longueurs plus importantes. Les étapes de pré-remplissage, critiques pour le traitement des invites, montrent des améliorations de 7 fois, grâce au MoE sparse. La consommation d'énergie diminue en conséquence, avec des coûts d'entraînement à 10 % de ceux des modèles plus denses.
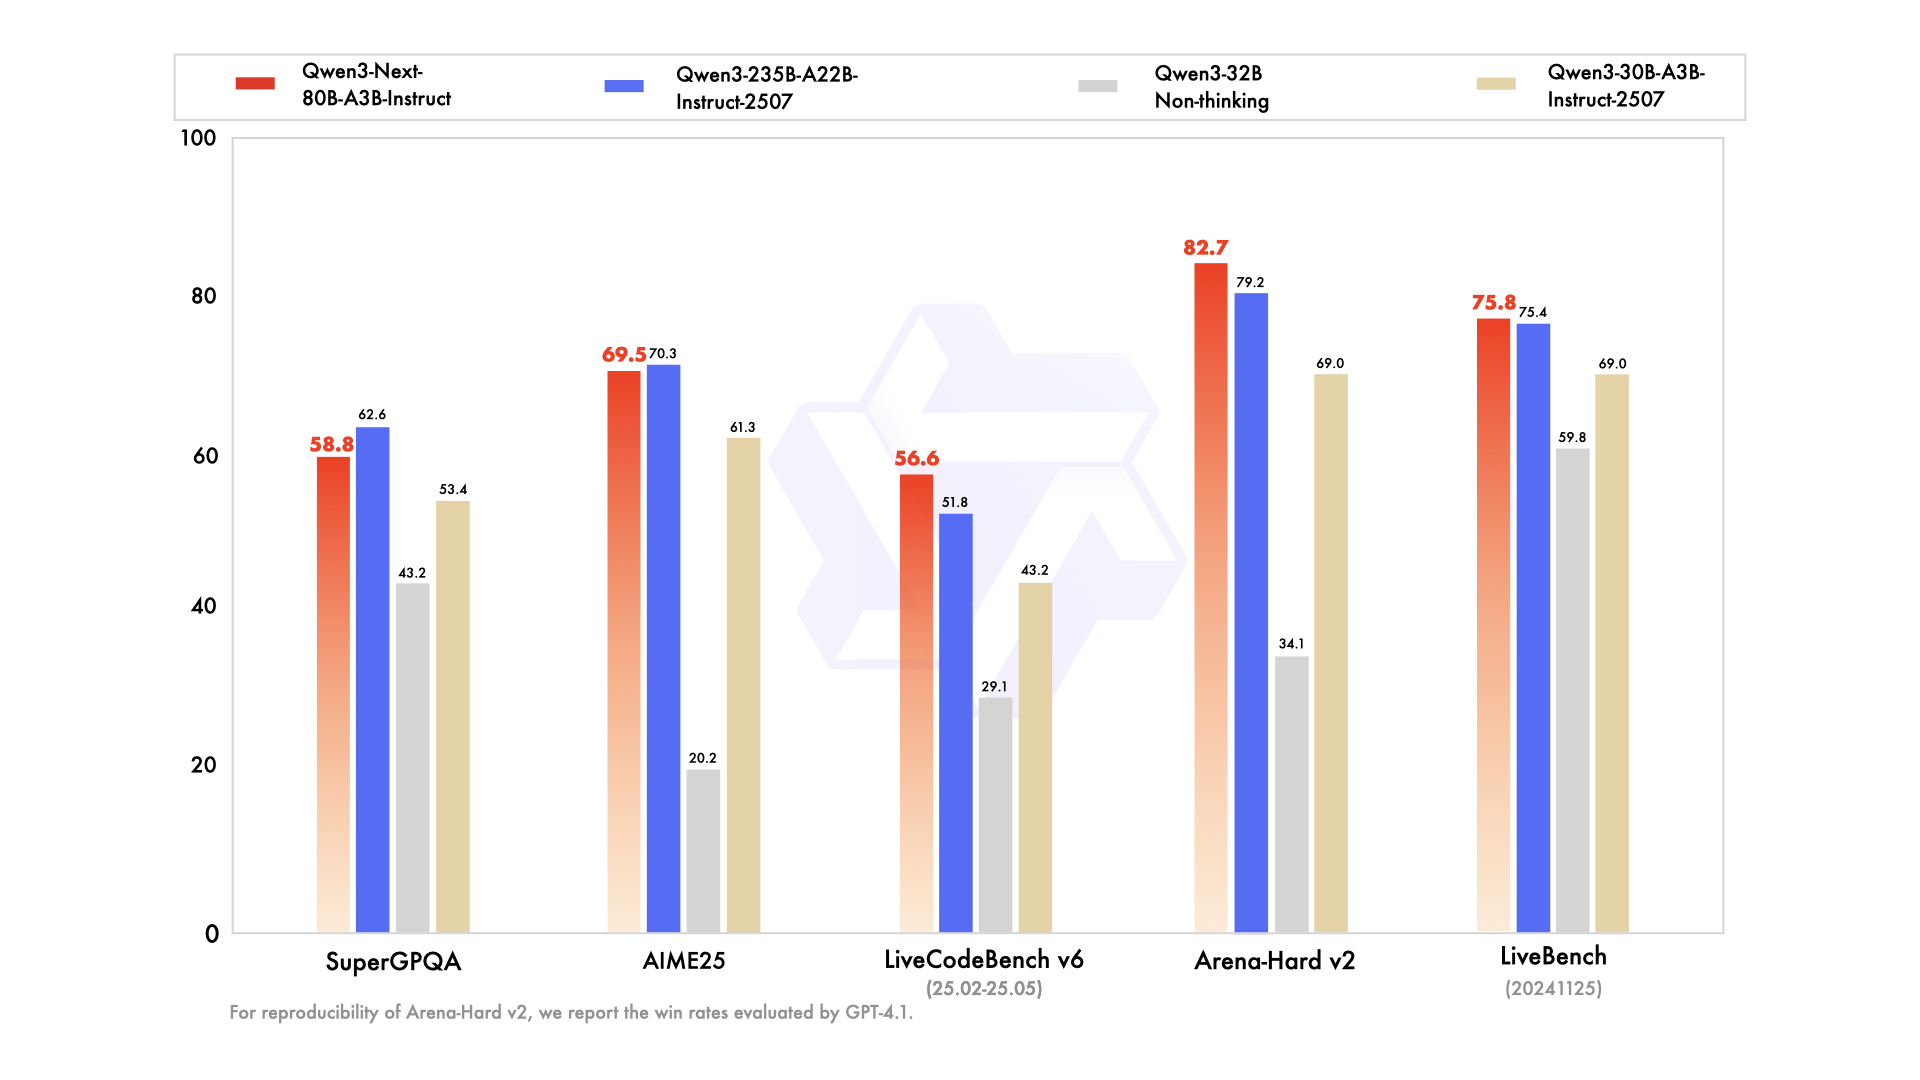
Les comparaisons avec ses rivaux soulignent son avantage. Face à Llama 3.1-70B, Qwen3-Next-80B-A3B-Thinking est en tête en RULER (rappel de contexte long) de 15 %, rappelant avec précision des détails de 128K jetons. Par rapport à DeepSeek-V2, il offre un meilleur support multilingue sans sacrifier la vitesse.
| Benchmark | Qwen3-Next-80B-A3B-Base | Qwen3-32B-Base | Llama 3.1-70B |
|---|---|---|---|
| MMLU | 78.5% | 76.2% | 77.8% |
| HumanEval | 82.1% | 79.5% | 81.2% |
| GSM8K | 91.2% | 88.7% | 90.1% |
| MT-Bench | 84.3% (Instruct) | 81.9% | 83.5% |
Ce tableau souligne une surperformance constante. En conséquence, les organisations l'adoptent pour la production, équilibrant qualité et coût. Passant de la théorie à la pratique, vous vous équipez maintenant d'outils d'accès à l'API.
Configuration de l'accès à l'API Qwen3-Next-80B-A3B : Prérequis et authentification
Alibaba fournit l'API Qwen via DashScope, sa plateforme cloud, assurant une intégration transparente. Tout d'abord, créez un compte Alibaba Cloud et naviguez vers la console Model Studio. Sélectionnez Qwen3-Next-80B-A3B dans la liste des modèles — disponible en modes base, instruct et thinking.
Obtenez votre clé API depuis le tableau de bord sous "Clés API". Cette clé authentifie les requêtes, avec des limites de débit basées sur votre niveau (le niveau gratuit offre 1M de jetons/mois). Pour les appels compatibles OpenAI, définissez l'URL de base sur https://dashscope.aliyuncs.com/compatible-mode/v1. Les points d'extrémité DashScope natifs utilisent https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation.
Installez le SDK Python via pip : pip install dashscope. Cette bibliothèque gère la sérialisation, les tentatives et l'analyse des erreurs. Alternativement, utilisez des clients HTTP comme requests pour des implémentations personnalisées.
Les meilleures pratiques de sécurité dictent de stocker les clés dans des variables d'environnement : export DASHSCOPE_API_KEY='votre_clé_ici'. Par conséquent, votre code reste portable entre les environnements. Une fois la configuration terminée, vous pouvez procéder à la création de votre premier appel API.
Guide pratique : Utiliser l'API Qwen3-Next-80B-A3B avec Python et DashScope
DashScope simplifie les interactions avec Qwen3-Next-80B-A3B. Commencez par une requête de génération de base en utilisant la variante instruct pour des réponses de type chat.
Voici un script de démarrage :
import os
from dashscope import Generation

os.environ['DASHSCOPE_API_KEY'] = 'your_api_key'

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Explain the benefits of MoE architectures in LLMs.',
    max_tokens=200,
    temperature=0.7
)

if response.status_code == 200:
    print(response.output['text'])
else:
    print(f"Error: {response.message}")
Ce code envoie une invite et récupère jusqu'à 200 jetons. Le modèle répond par une explication concise, soulignant les gains d'efficacité. Pour le mode thinking, passez à 'qwen3-next-80b-a3b-thinking' et ajoutez des instructions de raisonnement : "Pensez étape par étape avant de répondre."
Des paramètres avancés améliorent le contrôle. Définissez top_p=0.9 pour l'échantillonnage de noyau, ou repetition_penalty=1.1 pour éviter les boucles. Pour les contextes longs, spécifiez max_context_length=131072 pour tirer parti de la capacité de 128K du modèle.
Gérez le streaming pour les applications en temps réel :
from dashscope import Streaming

for response in Streaming.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='Generate a Python function for sentiment analysis.',
    max_tokens=500,
    incremental_output=True
):
    if response.status_code == 200:
        print(response.output['text_delta'], end='', flush=True)
    else:
        print(f"Error: {response.message}")
        break
Ceci produit une sortie jeton par jeton, idéale pour les intégrations d'interface utilisateur. La gestion des erreurs inclut la vérification de response.code pour les problèmes de quota (par exemple, 10402 pour un solde insuffisant).
De plus, l'appel de fonctions étend l'utilité. Définissez les outils dans le schéma JSON :
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get current weather",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}}
        }
    }
}]

response = Generation.call(
    model='qwen3-next-80b-a3b-instruct',
    prompt='What\'s the weather in Beijing?',
    tools=tools,
    tool_choice='auto'
)
Le modèle analyse l'intention et renvoie un appel d'outil, que vous exécutez en externe. Ce modèle alimente les flux de travail basés sur des agents. Avec ces exemples, vous construisez des pipelines robustes. Ensuite, intégrez Apidog pour tester et affiner ces appels sans coder à chaque fois.
Améliorer votre flux de travail : Intégrer Apidog pour le test de l'API Qwen3-Next-80B-A3B
Apidog transforme le développement d'API en un processus rationalisé, en particulier pour les points d'extrémité d'IA comme Qwen3-Next-80B-A3B. Cette plateforme combine la conception, la simulation, le test et la documentation dans une seule interface, alimentée par l'IA pour une automatisation intelligente.
Commencez par importer le schéma DashScope dans Apidog. Créez un nouveau projet, ajoutez le point d'extrémité POST https://dashscope.aliyuncs.com/api/v1/services/aigc/text-generation/generation, et collez votre clé API comme en-tête : X-DashScope-API-Key: votre_clé.
Concevez les requêtes visuellement : Définissez le paramètre de modèle sur 'qwen3-next-80b-a3b-instruct', saisissez une invite dans le corps au format JSON {"input": {"messages": [{"role": "user", "content": "Votre invite ici"}]}}. L'IA d'Apidog suggère des cas de test, générant des variations comme des invites de cas limites ou des échantillons à haute température.
Exécutez des collections de tests séquentiellement. Par exemple, évaluez la latence à différentes températures :
- Test 1 : Température 0.1, longueur de l'invite 100 jetons.
- Test 2 : Température 1.0, contexte 10K jetons.
L'outil suit les métriques — temps de réponse, utilisation des jetons, taux d'erreur — et visualise les tendances dans des tableaux de bord. Simulez des réponses pour le développement hors ligne : Apidog simule les sorties de Qwen basées sur des données historiques, accélérant les constructions frontend.
La documentation est générée automatiquement à partir de vos collections. Exportez les spécifications OpenAPI avec des exemples, y compris les spécificités de Qwen3-Next-80B-A3B comme les notes de routage MoE. Les fonctionnalités de collaboration permettent aux équipes de partager des environnements, garantissant des tests cohérents.
Dans un scénario, un développeur teste des invites multilingues. L'IA d'Apidog détecte les incohérences, suggérant des corrections comme l'ajout d'indices linguistiques. En conséquence, le temps d'intégration diminue de 40 %, selon les rapports des utilisateurs. Pour les tests spécifiques à l'IA, exploitez sa génération de données intelligente : Entrez un schéma, et il élabore des invites réalistes imitant le trafic de production.
De plus, Apidog prend en charge les hooks CI/CD, exécutant des tests API dans des pipelines. Connectez-vous à GitHub Actions pour une validation automatisée après le déploiement. Cette approche en boucle fermée minimise les bugs dans les applications alimentées par Qwen.
Stratégies avancées : Optimiser les appels d'API Qwen3-Next-80B-A3B pour la production
L'optimisation élève l'utilisation de base à une fiabilité de niveau entreprise. Premièrement, regroupez les requêtes lorsque c'est possible — DashScope prend en charge jusqu'à 10 invites par appel, réduisant la surcharge pour les tâches parallèles comme les fermes de résumé.
Surveillez l'économie des jetons : Le modèle facture par paramètre actif, donc des invites concises génèrent des économies. Utilisez result_format='message' de l'API pour des sorties structurées, analysant le JSON directement pour éviter le post-traitement.
Pour une haute disponibilité, implémentez des tentatives avec un backoff exponentiel :
import time
from dashscope import Generation

def call_with_retry(prompt, max_retries=3):
    for attempt in range(max_retries):
        response = Generation.call(model='qwen3-next-80b-a3b-instruct', prompt=prompt)
        if response.status_code == 200:
            return response
        time.sleep(2 ** attempt)
    raise Exception("Max retries exceeded")
Ceci gère les erreurs transitoires comme les limites de débit 429. Mettez à l'échelle horizontalement en distribuant les appels à travers les régions — DashScope propose des points d'extrémité à Singapour et aux États-Unis.
Les considérations de sécurité incluent la désinfection des entrées pour prévenir l'injection d'invites. Validez les entrées utilisateur par rapport à des listes blanches avant de les transmettre à l'API. De plus, enregistrez les réponses anonymisées pour l'audit, en conformité avec le RGPD.
Dans les cas extrêmes, comme les contextes ultra-longs, fragmentez les entrées et enchaînez les prédictions. La variante thinking aide ici : Invitez avec "Étape 1 : Analyser la section A ; Étape 2 : Synthétiser avec B." Cela maintient la cohérence sur plus de 100K jetons.
Les développeurs explorent également le réglage fin via la plateforme d'Alibaba, bien que les utilisateurs de l'API s'en tiennent à l'ingénierie d'invites. Par conséquent, ces tactiques assurent des déploiements évolutifs et sécurisés.
En résumé : Pourquoi Qwen3-Next-80B-A3B mérite votre attention
Qwen3-Next-80B-A3B redéfinit l'IA efficace avec son MoE sparse, ses portes hybrides et ses benchmarks supérieurs. Les développeurs exploitent son API via DashScope pour un prototypage rapide, amélioré par des outils comme Apidog pour la rigueur des tests.
Vous détenez maintenant le plan : des nuances architecturales aux optimisations de production. Mettez en œuvre ces connaissances pour construire des systèmes plus rapides et plus intelligents. Expérimentez dès aujourd'hui — l'avenir de l'intelligence évolutive vous attend.