
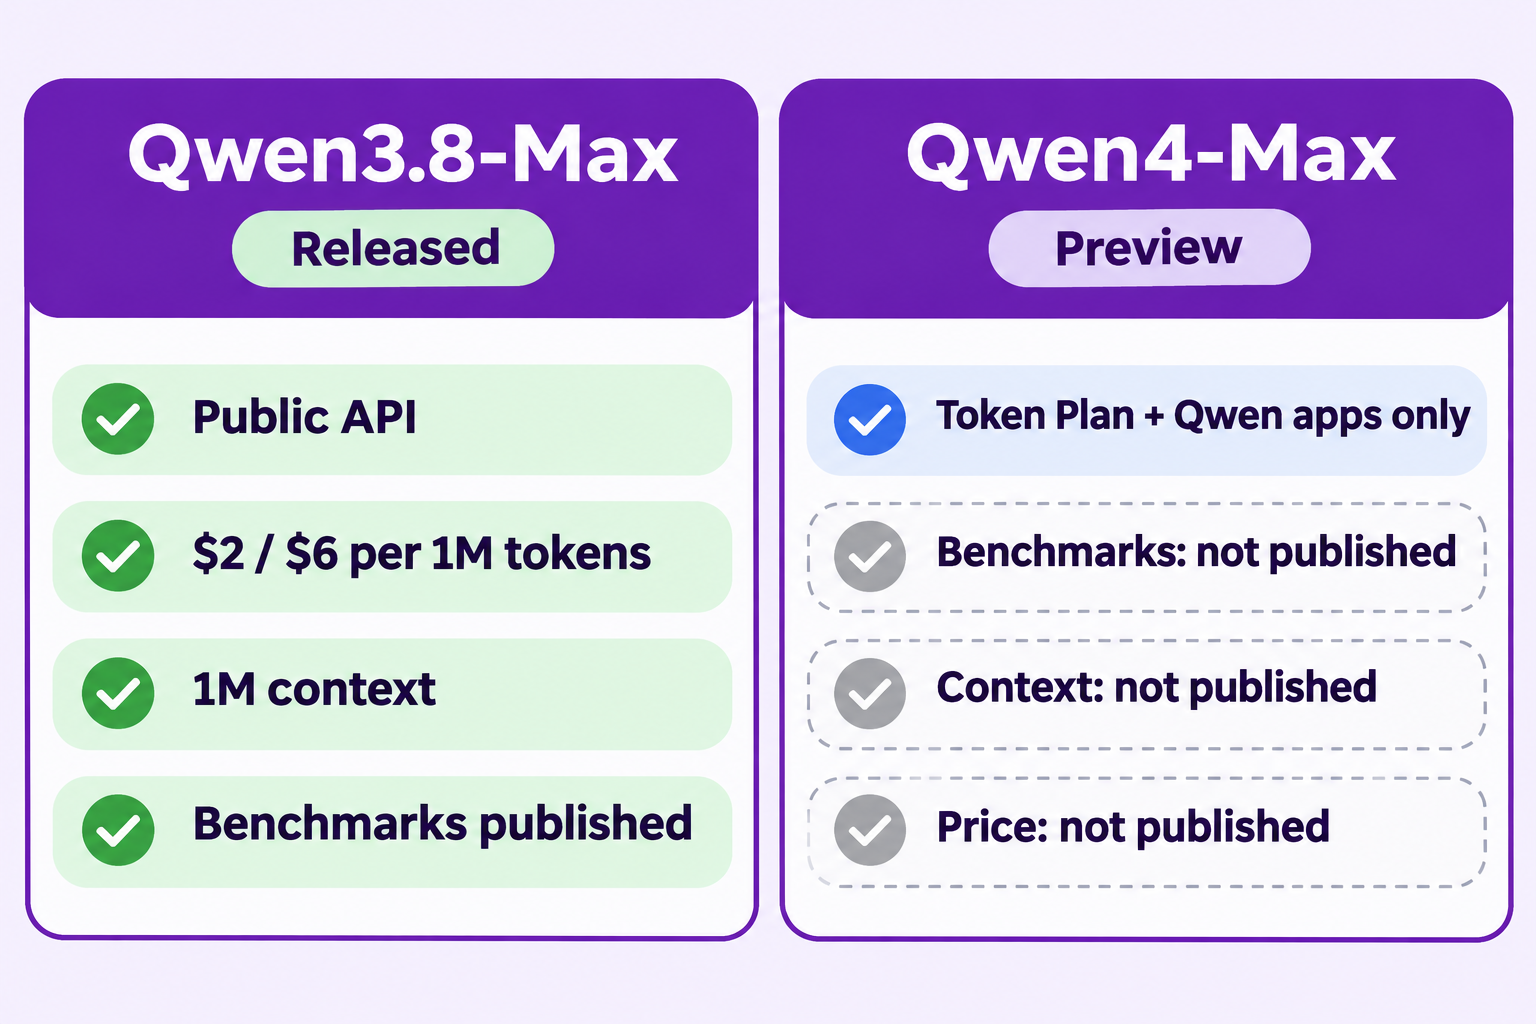
Le choix entre Qwen4-Max et Qwen 3.8 se résume à ceci : Qwen4-Max est une version d'aperçu accessible uniquement via le Token Plan d'Alibaba et ses propres applications, sans benchmarks, sans longueur de contexte et sans prix au token publiés. Qwen3.8-Max est un modèle officiellement sorti, avec une API publique à 2 $/6 $ par million de tokens, un contexte d'1M de tokens et une limite de sortie de 131K. Choisissez Qwen 3.8 pour la production. Testez Qwen4-Max sur vos propres cas d'usage.
C'est la situation au 11 novembre 2026, le jour où l'équipe Qwen d'Alibaba a lancé Qwen4-Max en aperçu. Vous trouverez ci-dessous : les nouveautés, ce que vous pouvez vérifier, ce qui reste encore inaccessible, et un test pratique. Vous découvrez l'un ou l'autre modèle ? Commencez par ce qu'est Qwen4-Max et ce qu'est Qwen 3.8.
Qwen4-Max vs Qwen 3.8 en un coup d'œil
Chaque ligne provient des pages officielles d'Alibaba, vérifiées au 11 novembre 2026.
| Qwen4-Max (aperçu) | Qwen3.8-Max | |
|---|---|---|
| Statut | Aperçu, annoncé le 11 novembre 2026 | Sorti, disponible généralement depuis août 2026 |
| ID du modèle | qwen4-max-preview (Token Plan) |
qwen3.8-max |
| API au token | Non publiée | Oui, compatible OpenAI et Anthropic |
| Prix au token | Non publié | 2 $ en entrée / 6 $ en sortie par million de tokens |
| Fenêtre de contexte | Non publiée | 1M de tokens |
| Sortie maximale | Non publiée (valeur par défaut de Qwen Code : 32 768) | 131K tokens |
| Entrées | Texte et images (tags du Token Plan) | Texte, images et vidéo |
| Paramètres | Non publiés | 2,4T au total, Mixture-of-Experts |
| Benchmarks officiels | Aucun | Tableau du fournisseur publié au lancement |
| Sur le Token Plan | Oui, « 80 % de réduction à durée limitée » | Oui, « 40 % de réduction nocturne » |
Sources : la page du modèle Qwen3.8-Max et la page de tarification du Token Plan. Qwen4-Max n'a pas encore de page dédiée ; son URL renvoyait une erreur 404 lors de notre vérification.
Ce qu'Alibaba annonce comme nouveau dans Qwen4-Max
L'annonce sur X s'ouvre sur « Qwen4 is coming » et liste quatre améliorations. Ce sont les affirmations de l'équipe Qwen, pas des résultats mesurés :
- Des connaissances plus approfondies. De meilleures réponses sur les sujets spécialisés.
- Une meilleure compréhension du monde réel. Un meilleur raisonnement sur le contexte réel.
- Des capacités de codage et d'agent renforcées. Une meilleure planification, utilisation d'outils et travail en plusieurs étapes.
- Conçu pour les tâches du monde réel. La publication mentionne le « codage complexe et le travail sur les connaissances », les « builds front-end » et les « flux de travail logiciels professionnels ».
Notez à quel point cela ressemble au discours de Qwen 3.8. La page du modèle Qwen3.8-Max décrit déjà « un bond en avant complet en matière de codage et de travail professionnel » et des projets autonomes « s'étendant sur plus de 10 jours ». La direction n'a pas changé ; Qwen4-Max prétend aller plus loin sur la même voie. La publication se termine par « Mettez-le à l'épreuve sur un problème réel », ce qui est légitime, puisqu'aucune fiche technique n'existe encore.
Ce que vous pouvez réellement comparer aujourd'hui
Cinq différences sont vérifiables aujourd'hui.
1. Le stade de publication. Qwen3.8-Max est un modèle officiellement sorti, avec des limites de débit documentées (2 000 000 tokens par minute sur sa page modèle). Qwen4-Max est un aperçu. Son comportement, ses limites ou son ID peuvent changer avant sa sortie générale.
2. La façon de l'appeler. Qwen 3.8 fonctionne sur l'API standard pay-as-you-go de Qwen Cloud, vous pouvez donc l'intégrer à un backend de production. Qwen4-Max fonctionne uniquement via les endpoints du Token Plan et les applications d'Alibaba. La FAQ du Token Plan indique que le plan Individuel est destiné au « développement interactif personnel via des outils désignés » et interdit l'automatisation en production, les scripts par lots et les tâches planifiées en arrière-plan.
3. La longueur de sortie en pratique. Qwen3.8-Max affiche une sortie maximale de 131K. Pour Qwen4-Max, le seul chiffre enregistré est une valeur par défaut du client : le guide de configuration de Qwen Code indique que qwen4-max-preview a par défaut une limite de sortie de 32 768 tokens, que vous pouvez augmenter avec generationConfig.samplingParams.max_tokens. C'est un réglage d'outil, pas un plafond du modèle.
4. Les types d'entrée. Le Token Plan associe Qwen4-Max aux tags Génération de texte, Modèle de raisonnement et Compréhension visuelle. La page du modèle Qwen3.8-Max liste les entrées texte, image et vidéo.
5. Les fonctionnalités de l'API. Qwen3.8-Max documente l'appel de fonctions, les sorties structurées, la mise en cache du contexte, les fichiers par lots et le fine-tuning. Rien de tout cela n'est documenté pour Qwen4-Max pour l'instant.
Ce que vous ne pouvez pas encore comparer
Quatre comparaisons que tout le monde attend ne sont pas possibles au 11 novembre 2026.
- Benchmarks. Alibaba n'a publié aucun score pour Qwen4-Max. Pour les chiffres du fournisseur concernant Qwen 3.8, consultez notre analyse des benchmarks de Qwen 3.8.
- Fenêtre de contexte. Certains rapports indiquent que Qwen4-Max aurait un contexte d'1M de tokens. Les pages officielles d'Alibaba ne le confirment pas, et l'analyse approfondie de Kie.ai précise que le chiffre d'1M appartient à Qwen3.8-Max.
- Prix au token. Aucune tarification pay-as-you-go n'existe, donc rien ne peut être comparé aux 2 $/6 $ de Qwen 3.8. Le Token Plan ne précise pas combien de crédits coûte une requête Qwen4-Max.
- Taille et architecture. Alibaba n'a pas publié de nombre de paramètres pour Qwen4-Max. Qwen3.8-Max est un modèle Mixture-of-Experts de 2,4T de paramètres.
Considérez tout article qui remplit ces cases comme de la spéculation. Pour les détails d'accès, voir comment utiliser Qwen4-Max.
Accès et tarification : Qwen4-Max vs Qwen 3.8
Le Token Plan est le seul plan qui propose les deux modèles. Au 11 novembre 2026, sa page pour la région de Singapour affichait ces prix mensuels Individuels en dollars américains :
| Plan | Prix événement | Prix catalogue | Crédits par mois | Agents simultanés |
|---|---|---|---|---|
| Lite | 3,00 $ | 8,00 $ | 20 000 | 1-2 |
| Essential | 5,00 $ | 16,00 $ | 45 000 | 2-3 |
| Standard | 18,00 $ | 25,00 $ | 80 000 | 3-4 |
| Pro | 43,00 $ | 51,00 $ | 200 000 | 6-8 |
Le prix événement s'applique aux nouveaux clients, et la page indique que le prix final est celui affiché au moment du paiement après connexion. Les deux modèles puisent dans le même pool de crédits. qwen4-max-preview arbore le tag « 80 % de réduction à durée limitée », et qwen3.8-max le tag « 40 % de réduction nocturne ».
Qwen 3.8 dispose d'une grille tarifaire pay-as-you-go complète : 2 $ en entrée, 6 $ en sortie, 0,25 $ pour les hits de cache implicite, et 1 $/3 $ pour les fichiers par lots, par million de tokens. Pour tous les calculs de coûts de Qwen 3.8, consultez notre guide de l'API Qwen 3.8.
Pour un backend qui appelle un modèle, Qwen 3.8 est la seule option des deux. Pour coder avec un agent, le Token Plan vous permet de tester les deux avec un seul abonnement.
Réalisez votre propre test Qwen4-Max vs Qwen 3.8
En l'absence de benchmark officiel, votre propre test est la meilleure preuve. Le travail sur API s'y prête bien, car un endpoint passe ses tests ou non.
La configuration d'exemple du guide Qwen Code liste déjà les deux modèles sur le même endpoint du Token Plan, donc passer de l'un à l'autre se fait en un choix de menu :
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
Mettez cela dans ~/.qwen/settings.json. Préparez ensuite le test équitable :
- Écrivez le contrat une seule fois. Créez un seul
openapi.jsonpour une petite API, par exemplePOST /ordersetGET /orders/{id}avec des règles de validation et d'authentification. Aucun des deux modèles n'écrit la spécification, donc aucun des deux ne corrige son propre devoir. - Créez deux dossiers vides,
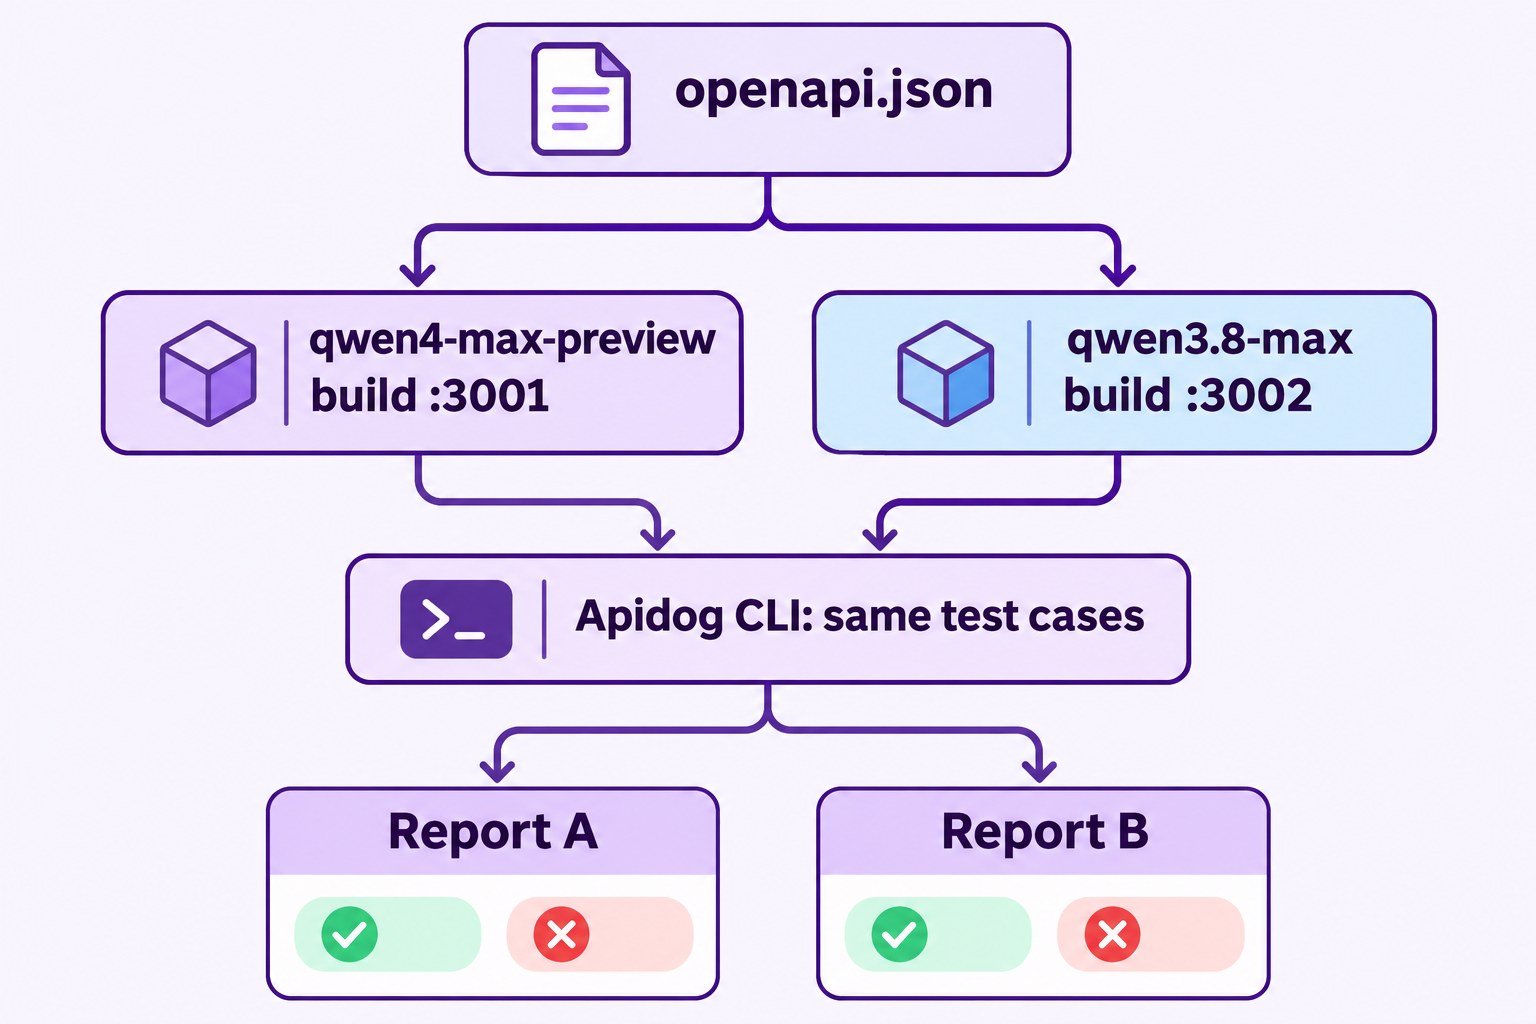
build-qwen4etbuild-qwen38, chacun avec une copie de la spécification. - Envoyez le prompt de construction identique dans chaque dossier, avec
qwen4-max-previewsélectionné dans l'un etqwen3.8-maxdans l'autre : « Implémente l'API de openapi.json avec Express. Lance-la sur le port 3001 (ou 3002). Ne modifie pas la spécification. » - Notez les bases : le temps jusqu'à un serveur fonctionnel, les fichiers écrits, et si vous avez dû intervenir.
Testez ensuite les deux builds avec la même suite de tests. C'est là qu'intervient Apidog CLI.
Évaluez les deux builds avec Apidog CLI
Votre agent de codage pilote Apidog CLI : il importe la spécification partagée, crée un jeu de cas de test à partir de celle-ci, et exécute ce jeu sur chaque build. Mêmes tests, deux cibles, deux rapports.
Configurez Apidog CLI une seule fois
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install apprend la CLI à votre agent. Le guide d'installation couvre les tokens.
Donnez un seul prompt à votre agent
N'importe quel agent peut servir d'arbitre ; ce n'est pas obligatoirement un modèle Qwen.
Import ./openapi.json into Apidog project <projectId>. Create two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
Les commandes apidog qu'il exécute
Chaque option ci-dessous provient de apidog <command> --help sur Apidog CLI 2.2.12 :
apidog import --project <projectId> --format openapi --file ./openapi.json
apidog environment create qwen4 --project <projectId> --base-url http://localhost:3001
apidog environment create qwen38 --project <projectId> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case-201.json
apidog test-case create --project <projectId> --file ./case-201.json
apidog run --test-case <caseId> --project <projectId> -e <qwen4EnvId> -r cli,json --out-file qwen4-{GENERATE_TIME}
apidog run --test-case <caseId> --project <projectId> -e <qwen38EnvId> -r cli,json --out-file qwen38-{GENERATE_TIME}
cli-schema get fournit à l'agent la structure JSON exacte d'un cas de test, et cli-schema validate vérifie chaque fichier avant toute écriture. L'agent répète test-case create et les deux lignes apidog run pour chaque cas. Le rapporteur cli affiche un résumé des succès/échecs, et json enregistre un rapport dans apidog-reports, que l'agent lit pour construire son tableau. Ajoutez --upload-report pour visualiser une exécution dans l'application Apidog.
Ce qu'il faut lire dans les rapports
Comptez trois choses par modèle : les cas réussis dès le premier build, les cycles de correction nécessaires pour tout passer au vert, et tout cas où le modèle a modifié le contrat au lieu du code. Répétez l'ensemble deux ou trois fois, car une seule exécution d'un modèle en aperçu ne dit pas grand-chose. Pour d'autres scénarios pilotés par agent, consultez le flux de travail agent d'Apidog CLI et Apidog CLI dans Claude Code. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
Lequel utiliser aujourd'hui ?
Choisissez le modèle en fonction du besoin :
- Application ou backend en production : Qwen 3.8. Il dispose d'une API publique, d'un prix publié et de limites documentées. Les règles du Token Plan écartent Qwen4-Max ici.
- Codage avec un agent : essayez les deux sur le Token Plan. Exécutez le test ci-dessus sur une tâche de votre backlog réel, pas un exercice factice.
- Décisions nécessitant des chiffres : attendez. Benchmarks, longueur de contexte et prix de Qwen4-Max ne sont pas encore disponibles.
Conservez l'ID du modèle dans une seule valeur de configuration, pour que le passage à l'ID stable de Qwen4-Max ne soit qu'une modification d'une ligne. Voir aussi Qwen 3.8 pour le codage et notre guide des meilleurs modèles Qwen.
FAQ
Qwen4-Max est-il meilleur que Qwen 3.8 ? Alibaba affirme qu'il offre des connaissances plus approfondies ainsi que des compétences de codage et d'agent renforcées, mais il n'a publié aucun benchmark. Aucune donnée officielle ne le prouve encore, alors testez les deux sur votre propre tâche.
Puis-je appeler Qwen4-Max via l'API comme Qwen 3.8 ? Pas en pay-as-you-go. Qwen4-Max est accessible via les endpoints du Token Plan avec l'ID qwen4-max-preview, pour un usage interactif dans les outils de codage. Qwen3.8-Max (qwen3.8-max) dispose d'une API standard.
Qwen4-Max a-t-il un contexte d'1M de tokens comme Qwen 3.8 ? Alibaba ne l'a pas confirmé. Qwen3.8-Max a un contexte d'1M documenté. Le chiffre d'1M pour Qwen4-Max provient uniquement de rapports tiers.
Combien coûte Qwen4-Max par rapport à Qwen 3.8 ? Qwen 3.8 coûte 2 $ en entrée et 6 $ en sortie par million de tokens. Qwen4-Max n'a pas encore de prix au token. Via le Token Plan, les deux partagent un pool de crédits sur des plans à partir de 3 $ par mois (prix événement Lite, catalogue 8 $).
Dois-je migrer mon application de Qwen 3.8 vers Qwen4-Max ? Pas encore. Un aperçu peut changer sans préavis, et le Token Plan interdit l'automatisation en production. Gardez Qwen 3.8 en production et faites tourner Qwen4-Max en parallèle en développement.