
Le tarif de Qwen4-Max sur l'API QwenCloud à l'usage (paiement au token) est de 1,50 $ par million de tokens en entrée et 4,50 $ par million de tokens en sortie dans la région de Singapour, avec une entrée en cache à 0,075 $ par million. Les modes thinking et non-thinking coûtent le même prix, et il n'y a pas de paliers selon la longueur de l'entrée. Si vous préférez payer un abonnement mensuel fixe pour vos outils de codage, le même modèle est disponible via le Token Plan, à partir de 6 $ par mois.
Ci-dessous : la grille tarifaire, les coûts réels des tâches, les économies liées au cache, Token Plan vs paiement au token, et les prix de la concurrence. Vous ne connaissez pas encore ce modèle ? Commencez par Qu'est-ce que Qwen4-Max.
Tarif de l'API Qwen4-Max par million de tokens
Qwen4-Max est facturé au million de tokens, avec des tarifs distincts pour l'entrée, la sortie, les écritures en cache et les lectures en cache. La sortie couvre à la fois les tokens de raisonnement (« thinking ») et la réponse. Alibaba publie une colonne Singapour (International) et une colonne Pékin/Global moins chère.
| Élément facturé (par 1M de tokens) | Singapour (International) | Pékin / Global |
|---|---|---|
| Entrée | 1,50 $ | 1,413 $ |
| Sortie (thinking + réponse) | 4,50 $ | 4,24 $ |
| Écriture en cache, TTL de 5 minutes | 1,875 $ | 1,767 $ |
| Écriture en cache, TTL d'1 heure | 3,00 $ | 2,827 $ |
| Lecture en cache (hit explicite ou implicite) | 0,075 $ | 0,071 $ |
Source : la documentation tarifaire de QwenCloud et la page du modèle Qwen4-Max, toutes deux consultées le 16 novembre 2026. La documentation indique que le déploiement Global est disponible à Francfort, Hong Kong, Tokyo et aux États-Unis (Virginie).
Quelques règles façonnent la facture :
- Les tokens de raisonnement sont facturés en sortie. Activez
enable_thinkinget chaque token de raisonnement est facturé 4,50 $ par million. - Aucun surcoût pour les longs contextes. Une requête de 900 000 tokens coûte le même prix par token qu'une requête de 9 000.
- Les lectures en cache coûtent 5 % du prix de l'entrée. 0,075 $ contre 1,50 $ représente une remise de 95 % sur les préfixes répétés.
- Limites : un contexte de 1 million de tokens, jusqu'à 991 000 tokens en entrée (983 000 avec thinking), jusqu'à 393 000 tokens en sortie et 5 000 000 de tokens par minute.
L'identifiant du modèle est qwen4-max. Si vous n'avez pas encore effectué d'appel, notre guide de l'API Qwen4-Max couvre les clés, les URLs de base et la première requête.
Le coût réel d'une tâche avec Qwen4-Max
Les prix au token sont difficiles à appréhender. Alibaba donne un chiffre concret dans son billet de lancement : sur son benchmark d'agents Work360, le coût moyen par tâche est passé de 4,43 $ avec Qwen3.8-Max à 1,67 $ avec Qwen4-Max, soit 62 % de moins. Alibaba indique également que Qwen4-Max a consommé environ 24 % de tokens en moins au niveau d'effort Xhigh et environ 35 % de moins au niveau High sur Work360. Ce sont des chiffres du fournisseur, à considérer comme une tendance, et non comme un devis pour votre charge de travail.
Vous pouvez estimer votre propre coût avec un simple calcul. Voici trois exemples détaillés aux tarifs officiels de Singapour :
- Brève conversation. 2 000 tokens en entrée et 500 en sortie : 2 000 x 1,50 $/1M + 500 x 4,50 $/1M = 0,003 $ + 0,00225 $ = 0,0053 $. Soit environ 5,25 $ pour 1 000 appels.
- Le même appel avec thinking activé. Supposons que le modèle raisonne pendant 6 000 tokens avant de fournir une réponse de 500 tokens. La sortie passe à 6 500 tokens, donc l'appel coûte 0,003 $ + 0,02925 $ = 0,032 $, environ six fois plus cher.
- Question sur un long document. 300 000 tokens en entrée et 2 000 en sortie : 0,45 $ + 0,009 $ = 0,459 $ sans cache, ou environ 0,032 $ si le document de 300K est déjà en cache.
L'exemple 2 surprend souvent : le raisonnement peut dominer la facture même quand la réponse est courte. Pour des chiffres plus poussés sur la qualité par dollar, consultez notre analyse des benchmarks de Qwen4-Max.
Comment les tarifs du cache modifient la facture Qwen4-Max
C'est le cache de contexte qui fait vraiment bouger la tarification de Qwen4-Max. QwenCloud propose deux modes pour qwen4-max sur l'API à l'usage, et sur les API Chat Completions, DashScope et compatibles Anthropic, ils s'excluent mutuellement par requête.
| Mode | Fonctionnement | Prix | Hit garanti ? |
|---|---|---|---|
| Cache implicite | Automatique, ne peut pas être désactivé, réutilise un préfixe commun de 1 024 tokens ou plus | 0,075 $ par 1M en cas de hit | Non. La validité est indéterminée |
| Cache explicite | Vous marquez un point de rupture avec cache_control |
1,875 $ (5 min) ou 3 $ (1 h) à l'écriture, 0,075 $ à la lecture | Oui, tant que le cache est valide |
La documentation sur le cache de contexte indique qu'un cache explicite de 5 minutes réinitialise son minuteur à chaque hit : une boucle d'agent sollicitée le maintient donc actif.
Prenons maintenant une session d'agent : un prompt système de 200 000 tokens avec les définitions d'outils et le contexte du dépôt, réutilisé sur 50 tours, avec 2K de nouvelles entrées et 3K de sortie par tour.
- Sans hit de cache : 10,1M de tokens en entrée x 1,50 $ + 150K en sortie x 4,50 $ = 15,83 $.
- Hits de cache implicites à partir du tour 2 : les premiers 202K au plein tarif (0,30 $), 9,8M de tokens en cache à 0,075 $ (0,74 $), 98K de tokens frais (0,15 $) et la sortie (0,68 $) = 1,86 $.
- Cache explicite de 5 minutes : une écriture à 0,375 $ au lieu du premier préfixe au plein tarif, mêmes lectures et sortie = environ 1,94 $, avec un hit garanti.
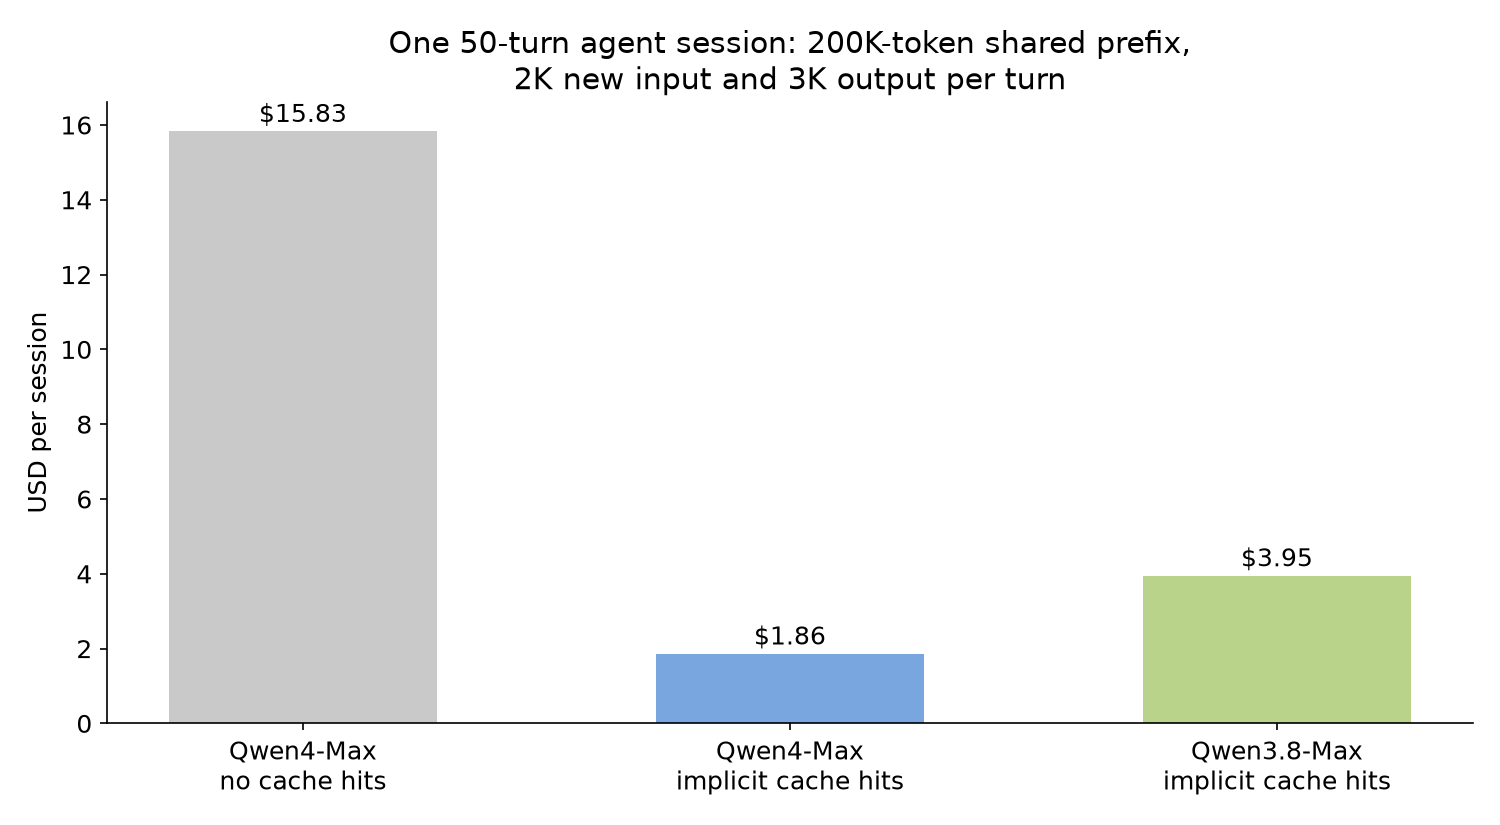
La même session sur Qwen3.8-Max, avec ses tarifs de 2 $ en entrée, 0,25 $ en cache implicite et 6 $ en sortie, revient à 3,95 $. C'est là qu'apparaît l'affirmation d'Alibaba concernant « la plus forte baisse sur l'entrée en cache » : Qwen3.8-Max facture 0,25 $ un hit implicite, Qwen4-Max seulement 0,075 $.
Utilisez le cache explicite quand vous avez besoin d'un hit garanti, et le cache implicite pour tout le reste. Vérifiez ce que vous avez obtenu via usage.prompt_tokens_details.cached_tokens et cache_creation_input_tokens. Si vous comparez l'économie du cache entre plusieurs fournisseurs, notre article sur le calcul du prompt caching de Claude Opus 5.5 utilise la même méthode.
Existe-t-il une remise Batch pour Qwen4-Max ?
Oui, mais dans une seule région seulement. L'API Batch de QwenCloud facture normalement l'entrée et la sortie à 50 % du prix temps réel. Pour qwen4-max, la documentation Batch ne le liste que sous China North 2 (Pékin), à 0,707 $ en entrée et 2,12 $ en sortie par million de tokens pour Batch File. Batch Chat à Pékin est affiché à 1,413 $ / 4,24 $.
Batch ne prend pas en charge le cache de contexte, ne se cumule pas avec d'autres remises et n'est pas couvert par le quota gratuit. Avec un taux élevé de hits de cache, l'API temps réel peut être plus avantageuse que Batch.
Qwen4-Max : paiement au token ou Token Plan ?
Le Token Plan est l'abonnement mensuel de QwenCloud pour les outils de codage et d'agents tels que Claude Code, Cursor, Qwen Code, Codex et Qoder. Il est facturé en Crédits, et non en tokens, et utilise ses propres clés API sk-sp-. qwen4-max figure sur la liste des modèles pris en charge. Les offres individuelles, selon la documentation du Token Plan consultée le 16 novembre 2026 :
| Offre | Prix par mois | Crédits par mois | Agents simultanés |
|---|---|---|---|
| Lite | 6 $ (3 $, prix de lancement pour nouveaux utilisateurs) | 20 000 | 1-2 |
| Essential | 10 $ (5 $, prix de lancement pour nouveaux utilisateurs) | 45 000 | 2-3 |
| Standard | 18 $ | 80 000 | 3-4 |
| Pro | 43 $ | 200 000 | 6-8 |
Les packs de Crédits supplémentaires coûtent 15 $ pour 20 000 Crédits (jusqu'à 5 à la fois). Une fois les Crédits épuisés, les appels sont bloqués ; aucun basculement vers le paiement au token n'a lieu.
Comment choisir :
- Choisissez le Token Plan si une seule personne utilise le modèle via un agent de codage chaque jour et souhaite un coût mensuel fixe.
- Choisissez le paiement au token pour les produits, les tâches backend, le batch, le fine-tuning ou un trafic irrégulier. Vous ne payez que ce que vous consommez et conservez la limite de 5 000 000 TPM.
Le nombre de Crédits par requête Qwen4-Max ne suit pas un ratio de tokens fixe, alors vérifiez la console après une journée d'utilisation réelle. Nous couvrons l'offre en profondeur, y compris la portée des Crédits, dans Qwen4-Max Token Plan : prix et intérêt.
Tarification de Qwen4-Max face à Qwen3.8-Max et aux modèles phares concurrents
Qwen4-Max est moins cher que son prédécesseur sur l'entrée, la sortie, les lectures en cache et l'écriture en cache de 5 minutes (Qwen3.8-Max affiche un seul tarif d'écriture en cache de 2,50 $ ; l'écriture d'une heure de Qwen4-Max est à 3 $). Voici où il se situe face aux autres modèles phares aux tarifs officiels standards, chacun relevé sur la page du fournisseur le 16 novembre 2026.
| Modèle | Entrée / 1M | Entrée en cache / 1M | Sortie / 1M |
|---|---|---|---|
| Qwen4-Max (Singapour) | 1,50 $ | 0,075 $ | 4,50 $ |
| Qwen3.8-Max | 2,00 $ | 0,25 $ (implicite), 0,17 $ (lecture explicite) | 6,00 $ |
| DeepSeek V4 Pro (heures pleines / creuses) | 1,32 $ / 0,66 $ | 0,044 $ / 0,022 $ | 3,96 $ / 1,98 $ |
| OpenAI gpt-5.6-sol | 4,00 $ | 0,40 $ | 20,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
Sources : page du modèle Qwen3.8-Max, tarifs DeepSeek, tarifs de l'API OpenAI et tarifs Claude.
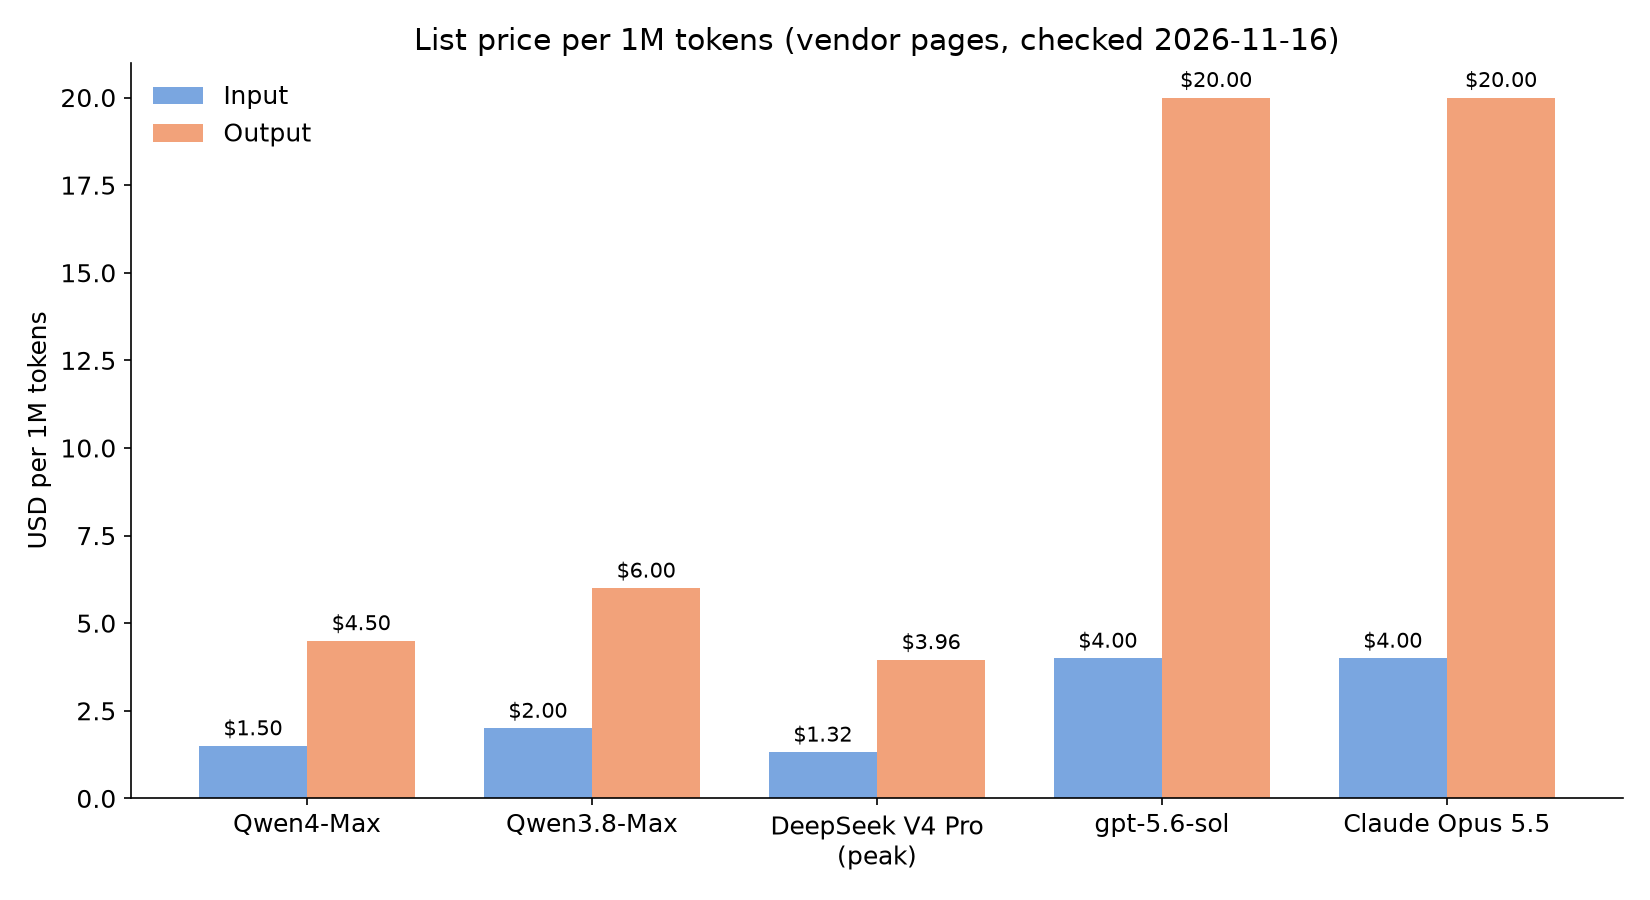
Pour les agents, la sortie constitue souvent le plus gros poste, et les 4,50 $ en sortie de Qwen4-Max restent bien en deçà des 20 $ facturés par gpt-5.6-sol et Claude Opus 5.5. DeepSeek V4 Pro est moins cher au token, surtout aux heures creuses. Le coût par tâche achevée dépend du nombre de tokens que chaque modèle consomme sur votre charge de travail. Pour le détail côté Qwen3.8-Max, consultez notre guide des tarifs Qwen 3.8 et la comparaison Qwen4-Max vs Qwen 3.8.
Mesurez les coûts de Qwen4-Max avec votre agent de codage et Apidog CLI
La seule estimation de coût fiable est celle des usage mesurés sur vos propres prompts. Laissez votre agent de codage (Claude Code, Codex, Cursor ou équivalent) construire et exécuter cette vérification avec l'Apidog CLI. Configurez-le une seule fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Donnez ensuite à votre agent un seul prompt :
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
L'agent vérifie la structure de chaque payload par rapport au schéma CLI avant d'écrire quoi que ce soit, puis exécute les cas de test :
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Comparez les deux valeurs de completion_tokens et multipliez par 4,50 $ par million : c'est votre surcoût de raisonnement, sur vos propres prompts. Ajoutez --upload-report à la commande apidog run pour consulter l'exécution dans l'application Apidog, ou placez la même commande en CI avec -r junit, comme indiqué dans exécuter Apidog CLI en CI/CD. Vous débutez avec le CLI ? Le guide d'installation d'Apidog CLI et Apidog CLI avec Codex vous permettront d'être opérationnel en quelques minutes. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Combien coûte Qwen4-Max par million de tokens ? 1,50 $ en entrée et 4,50 $ en sortie dans la région de Singapour, avec des lectures en cache à 0,075 $. La colonne Pékin/Global est légèrement moins chère, à 1,413 $ et 4,24 $.
Le mode thinking coûte-t-il plus cher sur Qwen4-Max ? Le tarif est le même, mais les tokens de raisonnement sont facturés comme sortie à 4,50 $ par million : un raisonnement long multiplie donc le coût d'un appel.
Qwen4-Max est-il moins cher que Qwen3.8-Max ? Oui. L'entrée passe de 2 $ à 1,50 $, la sortie de 6 $ à 4,50 $, et un hit de cache implicite de 0,25 $ à 0,075 $ par million de tokens. Alibaba indique également que le coût par tâche sur Work360 est passé de 4,43 $ à 1,67 $.
Peut-on utiliser Qwen4-Max gratuitement ? QwenCloud accorde un quota gratuit aux nouveaux modèles dans la région de Singapour, généralement 1M de tokens valables 90 jours, après ajout de vos informations de paiement. Consultez la page Free Tier de la console pour qwen4-max, et notre guide d'accès gratuit à Qwen4-Max détaille toutes les options à 0 $.
Qwen4-Max prend-il en charge la tarification Batch ? Uniquement dans la région de Pékin : Batch File est à 0,707 $ en entrée et 2,12 $ en sortie par million de tokens, sans cache de contexte.
Token Plan ou paiement au token pour Qwen4-Max ? Le Token Plan convient à une personne utilisant quotidiennement des outils de codage, à partir de 6 $ par mois. Le paiement au token convient aux applications, aux tâches backend et au batch.