
Qwen4-Max en une ligne : le graphique d'Alibaba place Qwen4-Max devant Qwen3.8-Max sur chacun des 15 tests où les deux apparaissent, et en première position sur 4 des 16, mais la plupart de ces chiffres proviennent des propres exécutions d'Alibaba. Sur Work360, il obtient 52,69 contre 47,74, et le coût moyen par tâche passe de 4,43 $ à 1,67 $.
Un benchmark n'a de valeur que si l'on peut répondre à la question « qui l'a exécuté, et comment ? ». Ce guide passe en revue tous les scores publiés par Alibaba le 16 novembre 2026, les classe en auto-déclarés et tiers, et se termine par une méthode pour effectuer votre propre vérification avec l'API Qwen4-Max. Pour les bases, commencez par ce qu'est Qwen4-Max et comment y accéder.
Les scores de Qwen4-Max aux benchmarks en un coup d'œil
L'article de lancement d'Alibaba compare Qwen4-Max à Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra et Kimi K3.1 sur 16 benchmarks.
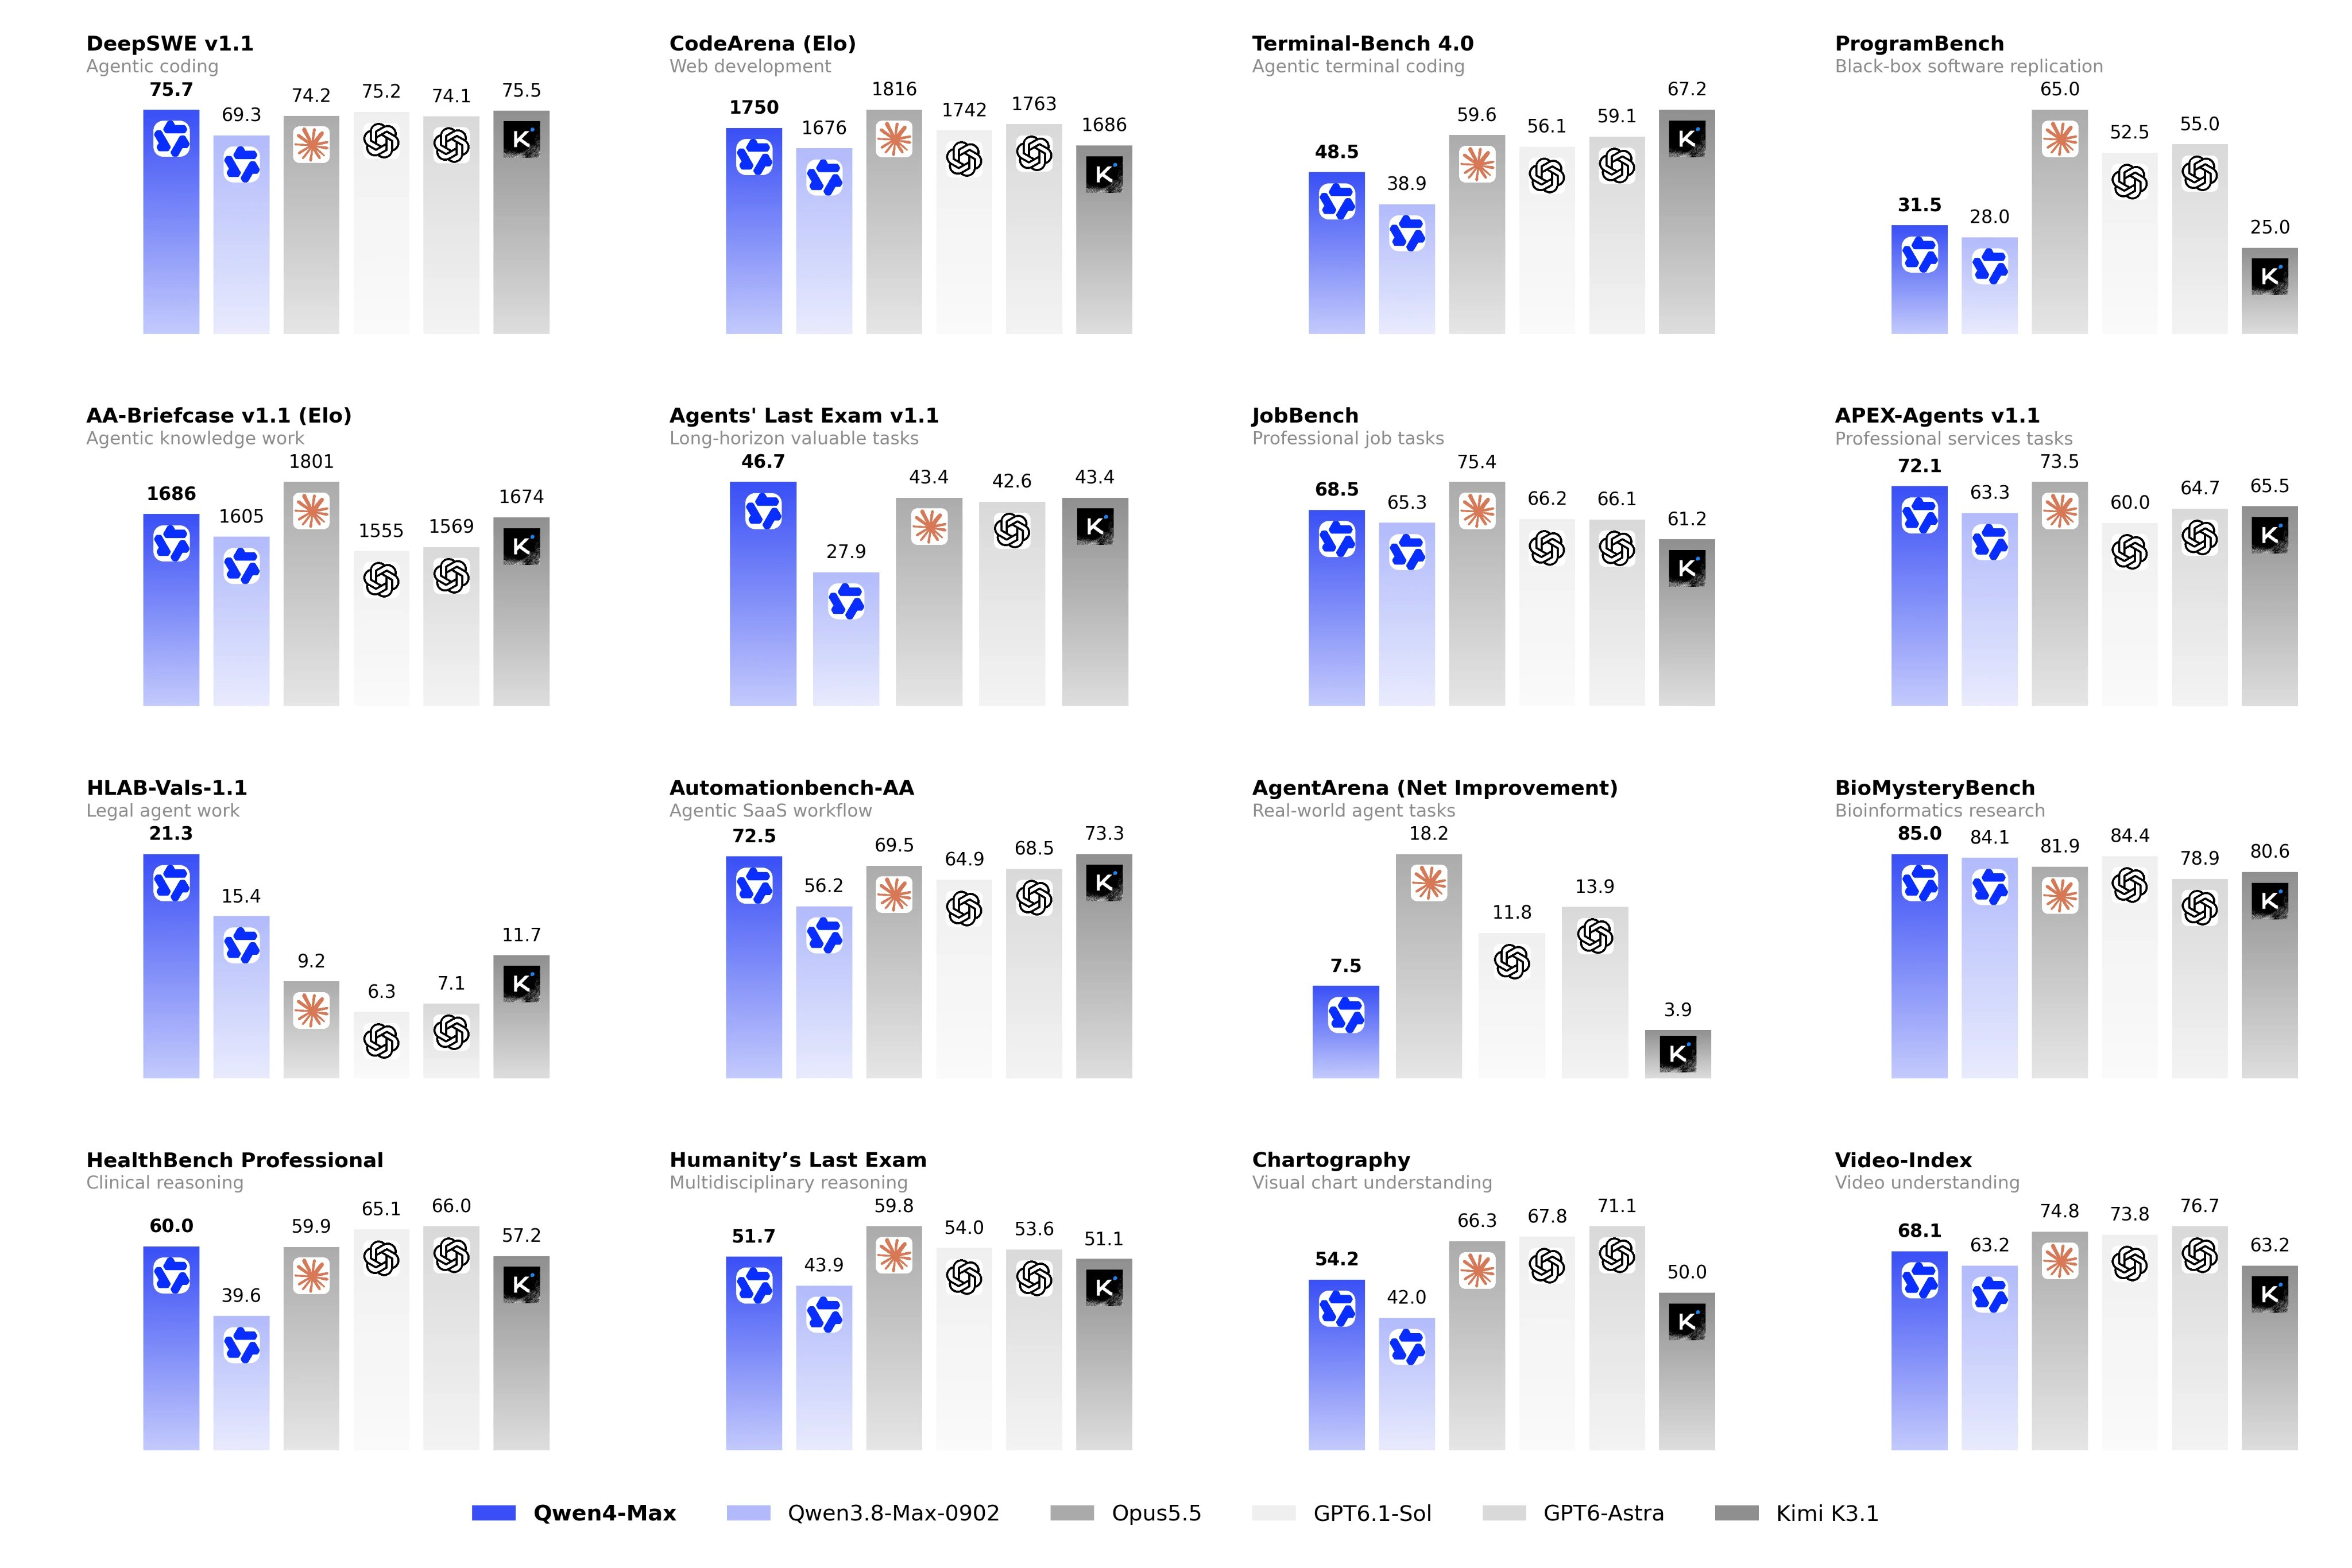
Les valeurs en gras indiquent le meilleur score du graphique. « Alibaba » signifie que les notes de bas de page ne citent aucun classement externe pour ce test : considérez-le comme une exécution propre d'Alibaba (les notes de JobBench et Chartography décrivent uniquement la configuration d'Alibaba).
Auto-déclarés ou tiers : qui a exécuté chaque test
Dix des 16 scores sont auto-déclarés. Six sont cités de classements publics gérés par des tiers. C'est le filtre le plus utile à appliquer.
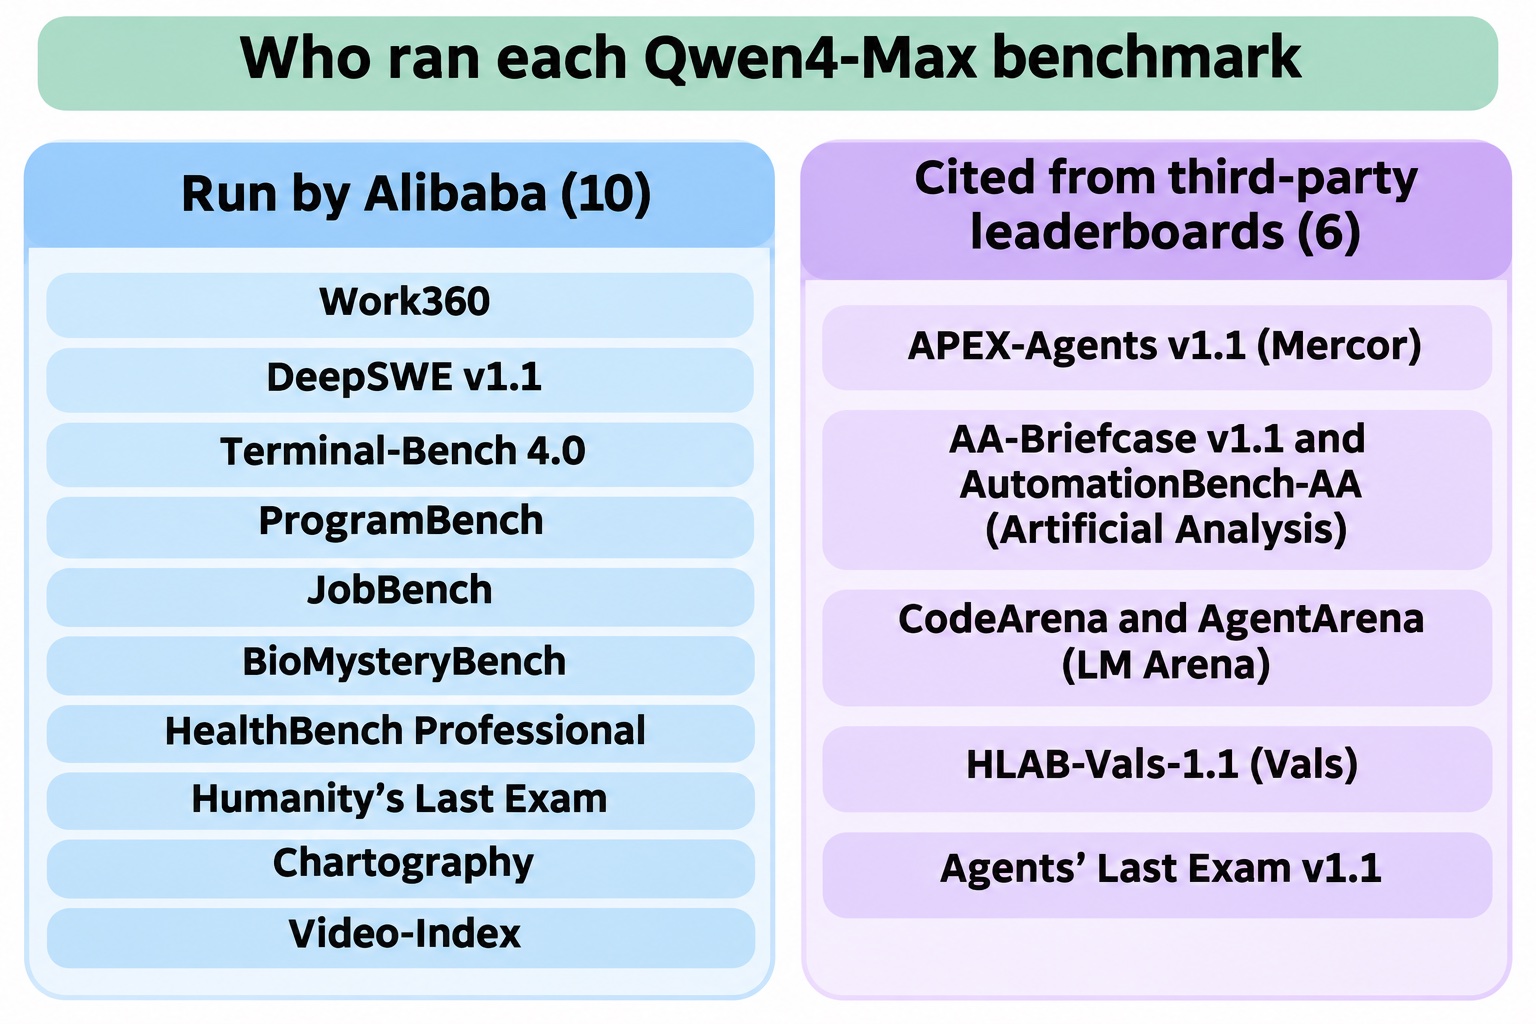
Le groupe tiers, selon les notes de l'article de lancement :
- APEX-Agents v1.1 : cité du classement Mercor APEX-Agents
- AA-Briefcase v1.1 et AutomationBench-AA : cités d'Artificial Analysis
- CodeArena et AgentArena : cités de LM Arena
- HLAB-Vals-1.1 : cité du Vals Index
- Agents' Last Exam v1.1 : cité de son propre classement
Un chiffre indépendant vérifiable dès aujourd'hui : le Vals Index (version 2.2, mise à jour le 15 novembre 2026) place Qwen 4 Max à 63,20 % au global, 11ᵉ rang, à 9,33 $ par test. Cela le place derrière dix modèles, menés par Claude Fable 5.2 à 71,31 %, et juste devant Kimi K3.1 Pro (62,52 %) et Qwen 3.8 Max 0902 (59,05 %). Un tableau plus modeste que le graphique vedette.
Work360 : le benchmark professionnel maison d'Alibaba
Work360 est le benchmark d'Alibaba pour les tâches industrielles complexes, couvrant 26 domaines, 182 sous-domaines et 721 spécialités. Qwen4-Max obtient 52,69, contre 47,74 pour Qwen3.8-Max.
À lire avec prudence : Alibaba a conçu le benchmark et exécuté les modèles, sa comparaison publiée ne couvre que Qwen4-Max et Qwen3.8-Max, et aucun classement public n'existe encore. C'est un chiffre de génération à génération, pas un classement face aux autres laboratoires.
Ce que Work360 vous apporte, c'est un chiffre de coût : le coût moyen par tâche passe de 4,43 $ à 1,67 $, soit une baisse de 62 %, grâce à la combinaison d'un nombre réduit de tokens par tâche et de prix plus bas. Qwen4-Max est listé à 1,50 $ par million de tokens d'entrée et 4,50 $ par million de tokens de sortie sur la page du modèle QwenCloud. Le détail complet dans notre guide des tarifs de Qwen4-Max.
Terminal-Bench 4.0 et efficacité en tokens
Terminal-Bench mesure la capacité d'agents à accomplir des tâches réelles dans un terminal. Alibaba annonce 48,5 pour Qwen4-Max sur la version 4.0, contre 38,9 pour Qwen3.8-Max. Sur le graphique d'Alibaba, les quatre modèles non-Qwen se situent entre 56,1 et 67,2, tous au-dessus.
L'affirmation la plus forte concerne l'efficacité. Selon Alibaba, la consommation de tokens baisse d'environ 48 % en effort Xhigh et 49 % en effort High sur Terminal-Bench 4.0, et d'environ 24 % (Xhigh) et 35 % (High) sur Work360. Son graphique score-vs-tokens montre la tendance :
- Sur Work360, Qwen4-Max en effort High dépasse déjà Qwen3.8-Max en Xhigh, avec environ 96K tokens par tâche contre environ 165K (lu sur le graphique, donc approximatif).
- Sur Terminal-Bench 4.0, Qwen4-Max en Xhigh atteint 48,5 avec environ 150K tokens par tâche, tandis que Qwen3.8-Max en Xhigh atteint environ 38 avec environ 290K.
Moins de tokens pour un meilleur score, c'est la bonne direction si vous payez au token. Mais c'est aussi auto-déclaré.
Un point à connaître : le classement public Terminal-Bench affiche désormais par défaut la version 4.1, et Qwen4-Max n'y figure pas au 16 novembre. Qwen3.8-Max-0902 affiche 27,0 % sur la 4.1 (exécuté avec Claude Code à effort max), contre 38,9 sur le graphique 4.0 d'Alibaba. Version et harnais différents, donc ne soustrayez pas l'un de l'autre, mais cela montre à quel point un score varie selon la configuration.
Où Qwen4-Max domine, et où il est en retard
Face aux autres modèles frontières du graphique, le tableau est mitigé :
En tête (4 sur 16) : DeepSWE v1.1 (75,7, avec 0,2 point d'avance sur Kimi K3.1), Agents' Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3) et BioMysteryBench (85,0, moins d'un point devant GPT-6.1 Sol).
Deuxième de justesse : APEX-Agents v1.1 (72,1 contre 73,5), AutomationBench-AA (72,5 contre 73,3) et AA-Briefcase (1686 contre 1801 Elo).
Nettement derrière : ProgramBench (31,5 contre 65,0), Terminal-Bench 4.0 (48,5 contre 67,2), AgentArena (7,5 contre 18,2), Chartography (54,2 contre 71,1) et Humanity's Last Exam (51,7 contre 59,8).
Deux des quatre premières places, Agents' Last Exam et HLAB-Vals, proviennent de classements tiers, ce qui en fait les affirmations les plus solides du graphique. Côté code : une courte avance sur DeepSWE, des écarts importants sur ProgramBench et Terminal-Bench. Si vous exécutez des agents terminaux de longue durée, testez avant de basculer. Pour ce qui a changé depuis la génération précédente, voir Qwen4-Max vs Qwen 3.8.
Codage sécurisé et chiffres de pré-entraînement
Codage sécurisé. Sur Last Secure Code Bench, dans le scénario « reconstruction de code sans indice de sécurité » avec vérification à la fois de la fonctionnalité et des vulnérabilités, le taux de réussite au niveau fonction est passé de 22,0 % pour Qwen3.8-Max à 31,8 %. La part de code validée aux trois niveaux (fonction, fichier et dépôt) est passée de 8 % à 14,7 %. Environ deux tiers des sorties au niveau fonction échouent encore à un contrôle : la revue de sécurité reste votre affaire.
Pré-entraînement. Sur les évaluations internes couvrant connaissance, code, questions-réponses et STEM, Qwen4-Max-Base affiche environ 5 % à 13 % de bits par octet en moins que Qwen3.8-Max-Base, tout en activant 25 % de paramètres en moins. Alibaba précise que deux points de contrôle de cette comparaison (GLM-5.3 et Kimi-K3.1-Pro) sont post-entraînés, ce qui peut fausser les résultats.
Ce qui manque encore
- Les paramètres d'évaluation de la plupart des tests. L'article de lancement ne précise pas quel niveau d'effort (High ou Xhigh) ni quel harnais d'agent a produit chaque barre.
- La variance. Pas de barres d'erreur ni de nombre d'exécutions. Des classements comme Terminal-Bench rapportent des marges d'environ 3 à 4 points, supérieures à certains écarts ci-dessus.
- Des exécutions indépendantes de Terminal-Bench et Work360. Aucun des deux ne figure encore sur un classement public.
Effectuez votre propre benchmark de Qwen4-Max avec Apidog CLI
Aucun benchmark public n'utilise vos prompts ni vos schémas. La vérification la plus honnête et la plus rapide consiste en une petite suite de vos propres requêtes, exécutée toujours de la même manière, avec enregistrement de la consommation de tokens pour calculer votre propre coût par tâche.
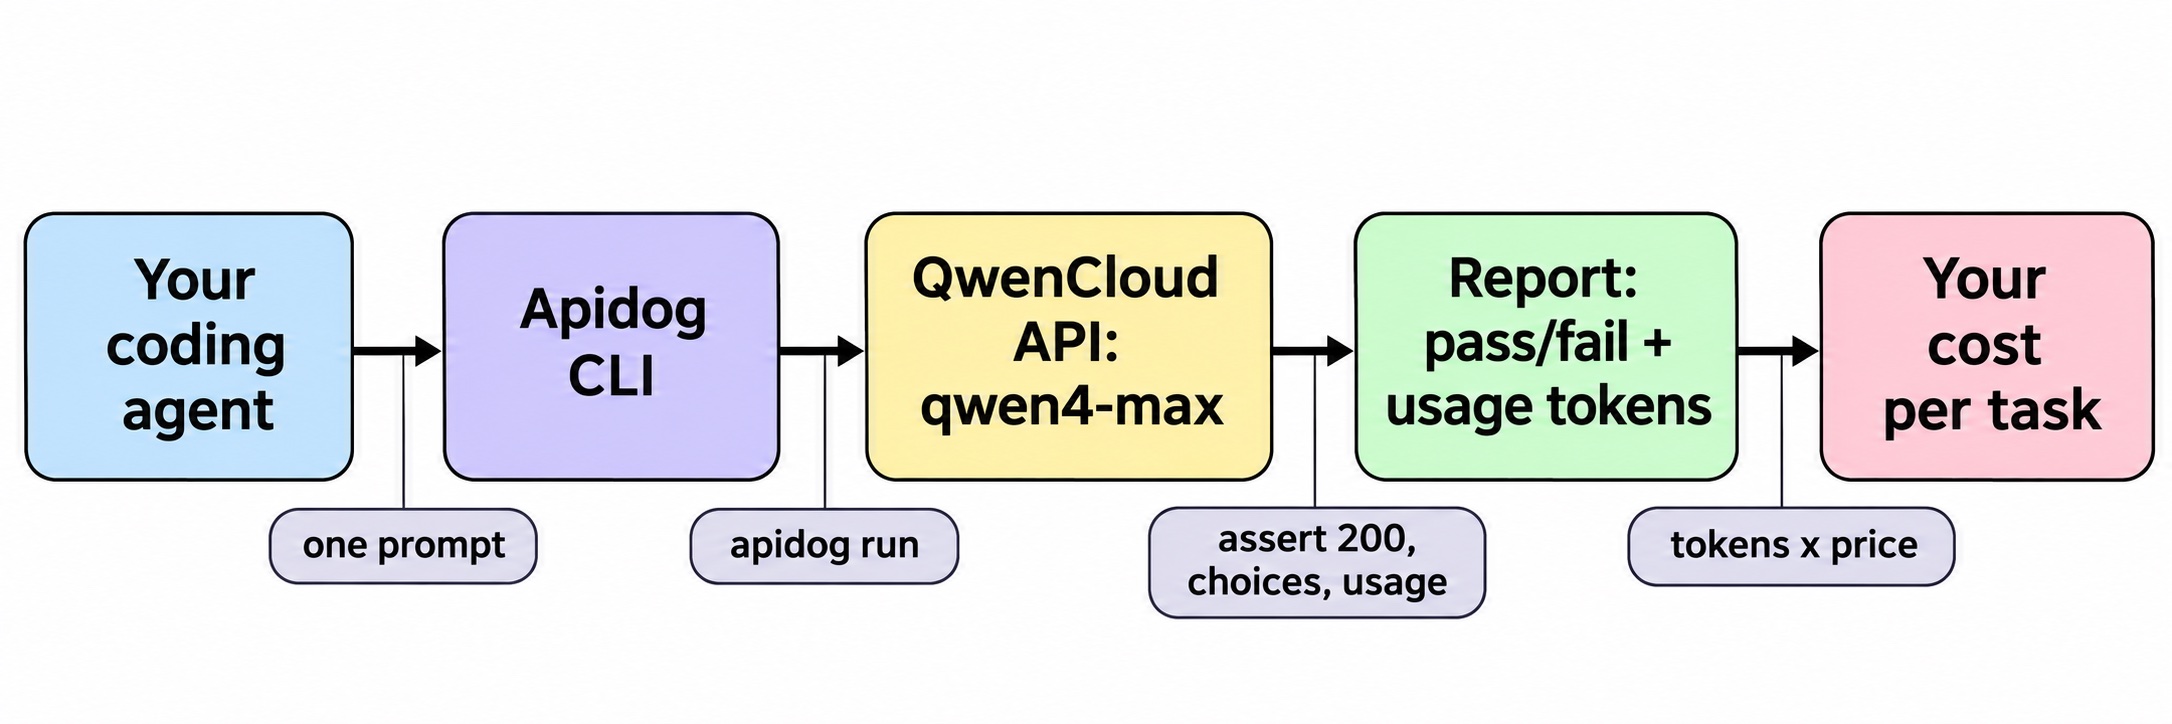
Laissez votre agent de code faire la configuration avec Apidog CLI. Installez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install apprend le CLI à votre agent ; le guide d'installation couvre les tokens. Donnez-lui ensuite un seul prompt :
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
L'agent vérifie la forme de chaque payload avant d'écrire quoi que ce soit. Tous les indicateurs ci-dessous proviennent de apidog <command> --help sur Apidog CLI 2.2.12 :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d exécute une itération par ligne de votre fichier de prompts, et --env-var transmet la clé au moment de l'exécution pour qu'elle ne figure jamais dans le projet. L'agent lit chaque bloc usage dans le rapport JSON du dossier apidog-reports. Multipliez les tokens de prompt par 1,50 $ et les tokens de complétion par 4,50 $ par million, et vous obtenez votre propre coût par tâche à comparer aux 1,67 $ d'Alibaba.
Changez d'environnement pour exécuter la même suite sur votre modèle actuel, et répétez-la deux ou trois fois pour observer la variance que le graphique de lancement ne montre pas. La même ligne apidog run s'intègre en CI avec -r junit ; voir le guide CI/CD. Pour une configuration d'agent pas à pas, voir Apidog CLI dans Claude Code. Le plan Gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Les benchmarks de Qwen4-Max sont-ils indépendants ? Pas vraiment. Dix des 16 scores du graphique d'Alibaba proviennent de ses propres exécutions. Six sont cités de classements tiers : APEX-Agents (Mercor), AA-Briefcase et AutomationBench-AA (Artificial Analysis), CodeArena et AgentArena (LM Arena), HLAB-Vals (Vals) et Agents' Last Exam.
Qu'est-ce que Work360 ? Le benchmark maison d'Alibaba pour les tâches industrielles complexes, couvrant 26 domaines. Qwen4-Max obtient 52,69 contre 47,74 pour Qwen3.8-Max ; seuls ces deux modèles figurent dans la comparaison publiée.
Comment Qwen4-Max se comporte-t-il sur Terminal-Bench 4.0 ? Alibaba annonce 48,5, contre 38,9 auparavant, avec environ deux fois moins de tokens. Les autres modèles frontières du graphique obtiennent entre 56,1 et 67,2.
Qwen4-Max est-il moins cher à exécuter que Qwen3.8-Max ? Sur l'évaluation Work360 d'Alibaba, le coût moyen par tâche passe de 4,43 $ à 1,67 $. Les tarifs listés sont de 1,50 $ en entrée et 4,50 $ en sortie par million de tokens. Voir le guide Token Plan pour les options d'abonnement et Qwen4-Max gratuitement pour les accès sans frais.
Qu'est-ce que Live Delivery dans le lancement de Qwen4-Max ? Un flux de travail d'agent qui livre tôt une première version utilisable et l'améliore pendant que vous pilotez. Ce n'est pas un benchmark. Notre guide du plugin Qwen Live Delivery en parle.