
L'API Qwen4-Max est disponible sur QwenCloud en modèle pay-per-token sous l'identifiant qwen4-max. Créez une clé pay-as-you-go dans votre région, pointez le SDK OpenAI vers https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 (Singapour), et appelez-la. Elle coûte 1,50 $ par million de tokens en entrée et 4,50 $ par million en sortie, avec un contexte de 1M de tokens.
Ce guide couvre la clé, les URL de base, le mode thinking, la vision, les outils, les sorties structurées, le cache, la route Anthropic, les limites et les erreurs. Chaque extrait de code suit la documentation QwenCloud telle que consultée le 16 novembre 2026.
Pour le contexte, lisez ce qu'est Qwen4-Max. Pour un accès par abonnement plutôt que pay-per-token, consultez toutes les façons d'utiliser Qwen4-Max et le guide du Token Plan.
Ce que l'API Qwen4-Max vous offre
L'API Qwen4-Max est le modèle phare d'Alibaba servi via QwenCloud, avec des endpoints compatibles OpenAI, compatibles Anthropic et DashScope. Elle accepte du texte, des images et des vidéos en entrée, renvoie du texte, réfléchit avant de répondre par défaut, et prend en charge le function calling, les sorties structurées, le cache de contexte, les jobs batch, la recherche web et le fine-tuning.
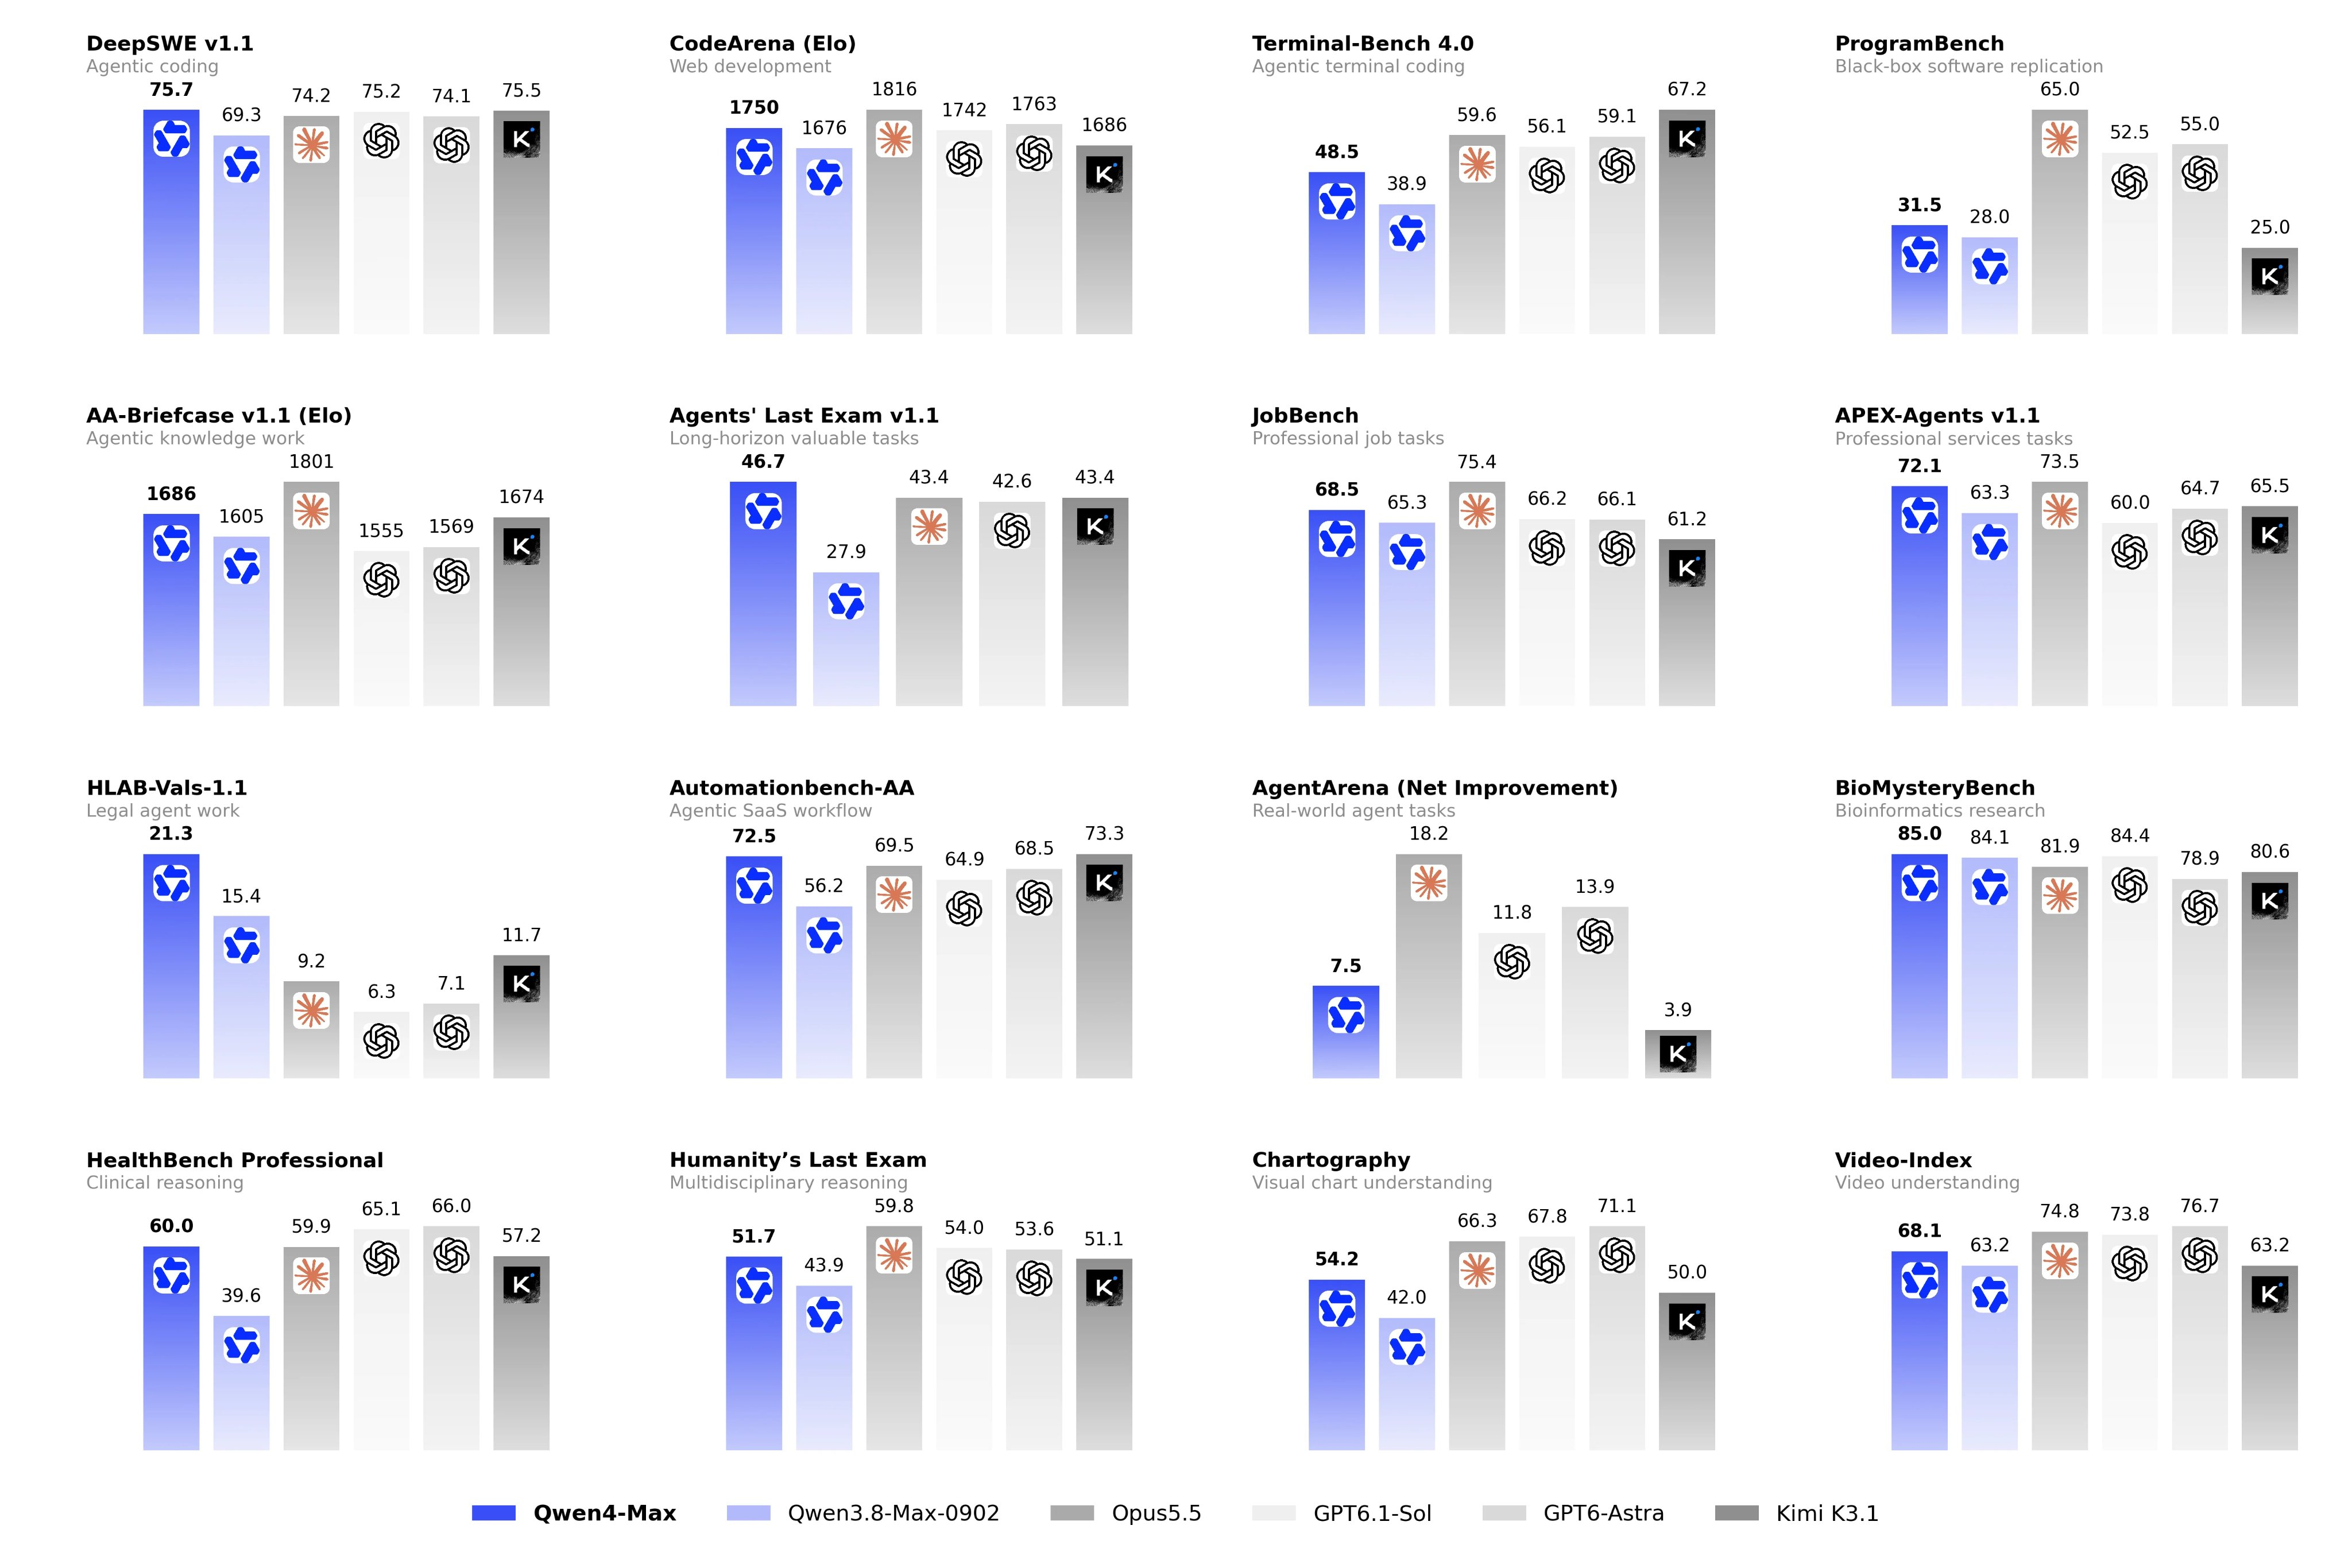
Voici les chiffres issus de la page du modèle qwen4-max :
| Élément | Valeur |
|---|---|
| ID du modèle | qwen4-max |
| Prix en entrée | 1,50 $ par million de tokens |
| Prix en sortie | 4,50 $ par million de tokens |
| Cache implicite en entrée / lecture de cache explicite | 0,075 $ par million de tokens |
| Création de cache explicite | 1,875 $ (5 minutes) ou 3 $ (1 heure) par million de tokens |
| Fenêtre de contexte | 1M de tokens |
| Entrée maximale | 991K (983K avec le thinking) |
| Sortie maximale | 393K |
| Raisonnement maximal | 262K |
| Débit | 5 000 000 TPM |
Les tokens de raisonnement sont facturés comme des tokens de sortie. Pour un détail complet des coûts, consultez le guide tarifaire Qwen4-Max.
Obtenir une clé et choisir la bonne URL de base
Les clés sont liées à une région, et le type de clé doit correspondre à l'endpoint.
- Ouvrez la console QwenCloud et choisissez une région dans le sélecteur en haut à droite.
- Allez dans API Keys, cliquez sur Create API key, ajoutez une description et cliquez sur Generate Key.
- Copiez la clé immédiatement. Elle n'est affichée qu'une seule fois. Les nouvelles clés pay-as-you-go commencent par
sk-ws-. - Exportez-la :
export DASHSCOPE_API_KEY="sk-ws-...".
Chaque région utilise le domaine {region}.maas.qwencloudapi.com. Singapour est ap-southeast-1 ; Francfort est eu-central-1, Tokyo est ap-northeast-1 et US (Virginie) est us-east-1. Ajoutez ensuite le chemin du protocole :
| Protocole | URL de base (Singapour) |
|---|---|
| Compatible OpenAI (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Compatible Anthropic | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
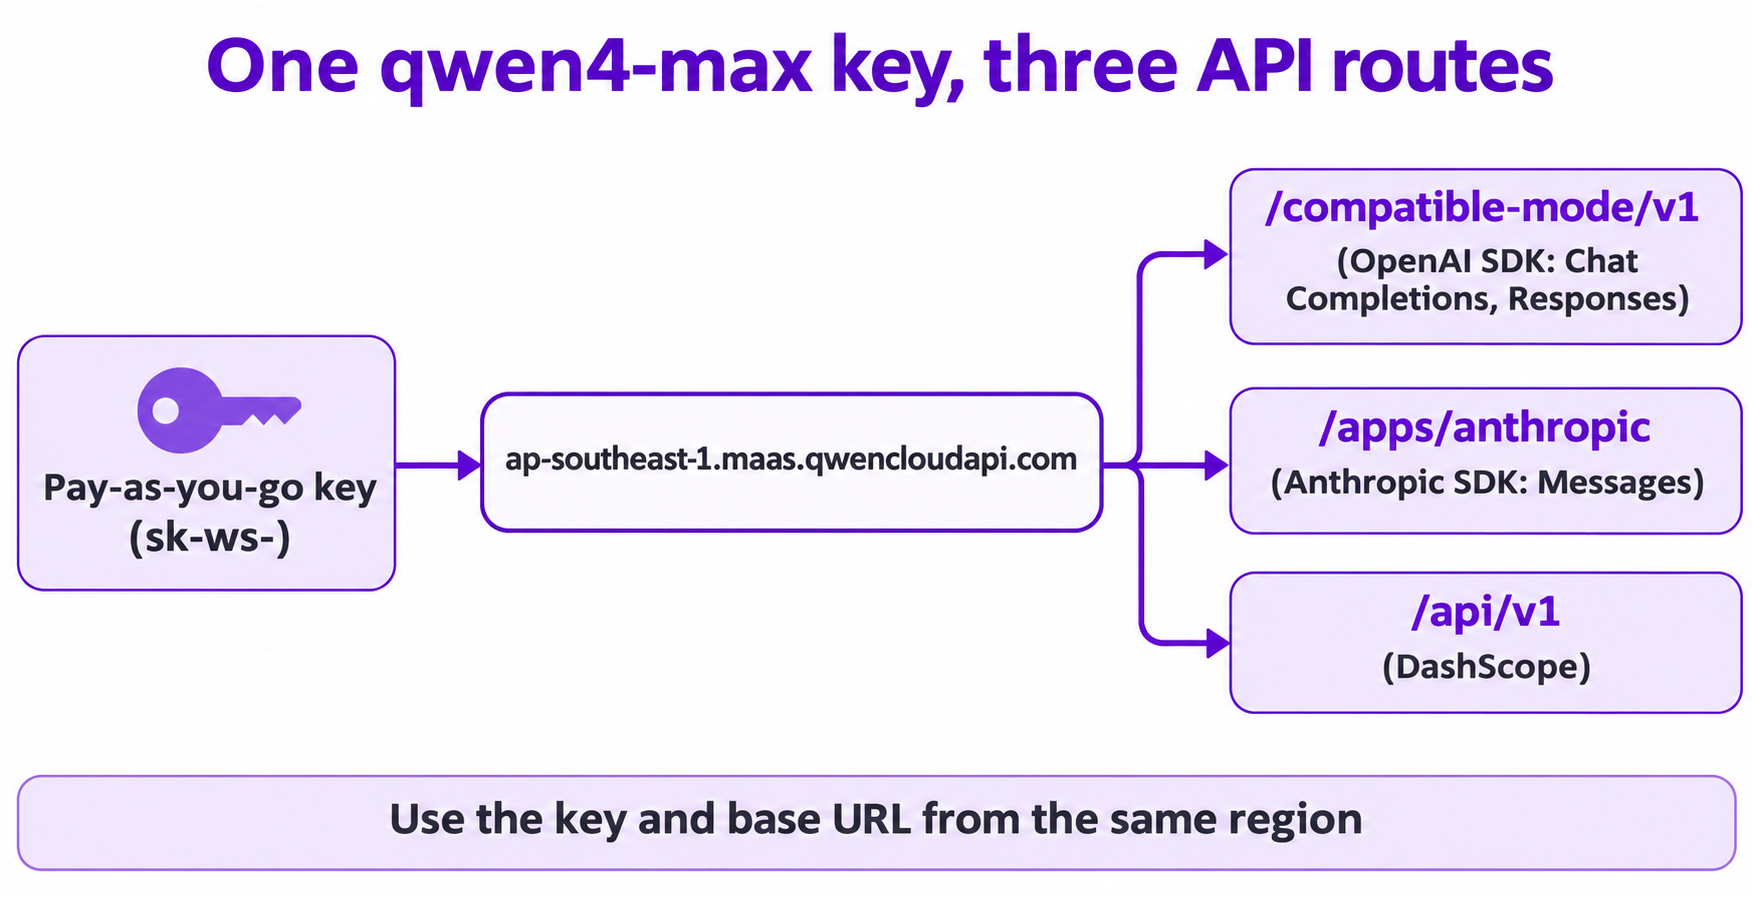
Une clé Token Plan (sk-sp-) ne fonctionne que sur token-plan.maas.qwencloudapi.com, et une clé pay-as-you-go uniquement sur le domaine de sa propre région. Les mélanger provoque une erreur 401. Consultez les régions et endpoints.
Votre premier appel à l'API Qwen4-Max
Installez le SDK OpenAI (pip install openai) et exécutez le quickstart de la documentation :
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
Le thinking est activé par défaut pour qwen4-max, donc cet appel consomme également des tokens de raisonnement. Pour les longs prompts, utilisez le streaming ou définissez un timeout client de 180 secondes ou plus.
Mode thinking et streaming du reasoning_content
Qwen4-Max est un modèle hybride avec thinking. Les valeurs par défaut documentées sont enable_thinking=true, reasoning_effort=high et thinking_budget=131072. Les niveaux d'effort sont low, high et xhigh ; none désactive le thinking.
Streamez le raisonnement et la réponse en deux phases (adapté de l'exemple de la page du modèle) :
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
Trois règles à connaître :
- Limitez la sortie avec
max_completion_tokens. Avec le thinking activé,max_tokensn'accepte que des valeurs de 1 à 32 768 (sinon erreur 400).max_completion_tokenscouvre le raisonnement plus la réponse sans cette limite. - Ajustez la profondeur avec
extra_body. Passez{"enable_thinking": True, "reasoning_effort": "xhigh"}pour les problèmes difficiles, ou"low"pour les cas simples. - Préservez le raisonnement dans les conversations multi-tours.
qwen4-maxapreserve_thinkingactivé par défaut : renvoyez donc le raisonnement précédent dans le champreasoning_contentde chaque message assistant, jamais danscontent.
Pour désactiver le thinking, passez {"enable_thinking": False}.
Entrées image et vidéo
Envoyez les images en parties image_url et les vidéos en parties video_url. Ceci reprend l'exemple vision de la documentation avec le modèle défini sur qwen4-max :
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
Pour la vidéo, utilisez {"type": "video_url", "video_url": {"url": "..."}, "fps": 2}. Les fichiers locaux sont transmis en Data URIs Base64.
Le guide vision autorise jusqu'à 2 048 images par URL de 20 Mo chacune, 250 images Base64, et 64 Mo par requête. Le niveau de détail des images est par défaut « high », ce qui consomme plus de tokens en entrée.
Function calling
Passez un tableau tools comme pour tout modèle compatible OpenAI :
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
Lisez message.tool_calls, exécutez la fonction, ajoutez un message tool puis appelez à nouveau.
En mode thinking, tool_choice n'accepte que "auto" ou "none" ; pour forcer une fonction, désactivez d'abord le thinking. Avec le thinking activé, renvoyez reasoning_content avec les résultats d'outils, sinon la précision diminue.
Sorties structurées
qwen4-max prend en charge le mode strict JSON Schema :
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
Avec le mode plus souple {"type": "json_object"}, le mot « JSON » doit apparaître dans un message, sinon l'API rejette la requête. Avec une entrée image ou vidéo, le mode retombe sur json_object : le schéma n'est donc pas appliqué aux appels multimodaux.
Cache de contexte et batch
Cache. Sans réglage, le cache implicite fait correspondre les préfixes mais ne garantit pas les correspondances. Pour des correspondances déterministes, utilisez le cache explicite Qwen4 : marquez un bloc de contenu avec "prompt_cache_breakpoint": {"mode": "explicit"} (le content du message doit être un tableau), et définissez le TTL avec extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}}. Le TTL est de 5m ou 1h, et le préfixe en cache doit compter au moins 1 024 tokens. Les lectures coûtent 0,075 $ par million de tokens, soit 95 % de moins qu'une entrée fraîche.
Batch. Le guide batch facture l'entrée et la sortie à 50 % du prix temps réel et renvoie les résultats sous 24 heures. Pour qwen4-max, Batch File s'exécute dans une région hors Singapour et ne prend pas en charge le cache de contexte ; consultez donc le guide batch avant de construire un pipeline autour.
La route compatible Anthropic
Vous travaillez déjà avec le SDK Anthropic ? Changez simplement l'URL de base et la clé :
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
Cet exemple désactive le thinking, comme celui de la documentation. Terminez l'URL de base à /apps/anthropic. Ajouter /v1/ produit /v1/v1/... et une erreur 404. Le thinking est également activé par défaut ici, et avec le thinking activé, max_tokens doit dépasser le budget de raisonnement. L'effort se règle via output_config.effort (low, high, xhigh), et les outils intégrés web_search et web_fetch sont disponibles sur cette route.
Limites de débit de l'API Qwen4-Max
D'après la page des limites de débit :
| Région | RPM | TPM |
|---|---|---|
| Singapour | Dynamique | Paliers dynamiques : 5M, 10M, 20M |
| Francfort, Tokyo, US (Virginie) et autres régions à portée mondiale | 30 000 | 5 000 000 |
Les limites s'appliquent par compte et par région, mais aussi par seconde (RPS = RPM / 60) : une rafale peut donc vous faire être limité en dessous du total par minute.
La page du quota gratuit indique que le quota gratuit n'existe qu'à Singapour, est attribué par modèle (généralement 1 000 000 de tokens), dure 90 jours et nécessite des coordonnées de paiement enregistrées. Elle ne mentionne pas qwen4-max : vérifiez la page Free Tier dans la console, ou lisez comment utiliser Qwen4-Max gratuitement.
Erreurs courantes de l'API Qwen4-Max
| Code | Signification | Solution |
|---|---|---|
401 InvalidApiKey |
La clé et l'URL de base proviennent de régions différentes, ou une clé Token Plan a été utilisée sur un endpoint pay-as-you-go | Utilisez une clé créée dans la même région que l'URL |
400 InvalidParameter |
Souvent un max_tokens hors de la plage 1 à 32 768 avec le thinking activé |
Passez à max_completion_tokens |
403 AllocationQuota.FreeTierOnly |
Quota gratuit épuisé avant configuration du paiement | Ajoutez vos coordonnées de paiement sur la page Free Tier |
404 ModelNotFound |
qwen4-max n'est pas proposé dans la région appelée |
Vérifiez les prix des modèles pour cette région |
429 Throttling |
Limite RPM ou TPM atteinte | Attendez avant de réessayer, ou répartissez la charge sur plusieurs secondes |
Laissez votre agent de codage tester l'API Qwen4-Max avec Apidog CLI
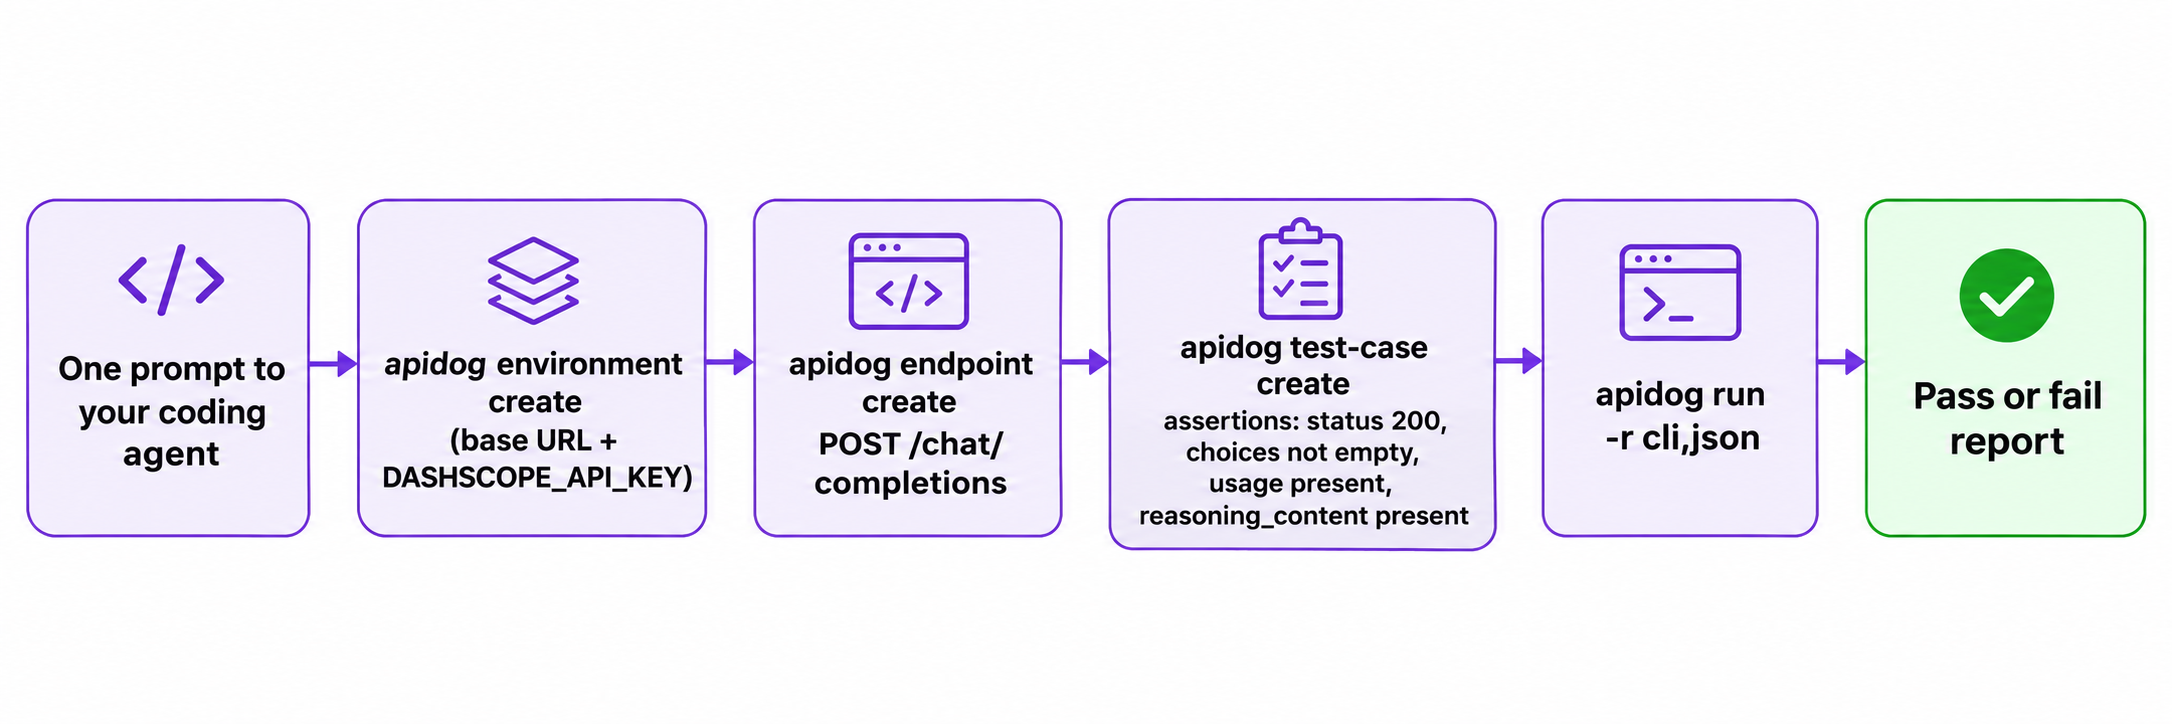
Votre agent de codage écrit l'intégration : laissez-le aussi écrire le test de régression. Apidog CLI lui permet d'enregistrer l'endpoint, de stocker la clé et d'exécuter des assertions.
Configurez-le une seule fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un seul prompt à votre agent :
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
L'agent lit le schéma de chaque payload avant d'écrire, puis exécute le cas de test :
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Le rapporteur cli affiche réussite ou échec ; json génère un rapport que l'agent lit. Intégrez le même apidog run ... -r junit dans votre CI avec le guide CI/CD d'Apidog CLI, et consultez Apidog CLI dans Claude Code pour d'autres prompts. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Quel est l'identifiant du modèle de l'API Qwen4-Max ?
L'identifiant stable est qwen4-max. L'ancien identifiant qwen4-max-preview était réservé au Token Plan pendant la préversion débutée le 11 novembre 2026.
L'API Qwen4-Max est-elle compatible OpenAI ?
Oui. Utilisez le SDK OpenAI avec l'URL de base /compatible-mode/v1 pour Chat Completions et l'API Responses. Un endpoint compatible Anthropic et l'API DashScope sont également disponibles.
Comment désactiver le thinking dans l'API Qwen4-Max ?
Passez extra_body={"enable_thinking": False}. Vous perdez reasoning_content, mais la latence et les tokens de sortie diminuent. Vous comparez des modèles ? Consultez Qwen4-Max vs Qwen3.8.
Combien coûte l'API Qwen4-Max ?
1,50 $ par million de tokens en entrée et 4,50 $ par million en sortie, avec des lectures en cache à 0,075 $ par million.
Puis-je utiliser ma clé Token Plan avec l'API pay-per-token ?
Non. Les clés Token Plan (sk-sp-) ne fonctionnent que sur token-plan.maas.qwencloudapi.com, et les clés pay-as-you-go uniquement sur le domaine de leur propre région.