
Alibaba a sorti Qwen 3.8-Max début août 2026, et si vous utilisez déjà qwen3.7-max en production, vous avez une vraie décision à prendre. Le nouveau modèle affiche de grands progrès sur les benchmarks d'agents et de recherche, ajoute l'entrée d'image, est lancé à un prix catalogue inférieur et s'accompagne d'une promesse qu'Alibaba n'avait jamais faite pour son prédécesseur : des poids ouverts.
Mais la décision n'est pas aussi simple que "le nouveau modèle gagne". Qwen 3.7-Max bénéficie actuellement d'une réduction limitée de 50 % qui le rend moins cher que 3.8-Max en termes absolus. Certains deltas de benchmarks sont spectaculaires. D'autres sont pratiquement nuls. Cet article passe en revue chaque changement important, afin que vous puissiez décider de passer à la nouvelle version maintenant, d'attendre ou de descendre d'un niveau.
Si vous voulez avoir une vue d'ensemble du nouveau modèle, commencez par notre explication de Qwen 3.8-Max. Pour en savoir plus sur le produit phare précédent, consultez ce que Qwen 3.7 a apporté.
Une remarque sur la méthodologie avant les chiffres. Chaque chiffre de benchmark ci-dessous provient du tableau d'Alibaba dans le billet de blog officiel de sortie de Qwen 3.8. C'est en fait utile ici : les deux modèles ont été évalués dans la même exécution fournisseur, donc les deltas sont cohérents en interne, même si une vérification indépendante est toujours en attente. La plupart des lignes de codage ont été exécutées sur l'environnement Claude Code, et plusieurs benchmarks sont internes à Qwen.
La version courte
| Ce qui a changé | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| Prix catalogue (pour 1M de tokens) | 2,5 $ entrée / 7,5 $ sortie | 2 $ entrée / 6 $ sortie |
| Prix actuel (promo) | 1,25 $ entrée / 3,75 $ sortie | 2 $ entrée / 6 $ sortie |
| Saisie d'image | Non | Oui |
| Architecture divulguée | Non divulguée | 2,4T au total, 95B MoE actif |
| Poids ouverts | Jamais publiés | Promis "la semaine prochaine" (vers le 10 août) |
| Fenêtre de contexte | 1M de tokens | 1M de tokens |
Maintenant, les détails.
Deltas de benchmarks : là où le bond est réel
Les améliorations principales se concentrent sur le travail agentique : des tâches à long terme où le modèle planifie, exécute et s'auto-corrige.
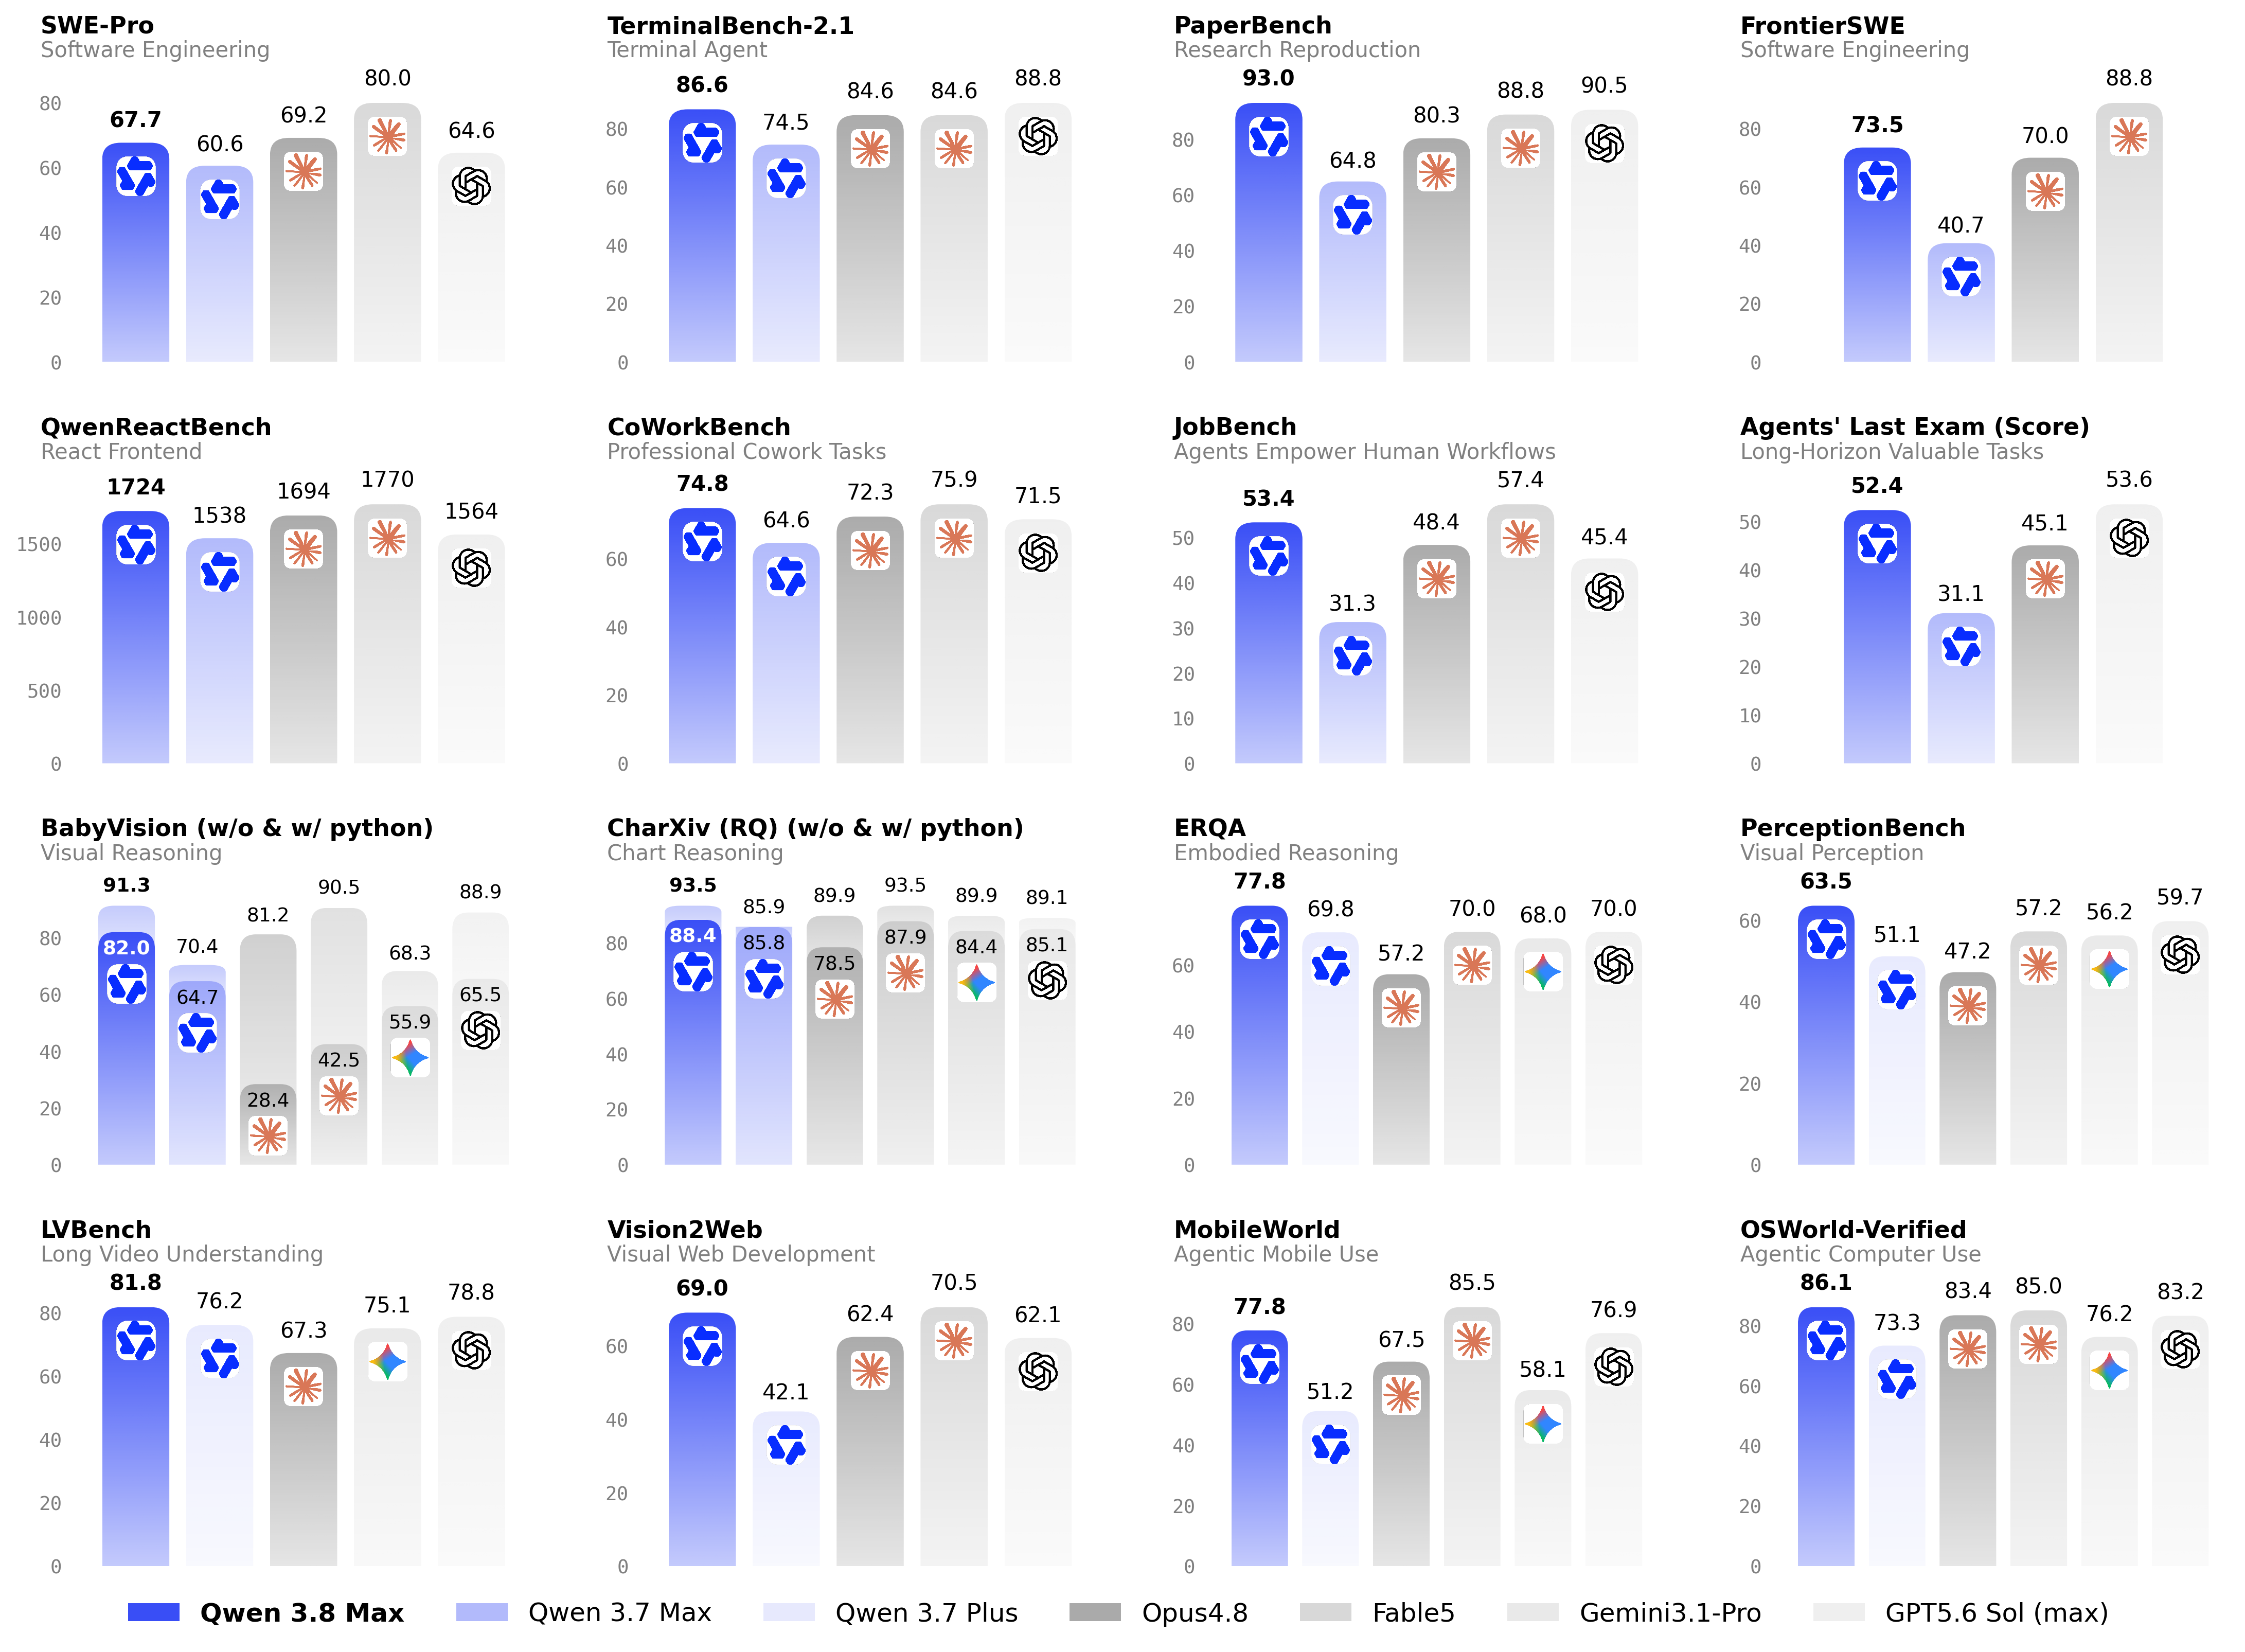
Terminal Bench 2.1 : 74,5 à 86,6. Il s'agit d'un bond de 12 points sur les tâches agentiques pilotées par terminal, et il fait passer Qwen de clairement en retard à véritablement compétitif. Dans le même tableau, Alibaba note Claude Opus 4.8 et Fable 5 à 84,6 chacun, ce qui place 3.8-Max devant les deux sur cette ligne. GPT-5.6 Sol mène toujours à 88,8.
SWE-bench Pro : 60,6 à 67,7. Un gain de 7 points sur des tâches d'ingénierie logicielle du monde réel. Significatif, mais restons honnêtes : Fable 5 est à 80,0 dans le même tableau, il s'agit donc d'un rattrapage, pas d'un dépassement. Si la performance SWE-bench Pro est votre critère d'achat principal, la frontière se situe toujours ailleurs.
PaperBench : 64,8 à 93,0. Le plus grand delta du tableau, un bond de 28 points sur la reproduction d'articles de recherche en IA. C'est aussi la meilleure ligne phare de 3.8-Max, devant tous ses rivaux dans la comparaison d'Alibaba. Si votre charge de travail implique la reproduction de recherches, de longs documents techniques ou un raisonnement scientifique en plusieurs étapes, c'est le chiffre qui devrait attirer votre attention.
IFBench : 79,1 à 82,8. Le suivi des instructions s'améliore de près de 4 points. Il est à noter que 3.7-Max était déjà solide ici (79,1 battait Opus 4.8 et Fable 5 dans la même exécution), donc cela prolonge une avance existante plutôt que de corriger une faiblesse.
GPQA Diamond : 92,4 à 92,6. Pratiquement stable. La QA scientifique de niveau universitaire était déjà proche de la saturation pour 3.7-Max, et le nouveau modèle ne la fait pas bouger. Si votre charge de travail ressemble à GPQA, la mise à niveau ne vous apporte rien en termes de qualité.
HLE : 41,4 à 43,6. L'Examen Final de l'Humanité s'améliore de 2 points mais reste à la traîne : Fable 5 affiche 53,3 et GPT-5.6 Sol affiche 47,2 dans le même tableau. Qwen 3.8-Max comble les lacunes à de nombreux endroits. Ce n'en est pas un.
La tendance : des gains massifs sur les benchmarks d'agents et de recherche, des gains incrémentiels sur le suivi des instructions, aucun mouvement sur les benchmarks de connaissances saturés, et un écart persistant sur les évaluations de raisonnement les plus difficiles. Pour une analyse plus approfondie du tableau complet, y compris les détails sur les environnements et les benchmarks internes, consultez notre analyse des benchmarks de Qwen 3.8.
Architecture : Alibaba révèle enfin ses chiffres
Qwen 3.8-Max est un modèle de mélange d'experts (MoE) de 2,4 trillions de paramètres avec 95 milliards de paramètres actifs par passe avant, construit sur la base architecturale de Qwen 3.5. Cela représente un ratio d'activation d'environ 4 %, ce qui est important pour les coûts de service : vous payez le calcul pour 95 milliards, pas pour 2,4 trillions.
Le contraste avec 3.7-Max est la divulgation elle-même. Alibaba n'a jamais publié de chiffres d'échelle comparables pour Qwen 3.7-Max. Le nombre de paramètres, les ratios d'activation, la configuration des experts : tout était non divulgué. Avec 3.8-Max, la documentation du modèle Model Studio et le billet de blog de sortie détaillent l'architecture, ce qui rend la planification des capacités et la modélisation des coûts beaucoup moins aléatoires.
Dans le contexte de la course aux poids ouverts : Kimi K3 fonctionne avec 2,8T au total et 104B actifs. Qwen 3.8-Max est plus petit sur les deux axes.
Multimodal : la capacité que 3.7-Max n'a jamais eue
Qwen 3.7-Max est un modèle textuel. Qwen 3.8-Max accepte nativement les images en entrée, et Alibaba a publié un tableau de benchmarks multimodal distinct où il domine la plupart des lignes face à Gemini 3.1 Pro et GPT-5.6 Sol.
Les scores remarquables du tableau multimodal d'Alibaba : MathVision à 95,2, LogicVista à 91,9 et OSWorld-Verified à 86,1 pour les tâches d'utilisation informatique. Il n'y a pas de colonne 3.7-Max dans ce tableau pour la comparaison, car cela n'aurait pas été possible : l'ancien modèle n'accepte pas les images.
En pratique, cela signifie que les charges de travail que vous deviez auparavant acheminer vers un modèle de vision distinct (compréhension de captures d'écran, images de documents, automatisation de l'interface utilisateur, extraction de graphiques) peuvent désormais être exécutées sur le même ID de modèle que votre trafic textuel. Le billet de blog de sortie démontre également la compréhension de longs documents et de vidéos, bien qu'il s'agisse de capacités démontrées dans des blogs plutôt que de types d'entrée API distincts, il faut donc vérifier les documentations API pour votre cas spécifique.
Tarification : le nouveau modèle est moins cher, sauf pour le moment
C'est là que les calculs de mise à niveau deviennent intéressants.
Qwen 3.8-Max est lancé à 2 $ en entrée / 6 $ en sortie par million de tokens, un tarif forfaitaire unique sur l'ensemble du contexte de 1M. Qwen 3.7-Max est répertorié à 2,5 $ / 7,5 $. Ainsi, le nouveau modèle, plus performant, sous-cote le prix catalogue de son prédécesseur de 20 %. Cela n'arrive presque jamais lors d'un changement de génération phare.
Mais il y a un hic : Alibaba propose actuellement une promotion limitée de 50 % sur 3.7-Max, ce qui ramène son taux effectif à 1,25 $ / 3,75 $. Aux prix actuels, l'ancien modèle coûte 38 % de moins que le nouveau. Tous les tarifs sont disponibles sur la page de tarification officielle de Model Studio.
Deux choses à garder à l'esprit :
- La promotion peut se terminer. Alibaba la qualifie de limitée dans le temps et n'a publié aucune date de fin. Si vous concevez votre architecture autour de 1,25 $ / 3,75 $, votre hypothèse budgétaire a une date d'expiration que vous ne pouvez pas voir. Aux prix catalogue, 3.8-Max est le modèle le moins cher.
- Les tokens de réflexion gonflent les factures réelles. Qwen 3.8-Max utilise par défaut
reasoning_effort: xhigh, et les tokens de réflexion sont facturés en tant que sortie. Votre coût effectif par requête peut être bien supérieur à ce que le prix indiqué suggère. Notre guide de tarification de Qwen 3.8 explique l'économie du cache et le calcul du coût par tâche.
Et si aucun des modèles Max ne correspond à votre budget, qwen3.7-plus à 0,4 $ / 1,6 $ (actuellement 20 % de réduction) reste l'option économique. La comparaison Plus vs Max explique quand Plus est suffisant.
Poids ouverts : une première pour la classe Max
Aucun modèle de la classe Qwen-Max n'a jamais été livré avec des poids ouverts. Qwen 3.7-Max n'en a pas eu, et Alibaba n'a jamais suggéré qu'il en aurait. Qwen 3.8-Max rompt avec ce modèle : le communiqué de presse promet des poids sur Hugging Face et ModelScope "la semaine prochaine", ce qui indique approximativement le 10 août.
Au moment de la rédaction de cet article (3 août 2026), les poids ne sont pas téléchargeables. Traitez la promesse comme une promesse. Le précédent est encourageant : les poids de Kimi K3 sont arrivés 11 jours après le lancement, et Alibaba a un long historique de poids ouverts avec des modèles Qwen plus petits. Mais un téléchargement de paramètres de 2,4T est un projet d'auto-hébergement multi-nœuds, même quantifié, donc pour la plupart des équipes, l'impact pratique sera un accès hébergé par des tiers et une pression sur les prix, et non un modèle fonctionnant sur votre propre rack.
Si les poids ouverts sont importants pour votre histoire d'approvisionnement ou de conformité, cela seul peut régler la question 3.7 vs 3.8. Un modèle les aura (probablement). L'autre ne les aura jamais.
Ce qui n'a pas changé
Il est important de le dire clairement, car les articles sur les mises à niveau ont tendance à exagérer :
- Fenêtre de contexte : 1M de tokens pour les deux. Pas d'extension. Si vous avez choisi 3.7-Max pour son long contexte, 3.8-Max maintient la ligne au même 1M avec un prix fixe sur toute la fenêtre.
- Chemin d'accès : le même. Les deux modèles sont servis via Alibaba Cloud Model Studio avec des points de terminaison compatibles OpenAI. Le passage de l'un à l'autre est un changement d'ID de modèle (
qwen3.7-maxversqwen3.8-max), pas un projet de migration. 3.8-Max ajoute en outre une surface API compatible Anthropic, ce qui vaut la peine d'être exercé dans un client comme Apidog si votre outillage parle ce protocole. - Contrôles de raisonnement : désormais officiels.
reasoning_effortest un paramètre documenté et pris en charge sur 3.8-Max avec trois niveaux (xhigh par défaut, medium, low), ainsi queenable_thinkingetpreserve_thinking. Si vous avez ajusté des prompts autour du comportement de raisonnement implicite sur 3.7-Max, vous disposez désormais d'un réglage explicite.
Faut-il passer à la nouvelle version ? Trois approches honnêtes
Mettez à niveau maintenant si votre charge de travail est agentique ou axée sur la recherche. Les deltas de Terminal Bench (74,5 à 86,6) et PaperBench (64,8 à 93,0) sont le genre de bond que l'on peut ressentir en production, et vous obtenez en prime la saisie d'images ainsi qu'un prix catalogue inférieur. Si vous construisez des agents qui opèrent des terminaux, reproduisent des travaux techniques ou traitent des captures d'écran, le cas est clair.
Profitez de la promo 3.7-Max si votre charge de travail se situe dans les zones stables. Les tâches de connaissance de type GPQA n'ont bougé que de 0,2 point. Si votre trafic est de type questions-réponses, résumé ou chat général, et que 3.7-Max répond déjà à vos exigences de qualité, 1,25 $ / 3,75 $ est la meilleure offre par token que l'un ou l'autre des modèles Max ait jamais proposée. Mettez un rappel dans votre calendrier pour vérifier le statut de la promo chaque mois, et sachez que votre prix de repli est 3.8-Max à 2 $ / 6 $, et non 3.7-Max au prix catalogue.
Passez à qwen3.7-plus si vous êtes axé sur le prix et que vos tâches sont routinières. À 0,4 $ / 1,6 $, il est 5 fois moins cher que 3.8-Max en entrée, et pour la classification, l'extraction et la génération de modèles, la capacité de classe Max est souvent une dépense inutile.
Testez le changement avant de vous engager
Les benchmarks des fournisseurs, même s'ils sont cohérents en interne, ne prédisent pas le comportement d'un modèle avec vos prompts. La manière la moins chère de régler cette question est une comparaison côte à côte sur votre charge de travail réelle.
Dans Apidog, vous pouvez configurer cela en quelques minutes : pointez une collection vers le point de terminaison compatible OpenAI de Model Studio, puis créez deux environnements qui ne diffèrent que par la variable d'ID de modèle, l'un configuré sur qwen3.7-max et l'autre sur qwen3.8-max. Exécutez le même ensemble de requêtes sur les deux, basculez d'un environnement à l'autre en un clic, et comparez les sorties, la latence et l'utilisation des tokens depuis la visionneuse de réponses. Étant donné que les deux modèles partagent la même surface d'API, une seule collection couvre les deux, et vous pouvez enregistrer des prompts de production représentatifs comme scénarios de test et les réexécuter chaque fois qu'Alibaba déploie une mise à jour ou que la tarification promotionnelle change.
Cela transforme la question "devrions-nous mettre à jour ?" d'un débat sur les benchmarks en une après-midi de preuves. Téléchargez Apidog gratuitement et exécutez la comparaison avec votre propre trafic avant de modifier une configuration de production.
FAQ
Qwen 3.8-Max est-il moins cher que Qwen 3.7-Max ?
Au prix catalogue, oui : 2 $ / 6 $ contre 2,5 $ / 7,5 $ par million de tokens. Aux prix réels actuels, non : la promotion limitée de 50 % de 3.7-Max le ramène à 1,25 $ / 3,75 $, ce qui sous-cote 3.8-Max de 38 %. La promotion n'a pas de date de fin publiée. Les détails complets des coûts se trouvent dans notre guide de tarification de Qwen 3.8.
Dois-je modifier mon code pour passer de qwen3.7-max à qwen3.8-max ?
Pour une utilisation de base, non. Les deux modèles sont servis via les mêmes points de terminaison Model Studio compatibles OpenAI, donc le changement consiste à échanger l'ID du modèle. Vous voudrez peut-être définir explicitement reasoning_effort, car 3.8-Max utilise par défaut xhigh et les jetons de réflexion sont facturés comme sortie. Si vous envoyez des images, il s'agit d'une capacité spécifique à 3.8-Max et nécessite le format de message d'entrée d'image standard.
Qwen 3.7-Max a-t-il des poids ouverts ?
Non, et il n'en aura jamais, compte tenu de l'historique d'Alibaba avec cette ligne. Qwen 3.8-Max est le premier modèle de classe Max avec des poids ouverts promis, attendus sur Hugging Face et ModelScope vers le 10 août 2026. Au 3 août, ils ne sont pas encore téléchargeables.
Qwen 3.8-Max est-il meilleur que Claude ou GPT maintenant ?
Cela dépend de la ligne, et n'oubliez pas que ce sont les chiffres d'Alibaba. Dans leur tableau, 3.8-Max bat Opus 4.8 et Fable 5 sur Terminal Bench 2.1 et mène tout le monde sur PaperBench et IFBench. Il est largement devancé par Fable 5 sur SWE-bench Pro (67,7 contre 80,0) et par tout le monde à la pointe sur HLE. Il n'existe pas encore de chiffres de benchmarks indépendants, alors attendez les évaluations tierces avant de porter un jugement final.