
```html
Dans le monde en évolution rapide de l'intelligence artificielle, une nouvelle étape a été franchie avec la sortie de Qwen 2.5 Omni 7B. Ce modèle révolutionnaire d'Alibaba Cloud représente un bond en avant significatif dans l'IA multimodale, combinant la capacité de traiter et de comprendre plusieurs formes d'entrée tout en générant des sorties de texte et de parole. Plongeons-nous dans ce qui rend ce modèle vraiment spécial et comment il remodèle notre compréhension des capacités de l'IA.
La véritable signification de "Omni" au sein de Qwen 2.5 Omni 7B
Le terme "Omni" dans Qwen 2.5 Omni 7B n'est pas qu'une simple appellation commerciale intelligente, c'est une description fondamentale des capacités du modèle. Contrairement à de nombreux modèles multimodaux qui excellent dans un ou deux types de données, Qwen 2.5 Omni 7B est conçu dès le départ pour percevoir et comprendre :
- Texte (langue écrite)
- Images (informations visuelles)
- Audio (sons et langage parlé)
- Vidéo (contenu visuel en mouvement avec une dimension temporelle)
Voice Chat + Video Chat! Just in Qwen Chat (https://t.co/FmQ0B9tiE7)! You can now chat with Qwen just like making a phone call or making a video call! Check the demo in https://t.co/42iDe4j1Hs
— Qwen (@Alibaba_Qwen) March 26, 2025
What's more, we opensource the model behind all this, Qwen2.5-Omni-7B, under the… pic.twitter.com/LHQOQrl9Ha
Ce qui est encore plus impressionnant, c'est que ce modèle ne se contente pas de prendre ces entrées variées, il peut répondre avec du texte et des sorties vocales naturelles en continu. Cette capacité "any-to-any" représente une avancée significative vers des interactions d'IA plus naturelles et humaines.
L'architecture innovante de Qwen 2.5 Omni 7B : explication
Thinker-Talker : un nouveau paradigme
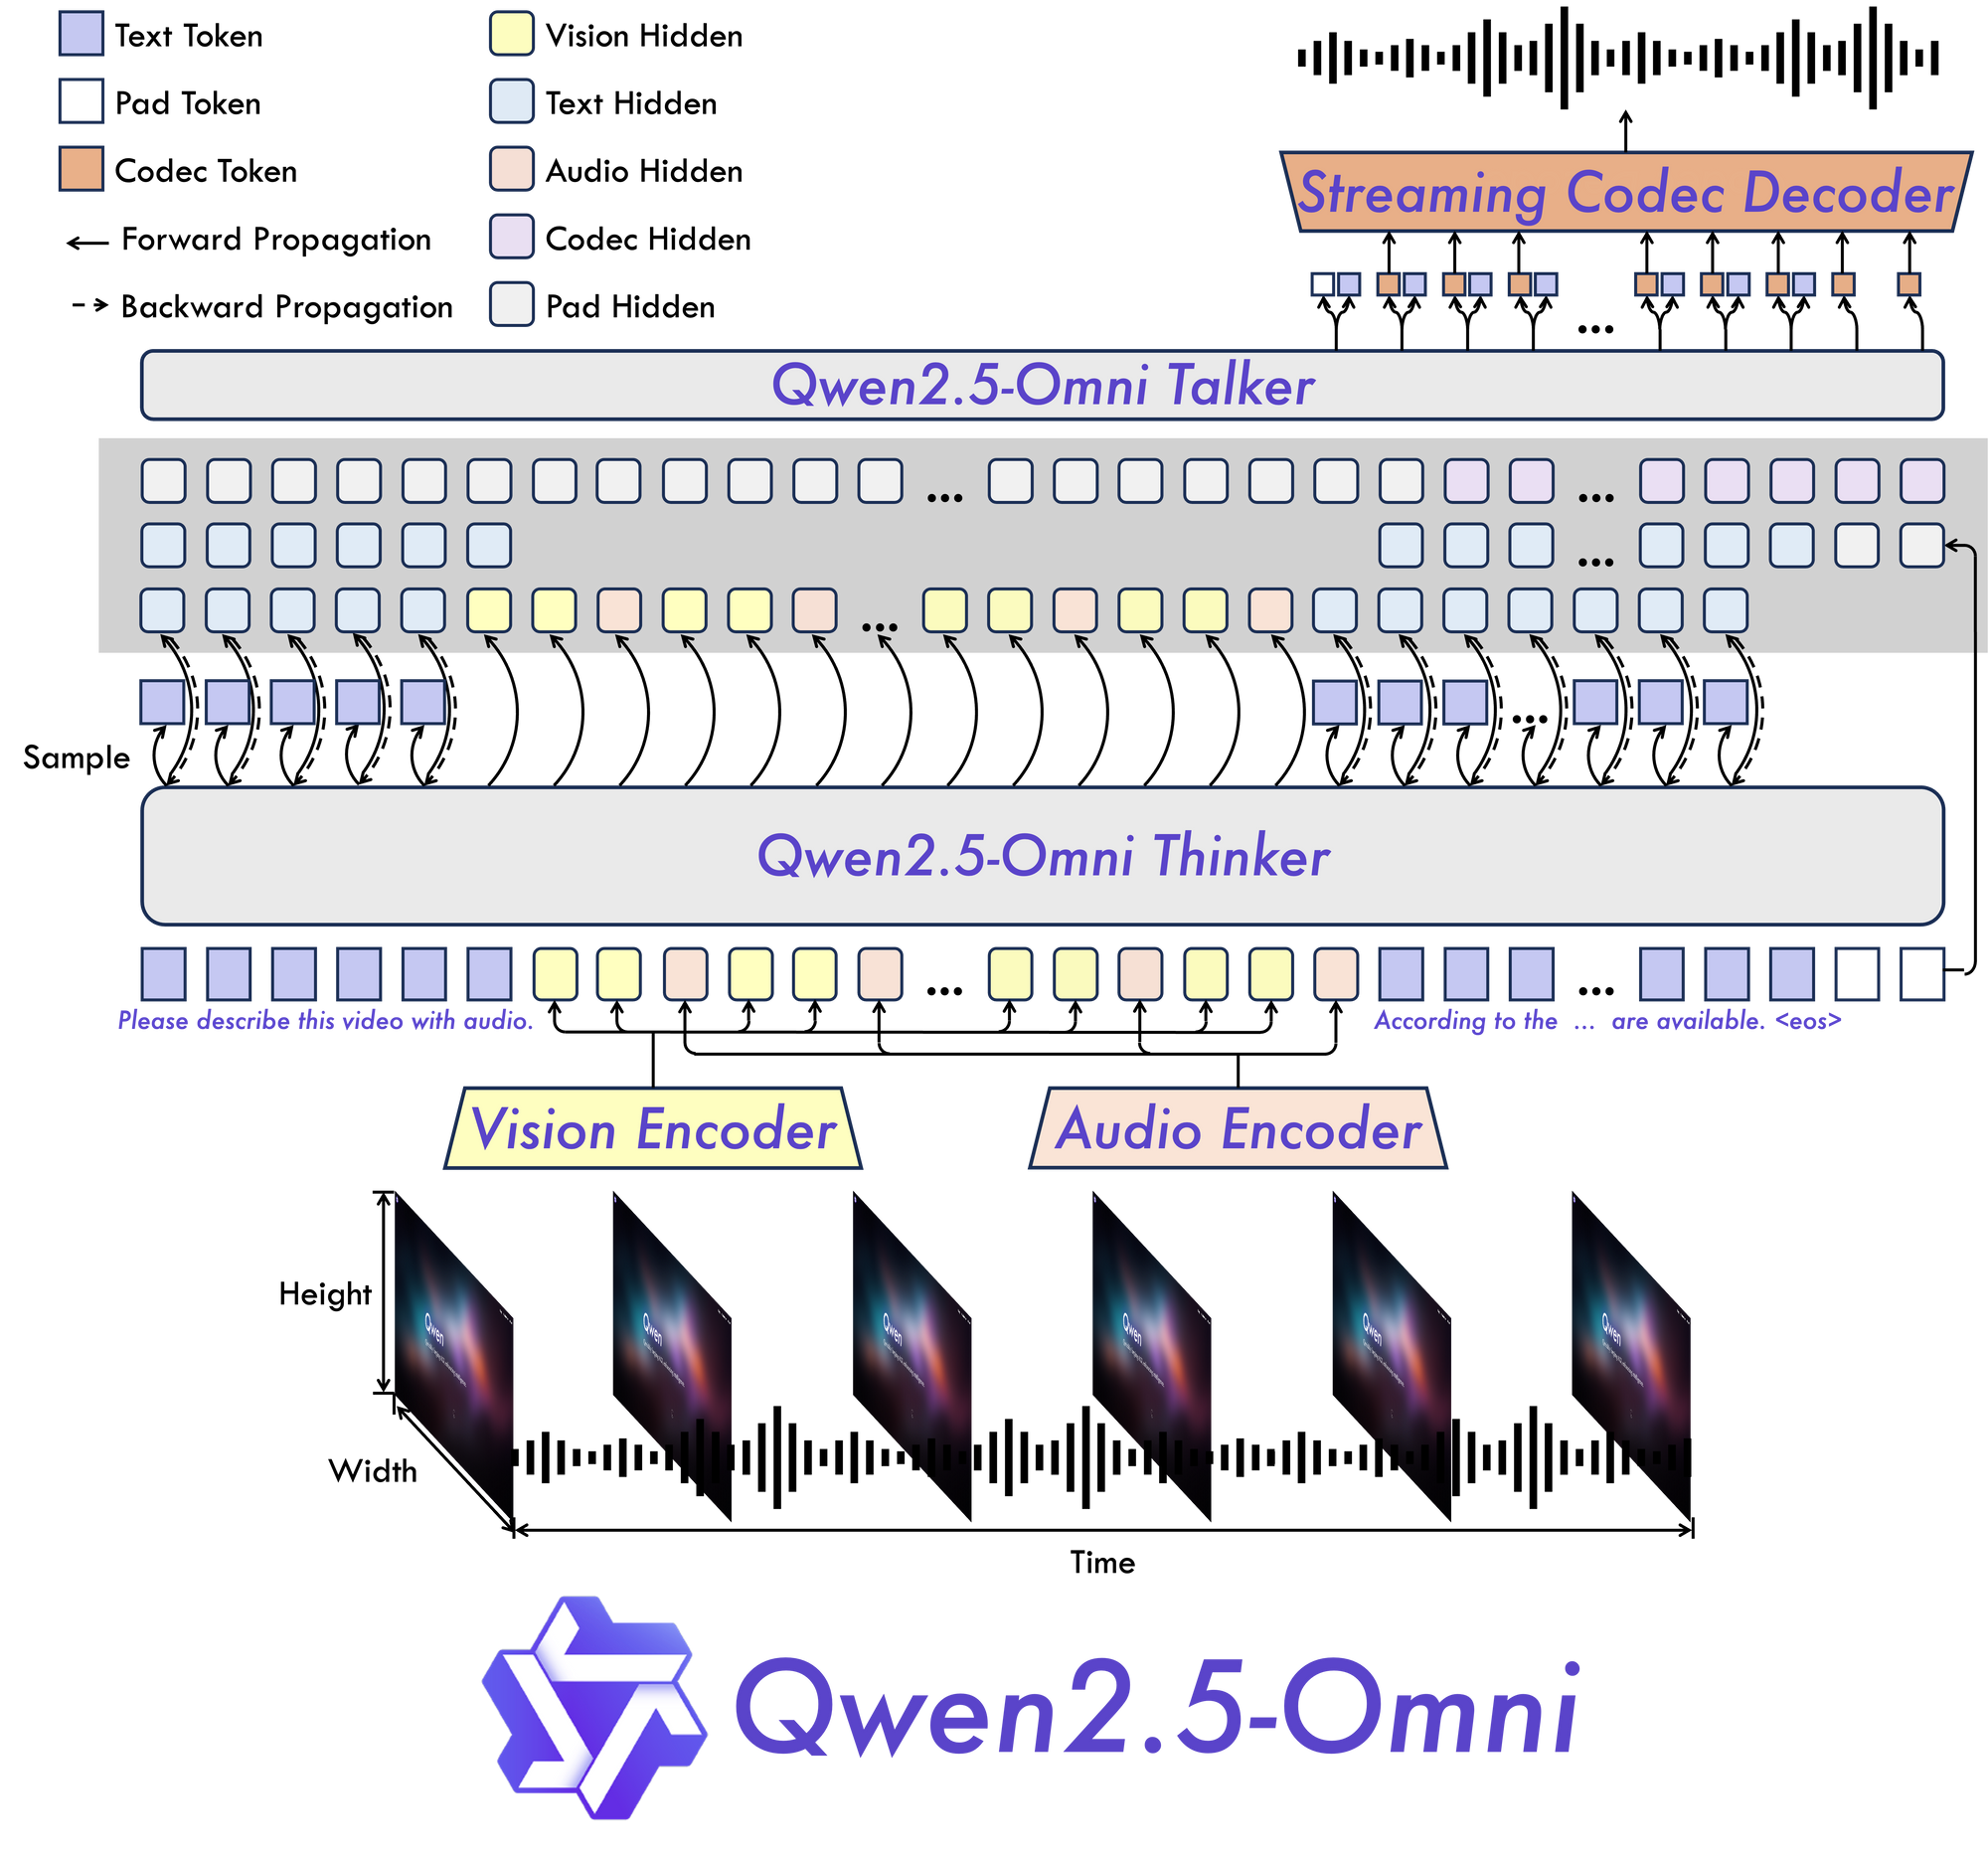
Au cœur de Qwen 2.5 Omni 7B se trouve son architecture fondamentale "Thinker-Talker". Cette nouvelle conception crée un modèle spécifiquement conçu pour être multimodal de bout en bout, permettant un traitement transparent de différents types d'informations.
Comme son nom l'indique, cette architecture sépare le traitement cognitif de l'information (penser) de la génération de sorties (parler). Cette séparation permet au modèle de gérer efficacement les complexités inhérentes aux données multimodales et de produire des réponses appropriées dans plusieurs formats.
TMRoPE : résoudre le défi de l'alignement temporel
L'une des innovations les plus importantes de Qwen 2.5 Omni 7B est son mécanisme Time-aligned Multimodal RoPE (TMRoPE). Cette percée s'attaque à l'un des aspects les plus difficiles de l'IA multimodale : la synchronisation des données temporelles provenant de différentes sources.
Lors du traitement simultané de la vidéo et de l'audio, le modèle doit comprendre comment les événements visuels s'alignent sur les sons ou la parole correspondants. Par exemple, faire correspondre les mouvements des lèvres d'une personne à ses paroles nécessite un alignement temporel précis. TMRoPE fournit le cadre sophistiqué pour réaliser cette synchronisation, permettant au modèle de construire une compréhension cohérente des entrées multimodales qui se déroulent dans le temps.
Conçu pour l'interaction en temps réel
Qwen 2.5 Omni 7B a été conçu pour les applications en temps réel. L'architecture prend en charge le streaming à faible latence, permettant le traitement des entrées par blocs et la génération immédiate de sorties. Cela le rend idéal pour les applications nécessitant des interactions réactives, telles que les assistants vocaux, l'analyse vidéo en direct ou les services de traduction en temps réel.
Performances de Qwen 2.5 Omni 7B : les références parlent d'elles-mêmes
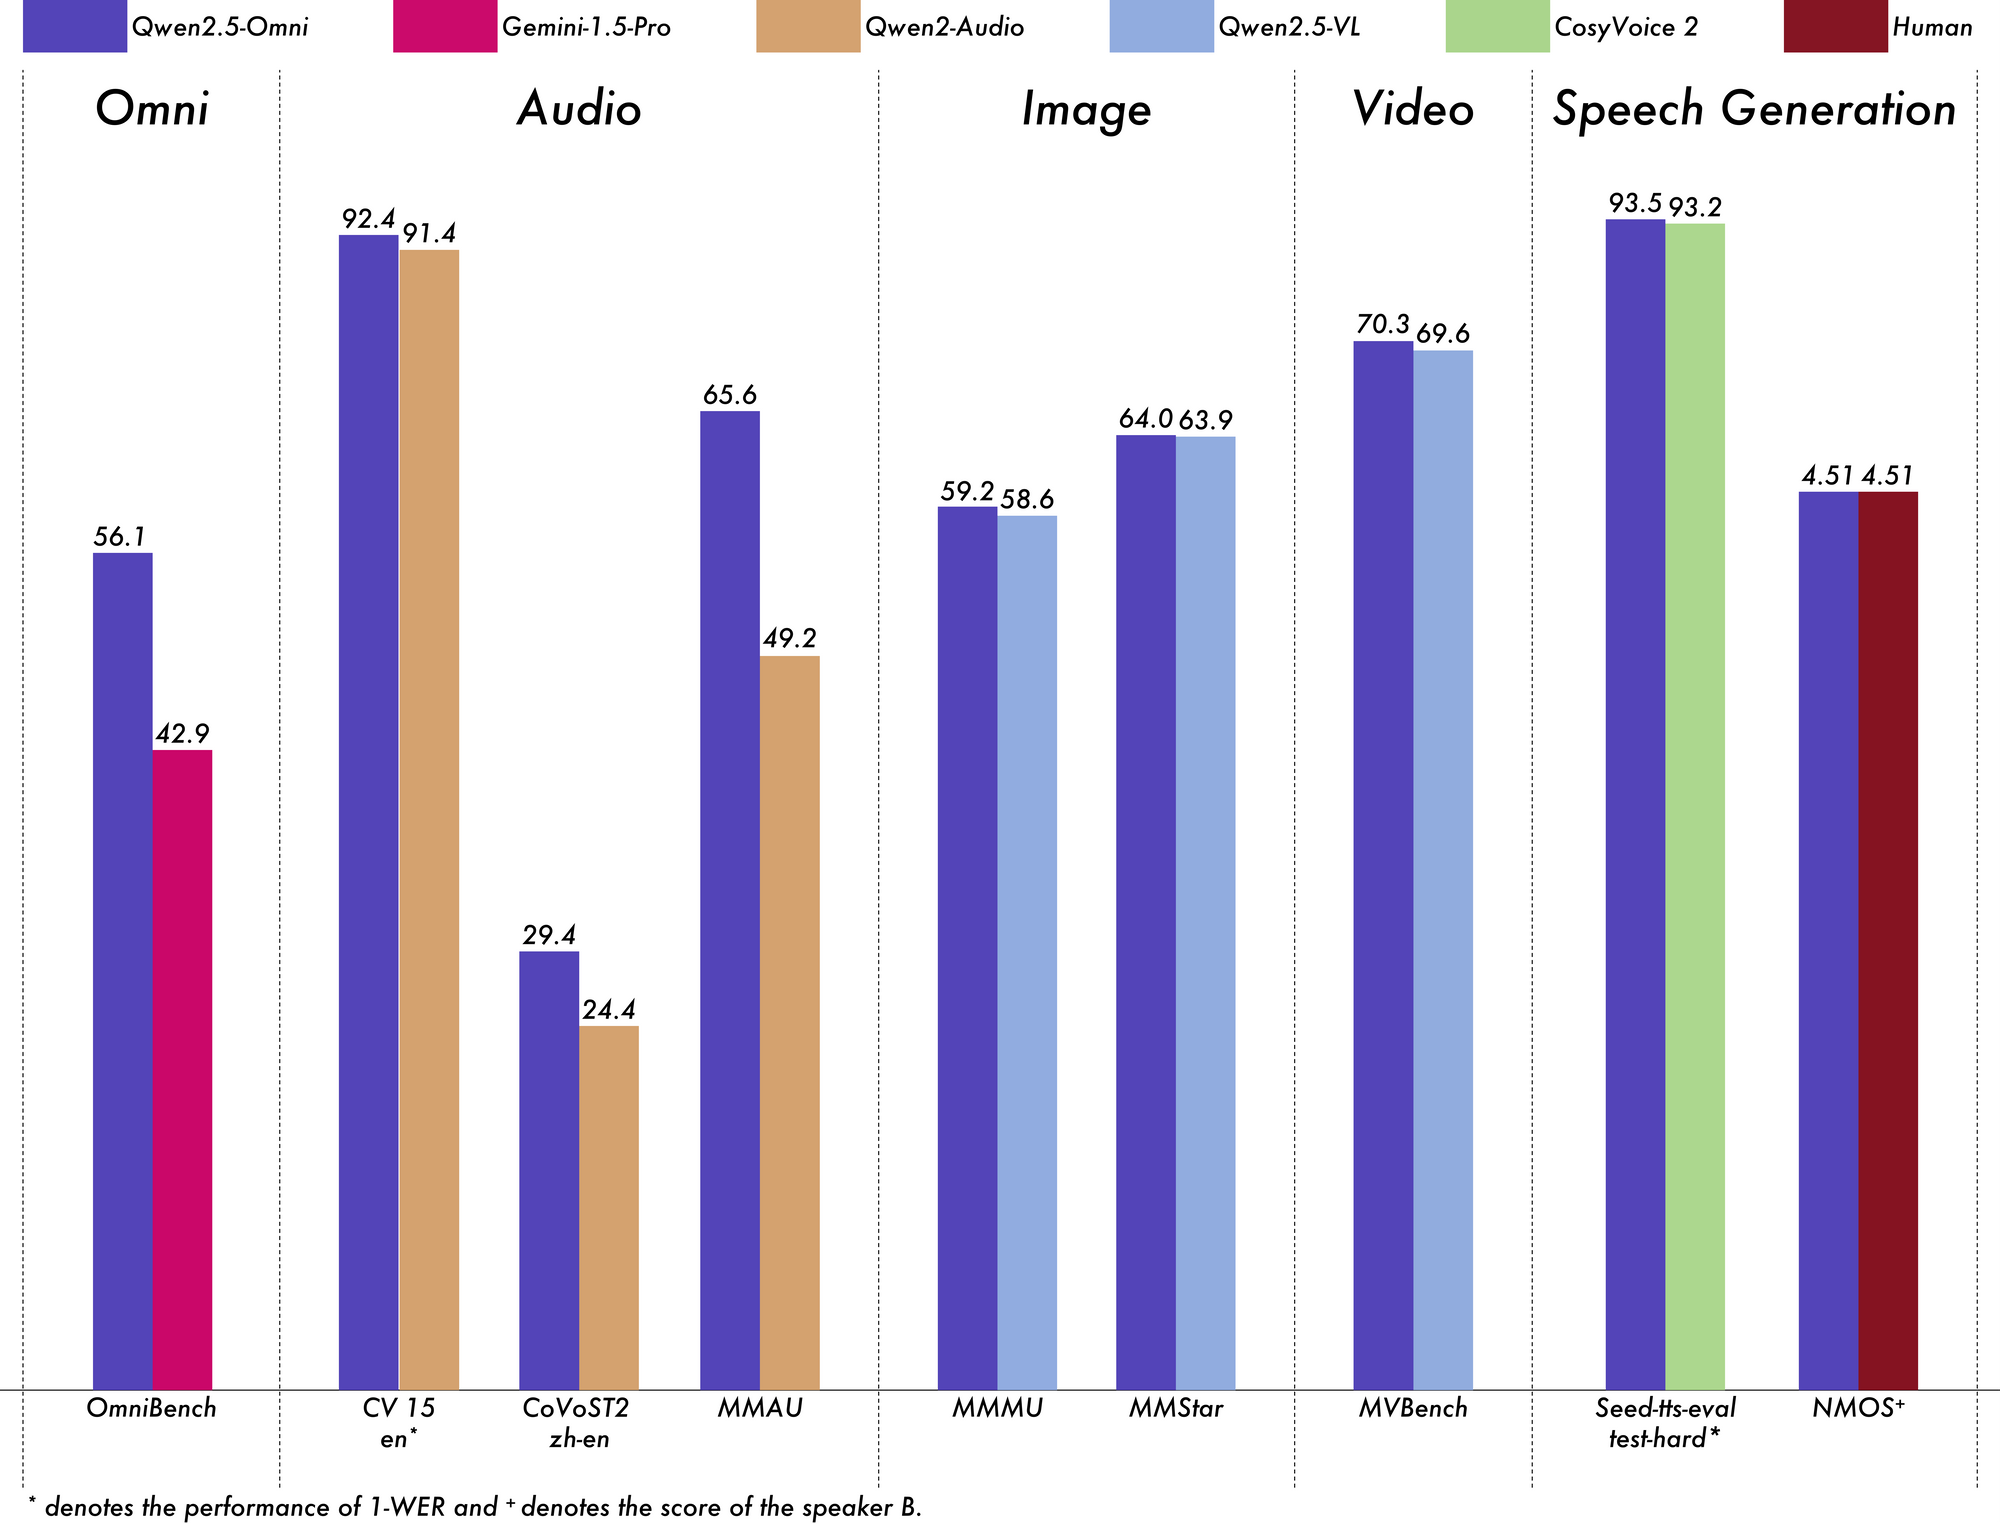
Le véritable test de tout modèle d'IA est sa performance sur des références rigoureuses, et Qwen 2.5 Omni 7B offre des résultats impressionnants sur toute la ligne.
Leader en compréhension multimodale
Sur la référence OmniBench pour la compréhension multimodale générale, Qwen 2.5 Omni 7B atteint un score moyen de 56,13 %. Cela surpasse de manière significative d'autres modèles comme Gemini-1.5-Pro (42,91 %) et MIO-Instruct (33,80 %). Ses performances exceptionnelles dans des catégories spécifiques d'OmniBench sont particulièrement remarquables :
- Tâches vocales : 55,25 %
- Tâches d'événements sonores : 60,00 %
- Tâches musicales : 52,83 %
Cette performance complète démontre la capacité du modèle à intégrer et à raisonner efficacement sur plusieurs modalités.
Exceller dans le traitement audio
Pour les tâches audio-texte, Qwen 2.5 Omni 7B affiche des résultats quasi-constants en matière de reconnaissance vocale automatique (ASR). Sur l'ensemble de données Librispeech, il atteint des taux d'erreur de mots (WER) allant de 1,6 % à 3,5 %, ce qui est comparable aux modèles spécialisés comme Whisper-large-v3.
En reconnaissance d'événements sonores sur l'ensemble de données Meld, il obtient les meilleures performances de sa catégorie avec un score de 0,570. Le modèle excelle même dans la compréhension musicale, avec un score de 0,88 sur la référence GiantSteps Tempo.
Forte compréhension des images
En ce qui concerne les tâches image-texte, Qwen 2.5 Omni 7B atteint un score de 59,2 sur la référence MMMU, ce qui est remarquablement proche des 60,0 de GPT-4o-mini. Sur la tâche de référence RefCOCO Grounding, il atteint une précision de 90,5 %, surpassant les 73,2 % de Gemini 1.5 Pro.
Compréhension vidéo impressionnante
Pour les tâches vidéo-texte sans sous-titres, le modèle obtient un score de 64,3 sur Video-MME, correspondant presque aux performances des modèles vidéo spécialisés. Lorsque des sous-titres sont ajoutés, les performances atteignent 72,4, ce qui démontre la capacité du modèle à intégrer efficacement plusieurs sources d'informations.
Génération de parole naturelle
Qwen 2.5 Omni 7B ne se contente pas de comprendre, il parle. Pour la génération de la parole, il atteint des scores de similarité de locuteur allant de 0,754 à 0,752, ce qui est comparable aux modèles texte-parole dédiés comme Seed-TTS_RL. Cela démontre sa capacité à générer une parole naturelle qui conserve les caractéristiques de la voix du locuteur d'origine.
Maintenir de solides capacités textuelles
Malgré son orientation multimodale, Qwen 2.5 Omni 7B fonctionne toujours admirablement sur les tâches textuelles uniquement. Il obtient de solides résultats en matière de raisonnement mathématique (score GSM8K : 88,7 %) et de génération de code. Bien qu'il y ait un léger compromis par rapport au modèle Qwen2.5-7B texte uniquement (qui obtient un score de 91,6 % sur GSM8K), cette légère baisse est un compromis raisonnable pour acquérir des capacités multimodales aussi complètes.
Applications concrètes de Qwen 2.5 Omni 7B :
Qwen 2.5 Omni is NUTS!
— Jeff Boudier 🤗 (@jeffboudier) March 26, 2025
I can't believe a 7B model
can take text, images, audio, video as input
give text and audio as output
and work so well!
Open source Apache 2.0
Try it, link below!
You really cooked @Alibaba_Qwen ! pic.twitter.com/pn0dnwOqjY
La polyvalence de Qwen 2.5 Omni 7B ouvre un large éventail d'applications pratiques dans de nombreux domaines.
Interfaces de communication améliorées
Ses capacités de streaming à faible latence le rendent idéal pour les applications de chat vocal et vidéo en temps réel. Imaginez des assistants virtuels qui peuvent voir, entendre et parler naturellement, comprendre les indices de communication verbaux et non verbaux tout en répondant avec une parole naturelle.
Analyse de contenu avancée
La capacité du modèle à traiter et à comprendre diverses modalités le positionne comme un outil puissant pour l'analyse complète du contenu. Il peut extraire des informations de documents multimédias, en identifiant automatiquement les informations clés du texte, des images, de l'audio et de la vidéo simultanément.
Interfaces vocales accessibles
Grâce à ses solides performances en matière de suivi des instructions vocales de bout en bout, Qwen 2.5 Omni 7B permet une interaction plus naturelle et véritablement mains libres avec la technologie. Cela pourrait révolutionner les fonctionnalités d'accessibilité pour les utilisateurs handicapés ou dans les situations où le fonctionnement mains libres est essentiel.
Génération de contenu créatif
La capacité du modèle à générer à la fois du texte et une parole naturelle ouvre de nouvelles possibilités pour la création de contenu. De la génération automatique de narration pour les vidéos à la création de supports pédagogiques interactifs qui répondent aux questions des étudiants avec des explications appropriées, les applications sont vastes.
Service client multimodal
Les entreprises pourraient déployer Qwen 2.5 Omni 7B pour alimenter des systèmes de service client capables d'analyser les requêtes des clients à partir de plusieurs canaux (appels vocaux, chats vidéo, messages écrits) et de répondre naturellement et de manière appropriée à chacun.
Considérations et limites pratiques
Bien que Qwen 2.5 Omni 7B représente une avancée significative dans l'IA multimodale, il y a quelques considérations pratiques à garder à l'esprit lorsque vous travaillez avec lui.
Exigences matérielles
Les capacités complètes du modèle s'accompagnent d'exigences informatiques substantielles. Le traitement d'une vidéo même relativement courte de 15 secondes en précision FP32 nécessite environ 93,56 Go de mémoire GPU. Même avec la précision BF16, une vidéo de 60 secondes nécessite toujours environ 60,19 Go.
Ces exigences peuvent limiter l'accessibilité pour les utilisateurs qui n'ont pas accès à du matériel haut de gamme. Cependant, le modèle prend en charge diverses optimisations comme Flash Attention 2, ce qui peut aider à améliorer les performances sur le matériel compatible.
Personnalisation du type de voix
Il est intéressant de noter que Qwen 2.5 Omni 7B prend en charge plusieurs types de voix pour ses sorties audio. Actuellement, il propose deux options vocales :
- Chelsie : une voix féminine décrite comme "mielleuse, veloutée" avec une "chaleur douce et une clarté lumineuse"
- Ethan : une voix masculine caractérisée comme "brillante, optimiste" avec "une énergie contagieuse et une ambiance chaleureuse et accessible"
Cette personnalisation ajoute une autre dimension à la flexibilité du modèle dans les applications réelles.
Considérations d'intégration technique
Lors de la mise en œuvre de Qwen 2.5 Omni 7B, plusieurs détails techniques doivent être pris en compte :
- Le modèle nécessite des modèles d'invite spécifiques pour la sortie audio
- Des paramètres cohérents pour les paramètres
use_audio_in_videosont nécessaires pour des conversations multi-tours appropriées - La compatibilité des URL vidéo dépend de versions spécifiques de la bibliothèque (torchvision ≥ 0.19.0 pour la prise en charge HTTPS)
- Le modèle n'est actuellement pas disponible via l'API Hugging Face Inference en raison de limitations dans la prise en charge des modèles "any-to-any"
L'avenir de l'IA multimodale
Qwen 2.5 Omni 7B représente plus qu'un simple autre modèle d'IA, c'est un aperçu de l'avenir de l'intelligence artificielle. En réunissant plusieurs modalités sensorielles dans une architecture unifiée de bout en bout, il nous rapproche des systèmes d'IA qui peuvent percevoir et interagir avec le monde plus comme le font les humains.
L'intégration de TMRoPE pour l'alignement temporel résout un défi fondamental du traitement multimodal, tandis que l'architecture Thinker-Talker fournit un cadre pour combiner efficacement diverses entrées et générer des sorties appropriées. Ses solides performances sur les références démontrent que les modèles multimodaux unifiés peuvent rivaliser avec et parfois surpasser les modèles spécialisés à modalité unique.
À mesure que les ressources informatiques deviennent plus accessibles et que les techniques de déploiement de modèles efficaces s'améliorent, nous pouvons nous attendre à une adoption plus large d'une IA véritablement multimodale comme Qwen 2.5 Omni 7B. Les applications couvrent pratiquement tous les secteurs, de la santé et de l'éducation au divertissement et au service client.
Conclusion
Qwen 2.5 Omni 7B est une réalisation remarquable dans l'évolution de l'IA multimodale. Ses capacités "Omni" complètes, son architecture innovante et ses performances intermodales impressionnantes en font un exemple de premier plan de la prochaine génération de systèmes d'intelligence artificielle.
En combinant la capacité de voir, d'entendre, de lire et de parler dans un seul modèle unifié, Qwen 2.5 Omni 7B brise les barrières traditionnelles entre les différentes capacités de l'IA. Il représente une étape importante vers la création de systèmes d'IA capables d'interagir avec les humains et de comprendre le monde d'une manière plus naturelle et intuitive.
Bien qu'il y ait des limites pratiques à prendre en compte, en particulier en ce qui concerne les exigences matérielles, les réalisations du modèle pointent vers un avenir passionnant où l'IA peut traiter et répondre de manière transparente au monde riche et multimodal que nous habitons. À mesure que ces technologies continuent d'évoluer et de devenir plus accessibles, nous pouvons nous attendre à ce qu'elles transforment la façon dont nous interagissons avec la technologie dans d'innombrables applications et domaines.
Qwen 2.5 Omni 7B n'est pas seulement une réussite technologique, c'est un aperçu d'un avenir où les frontières entre les différentes formes de communication commencent à se dissoudre, créant des moyens plus naturels et intuitifs pour les humains et l'IA d'interagir.
```


