
Le 20 août 2026, un modèle nommé ox-alpha est apparu sur des plateformes d'inférence tierces. Aucun fournisseur, aucune annonce, aucune fiche de modèle. Il disposait d'une fenêtre de contexte d'un million de tokens et son utilisation était gratuite.
En quelques jours, il est devenu l'un des modèles les plus utilisés sur ces plateformes. En environ 48 heures, la communauté l'avait identifié comme un modèle Zhipu. Le 26 août, Z.ai l'a confirmé : Ox Alpha était GLM-5.3-Flash, et la semaine gratuite avait été un test délibéré.
Ceci est désormais une étape standard de lancement de produit plutôt qu'une curiosité. Voici comment ce schéma fonctionne, comment les gens l'ont identifié, et ce que cela signifie si vous êtes un consommateur de ces modèles.
La chronologie
20 août. ox-alpha apparaît sur OpenRouter et OpenCode en tant que modèle anonyme. Contexte de 1M, prix zéro. Les modèles anonymes ne sont pas inhabituels sur ces plateformes, mais la combinaison d'une très grande fenêtre de contexte et d'un accès gratuit est un signal fort que quelqu'un subventionne quelque chose.
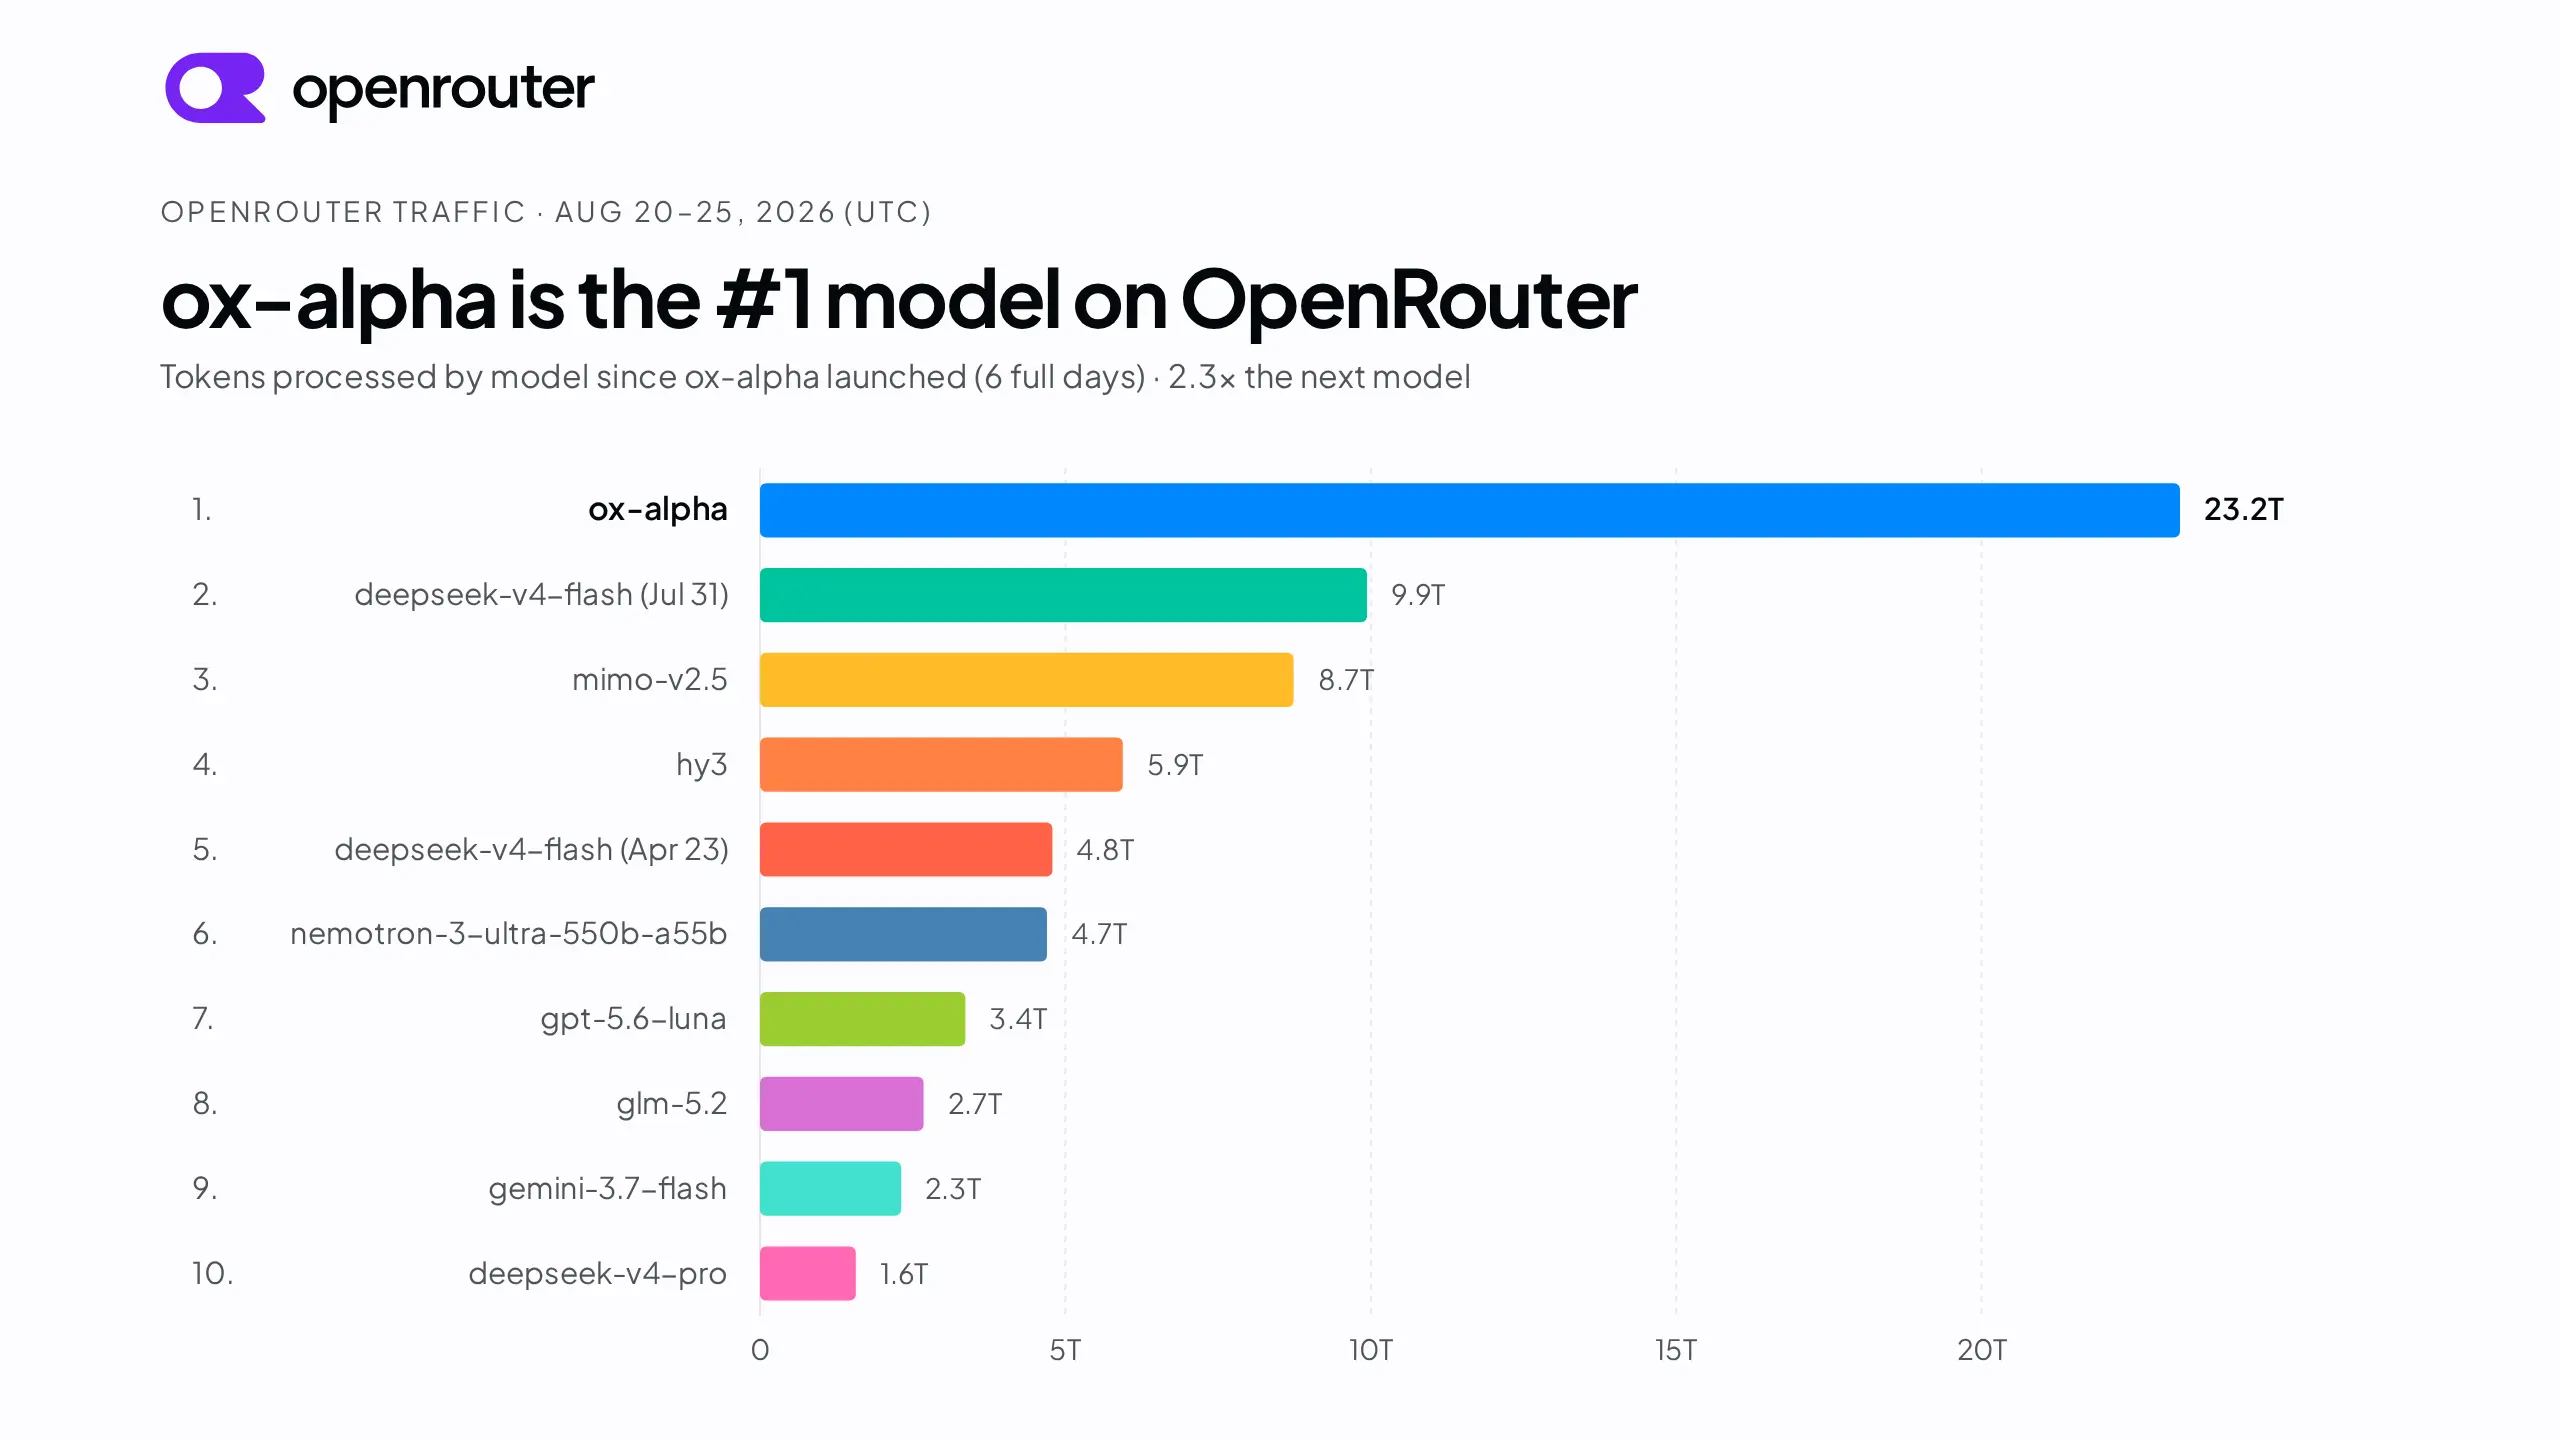
Du 20 au 22 août. L'utilisation augmente rapidement. L'accès gratuit à un modèle performant à long contexte est un argument de vente facile, et la communauté des développeurs l'utilise pour des tâches réelles. Pendant ce temps, les gens commencent à l'examiner pour découvrir son origine.
Environ 48 heures plus tard. Le consensus s'est porté sur Zhipu, basé sur les caractéristiques de sortie plutôt que sur une quelconque divulgation.
26 août. Z.ai annonce GLM-5.3-Flash et confirme qu'il s'agissait bien d'Ox Alpha. L'entreprise décrit la semaine gratuite comme un test intentionnel.
Comment identifier un modèle anonyme
Rien de tout cela ne nécessite un accès spécial. Il s'agit de faire correspondre des modèles de comportement que les familles de modèles portent en elles.
Comportement du tokenizer. Différentes familles divisent le texte différemment. Alimentez un modèle avec des chaînes inhabituelles, des séquences d'emojis, des scripts mélangés, de longues séquences d'espaces blancs, du code avec une indentation inhabituelle, et observez où il trébuche ou comment les comptes de tokens se présentent. Les tokenizers sont hérités des versions d'une famille et sont difficiles à dissimuler.
Auto-déclarations sous pression. Les modèles sont entraînés sur des données qui incluent des descriptions d'eux-mêmes. Les questions directes obtiennent des réponses évasives ou incorrectes, mais une incitation oblique révèle souvent des traces de données d'entraînement : des phrasés caractéristiques, une date limite de connaissance, un style maison pour les refus.
Style de refus et de formatage. La manière dont un modèle refuse, comment il structure une liste, s'il s'ouvre par un préambule, s'il utilise des conventions de section particulières. Ceux-ci découlent de la post-formation et ont tendance à être cohérents au sein d'un laboratoire.
Comportement multilingue. Un modèle fortement entraîné sur des données chinoises et anglaises se comporte différemment sur des invites en chinois qu'un modèle qui a traité le chinois comme une langue à longue traîne. Pour un modèle Zhipu, c'est un indice fort.
Profil de benchmark. Exécutez une batterie d'évaluation rapide et comparez le profil des forces et des faiblesses aux modèles connus. Les scores absolus importent moins que la forme : quelles catégories sont fortes par rapport à d'autres.
Caractéristiques de service. Les schémas de latence, le débit, les limites de contexte et les paramètres acceptés par le point de terminaison divulguent tous des informations sur la pile technologique sous-jacente.
Nous avons vu le même processus se dérouler lorsque Pony Alpha s'est avéré être un modèle DeepSeek ou GLM. La méthodologie se généralise.
Pourquoi les fournisseurs agissent-ils ainsi
Un lancement furtif permet d'obtenir des choses qu'une bêta fermée ne peut pas.
Trafic réel à échelle réelle. Les évaluations internes et les testeurs bienveillants produisent une vision limitée de ce que les gens font réellement. Une semaine de trafic public ouvert fait émerger la "longue traîne" : les invites étranges, les abusives, les contextes énormes, les boucles d'appel d'outils pour lesquelles personne n'avait conçu.
Tests de charge honnêtes. Vous apprenez ce que votre pile de service fait sous une véritable concurrence. Z.ai affirme avoir fait fonctionner Ox Alpha pendant une semaine entièrement sur des accélérateurs chinois nationaux en utilisant une pile basée sur SGLang, et revendique un coût de service par token comparable au matériel NVIDIA grand public. Il s'agit d'une affirmation du fournisseur concernant sa propre infrastructure sans vérification indépendante, mais c'est une affirmation que l'on ne peut faire de manière crédible qu'après avoir servi un trafic réel.
Réception sans marque. La réaction des gens à "un bon modèle anonyme" est différente de leur réaction à un modèle avec un logo. L'anonymat élimine les préjugés de marque dans les deux sens.
Marketing gratuit lors de la révélation. Le jour de l'annonce, une population de développeurs avait déjà utilisé le modèle et s'était forgé des opinions positives. C'est plus persuasif que n'importe quel tableau de benchmark.
Le coût est le risque de réputation. Les utilisateurs qui ont construit quelque chose pendant une semaine gratuite découvrent que leur dépendance a maintenant un prix. Dans ce cas, la révélation s'est accompagnée d'une réduction de lancement de 50 % valable jusqu'au 9 septembre 2026, ce qui adoucit l'atterrissage.
Ce qui se cachait réellement derrière le rideau
GLM-5.3-Flash est un modèle de mélange d'experts de 320 milliards de paramètres avec 18 milliards actifs par token, publié sous la licence MIT avec les poids sur Hugging Face. Il utilise une attention hybride linéaire et sparse, gère 1 048 576 tokens de contexte et est le premier modèle nativement multimodal de la série GLM-5.
Des mesures indépendantes d'Artificial Analysis le placent à 57 sur l'Intelligence Index, contre 60 pour le plus grand GLM-5.3 et une médiane de 27 pour les modèles open-weight de taille similaire.
Le tableau complet est dans notre explication de GLM-5.3-Flash.
Un détail explique la semaine gratuite mieux que toute théorie marketing : Z.ai rapporte que le modèle utilise environ trois fois moins de calcul d'attention que GLM-5.3 et un cache KV environ 4,4 fois plus petit. Offrir un modèle si peu coûteux à servir est un pari bien moins risqué que d'offrir un fleuron de pointe. L'économie du coup publicitaire était intégrée à l'architecture.
Ce que cela signifie pour vous
Les modèles anonymes sur les routeurs sont généralement des flagships non encore publiés. Un modèle sans marque avec une fenêtre de contexte inhabituellement grande et sans prix n'est pas un projet de loisir. Quelqu'un paie pour cette inférence.
L'accès gratuit est temporaire par conception. Si vous développez pendant une période gratuite, attendez-vous à ce que le prix arrive. Ox Alpha est passé de gratuit à 0,15 $ par million de tokens d'entrée en six jours, ce qui est bon marché mais n'est pas nul.
Ne mettez pas de modèles furtifs en production. Pas de fiche de modèle, pas de garantie de versioning, pas d'avis de dépréciation, pas de support. Le modèle peut changer sous vos pieds ou disparaître. L'évaluer, c'est bien. En dépendre, non.
Votre évaluation vaut plus que la révélation. Au moment où l'annonce est faite, vous disposez peut-être déjà d'une semaine de données réelles sur la manière dont le modèle gère votre charge de travail. Cela surpasse n'importe quel tableau de benchmark publié par le fournisseur.
Ce dernier point n'est valable que si vous avez réellement capturé les données. Les prompts ad hoc pendant une semaine gratuite produisent des impressions ; une suite enregistrée produit des preuves. Garder vos prompts d'évaluation sous forme de collection dans Apidog, avec l'ID du modèle et l'URL de base comme variables d'environnement, signifie que la prochaine fois qu'un modèle anonyme intéressant apparaît, vous pouvez pointer la même suite vers lui et obtenir une comparaison au lieu d'une simple impression. Quand il est révélé et tarifé, vous savez déjà s'il vaut la peine d'être payé.
Ce que la semaine gratuite a réellement révélé
En faisant abstraction du marketing, l'épisode Ox Alpha a produit trois signaux réellement utiles.
Le modèle est peu coûteux à servir, et c'est architectural. Environ trois fois moins de calcul d'attention et un cache KV environ 4,4 fois plus petit que GLM-5.3 n'est pas une décision de prix, c'est une décision de conception. Cela rend le prix catalogue bas plus susceptible de persister qu'un tarif promotionnel. Notre analyse des prix explique ce que cela signifie en pratique.
Les poids ouverts ont suivi le lancement hébergé. Le modèle a été mis en ligne sur Hugging Face sous licence MIT, de sorte que la semaine d'accès hébergé gratuit n'était pas le seul moyen de l'utiliser gratuitement. Quiconque disposant du matériel peut l'exécuter indéfiniment. L'exécuter localement couvre ce que cela implique.
La multimodalité était la partie que personne ne savait tester. Pendant la semaine anonyme, la plupart des gens ont utilisé Ox Alpha comme modèle de texte, car il n'y avait pas de fiche de modèle indiquant qu'il acceptait les images. Une capacité qui s'est avérée être la caractéristique principale est restée largement inexploitée par la population même qui était censée la tester en situation de stress. C'est la faiblesse structurelle d'un lancement sans marque : vous obtenez du volume, mais ce volume est orienté vers ce que les gens supposent que le modèle fait. Notre guide de vision couvre le chemin qui n'a pas été testé.
Le schéma plus large
Ox Alpha n'était pas le premier et ne sera pas le dernier. Le déploiement furtif sur des routeurs tiers est devenu une étape normale de pré-lancement, se situant entre l'évaluation interne et le lancement public.
Pour les consommateurs de ces modèles, l'approche pratique est simple. Testez-les, apprenez d'eux, conservez des enregistrements de ce que vous trouvez, et ne construisez rien de crucial sur un modèle sans nom. La semaine gratuite est une opportunité de recherche, pas une chaîne d'approvisionnement.
FAQ
Qu'était ox-alpha ? GLM-5.3-Flash, le modèle à poids ouverts nativement multimodal 320B-A18B de Z.ai, déployé anonymement à partir du 20 août 2026 et révélé le 26 août.
Est-il toujours gratuit ? Non. La période gratuite a pris fin lors de l'annonce. Une réduction de lancement de 50 % est valable jusqu'au 9 septembre 2026, après quoi le prix catalogue de 0,15 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie s'appliquera.
Comment les gens ont-ils découvert que c'était Zhipu ? Le comportement du tokenizer, le style de sortie, la gestion multilingue, les schémas de refus et le profil de benchmark, comparés aux versions connues de GLM. Aucune information interne n'a été requise.
Pourquoi offrir un modèle gratuitement ? Pour obtenir du trafic réel à grande échelle, des tests de charge honnêtes, des retours non biaisés par la marque, et une base d'opinions positives le jour du lancement.
Dois-je utiliser des modèles anonymes sur OpenRouter ? Pour l'évaluation, oui. Pour la production, non. Ils n'offrent aucune garantie de versioning, de support ou de dépréciation.