
Jev est le Modèle Système Un de TypeSafe AI : vous lui envoyez l'état du programme plus des questions typées, et il retourne des décisions avec des probabilités calibrées au lieu de prose. (Il s'agit de Jev le modèle, pas de FaZe Jev le streamer ou du vaccin JEV.) Ses poids sont fermés, il est disponible uniquement via API, servi à `POST https://api.typesafe.ai/v1/systemone` sous le nom `jev-latest`. Ainsi, « exécuter Jev localement » ne peut pas signifier Jev. Cela signifie un ensemble de projets communautaires datant de quelques jours, menés par OpenJev, qui reproduisent l'idée avec des modèles ouverts. Si vous êtes nouveau sur le modèle lui-même, lisez d'abord ce qu'est Jev ; cet article couvre les imitations.
C'est un tour d'horizon et une vérification de la réalité : ce que chaque README prétend, sa fidélité, le matériel qu'il requiert et comment les tester via un point de terminaison HTTP local dans Apidog, de la même manière que vous testeriez l'API TypeSafe. Aucun n'est évalué par un tiers, et aucun ne provient de TypeSafe.
Ce que « exécuter Jev localement » peut signifier
L'article de lancement de TypeSafe décrit un modèle entraîné avec l'apprentissage par renforcement pour les décisions calibrées (RLCD), trois primitives (noul, choice, score), un temps de réponse de 70 ms à 500 ms, et 0,042 $ par million de jetons d'entrée avec sortie gratuite. Ce sont des affirmations du fournisseur ; la recette d'entraînement n'est pas publiée. Un fil de discussion communautaire indique que Jev a été entraîné sur 100 % de données synthétiques. Considérez cela comme une rumeur non vérifiée.
Parce que la recette est secrète, chaque « Jev ouvert » prend l'un des trois raccourcis suivants :
- Lire les logits d'un modèle de chat gelé. Posez une question à choix multiples à un petit Qwen, ignorez la génération et transformez les logits du jeton suivant par option en une probabilité. OpenJev et mini-jev le font.
- Entraîner un petit scoreur à partir de zéro. Un modèle dont le seul travail est de noter N options par rapport à un contexte en un seul passage. C'est ce que fait jevlike.
- Changer le moteur de décodage. Gardez le modèle de base, évaluez chaque champ en parallèle sur des candidats contraints. C'est le moteur Apple Silicon sur Hugging Face et la pull request vLLM.
Aucun d'entre eux ne reproduit le RLCD. C'est la vérité honnête.
OpenJev : logits d'un Qwen gelé sur une 3090
OpenJev demande : « Pouvons-nous exécuter quelque chose comme Jev sur une 3090 à la maison ? » et répond avec un package Python sous licence MIT. Le README est prudent : il « reproduit ce modèle d'interface avec des modèles ouverts ; il ne reproduit pas le modèle ou l'entraînement non divulgué de Jev. »
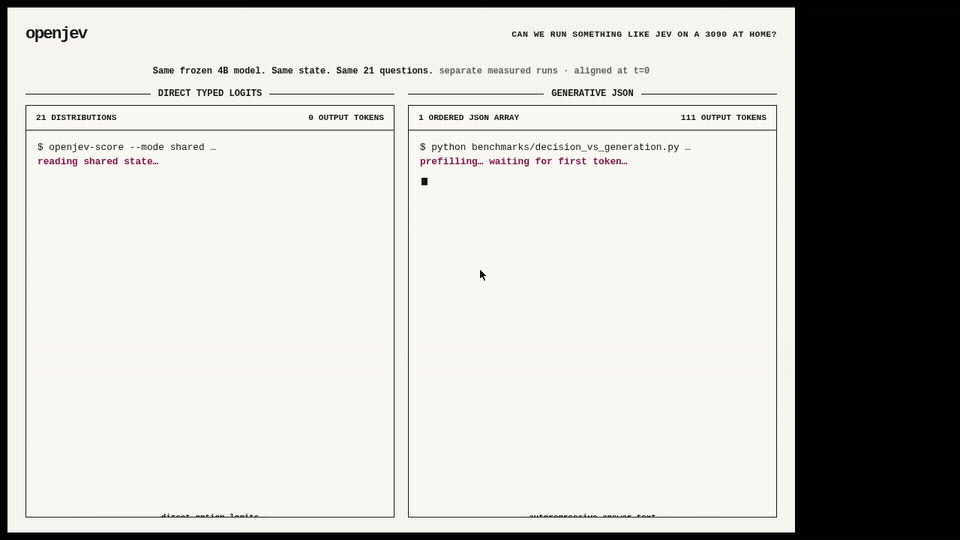
Le mécanisme est un passage avant unique qui lit les logits d'option déclarés, sans échantillonnage de jeton de réponse. Les critères et les options arrivent avec chaque requête, de sorte que rien n'est affiné par tâche. Le modèle principal est Qwen3.5-4B.
Chiffres rapportés par le README sur une RTX 3090 avec Qwen3.5-4B :
- Logits typés directs : 1,023 s pour 21 paires de probabilités, contre 5,332 s pour un tableau JSON autorégressif, soit 5,21x plus lent.
- Sur un sous-ensemble TypeSafe de 102 lignes, un accord modal de 0,845, contre 0,883 pour Jev publié.
L'entrée est au format JSONL avec `id`, `state`, `question`, et un tableau `options` de `{id, description}` ; la sortie est une probabilité par option. Il n'y a pas de serveur HTTP dans le dépôt : vous exécutez `openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl`, ou essayez la démo WebGPU sur openjev.com. Matériel : CUDA et un GPU contenant un modèle 4B en BF16.
Ce qu'il omet : pas de primitive noul ou score, et les probabilités sont une softmax sur les logits d'option, et non une confiance calibrée RLCD.
mini-jev : une étude préenregistrée avec un serveur local
mini-jev est une expérience plus qu'un produit. Son slogan : « À quoi ressemble une interface de style Jev sur un Qwen3-4B gelé, lisant les logits de la lettre d'option au lieu de générer du JSON. » Il exécute Qwen3-4B-Instruct-2507 sur la classification d'intention CLINC150 et compare la génération JSON contrainte par la grammaire à la lecture du logit d'une lettre d'option.
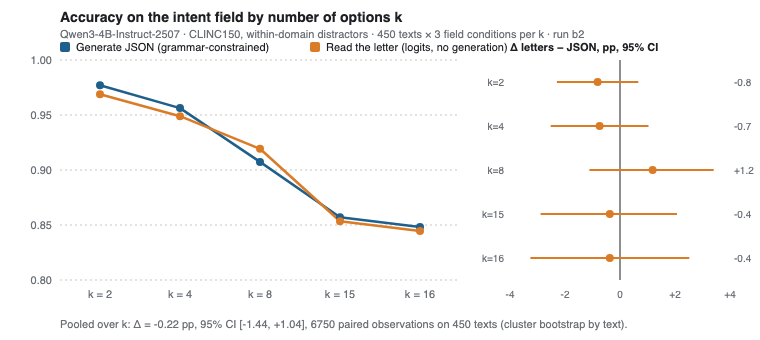
Le résultat, à partir de 6 750 observations appariées : précision JSON 0,909, lettres 0,907, une différence de -0,22 points dans un intervalle de confiance de 95 % de [-1,44, +1,04]. La lecture des lettres était environ 4 fois plus rapide sur des textes de 32 jetons.
Le README met en correspondance ses termes avec ceux de TypeSafe : "choice" et "noul" sont « ce que cette étude mesure sur un modèle gelé, comme la lettre lue et le booléen ; "score" (une échelle ordonnée) n'a pas été mesuré. » Il appelle cela « une correspondance de termes, pas une reproduction de leur modèle », et ajoute la mise en garde que chaque projet ici devrait copier : « Les partages de lettres sont un classement avec un écart de confiance, pas des probabilités calibrées. »
Il fournit une démo HTTP. `MINIJEV_DEVICE=mps uv run python demo/server.py` sert `127.0.0.1:8765` avec `POST /run`, qui prend `schema` et `text` et retourne `letter`, `p`, `gap`, et `answer` par champ. Il nécessite environ 8,5 Go de mémoire sur Apple Silicon ou un GPU NVIDIA. MIT, 11 étoiles au moment de la rédaction.
jevlike : un scoreur d'options à partir de zéro
jevlike est partagé comme un « modèle similaire à Jev, rétro-ingénieré ». Le README dit le contraire : « TypeSafe n'a pas publié sa conception. Ce dépôt est un modèle de démarrage indépendant avec la même forme d'entrée et de sortie. » Les auteurs ajoutent qu'ils « n'ont pas montré une qualité égale à celle de Jev ni reproduit la méthode d'entraînement privée de TypeSafe. »
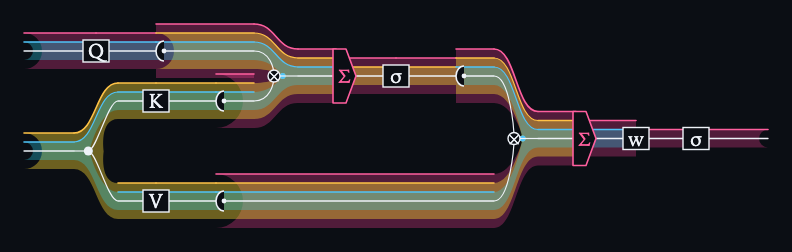
La conception est petite. Chaque option reçoit un vecteur de requête qui s'applique sur les jetons de contexte ; un produit scalaire partagé note chaque paire ; la softmax transforme les scores en probabilités. L'encodeur par défaut est des embeddings d'octets appris à partir de zéro, avec un encodeur Hugging Face gelé optionnel.
Chiffres rapportés : environ 98 % sur les menus synthétiques, 26 % sur Wikispeedia avec un encodeur Qwen2.5-0.5B gelé contre un contrôle aléatoire de 8 %, et un seul passage « environ 100 fois plus rapide qu'un petit décodeur forcé d'écrire 400 jetons ». Il fonctionne sur CPU, MPS ou CUDA. MIT, 764 étoiles.
La fidélité est la plus faible du groupe. Vous l'entraînez sur vos propres étiquettes, c'est donc un classifieur que vous avez construit, pas un modèle de décision auquel vous pouvez confier des critères arbitraires. Pas de noul ou de score, pas de revendication de calibration, pas de serveur HTTP.
Décodage contraint parallèle : le moteur Apple Silicon
Le Hugging Face Space parallel-constrained-decoding circule comme une « alternative open source Jev de Typesafe.ai », mais son README ne mentionne jamais Jev, TypeSafe ou RLCD. Son titre est « Décodage contraint parallèle pour Apple Silicon » : un moteur d'inférence MLX pour l'extraction structurée sur `mlx-community/Qwen2.5-1.5B-Instruct-4bit`, avec n'importe quel décodeur `mlx-lm` interchangeable.
La méthode : pré-remplir le contexte une seule fois dans un cache KV, le diffuser sur chaque champ de schéma, évaluer uniquement les ID de jetons candidats valides par champ, appliquer une softmax sur cet ensemble, et assembler le JSON dans le code. Le README rapporte sur un M4 Max : triage de fraude à 4 champs 420 ms autorégressif contre 75 ms parallèle (5,6x), et triage de support à 28 champs 1 900 ms contre 270 ms (7,0x). Il revendique une validité de schéma de 100 %, ce qui découle du fait de ne jamais échantillonner de texte libre.
Il sert du HTTP sur le port 8000 via uvicorn, retournant `parsed_json` plus `field_telemetry` avec la confiance par champ. Exigences : un Mac M1 ou ultérieur, macOS 14+. Apache 2.0. Pas de chiffres de précision, seulement la latence, et « calibré » signifie ici une softmax exacte sur les candidats, pas une calibration entraînée.
PR vLLM 57250 : un mode Jev-like pour DiffusionGemma
La demande de tirage (pull request) vLLM #57250, ouverte le 16 septembre et toujours ouverte, transforme DiffusionGemma en ce que l'auteur appelle une « machine à choix multiples calibrée » : un canevas amorcé avec des emplacements de réponse à un seul jeton, lu à une limite d'étapes, avec une confiance dérivée des logprobs et de l'entropie. Les nouveaux champs `vllm_xargs` incluent `diffusion_seed_canvas`, `diffusion_max_steps`, et `diffusion_read_only`, et un exemple `structured_server.py` traduit un schéma en un canevas.
La PR rapporte 8,7 requêtes par seconde sur des lectures de canevas uniques, 54 à une concurrence de 32 voies, et environ 90 % de précision sur un corpus de classification linguistique. Un relecteur a signalé un test de condition de concurrence manquant et une création de threads illimitée comme bloquants. Tant qu'elle n'est pas fusionnée, c'est une conception à lire, pas à déployer.
Quelle est la fidélité de chacun ?
| Projet | Base | Primitives | Calibration | Serveur HTTP | Matériel |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, gelé | choix | softmax sur les logits d'option | Non (CLI + démo navigateur) | Classe RTX 3090, CUDA |
| mini-jev | Qwen3-4B-Instruct, gelé | choix, noul | classement avec un écart | Oui, port 8765 | 8,5 Go de mémoire, MPS ou CUDA |
| jevlike | encodeur que vous entraînez | choix | aucune revendication | Non | CPU, MPS ou CUDA |
| Moteur MLX | Qwen2.5-1.5B-Instruct-4bit | champs de schéma | softmax sur les candidats | Oui, port 8000 | Apple Silicon, macOS 14+ |
| PR vLLM | DiffusionGemma | oui/non, choix, échelle | logprobs plus entropie | Oui, compatible OpenAI | GPU de classe vLLM, non fusionné |
Chaque ligne représente un modèle gelé ou auto-entraîné lisant les logits. Cela vous donne la forme de Jev : réponses typées, une probabilité par option, un seul passage avant. Cela ne vous donne pas l'affirmation centrale de Jev, selon laquelle le RLCD rend ces probabilités honnêtes. Le 0,845 d'OpenJev contre 0,883 est la seule comparaison avec le modèle réel, et c'est l'évaluation propre à l'auteur. La configuration correspond à notre guide pour exécuter Kimi K3 localement : poids, un GPU ou un Mac de série M, un port local.
Testez-les dans Apidog comme la véritable API Jev
L'intérêt d'une reproduction locale est de la substituer à la véritable API sans réécrire votre intégration, vos tests devraient donc envoyer le même corps aux deux. Aucun de ces projets ne gère nativement le schéma de Jev `{model, state, questions}`. Placez un adaptateur léger devant celui que vous utilisez : une application FastAPI de 40 lignes qui accepte le corps de Jev, appelle l'outil et renvoie `{"answers": {...}}` avec les clés `choice`, `probabilities` et `confidence`. Maintenant, Apidog voit un seul contrat.
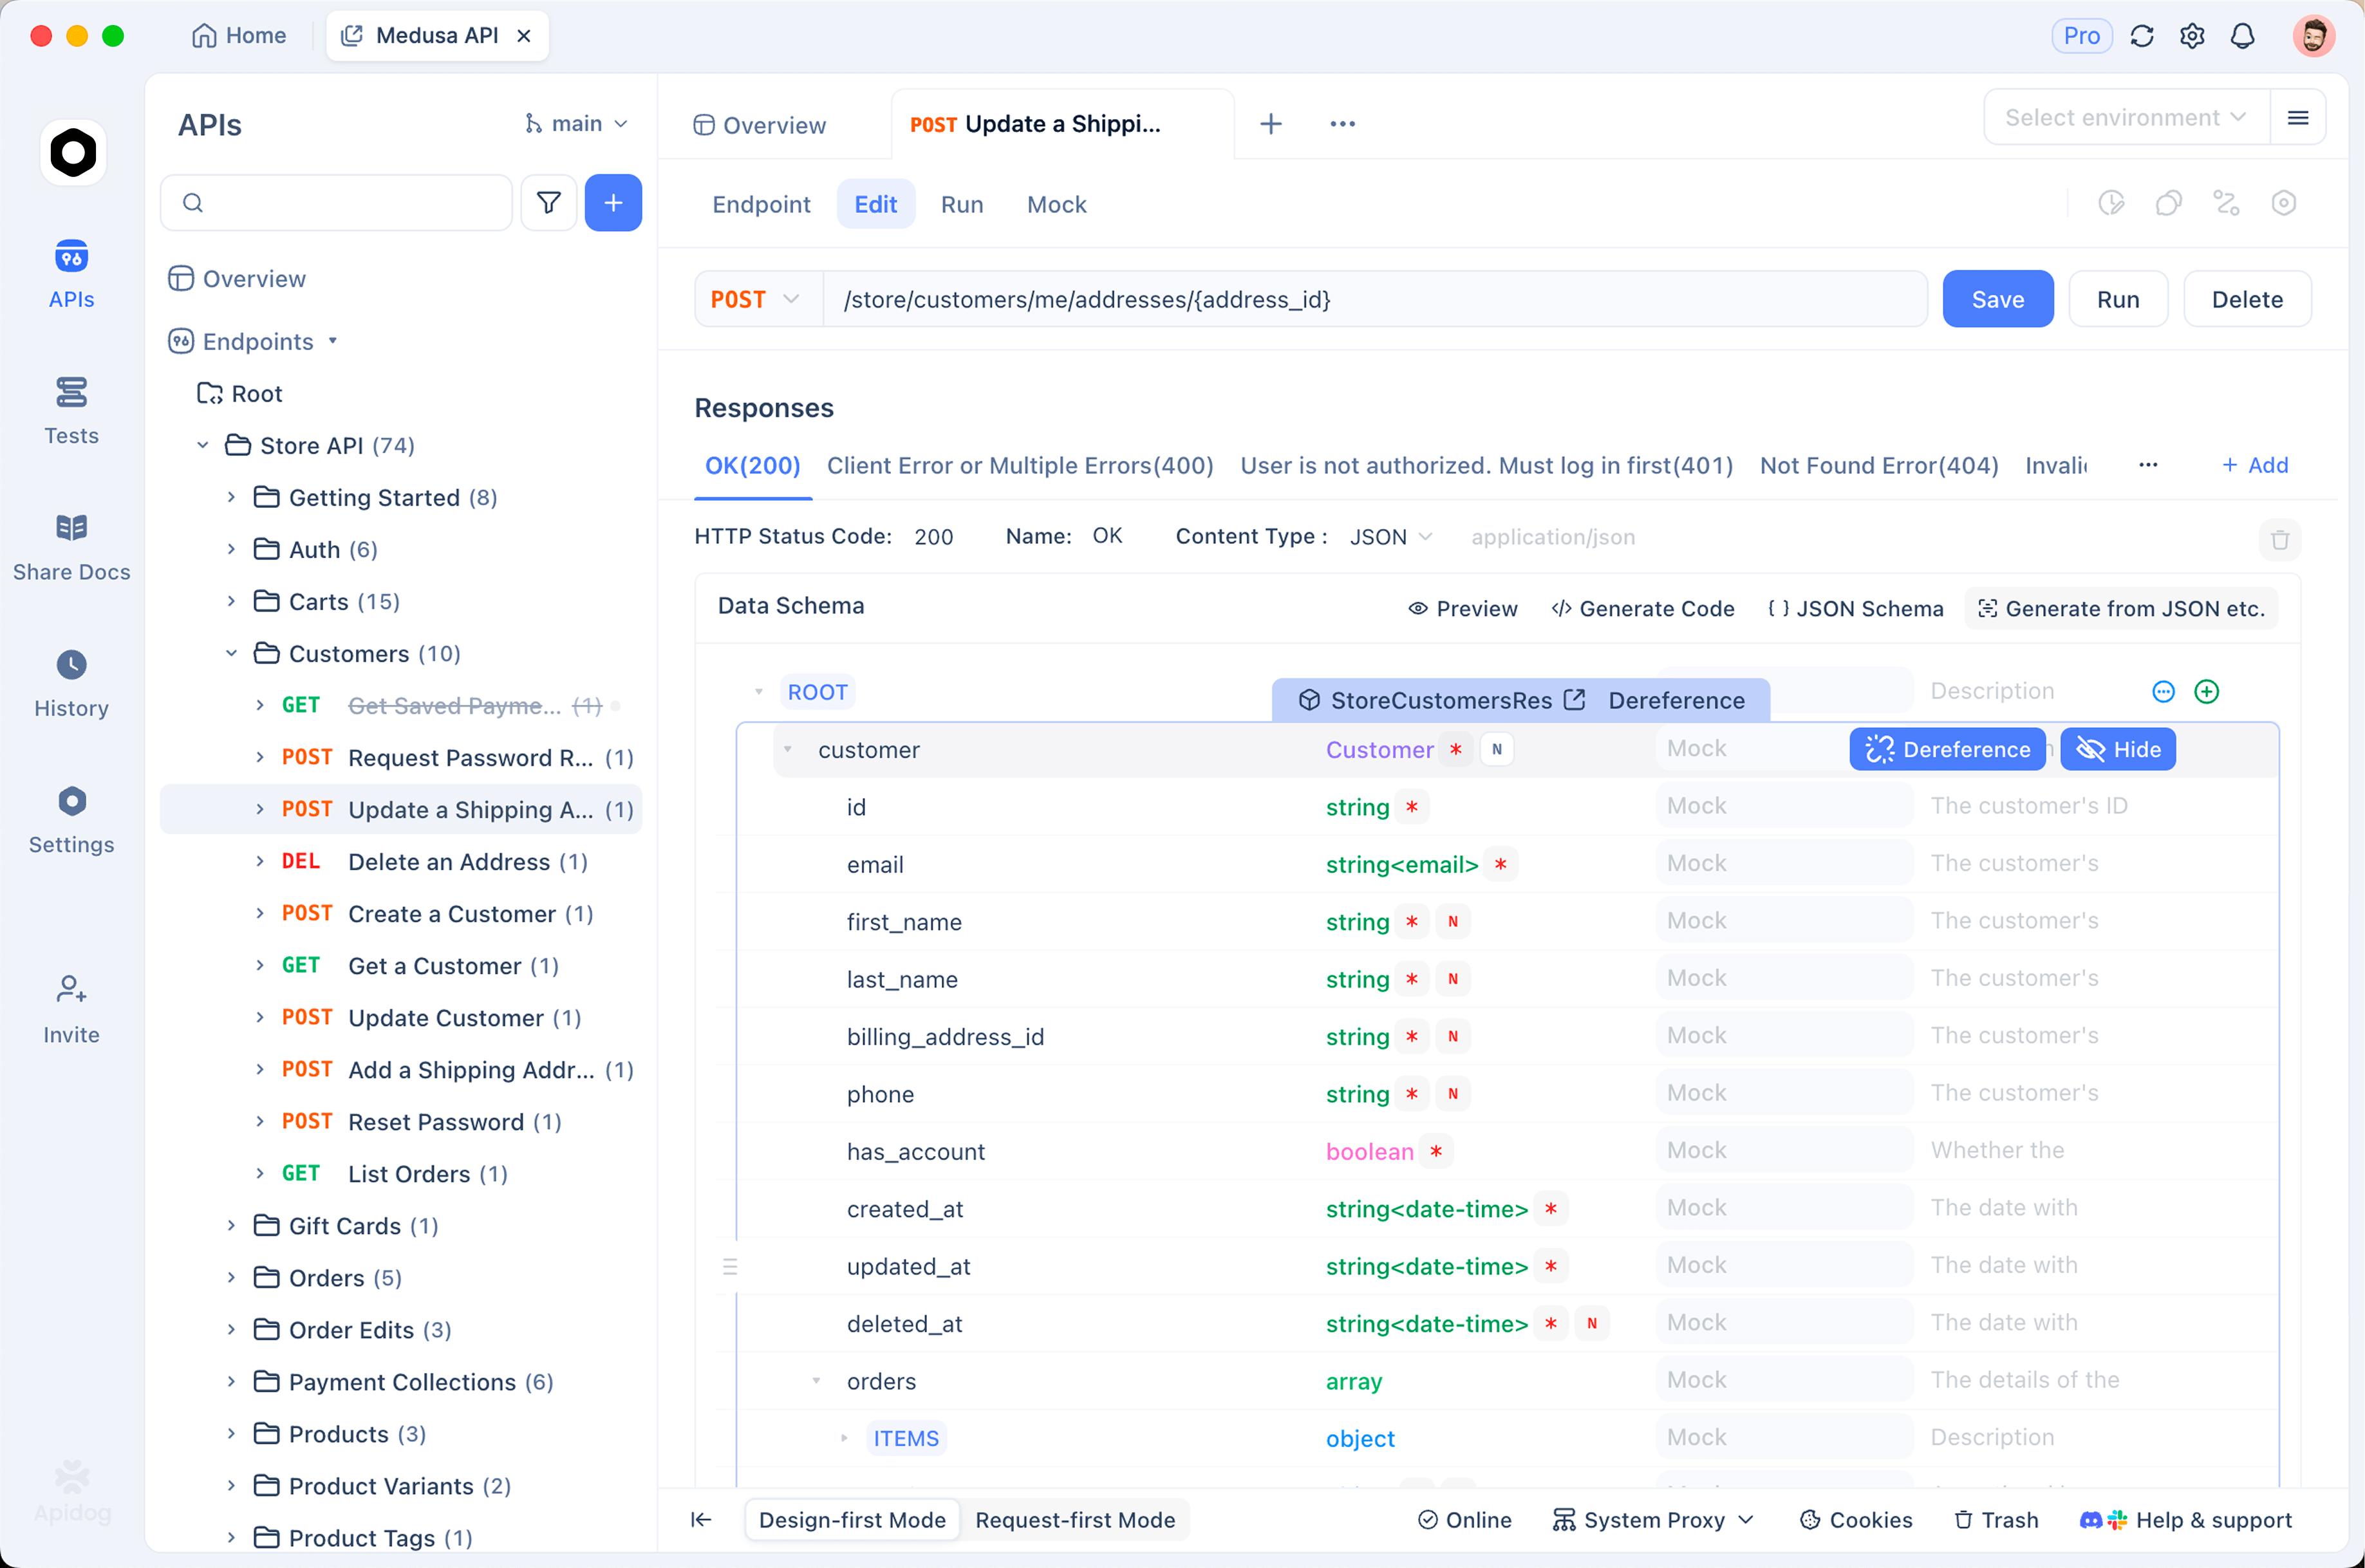
Deux environnements, un seul ensemble de requêtes. Créez `Local reproduction` avec `BASE_URL = http://localhost:8765` et sans clé, et `TypeSafe API` avec `BASE_URL = https://api.typesafe.ai` plus `TYPESAFE_API_KEY` dans le champ local afin qu'il ne se synchronise jamais avec les coéquipiers (règles de portée ici). Chaque requête utilise `{{BASE_URL}}/v1/systemone` et Bearer `{{TYPESAFE_API_KEY}}` ; le serveur local ignore l'en-tête.
Envoyez le corps de Jev. `POST {{BASE_URL}}/v1/systemone` avec l'état et les questions que vous enverriez à `jev-latest` :
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
Affirmez sur les champs de probabilité. Ajoutez des assertions post-traitement : `answers.department.choice` est égal à `billing` ; `answers.department.probabilities.billing` est supérieur à `0.7` ; `answers.wants_refund.noul` est supérieur à `0.8`. Basculez le menu déroulant de l'environnement et exécutez le même scénario contre TypeSafe. L'écart entre les deux exécutions est votre indice de fidélité, qui vaut plus que n'importe quel tableau du README.
Enregistrez l'exécution locale comme un mock afin que le frontend se construise sur un objet `answers` stable avec un temps GPU nul. Téléchargez Apidog pour le configurer ; le plan gratuit couvre quatre utilisateurs. Le même modèle pour les modèles de chat se trouve dans le test des LLM locaux en tant qu'API.
FAQ
OpenJev est-il identique à Jev ?
Non. OpenJev lit les logits d'option d'un Qwen3.5-4B gelé et le mentionne dans son README. Jev est un modèle fermé TypeSafe entraîné avec RLCD. OpenJev rapporte un accord modal de 0,845 avec Jev sur un sous-ensemble de 102 lignes, selon l'évaluation de son propre auteur.
Lequel devrais-je essayer en premier ?
mini-jev si vous êtes sur un Mac et souhaitez un point de terminaison HTTP dès aujourd'hui ; OpenJev si vous avez un GPU NVIDIA et souhaitez la comparaison publiée la plus proche de Jev. Ne choisissez jevlike que si vous avez des données étiquetées pour l'entraînement.
Puis-je obtenir des probabilités calibrées à partir d'un modèle gelé ?
Pas en lisant les logits seuls. Une softmax sur les jetons d'option est un classement avec un écart, comme le dit le README de mini-jev. La calibration nécessite un entraînement ou une étape post-hoc comme la mise à l'échelle de la température sur votre ensemble étiqueté, ce qu'aucun de ces projets ne fournit.
Est-il moins cher d'exécuter l'un d'eux que de payer TypeSafe ?
À 0,042 $ par million de jetons d'entrée avec une sortie gratuite, Jev se situe déjà au plus bas des fournisseurs d'API LLM les moins chers. Le local l'emporte sur la confidentialité et l'utilisation hors ligne, pas sur le coût, une fois que vous comptez le temps GPU.
Ce qu'il faut en retenir
OpenJev, mini-jev, jevlike, le moteur MLX et la PR vLLM prouvent tous une idée : une décision n'a pas besoin de texte généré, et la lecture des logits en un seul passage est plus rapide. Aucun ne prouve qu'il est calibré, et aucun n'est Jev. Exécutez-en un derrière un adaptateur de forme Jev, gardez un second environnement pointé vers TypeSafe, et laissez vos assertions décider de leur écart.