OpenAI et Anthropic ont fortement baissé les prix de leurs API depuis juillet 2026, et ces baisses figurent sur leurs propres pages de tarification. GPT-5.6 Luna a chuté de 80 % du jour au lendemain, GPT-6.1 Sol est affiché à 2 $/10 $ contre 5 $/30 $ pour GPT-5.6 Sol, Claude Opus 5.5 a réduit les lectures de cache de 60 %, et Claude Haiku 5.5 est affiché à un dixième de Haiku 4.5. Si votre modèle de coûts, vos règles de routage ou vos alertes budgétaires datent d’avant septembre, ils sont désormais faux, la plupart du temps en votre faveur. Ci-dessous : les prix avant/après vérifiés, les calculs par requête, les pièges qui gonflent encore les factures, et comment laisser votre agent de codage transformer les budgets de tokens en tests.
Le point de départ est l’essai de Max Woolf OpenAI et Anthropic ont réduit les prix de leurs LLM jusqu’à 80 % en quelques mois. Pourquoi ? et son fil Hacker News. Nous avons couvert le côté marché dans la guerre des prix des modèles d’IA de septembre 2026 ; cet article porte sur ce qu’une équipe doit changer.
Les prix avant/après vérifiés
USD par million de tokens (entrée / sortie / entrée mise en cache), niveau standard, en dessous des seuils de contexte long. Les lignes OpenAI proviennent de la page de tarification de l’API OpenAI consultée le 2026-10-26, les prix « avant » venant de copies archivées de cette page. Les lignes Anthropic proviennent de la documentation tarifaire de Claude, qui liste les anciens et les nouveaux modèles côte à côte.
| Changement de modèle | Avant | Après | Variation | Date |
|---|---|---|---|---|
| GPT-5.6 Luna (baisse de prix) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80 % sur toute la ligne | 2026-07-30 |
| GPT-5.6 Terra (baisse de prix) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20 % | 2026-07-30 |
| GPT-5.6 Sol (promotionnel) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | -20 % en entrée, -33 % en sortie | 2026-08-21 |
| GPT-5.6 Sol tarif normal vers GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | -60 % en entrée, -67 % en sortie, -80 % en cache | 2026-09-29 |
| GPT-5.6 Luna vers GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | -50 % en entrée, -58 % en sortie | 2026-09-22 |
| Claude Opus 5 vers Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | -20 % en entrée/sortie, -60 % en cache | 2026-09-22 |
| Claude Fable 5 vers Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | -75 % en cache uniquement | sept. 2026 |
| Claude Sonnet 5 vers Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | -50 % en cache uniquement | sept.-oct. 2026 |
| Claude Haiku 4.5 vers Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90 % (invites jusqu’à 100K) | oct. 2026 |
Seules les lignes GPT-5.6 correspondent à des baisses sur le même modèle ; les autres sont des successeurs moins chers, donc la qualité et le nombre de tokens diffèrent. Le prix de lancement de 2 $/10 $ de Sonnet 5 est devenu permanent, et la documentation indique que le passage prévu à 3 $/15 $ « n’aura pas lieu ». La remise sur GPT-5.6 Sol est promotionnelle, « disponible au moins jusqu’au 21 novembre 2026 ». Les prix de Luna et Terra avant la baisse se trouvent sur la page de tarification OpenAI archivée du 29 juillet.
Détails par modèle : la baisse de prix de GPT-5.6, la tarification de GPT-6 Sol, la tarification de Claude Haiku 5.5.
Pourquoi les prix ont baissé
La seule raison donnée par l’un des deux acteurs vient d’Anthropic : l’annonce de Claude Opus 5.5 indique que le modèle « nécessite moins de calcul pour être servi qu’Opus 5, et sa tarification le reflète », et estime un coût inférieur de 40 % sur les charges de travail typiques. Les pages d’OpenAI ne donnent aucune raison. Le reste relève de l’opinion :
- Concurrence, faibles coûts de changement. Woolf soutient que les modèles sont désormais des substituts proches : changer revient à basculer un réglage dans un harnais ou à passer une nouvelle chaîne de modèle via un routeur. Les modèles à poids ouverts servis par de nombreux fournisseurs (il en a compté 29 pour une variante de DeepSeek Flash sur OpenRouter le 24 octobre) fixent le plancher.
- Riposte réciproque. Les baisses alternent entre les deux entreprises, et les deux ont lancé des modèles phares moins chers le 22 septembre.
- Calendrier d’introduction en bourse. Woolf note que les deux seraient sur le point d’entrer en bourse et trouve le calendrier étrange. C’est une spéculation sur les motivations.
- Efficacité. De nombreux commentateurs sur HN donnent une explication plus simple : un meilleur cache, des modèles plus petits, un service moins cher.
Woolf cite aussi les données de Vercel AI Gateway : le coût par token est tombé à 43,3 % de son niveau d’avril 2026 tandis que les dépenses globales augmentaient. Des tokens moins chers réduisent rarement une facture, sauf si vous changez votre façon de les dépenser.
Ce que les baisses changent : calculs détaillés par requête
Un tour d’agent à forte utilisation de cache
Prenons un tour d’un agent de codage : 100 000 tokens de conversation lus depuis le cache, 2 000 nouveaux tokens d’entrée, 1 000 tokens de sortie.
| Modèle | Lectures de cache | Nouvelle entrée | Sortie | Coût du tour |
|---|---|---|---|---|
| GPT-5.6 Sol (tarif normal) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (promo) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
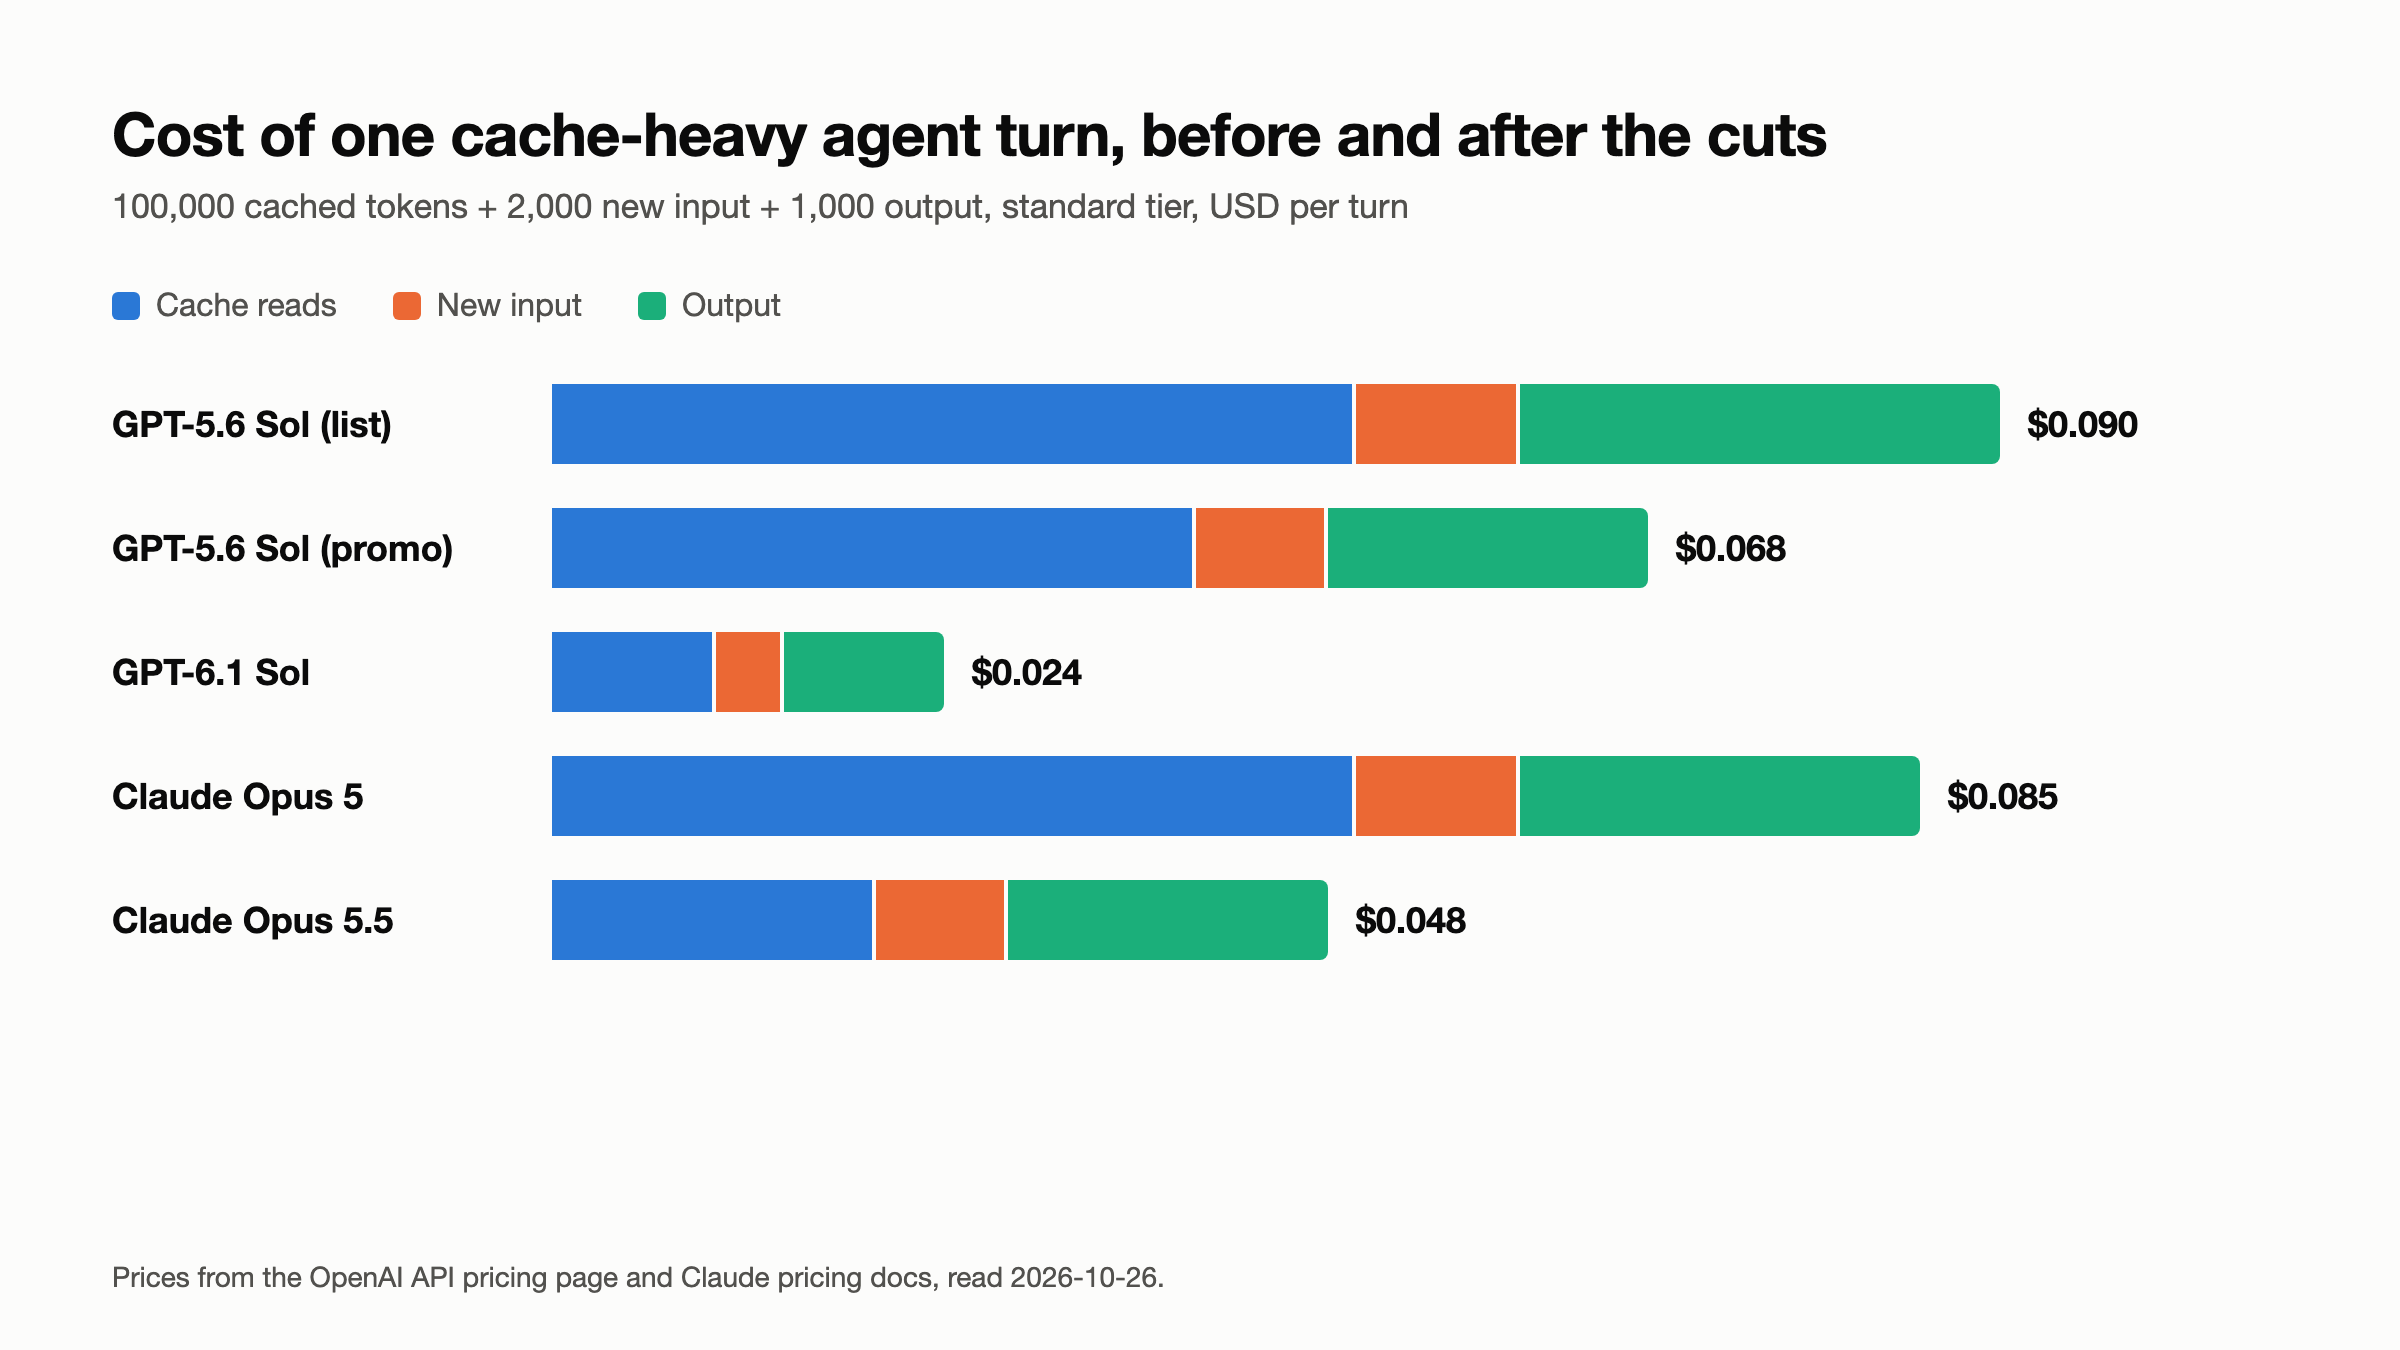
GPT-6.1 Sol est 73 % en dessous du tarif normal de GPT-5.6 Sol sur ce tour, et Opus 5.5 est 44 % en dessous d’Opus 5, proche des 40 % annoncés par Anthropic. Sur les anciens modèles, les lectures de cache représentaient plus de la moitié du tour, donc le prix des lectures de cache est désormais le chiffre qui compte pour les agents. C’est pourquoi la baisse uniquement sur le cache de Fable 5.1 compte plus que ne le suggère son tarif inchangé de 10 $/50 $. Voir notre calcul du seuil de rentabilité du cache d’Opus 5.5 et notre guide de mise en cache des prompts de GPT-6.
Ce qu’il faut changer : classez les modèles par coût par tour selon votre taux réel de succès du cache, et non selon le prix d’entrée catalogue.
Un classifieur à fort volume
Maintenant un routeur ou un classifieur : 1 million de requêtes par jour, 1 500 tokens d’entrée et 200 tokens de sortie chacune, sans cache.
- GPT-5.6 Luna avant le 30 juillet : 1,5 Md d’entrée à 1 $ plus 200 M de sortie à 6 $ = 2 700 $/jour
- GPT-6 Luna : 150 $ + 100 $ = 250 $/jour
- Claude Haiku 4.5 : 1 500 $ + 1 000 $ = 2 500 $/jour
- Claude Haiku 5.5 : 150 $ + 100 $ = 250 $/jour
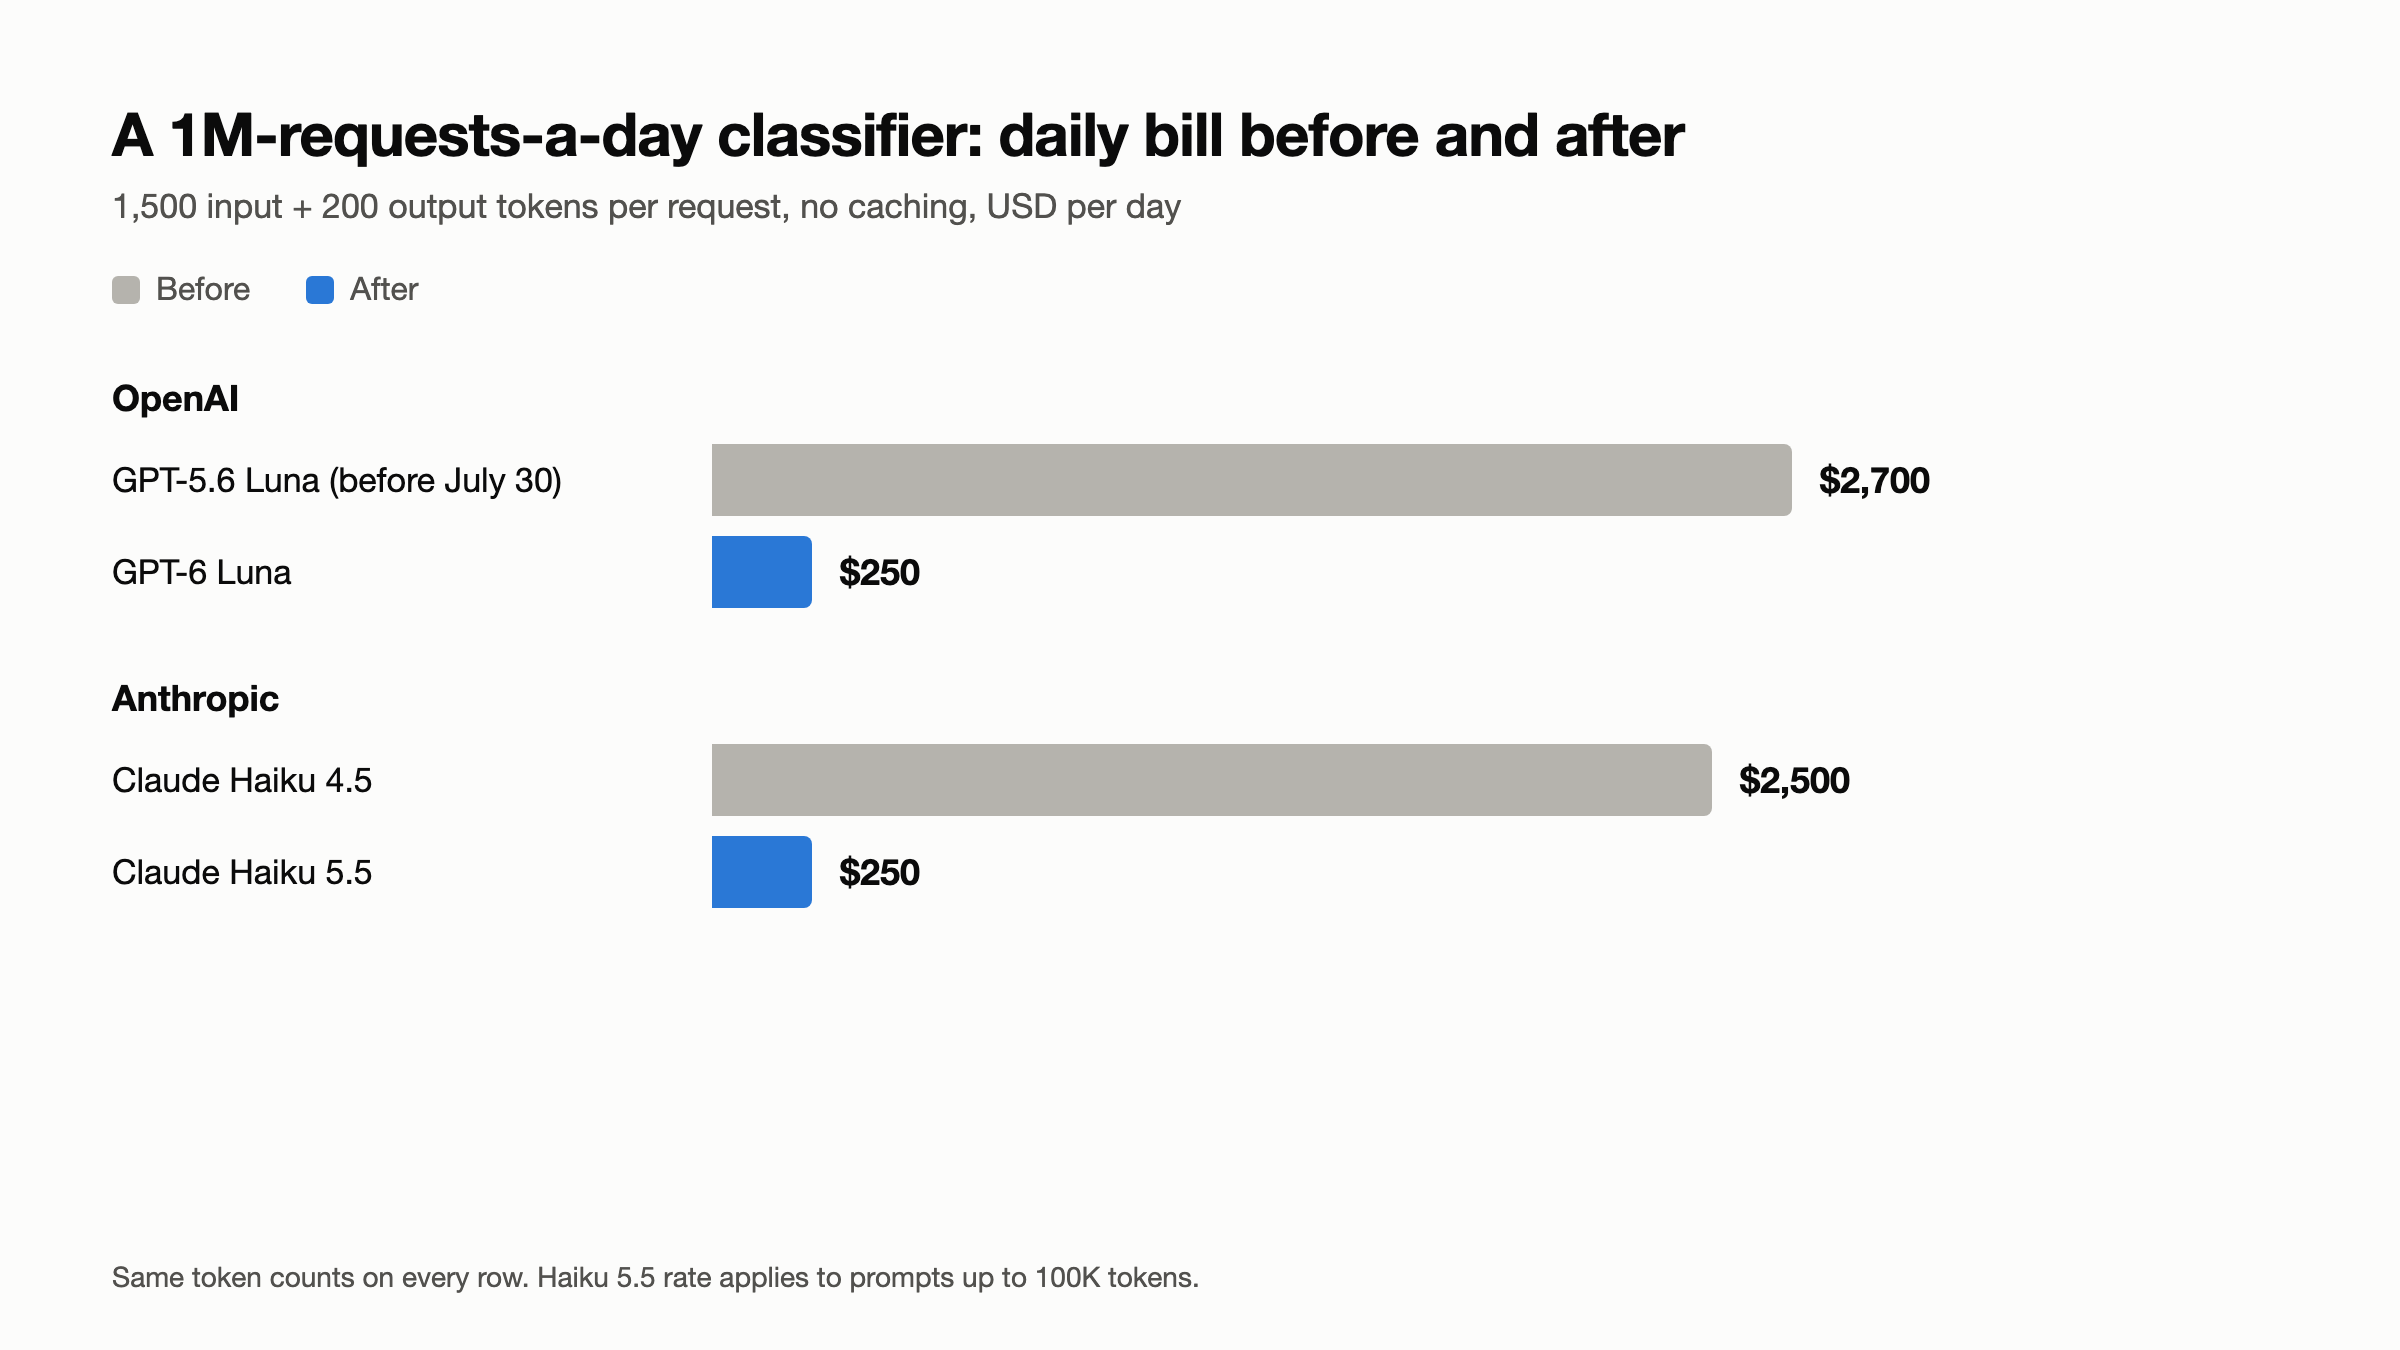
Ce qu’il faut changer : arrêtez de réduire les prompts pour les petits modèles, et testez si le trafic de gamme intermédiaire peut désormais tenir sur un petit modèle. Exécutez d’abord votre jeu d’évaluation : le prix par token ne dit rien de la précision sur vos données.
Batch : des montants plus faibles, même pourcentage
Les deux offrent toujours 50 % de réduction sur le travail asynchrone : l’API Batch d’Anthropic divise par deux l’entrée et la sortie, et le niveau Flex/Batch d’OpenAI divise par deux tout, entrée mise en cache comprise (GPT-6.1 Sol : 1 $ / 5 $ / 0,05 $). Sur le classifieur ci-dessus, le batch permet désormais d’économiser 125 $ par jour. Pour les petites charges de travail, cela peut ne plus justifier une infrastructure de file d’attente supplémentaire ; pour les grandes, le guide de l’API Batch d’OpenAI s’applique toujours.
Les pièges qui gonflent encore la facture
Les écritures de cache coûtent plus cher que l’entrée. Anthropic facture 1,25x le prix d’entrée de base pour une écriture de 5 minutes et 2x pour une écriture d’une heure. Le tableau d’OpenAI comporte aussi des colonnes d’écriture : 1,25x pour 30 minutes et 2,5x pour 12 heures (GPT-6.1 Sol : 2,50 $ et 5 $ contre 2 $ en entrée). Un préfixe écrit et jamais lu coûte 25 % à 150 % de plus que sans cache. Avec des lectures à 5 % de l’entrée, une écriture courte est rentabilisée après une lecture, une longue après deux.
Multiplicateurs de contexte long. Sur GPT-6.1 Sol et GPT-6 Luna, les pages de modèles d’OpenAI indiquent que les prompts dépassant 272K tokens d’entrée sont facturés à 2x les tarifs d’entrée et de cache et 1,5x la sortie « pour la requête complète ». Claude Haiku 5.5 passe de 0,10 $/0,50 $ à 0,50 $/2,50 $ au-delà de 100 000 tokens de prompt, et Anthropic compte les lectures et écritures de cache dans ce seuil. Les autres modèles Claude 4.6 et ultérieurs facturent la fenêtre complète de 1M aux tarifs standard. Un seul prompt surdimensionné sur un chemin critique peut effacer les économies.
Les tokens de raisonnement sont des tokens de sortie. Le guide de raisonnement d’OpenAI indique que les tokens de raisonnement sont « facturés comme des tokens de sortie » et les affiche dans usage.output_tokens_details.reasoning_tokens. Une réponse peut atteindre max_output_tokens avant toute sortie visible, et vous payez quand même. La documentation sur le coût de la réflexion d’Anthropic facture l’intégralité de la réflexion, pas le résumé visible, indiquée dans usage.output_tokens_details.thinking_tokens. La sortie est le côté coûteux de chaque ligne, donc les réglages d’effort peuvent faire varier les factures plus que le choix du modèle.
Majorations régionales. OpenAI ajoute 10 % pour le traitement régional (résidence des données) sur les modèles sortis à partir du 5 mars 2026, et 10 % pour les points de terminaison FedRAMP. Anthropic applique un multiplicateur de 1,1x lorsque vous définissez inference_geo: "us", et les points de terminaison régionaux sur Bedrock et Google Cloud entraînent une majoration de 10 % par rapport aux points globaux.
Tokeniseurs et promotions. La documentation d’Anthropic indique que les modèles Claude 4.7 et ultérieurs utilisent un tokeniseur qui produit environ 30 % de tokens en plus pour le même texte que Sonnet 4.6 et antérieurs, donc sur un même texte, le passage de Haiku 4.5 à Haiku 5.5 revient à environ 87 % plutôt que 90 %. Et si vous avez épinglé gpt-5.6-sol pour conserver le tarif promotionnel, notez le 21 novembre 2026 dans votre calendrier.
Laissez votre agent de codage placer des assertions de coût sur vos appels LLM avec Apidog CLI
Les prix changent tous les mois ; le nombre de tokens change dès que quelqu’un modifie un prompt ou augmente un réglage d’effort. La solution durable est un test qui échoue lorsqu’un appel dépasse le budget, exécuté à chaque pull request. Laissez Claude Code, Codex ou Cursor l’écrire avec Apidog CLI.
Installez la CLI et la compétence de l’agent une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez un prompt à votre agent :
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
L’agent lit chaque schéma de payload, valide avant d’écrire, et exécute le cas :
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Les budgets résident dans les postProcessors du cas sous forme d’assertions sur JSONPath, avec des comparaisons telles que isAtMost et isAtLeast issues du schéma test-case-create :
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Pour Claude, pointez le point de terminaison vers /v1/messages et faites une assertion sur $.usage.output_tokens et $.usage.output_tokens_details.thinking_tokens. Demandez ensuite un scénario de test qui effectue le même appel deux fois et vérifie que $.usage.input_tokens_details.cached_tokens (OpenAI) ou $.usage.cache_read_input_tokens (Claude) de la deuxième réponse est supérieur à zéro : lorsque quelqu’un casse le préfixe mis en cache, la compilation échoue avant que la facture n’arrive. Fournissez des prompts représentatifs avec -d, transmettez la clé API depuis les secrets CI avec --env-var, et utilisez -r junit dans votre pipeline (guide CI/CD). Apidog CLI dans Claude Code couvre la configuration de l’agent.
FAQ
OpenAI et Anthropic ont-ils vraiment baissé leurs prix de 80 % ? Pour un modèle, oui : GPT-5.6 Luna est passé de 1 $/6 $ à 0,20 $/1,20 $ le 30 juillet 2026. La plupart des autres baisses proviennent de modèles successeurs moins chers.
Les baisses s’appliquent-elles aux abonnements Claude Code et Codex ? Les pages de tarification concernent l’API. Woolf affirme que les économies atteignent aussi les harnais d’abonnement, mais rapporte également qu’OpenAI a réduit de moitié l’allocation d’utilisation du niveau à 200 $ de Codex, alors vérifiez les limites de votre forfait.
Le prix de GPT-5.6 Sol est-il permanent ? Non. Il est promotionnel, au moins jusqu’au 21 novembre 2026. GPT-6.1 Sol est de toute façon moins cher.
Quel est le moyen le moins cher de réduire la facture d’un agent maintenant ? Augmentez votre taux de succès du cache et réduisez l’effort de raisonnement. Les lectures de cache dominent les longues sessions, et le raisonnement est facturé au tarif de sortie.
Prochaine étape
Refaites le calcul des coûts pour vos trois appels LLM les plus fréquents, puis demandez à votre agent d’ajouter un test de budget de tokens pour chacun. Téléchargez Apidog pour commencer.