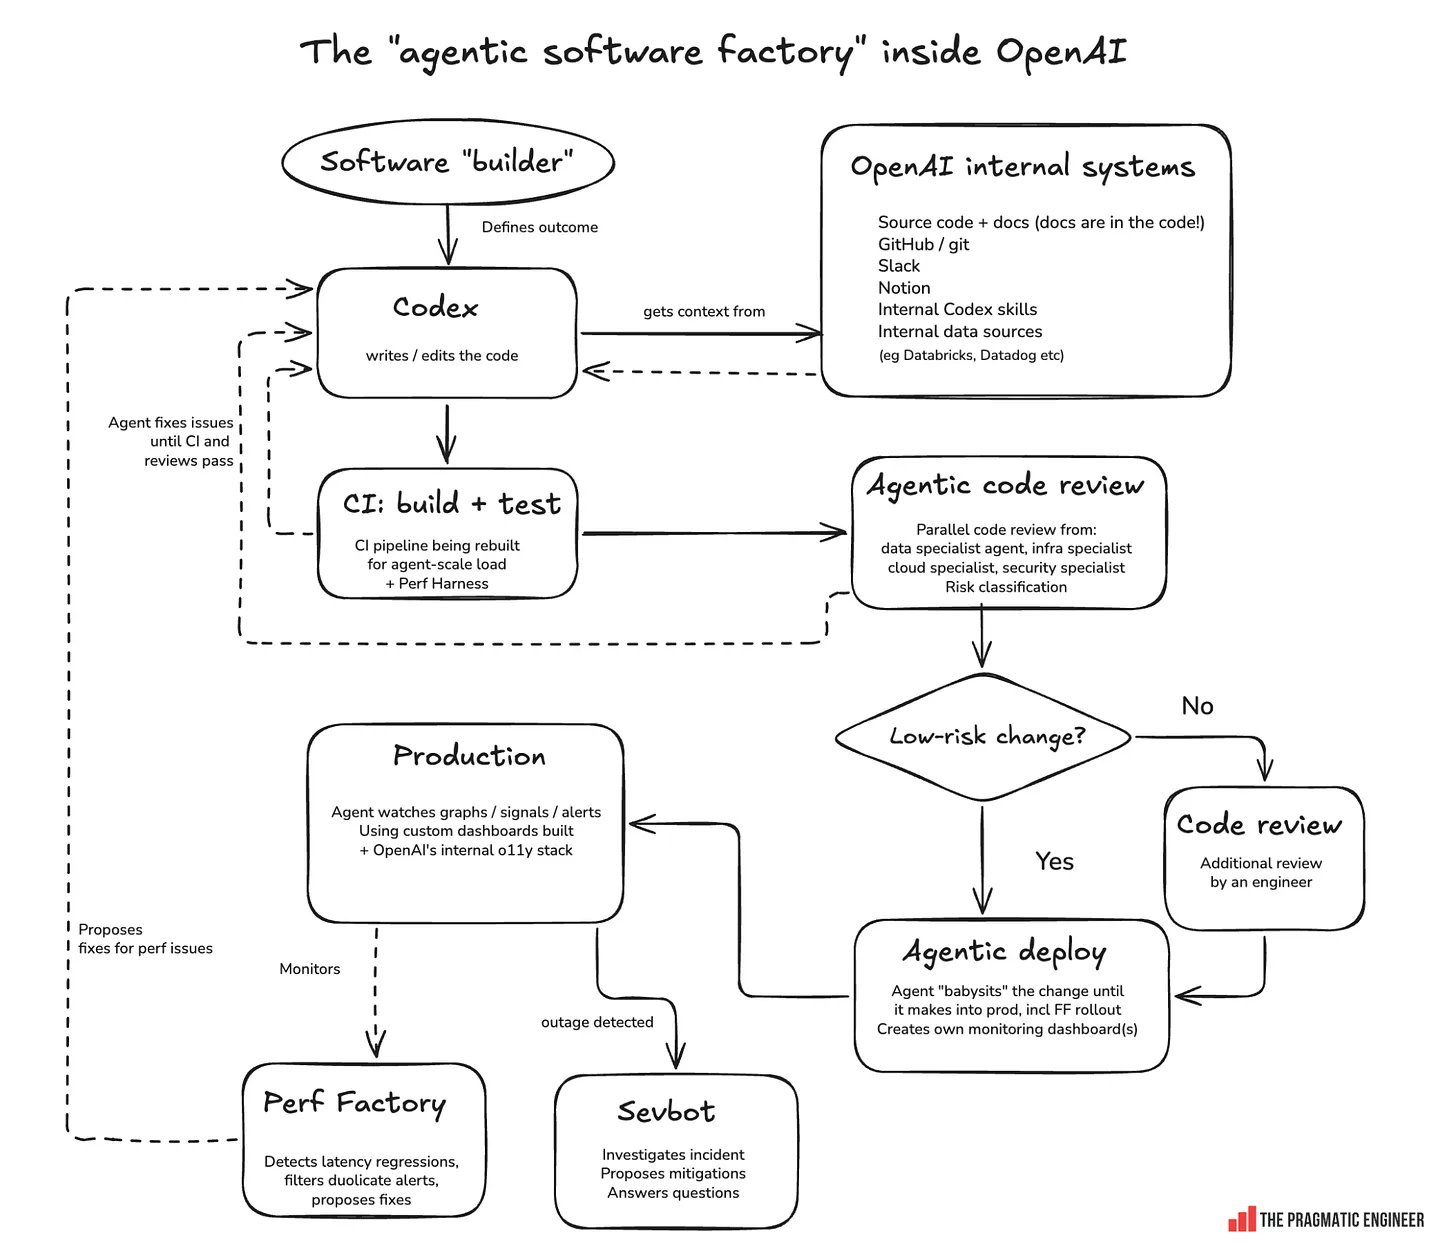
Un diagramme du pipeline d'ingénierie interne d'OpenAI est devenu semi-viral sur X cette semaine. Il montrait dix étapes, de "le développeur de logiciels définit le résultat" jusqu'à un agent qui surveille les graphiques de production et dépose ses propres rapports d'incidents. La source est la newsletter de Gergely Orosz, The Pragmatic Engineer, dans un article intitulé "L'usine logicielle agentique d'OpenAI", et le diagramme lui-même s'est rapidement répandu sur X.
La plupart des réactions ont omis un détail important : plusieurs de ces dix étapes décrivent la configuration d'ingénierie interne d'OpenAI, et non le produit Codex que vous pouvez installer aujourd'hui. Confondre les deux est l'erreur la plus courante dans le discours autour de ce diagramme. Cet article examine chaque étape et s'arrête à la seule que les équipes externes peuvent réellement copier : l'intégration continue (CI).
Les dix étapes, dans l'ordre
Le diagramme se lit de gauche à droite comme une boucle : un humain fixe un objectif, un agent écrit du code, des barrières automatisées le vérifient, et l'agent continue d'itérer jusqu'à ce que ces barrières soient franchies. Voici la séquence complète avec la distinction entre le "produit interne" et le "produit commercialisé" pour chaque étape.
| # | Étape | Ce qui se passe | Interne uniquement ou livré dans Codex |
|---|---|---|---|
| 1 | Développeur de logiciels | Un ingénieur ou un chef de produit définit le résultat | Étape humaine, pas logicielle |
| 2 | Codex écrit/modifie le code | Tire le contexte des sources, docs, GitHub, Slack, Notion, compétences internes, et systèmes de données comme Databricks et Datadog | Codex commercialisé écrit du code ; le graphe de contexte interne (Slack, Notion, données internes) est interne uniquement |
| 3 | CI : compilation + test | Un pipeline en cours de reconstruction pour une charge à l'échelle d'un agent, plus un « Perf Harness » | Livré (votre propre CI) ; le travail de mise à l'échelle spécifique d'OpenAI est interne |
| 4 | Revue de code agentique | Revue parallèle par des agents spécialistes des données, de l'infra, du cloud et de la sécurité, plus classification des risques | Interne uniquement |
| 5 | Décision à faible risque | Les changements à faible risque sont poursuivis ; les changements à risque plus élevé reçoivent une revue supplémentaire par un ingénieur humain | Interne uniquement |
| 6 | Déploiement agentique | Un agent « couve » le changement en production, y compris le déploiement de drapeaux de fonctionnalités, et construit ses propres tableaux de bord | Interne uniquement |
| 7 | Surveillance de la production | L'agent surveille les graphiques, les signaux et les alertes sur la pile d'observabilité interne d'OpenAI | Interne uniquement |
| 8 | Panne détectée -> Sevbot | Enquête sur l'incident, propose des mesures d'atténuation, répond aux questions | Interne uniquement |
| 9 | Usine de performances | Filtre les alertes en double, trouve les régressions de latence, propose des correctifs | Interne uniquement |
| 10 | Retour à la boucle | L'agent corrige les problèmes jusqu'à ce que la CI et les revues soient validées, puis le développeur reçoit les correctifs proposés | Décrit la boucle interne |
Une seule étape, celle de la CI, plus une partie de l'étape 2, est quelque chose qu'une équipe externe peut désigner en disant « nous avons cela aussi ». Tout le reste, de la revue agentique à Sevbot, est une construction interne d'OpenAI.
Cette colonne « interne uniquement » est aussi un problème d'approvisionnement. Les éléments qu'OpenAI garde derrière son pare-feu, l'orchestration, la porte de révision, l'approbation humaine, sont précisément la couche pour laquelle la plupart des équipes n'ont rien. Sharkly est un endroit neutre vis-à-vis des fournisseurs pour le construire : un développeur définit le résultat comme une Tâche, l'assigne à un Agent, et l'Agent s'exécute sur un Ordinateur en utilisant le Runtime que vous possédez déjà, Claude Code ou Codex. « Prêt pour la publication » est le statut qu'un humain doit faire passer avant que quoi que ce soit n'atteigne « Terminé », de sorte que l'approbation reste le travail d'une personne, et non du pipeline. Sharkly ne remplace pas Codex et n'écrit pas de code lui-même ; il exécute le Runtime pour lequel vous payez déjà et offre à la boucle environnante un endroit où vivre.
Étape 1-2 : un humain fixe toujours l'objectif, Codex écrit toujours le code
Un développeur de logiciels, c'est-à-dire un ingénieur ou un chef de produit, définit le résultat qu'il souhaite. Codex effectue ensuite une série de modifications de code jusqu'à atteindre cet objectif et vérifie que le résultat fonctionne. Cette boucle de vérification est la partie de Codex qui est commercialisée aujourd'hui : l'application de bureau (Mac en février 2026, Windows en mars), l'intégration de ChatGPT Work à partir de juillet 2026, les plugins et compétences basés sur les rôles, et la commande /goal pour les tâches de longue durée. Si vous souhaitez connaître les mécanismes de cette commande, nous avons traité la commande /goal pour les exécutions d'agents autonomes séparément.
Ce qui n'est pas commercialisé, c'est le graphe de contexte alimentant Codex en interne : à peu près tous les systèmes d'OpenAI, des discussions Slack aux tableaux de bord Databricks. L'article d'Orosz le dit directement : le Codex interne d'OpenAI « est beaucoup plus avancé que son homologue externe car il est connecté à pratiquement tous les systèmes d'OpenAI ». Cet écart entre le Codex interne et externe est la véritable thèse de l'article.
Étape 3 : la CI est l'endroit où la boucle est réellement appliquée
C'est l'étape sur laquelle il faut s'attarder, car c'est la seule composante de l'ensemble du pipeline que n'importe quelle équipe, et pas seulement OpenAI, possède déjà. L'article note que la CI chez OpenAI est en cours de reconstruction pour une augmentation de charge d'environ 10x sur environ six mois, car les agents poussent désormais beaucoup plus de changements à travers le pipeline que les humains seuls ne l'ont jamais fait. Un « Perf Harness » est exécuté en parallèle pour détecter les régressions de performance avant qu'elles n'atteignent la revue.
Voici la partie qui est souvent omise : un agent qui « corrige les problèmes jusqu'à ce que la CI et les revues soient validées » n'est fiable que dans la mesure de ce que la CI vérifie réellement. Si votre suite de tests couvre la logique unitaire mais pas le contrat d'API, un agent peut boucler jusqu'à une construction verte qui livre toujours un changement cassant. Les codes de statut, la forme du schéma, le comportement d'authentification et les budgets de temps de réponse sous charge sont exactement le type de vérification dans lequel la plupart des équipes sous-investissent par rapport aux tests unitaires. C'est là que Apidog s'intègre : exécuter les scénarios de test d'Apidog via l'interface CLI d'Apidog dans votre étape de CI offre à un agent une barrière plus difficile à satisfaire que « le code a compilé ». Nous avons écrit sur la manière de configurer cela dans Apidog CLI dans Codex. C'est le seul rôle que Apidog joue dans ce pipeline. Ce n'est pas l'agent, et il ne touche ni le déploiement, ni la revue, ni la réponse aux incidents.
Étape 4-5 : agents de revue spécialisés et décision de risque
Une fois la CI passée, la configuration interne d'OpenAI achemine le changement à travers une revue parallèle par des agents spécialistes des données, de l'infrastructure, du cloud et de la sécurité. Orosz la décrit comme « l'équivalent d'avoir un expert humain de chaque équipe d'infrastructure pertinente pour examiner chaque changement », ce qui est une barre de revue plus lourde que ce que la plupart des équipes humaines peuvent gérer pour chaque pull request. La fonctionnalité de revue de code commercialisée de Codex est une chose différente, plus légère que ces agents spécialistes internes ; si vous décidez ce qu'un réviseur agentique à usage général peut faire pour votre propre stack, notre tour d'horizon des outils de revue de code IA est un bon point de départ, et notre article complémentaire sur la revue agentique et la conception de la porte de risque d'OpenAI approfondit cette seule case (frère, confirmer en ligne avant de lier).
La classification des risques décide ensuite de la suite des événements. Les zones du codebase à faible risque peuvent permettre à un agent d'auto-approuver ses propres PR, éliminant complètement l'approbation humaine de la boucle pour cette classe de changement. Les changements à risque plus élevé bénéficient de plus de passages de revue par l'IA, d'une revue humaine obligatoire, ou des deux. OpenAI n'a pas publié la règle exacte de ce qui est considéré comme un faible risque, et nous n'all'ons pas la deviner ici. Une idée qui va au-delà de la configuration spécifique d'OpenAI : un changement cassant apporté à un contrat d'API public ne devrait jamais être classé comme à faible risque, quelle que soit la taille de la différence. Les outils basés sur la spécification qui maintiennent votre définition OpenAPI et vos tests au même endroit facilitent l'application automatique de cette distinction, car une différence de schéma est un signal de risque beaucoup plus clair qu'une différence de nombre de lignes.
Étape 6-8 : déployer, surveiller et réagir, sans qu'un humain ne soit d'abord appelé
Si un changement passe la revue, un agent interne le « supervise » en production, y compris le déploiement par feature-flag, et construit ses propres tableaux de bord de surveillance pour ce changement spécifique. Une fois en ligne, le même agent (ou un agent connexe) surveille les graphiques et les alertes sur la pile d'observabilité interne d'OpenAI. Lorsque quelque chose tombe en panne, Sevbot prend le relais : il enquête sur l'incident, propose des mesures d'atténuation et répond aux questions des développeurs dans Slack. Il est important d'être précis sur ce que Sevbot ne fait pas. Il propose ; il n'exécute pas. Un humain autorise toujours l'atténuation et reste d'astreinte. Comme l'article l'indique clairement, « la garde n'appartient pas au passé ». Aucune des étapes 6 à 8 n'existe dans le produit Codex que vous pouvez acheter.
Étape 9-10 : régressions de performance et retour à la boucle
Perf Factory fonctionne parallèlement au chemin d'incident. Il passe au crible les alertes et les tableaux de bord, filtre les signaux en double, débusque les véritables régressions de latence et propose des correctifs, qui sont ensuite renvoyés au développeur d'origine. Avec Sevbot, c'est la réponse d'OpenAI à la fatigue d'alerte : au lieu qu'un ingénieur d'astreinte trie chaque notification, un agent pré-filtre et pré-diagnostique d'abord. La boucle se ferme avec l'étape 10 : l'agent continue de réviser jusqu'à ce que la CI et toutes les couches de revue soient passées.
Pourquoi la distinction interne/externe est importante pour votre équipe
Si vous évaluez si l'ingénierie agentique de type « OpenAI » est quelque chose que votre équipe peut adopter ce trimestre, la réponse honnête est : vous pouvez adopter les étapes 1 à 3 dès aujourd'hui, et les étapes 4 à 9 décrivent une direction, pas une fonctionnalité achetable. Ce n'est pas une critique d'OpenAI ; les outils internes à cette échelle prennent des années. Un projet open-source, orchflows, est une tentative publique d'approximer cette boucle avec une commande /software-factory pour Claude Code et Codex ; son README est franc sur l'objectif, arguant que vous n'avez besoin que de deux compétences au lieu d'une bibliothèque entière. C'est un projet précoce, non affilié, et non une version d'OpenAI, donc traitez-le comme une implémentation de référence plutôt qu'une usine prête à l'emploi.
L'adoption au sein d'OpenAI a progressé rapidement dans les parties qui ne nécessitent pas de plomberie interne personnalisée : l'utilisation de Codex dans les équipes non-ingénieurs est passée d'environ 0 % à 90 % d'adoption en quatre mois, de février à mai 2026. C'est un signal plus fort que le seul diagramme du pipeline, car cela indique que la partie facile (un agent qui écrit du code vers un objectif déclaré) est déjà normale chez OpenAI, tandis que la partie difficile (le déploiement, la révision et la réponse aux incidents agentiques intégrés à chaque système interne) est toujours sur mesure.
Ce qui reste humain
L'article est prudent quant à ce qui ne change pas. Les développeurs définissent toujours les résultats. Les humains approuvent toujours les changements à haut risque et autorisent les atténuations d'incidents. Quelqu'un examine toujours ce que Sevbot a fait après coup, et les rotations d'astreinte existent toujours. La dernière phrase de l'article saisit mieux le changement que n'importe quelle statistique : « Le jugement, la priorisation et le goût deviennent plus importants. » Deux mises en garde permettent également de rester terre-à-terre : la revue des applications sur les stores mobiles reste un goulot d'étranglement manuel qu'aucun agent ne peut contourner, et la mise à l'échelle de l'infrastructure est un combat mensuel, pas un problème résolu.
Si vous construisez votre propre version des étapes 1 à 3 plutôt que d'attendre qu'un fournisseur livre les étapes 4 à 9, commencez par la porte qui existe déjà dans votre pipeline : la CI. Notre article complémentaire sur la construction d'une usine logicielle plus légère autour de Codex décrit cette construction (frère, confirmer en ligne avant de lier), et la conception de Sevbot/Perf Factory est traitée dans notre article sur l'usine de performance d'OpenAI et Sevbot (frère, confirmer en ligne avant de lier). Un agent qui boucle jusqu'à ce que les tests passent n'est une bonne idée que si les tests qu'il exécute affirment réellement quelque chose. Apidog maintient les tests de contrat d'API à côté de la spécification afin que cette porte reste honnête lorsque des agents, et pas seulement des humains, commencent à y pousser des changements.