
NVIDIA a livré le modèle de transcription vocale à poids ouverts le plus précis du classement Open ASR de Hugging Face, et vous pouvez l’utiliser gratuitement dès aujourd’hui. Nemotron 3.5 Transcribe (nom complet NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) est arrivé le 28 octobre 2026 sous licence OpenMDW-1.1, qui autorise l’usage commercial. Cela signifie trois voies à 0 $ : l’espace de démo de NVIDIA lui-même, les poids gratuits sur votre propre GPU, et les Spaces communautaires qui encapsulent le même checkpoint.
Ce guide couvre chaque voie gratuite, ce qu’elle peut et ne peut pas faire, et la solution payante la moins chère quand le gratuit ne suffit plus. Chaque fait provient de la fiche modèle officielle, du post de lancement NVIDIA sur Hugging Face et du classement Open ASR, tous consultés le 29 octobre 2026.
Si vous avez seulement besoin de l’API hébergée, passez à notre guide de l’API Nemotron 3.5 Transcribe.
Nemotron 3.5 Transcribe est-il gratuit ?
Oui, de deux façons. Les poids sont gratuits à télécharger et la licence autorise un usage commercial et non commercial, donc l’auto-hébergement ne vous coûte que le matériel. NVIDIA gère aussi un espace de démo gratuit sur Hugging Face où vous pouvez l’essayer dans le navigateur.
Ce qui n’est pas gratuit : les API hébergées. DeepInfra facture 0,002 $ par minute d’audio et OpenRouter l’affiche à 0,000033 $ par seconde. Aucun des deux ne montre de variante gratuite. Et au 29 octobre 2026, le modèle n’apparaît pas sur build.nvidia.com, où de nombreux modèles NVIDIA bénéficient d’une API d’essai gratuite. Une recherche sur place pour « transcribe » a renvoyé un modèle ASR espagnol sans rapport.
Pourquoi on le veut : les chiffres
Nemotron 3.5 Transcribe est un modèle de langage augmenté pour la parole. Un encodeur ASR de 600 M de paramètres et un encodeur de locuteur alimentent un modèle de langage hybride à mélange d’experts Mamba-2 et Transformer. Il compte 34 B de paramètres au total, mais seulement environ 4,3 B sont actifs par token, ce qui explique qu’il tourne sur un seul GPU.
Ce qu’il fait en un seul checkpoint :
- Transcription en 40 langues, dont 13 classées « leaders » (anglais, espagnol, français, allemand, hindi, coréen, portugais et d’autres)
- Enregistrements jusqu’à une heure en une seule requête (contexte de 65 536 tokens)
- Attribution des locuteurs avec jusqu’à huit locuteurs étiquetés
- Horodatages au niveau du mot via une tête d’alignement CTC
- Traduction de la parole vers et depuis l’anglais dans 31 langues
- Amorçage par contexte : transmettez des noms et du jargon pour qu’il les orthographie correctement
- Questions-réponses sur l’audio (anglais uniquement)
Sur le classement Open ASR, mis à jour le 28 octobre 2026, il obtient un WER moyen de 5,33 %. Cela le place 9e sur 61 modèles. Les huit qui le précèdent (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech et d’autres) sont tous des API fermées et payantes. Parmi les modèles téléchargeables, aucun n’est mieux classé. whisper-large-v3 d’OpenAI se situe 41e avec 7,16 %.
La fiche modèle de NVIDIA rapporte un WER moyen de 4,71 % sur les neuf ensembles publics. Le 5,33 % du classement ajoute deux ensembles privés, donc les deux chiffres sont honnêtes ; ils mesurent des mélanges différents.
Une limite à connaître avant de commencer : c’est un modèle hors ligne. Il transcrit des fichiers enregistrés, pas un flux de microphone en direct.
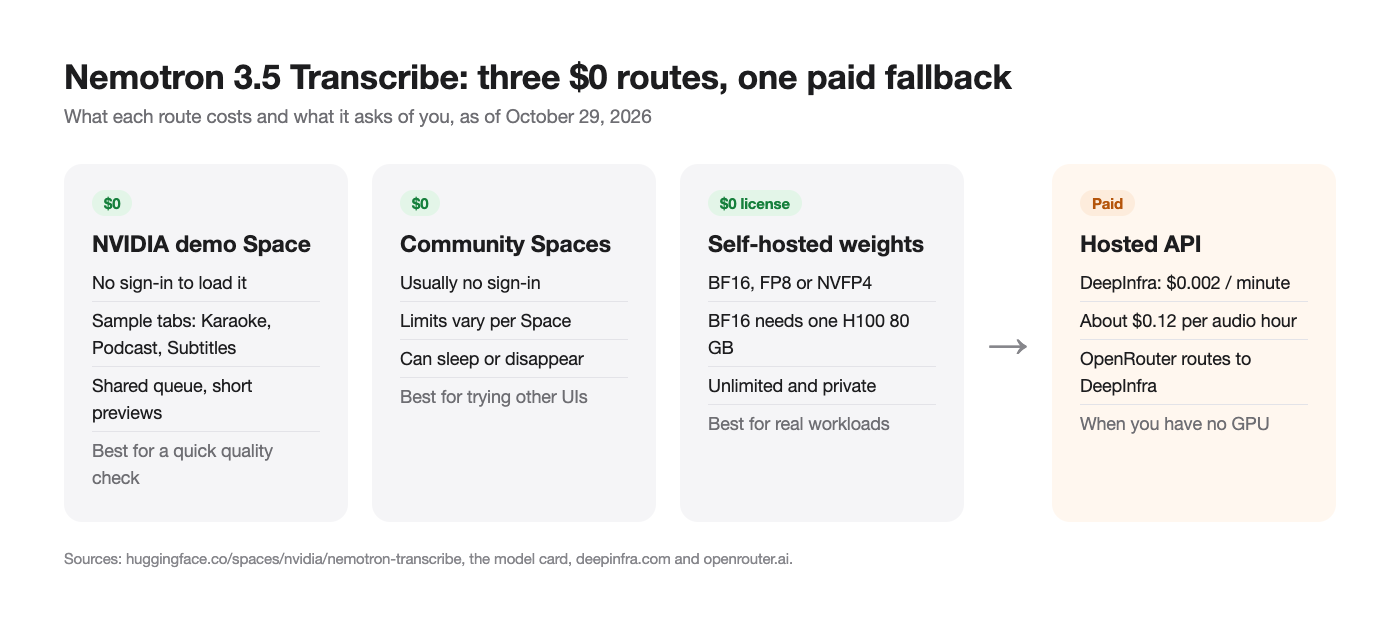
Comparaison de toutes les voies gratuites et payantes
| Voie | Coût | Connexion | Limites | Idéal pour |
|---|---|---|---|---|
Espace de démo NVIDIA (nvidia/nemotron-transcribe) |
0 $ | Non | Aperçu de 60 secondes sur les onglets d’exemple ; file d’attente partagée | Un contrôle qualité rapide |
| Spaces communautaires | 0 $ | Généralement non | Varie selon le Space ; peut s’endormir ou disparaître | Essayer d’autres interfaces |
| Poids auto-hébergés (BF16, FP8, NVFP4) | Licence à 0 $, votre GPU | Compte Hugging Face pour télécharger | Un H100 80 Go pour BF16 ; les cartes plus petites nécessitent FP8 ou NVFP4 | Transcription privée illimitée |
| API DeepInfra | 0,002 $ par minute | Compte et clé API | Usage payant | Production sans GPU |
| OpenRouter | 0,000033 $ par seconde | Compte et crédits | Routé uniquement vers DeepInfra | Une clé pour plusieurs modèles |
| build.nvidia.com | Pas encore répertorié | n/a | n/a | À surveiller |
Seules les trois premières lignes ne coûtent rien.
Voie gratuite 1 : l’espace de démo de NVIDIA
Le moyen le plus rapide d’entendre ce que le modèle peut faire est l’espace officiel de NVIDIA à l’adresse huggingface.co/spaces/nvidia/nemotron-transcribe.
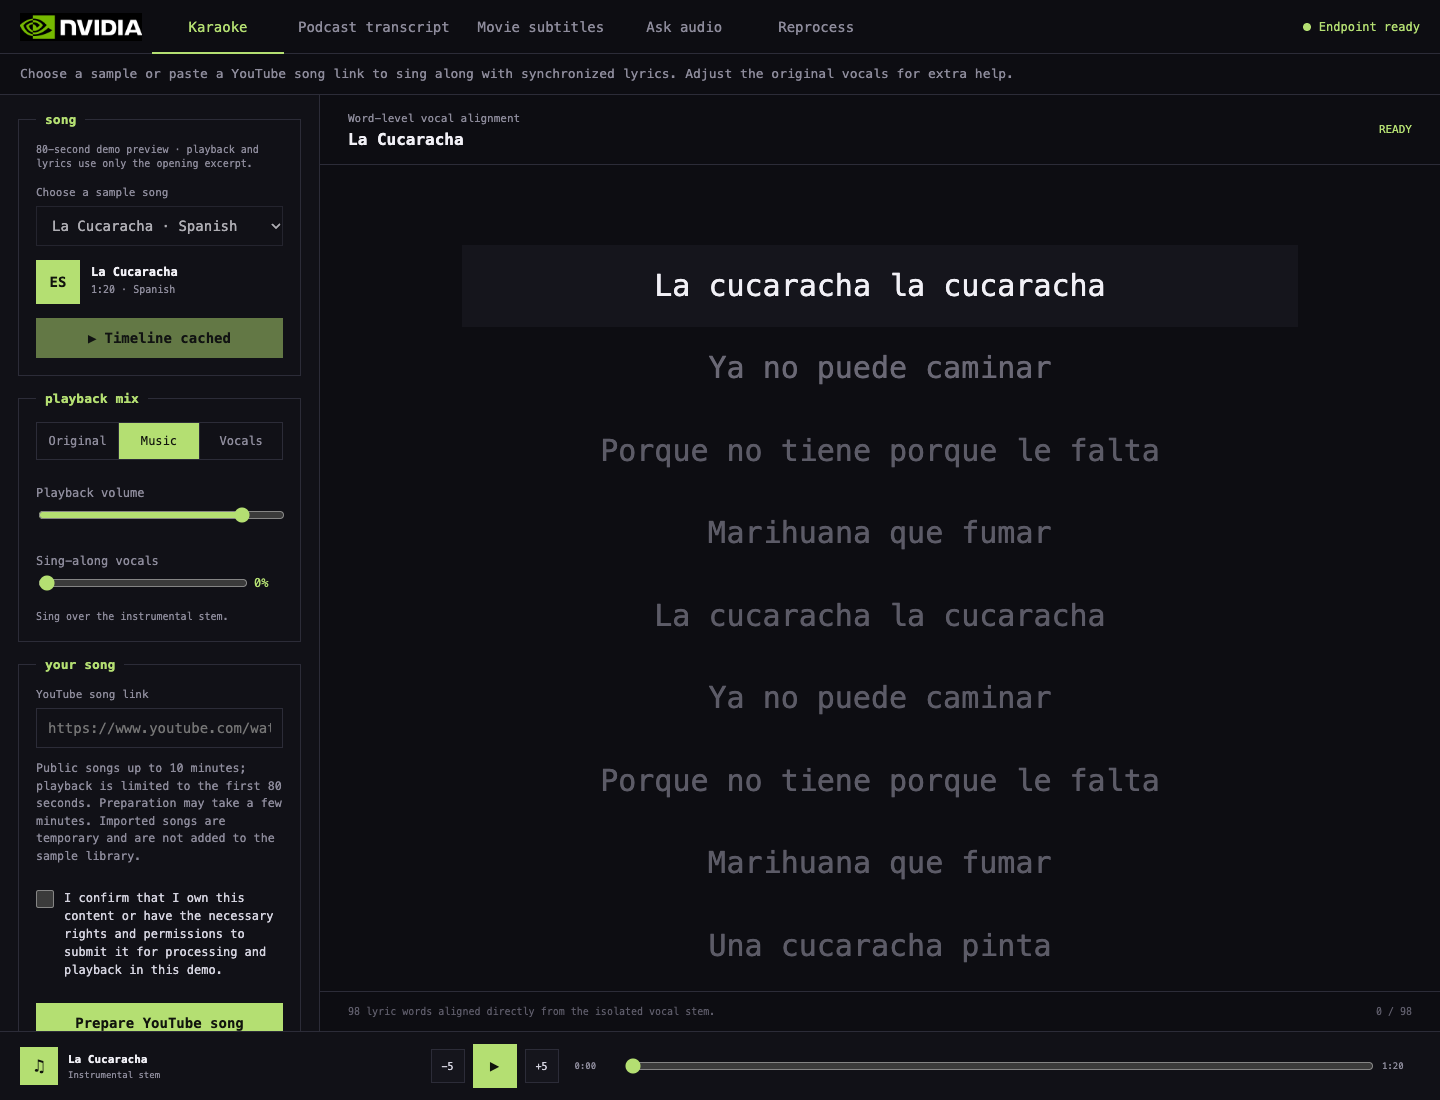
- Ouvrez le Space dans votre navigateur. Aucun compte n’est nécessaire pour le charger.
- Choisissez un onglet. Le 29 octobre 2026, le Space en avait trois : Karaoke (paroles synchronisées mot à mot), Transcription de podcast (texte attribué aux locuteurs) et Sous-titres de film (sous-titres synchronisés).
- Choisissez un exemple ou collez un lien, selon ce que permet l’onglet. L’onglet Karaoke indique que son aperçu couvre les 60 premières secondes.
- Lancez-le et lisez la sortie. La vue Karaoke met en évidence chaque mot au fur et à mesure qu’il est chanté, ce qui met en valeur les horodatages au niveau du mot.
Considérez le Space comme une démo, pas comme une API gratuite. Les Spaces publics partagent des GPU, mettent les requêtes en file d’attente et peuvent changer sans préavis. Ne construisez pas un produit dessus.
Voie gratuite 2 : exécuter vous-même les poids ouverts
C’est le vrai niveau gratuit : transcription illimitée sur du matériel que vous possédez déjà, sans que rien ne quitte votre machine. La licence (OpenMDW-1.1) autorise l’usage commercial, donc vous pouvez l’intégrer dans un produit.
Le revers de la médaille, c’est le matériel. La configuration de référence de NVIDIA est un H100 80 Go en BF16. Le tableau de compatibilité de la fiche modèle liste :
- BF16 : H100, H200, A100 80 Go, B200, GB200, DGX Spark
- FP8 : H100, H200, L40S 48 Go
- NVFP4 uniquement : RTX 5090 (32 Go) et RTX PRO 6000 Blackwell
Donc une RTX 5090 grand public fonctionne, avec le checkpoint NVFP4. Les cartes plus anciennes de 24 Go comme la RTX 4090 ne figurent pas dans la liste.
Le test le plus rapide ne nécessite que Transformers installé depuis les sources :
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
C’est suffisant pour une poignée de fichiers. Pour des lots, de longs enregistrements et un point de terminaison compatible OpenAI, servez-le avec vLLM 0.32.0 et le plugin NeMo Speech. Notre guide pas à pas pour exécuter Nemotron 3.5 Transcribe localement contient l’installation exacte et la commande vllm serve de la fiche modèle.
Pas de GPU local ? En louer un à l’heure est la voie « presque gratuite » la moins chère pour de gros arriérés. NVIDIA indique qu’une RTX PRO 6000 Blackwell peut traiter 100 heures d’audio en moins de trois minutes avec la version NVFP4, bien que ce chiffre utilise des optimisations de service qui ne sont pas encore open source.
Voie gratuite 3 : Spaces communautaires
La page du modèle liste plusieurs Spaces communautaires construits sur le même checkpoint, notamment hugging-apps/nemotron-3-5-transcribe et mrfakename/nemotron-3.5-transcribe. Ils sont utiles quand la file d’attente du Space NVIDIA est longue ou que vous voulez une simple zone de téléversement. Ils sont gérés par des particuliers, alors attendez-vous à des mises en veille, des quotas et parfois à des liens morts.
Des prompts pour de meilleurs résultats gratuits
Nemotron 3.5 Transcribe accepte des instructions en langage naturel. Celles-ci proviennent de la fiche modèle et de la page DeepInfra. Gardez le prompt système vide pour la transcription et utilisez une température de 0.
Texte propre et lisible :
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
Qui a dit quoi :
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Noms de produits et jargon :
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
Traduction :
Please translate the given speech to English.
Les termes de contexte comptent plus que vous ne l’imaginez. Sur le benchmark ContextASR de NVIDIA, le WER passe de 3,33 % sans contexte à 1,71 % avec un contexte finement détaillé.
Quand le gratuit ne suffit plus : la voie payante la moins chère
Si vous ne possédez pas de GPU compatible et avez besoin de plus qu’une démo, l’API hébergée est bon marché. À 0,002 $ par minute chez DeepInfra, un enregistrement d’une heure coûte 0,12 $, et 1 000 heures coûtent 120 $. Les 0,000033 $ par seconde d’OpenRouter reviennent à environ 0,119 $ par heure, routé vers le même fournisseur.
Une requête DeepInfra minimale, tirée de sa page API :
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
La réponse inclut text, segments avec les heures de début et de fin, words, et la language détectée. Notre guide de l’API détaille les clés, les champs de réponse et les coûts.
Laissez votre agent de codage tester le point de terminaison avec Apidog CLI
Que vous auto-hébergiez ou utilisiez DeepInfra, vous voulez une vérification qui échoue bruyamment quand une transcription revient vide ou dans la mauvaise langue. Confiez cette tâche à votre agent de codage et à Apidog CLI au lieu d’inspecter le JSON à l’œil nu.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Ensuite, donnez à votre agent un seul prompt :
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
L’agent lit le schéma, valide sa charge utile, écrit le cas et l’exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Changez l’environnement pour pointer vers votre serveur local quand vous passez de l’API à l’auto-hébergement. Le même apidog run avec -r junit s’intègre dans la CI ; voir exécuter Apidog CLI dans un pipeline CI/CD et Apidog CLI dans Claude Code pour la configuration.
Limites à connaître avant de vous y fier
- Hors ligne uniquement. Il ne diffuse pas en continu. NVIDIA renvoie à un modèle distinct Nemotron 3.5 ASR Streaming pour l’audio en direct.
- Les questions-réponses audio sont en anglais uniquement. La transcription couvre 40 langues, mais la compréhension audio et les instructions parlées n’ont été évaluées qu’en anglais.
- Les étiquettes de locuteur ne sont pas des identités.
<spk:0>signifie « la première voix », pas une personne nommée. - Les longues sorties ont besoin de place. Une conversation dense d’une heure peut produire environ 20 000 tokens de sortie, donc définissez
max_new_tokensen conséquence. - Il peut halluciner. La fiche avertit qu’il peut « générer une transcription plausible » pour un audio peu clair. Relisez tout contenu juridique ou médical.
FAQ
Nemotron 3.5 Transcribe est-il gratuit pour un usage commercial ? Oui. La licence OpenMDW-1.1 autorise l’usage commercial et non commercial des poids. Les API hébergées facturent le calcul.
Existe-t-il une clé API gratuite pour Nemotron 3.5 Transcribe ? Pas à notre connaissance au 29 octobre 2026. DeepInfra et OpenRouter sont payants, et le modèle n’est pas encore sur build.nvidia.com. Comparez avec l’API gratuite de NVIDIA pour Nemotron Nano 12B v2 VL, qui a bien obtenu un point de terminaison d’essai gratuit.
Puis-je l’exécuter sur un Mac ? Pas d’après la liste officielle. Les environnements d’exécution pris en charge ciblent les GPU NVIDIA sous Linux ou Windows (WSL2). La prise en charge GGML est indiquée uniquement pour RTX 5090 et RTX PRO 6000.
Comment se compare-t-il à Whisper ? Sur le classement du 28 octobre, il atteint en moyenne 5,33 % de WER contre 7,16 % pour whisper-large-v3. Voir notre guide de l’API Whisper pour l’option hébergée d’OpenAI et notre classement des meilleurs modèles de transcription vocale open source pour tout le panel.
Prend-il en charge le MP3 ? Oui. Il accepte WAV, FLAC, MP3, OGG ou tout ce qui se décode en PCM mono à 16 kHz. Utilisez FFmpeg pour convertir d’autres formats.
En résumé
Nemotron 3.5 Transcribe est gratuit là où ça compte : les poids, la licence et la démo de NVIDIA. Essayez le Space pour un contrôle qualité, auto-hébergez-le sur un H100, L40S ou RTX 5090 pour un usage privé illimité, et rabattez-vous sur DeepInfra à 0,12 $ par heure quand vous n’avez pas le matériel. Quelle que soit la voie choisie, laissez votre agent exécuter des vérifications Apidog sur le point de terminaison pour qu’une mauvaise transcription n’atteigne jamais la production.