Transcrire un enregistrement d'une heure avec la nouvelle API Nemotron 3.5 Transcribe de NVIDIA coûte 12 cents. C'est le prix de DeepInfra de 0,002 $ par minute pour le meilleur modèle à poids ouverts du classement Open ASR Leaderboard de Hugging Face, un modèle qui renvoie également les horodatages des mots, les étiquettes des locuteurs et la langue détectée dans le même appel.
Ce guide montre comment obtenir une clé API, envoyer votre première requête, lire la réponse, rédiger des prompts pour les étiquettes de locuteur et le jargon, et garder les coûts prévisibles. Tout ce qui suit a été vérifié le 29 octobre 2026 sur la page du modèle DeepInfra, la fiche OpenRouter et la carte de modèle officielle.
Vous cherchez plutôt une solution à 0 $ ? Lisez comment utiliser Nemotron 3.5 Transcribe gratuitement.
Ce que vous offre l'API Nemotron 3.5 Transcribe
NVIDIA a publié Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) le 28 octobre 2026. C'est un modèle vocal à poids ouverts avec 34 milliards de paramètres au total et environ 4,3 milliards actifs, construit sur un modèle de langage hybride Mamba-2 et Transformer à mélange d'experts, avec un encodeur ASR et un encodeur de locuteur ajoutés.
À partir d'un seul point de terminaison, vous obtenez :
- Transcription en 40 langues
- Fichiers jusqu'à une heure de durée
- Horodatages des mots et horodatages des segments
- Transcriptions attribuées au locuteur avec jusqu'à huit locuteurs
- Traduction de la parole dans 31 langues vers et depuis l'anglais
- Prompt contextuel pour les noms, produits et jargon
- Identification de la langue
Sur le Open ASR Leaderboard (mis à jour le 28 octobre 2026), il obtient en moyenne 5,33 % de WER, 9e sur 61 modèles et premier parmi les modèles à poids publics. Les huit modèles au-dessus sont des API commerciales fermées.
C'est un modèle hors ligne. Envoyez des fichiers enregistrés, pas un flux en direct.
Où l'appeler, et combien cela coûte
À ces tarifs, 1 000 heures d'audio coûtent environ 120 $. Pour comparaison, l'API OpenAI Whisper a historiquement facturé 0,006 $ par minute, soit trois fois le prix de DeepInfra, et whisper-large-v3 se classe 41e sur le même classement avec 7,16 % de WER.
Étape 1 : obtenir une clé API DeepInfra
- Créez un compte sur deepinfra.com.
- Ouvrez le tableau de bord et créez une clé API.
- Ajoutez un moyen de paiement ou des crédits. La page du modèle nécessite une connexion, même pour la démo dans le navigateur.
- Exportez la clé dans votre shell :
export DEEPINFRA_API_KEY="your_key_here"
Gardez la clé hors du contrôle de source. Si vous travaillez via un agent de codage, placez-la dans l'environnement de l'agent, pas dans un prompt.
Étape 2 : transcrire votre premier fichier
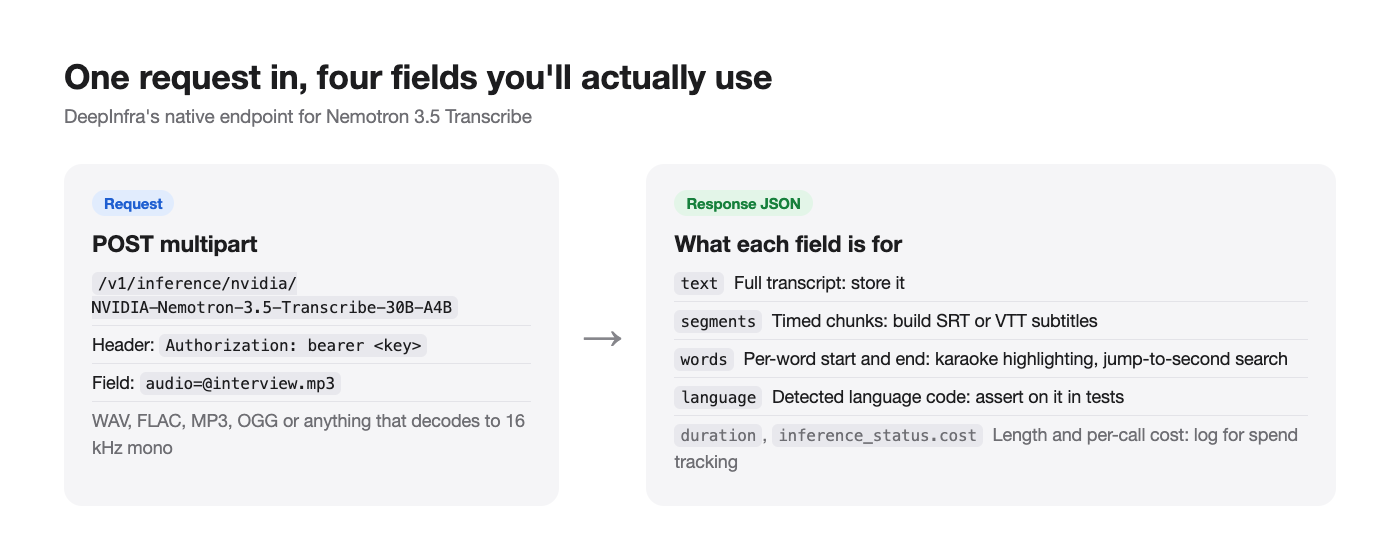
Le point de terminaison d'inférence natif de DeepInfra accepte un téléversement multipart avec un champ audio. Voici la forme exacte de la requête depuis sa page API :
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
Le modèle accepte les formats WAV, FLAC, MP3, OGG ou tout format qui se décode en PCM mono 16 kHz. Si vous avez des fichiers M4A ou vidéo, convertissez-les avec FFmpeg d'abord :
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
Étape 3 : lire la réponse
DeepInfra documente cette forme de réponse (les valeurs ci-dessous sont illustratives) :
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
À quoi sert chaque champ :
textest la transcription complète. Stockez ceci.segmentsdonne des morceaux horodatés. Utilisez-les pour les sous-titres (SRT ou VTT).wordsdonne l'horodatage par mot. Utilisez-le pour la mise en surbrillance de style karaoké ou une recherche qui saute à la seconde exacte.languageest le code de langue détecté. Vérifiez-le dans les tests ; une mauvaise langue est une défaillance courante sur les clips courts.inference_status.costindique le coût de l'appel. Consignez-le pour suivre les dépenses par fichier.
Étape 4 : l'appeler depuis Python
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
Définissez un délai d'attente long. Une heure complète de parole dense peut générer environ 20 000 jetons de sortie, et la carte de modèle avertit que les tâches longues prennent du temps.
DeepInfra liste également un onglet « OpenAI Speech-to-Text » pour le modèle, donc le code du SDK OpenAI qui appelle audio.transcriptions peut probablement pointer vers l'URL de base compatible OpenAI de DeepInfra. Vérifiez cet onglet pour l'URL de base exacte avant de basculer le code de production.
Prompts : verbatim, propre, locuteurs, jargon
Ce qui distingue Nemotron 3.5 Transcribe des anciennes API ASR, c'est qu'il accepte des instructions. Les prompts recommandés par NVIDIA, tels que listés sur la page DeepInfra :
| Vous voulez | Instruction |
|---|---|
| Mots verbatim | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| Texte lisible | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| Vocabulaire du domaine | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| Qui a dit quoi | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| Traduction | Please translate the given speech to <target language>. |
Utilisez une température de 0 avec le raisonnement désactivé pour la transcription, la traduction et l'identification de la langue, et gardez le prompt système vide.
Les termes de contexte portent leurs fruits. NVIDIA rapporte que le WER de ContextASR-Bench passe de 3,33 % sans contexte à 1,71 % avec un contexte fin, et celui d'Earnings22 contextuel de 12,54 % à 9,58 %. Pour un appel de résultats, transmettez les noms d'entreprises, les tickers et les noms des dirigeants.
Consultez l'onglet du schéma d'entrée de DeepInfra pour le champ qui transporte l'instruction sur le point de terminaison natif. Sur un serveur auto-hébergé, l'instruction va dans le message de chat à côté de l'audio, comme montré dans notre guide d'installation locale.
Utiliser OpenRouter à la place
Si vous utilisez déjà OpenRouter pour les LLM, vous pouvez conserver une seule clé et une seule facture. L'ID du modèle est nvidia/nemotron-3.5-transcribe, au prix de 0,000033 $ par seconde, avec DeepInfra comme seul fournisseur listé le 29 octobre 2026 (100 % de disponibilité, environ une seconde de latence à ce moment-là). Copiez le format de requête depuis l'onglet API du modèle sur OpenRouter, car les points de terminaison audio diffèrent des complétions de chat.
Le compromis : OpenRouter ajoute un saut réseau, et aujourd'hui il n'y a pas de basculement de fournisseur car un seul fournisseur sert le modèle.
Garder les coûts prévisibles
- Coupez d'abord le silence. Vous payez par minute d'audio, pas par minute de parole. Couper les silences des enregistrements réduit la facture.
- Convertissez en mono et rééchantillonnez. Le mono 16 kHz est ce que le modèle utilise de toute façon ; envoyer du stéréo 48 kHz ne fait qu'ajouter du temps de téléversement.
- Traitez par fichier, pas par morceau. Le modèle gère une heure en une seule requête. Diviser un fichier en morceaux de 30 secondes casse les étiquettes de locuteur et le contexte.
- Consignez
inference_status.cost. Additionnez-le par client ou par tâche. - Auto-hébergez au-dessus d'un volume régulier. Le NIM optimisé de NVIDIA traite jusqu'à 2 238 secondes d'audio par seconde sur une RTX PRO 6000 Blackwell. Si vous transcrivez des milliers d'heures par mois, un GPU loué bat la tarification à la minute. Notez que la voie vLLM open source devrait être environ deux fois plus lente que ce chiffre NIM.
Laissez votre agent de codage le tester avec Apidog CLI
Les API de transcription échouent silencieusement : un 200 avec un text vide, un clip espagnol détecté comme portugais, ou words manquant après une mise à jour du fournisseur. Au lieu de vérifier le JSON à la main, laissez votre agent de codage écrire et exécuter les vérifications avec Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez à votre agent un prompt :
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
L'agent lit le schéma, valide sa charge utile, écrit les cas et les exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Ajoutez -r junit et la même commande devient une porte CI. Voir Apidog CLI dans un pipeline CI/CD et Apidog CLI dans Claude Code pour la configuration complète.
FAQ
Quel est le prix de l'API Nemotron 3.5 Transcribe ? 0,002 $ par minute sur DeepInfra et 0,000033 $ par seconde sur OpenRouter, en date du 29 octobre 2026. Cela représente environ 0,12 $ par heure d'audio sur l'un ou l'autre.
Existe-t-il une clé API gratuite ? Nous n'en avons pas trouvé. Le modèle n'est pas encore sur build.nvidia.com. Les voies gratuites sont le Space de démo de NVIDIA et l'auto-hébergement ; voir le guide gratuit.
Quelle est la longueur maximale d'un fichier ? Une heure par requête, avec un contexte de 65 536 jetons.
L'API diffuse-t-elle les résultats en flux ? Non. C'est un modèle hors ligne qui renvoie la transcription lorsque le fichier est terminé.
Quelles langues sont prises en charge ? 40, classées en trois niveaux. Les 13 langues « leaders » incluent l'anglais, l'espagnol, le français, l'allemand, l'italien, le portugais, l'hindi, le coréen, le russe et le polonais. Le japonais, le turc et l'ukrainien sont « prêts pour la production ». Le chinois mandarin et l'arabe sont « pris en charge ».
Comment se compare-t-il aux autres API vocales ? Voir notre classement des meilleurs modèles de reconnaissance vocale open source et l'ancien récapitulatif des meilleures API de synthèse vocale et de reconnaissance vocale.
Commencez à transcrire
Obtenez une clé DeepInfra, envoyez un curl avec un MP3, et vous obtiendrez en retour un texte horodaté et étiqueté par langue pour 0,002 $ la minute. Ajoutez des termes de contexte pour votre domaine, utilisez le prompt de locuteur pour les réunions, et faites exécuter à votre agent des vérifications Apidog à chaque version afin qu'une régression silencieuse ne soit jamais livrée.