
Mistral s'était fait discret sur le segment haut de gamme pendant un certain temps. Mistral Large 3 a été lancé en décembre 2025, et depuis lors, la discussion sur la frontière des modèles open-weight a tourné autour de Kimi, DeepSeek, GLM et Qwen. Le 6 octobre 2026, Mistral a répondu avec Mistral Large 4, un modèle de 1 000 milliards de paramètres que l'équipe surnomme « Le Chonk ».
Le chiffre phare est une référence en cybersécurité où Large 4 obtient 82 %, tandis que Claude Opus 5.5 et GPT-6 Astra obtiennent un score proche de zéro. C'est vrai, c'est sur la page de lancement de Mistral, et cela nécessite une phrase de contexte avant de le partager. Cet article vous donne ce contexte, les spécifications, le prix réel, et les domaines où Large 4 est encore en retrait.
En bref
- Qu'est-ce que c'est : un modèle de type « mixture-of-experts » de 1,05 T paramètres avec 49 milliards de paramètres actifs, un encodeur de vision de 1,6 milliard, une entrée texte et image, et une fenêtre de contexte d'un million de tokens.
- Où l'obtenir : en avant-première publique sur l'API Mistral dès aujourd'hui sous le nom
mistral-large-4. Les poids du modèle « d'ici la fin du mois », soit autour du 27 octobre. - Prix : 1,36 $ en entrée / 4,18 $ en sortie par million de tokens au prix catalogue, actuellement affiché à **0,68 $ / 2,09 $** pendant la prévisualisation. L'entrée mise en cache est de 0,07 $.
- La victoire en cybersécurité : 82 % au test de reproduction de vulnérabilités de l'indice AA Cyber. Opus 5.5 et Astra obtiennent un score proche de zéro **parce qu'ils refusent la tâche**, et non parce qu'ils échouent.
- La véritable défaite : en évaluation humaine de codage, Claude Opus 5 a obtenu 4,22 et Large 4 a obtenu 3,74.
Pourquoi « Mistral est de retour » est justifié
Pendant la majeure partie de 2026, les modèles open-weight les plus performants provenaient de Chine. Mistral a continué à proposer des modèles, avec Medium 3.5, Devstral 2 et Small 4, mais rien qui puisse rivaliser avec les modèles fermés de pointe sur leur propre terrain.
Large 4 change la donne. Mistral affirme qu'il « surpasse significativement tout modèle open-weight développé aux États-Unis ou en Europe », et appuie cette affirmation avec un récit de formation conçu pour le public soucieux de la souveraineté de l'UE. Le modèle a été entraîné de zéro sur 3 800 GPU NVIDIA Grace Blackwell dans les centres de données européens de Mistral, couvre plus de 160 langues, y compris toutes les langues officielles de l'UE, et arrive quelques semaines après un tour de table de série D de 3 milliards d'euros que Mistral qualifie de plus grand tour de capital jamais levé par une entreprise technologique européenne.
Le timing compte aussi. Large 4 est arrivé juste après que Reflection a dévoilé son modèle open-weight Beam, de sorte que la course aux modèles ouverts entre les États-Unis et la Chine compte désormais un troisième concurrent sérieux.
Le titre sur la cybersécurité, et la nuance
Voici le résultat que tout le monde capture d'écran. L'indice Cyber d'Artificial Analysis comprend un test qui demande à un modèle de reproduire une vulnérabilité réelle dans un logiciel open-source, puis de la corriger. Mistral affirme que Large 4 obtient **82 %, le score le plus élevé de tous les modèles**.
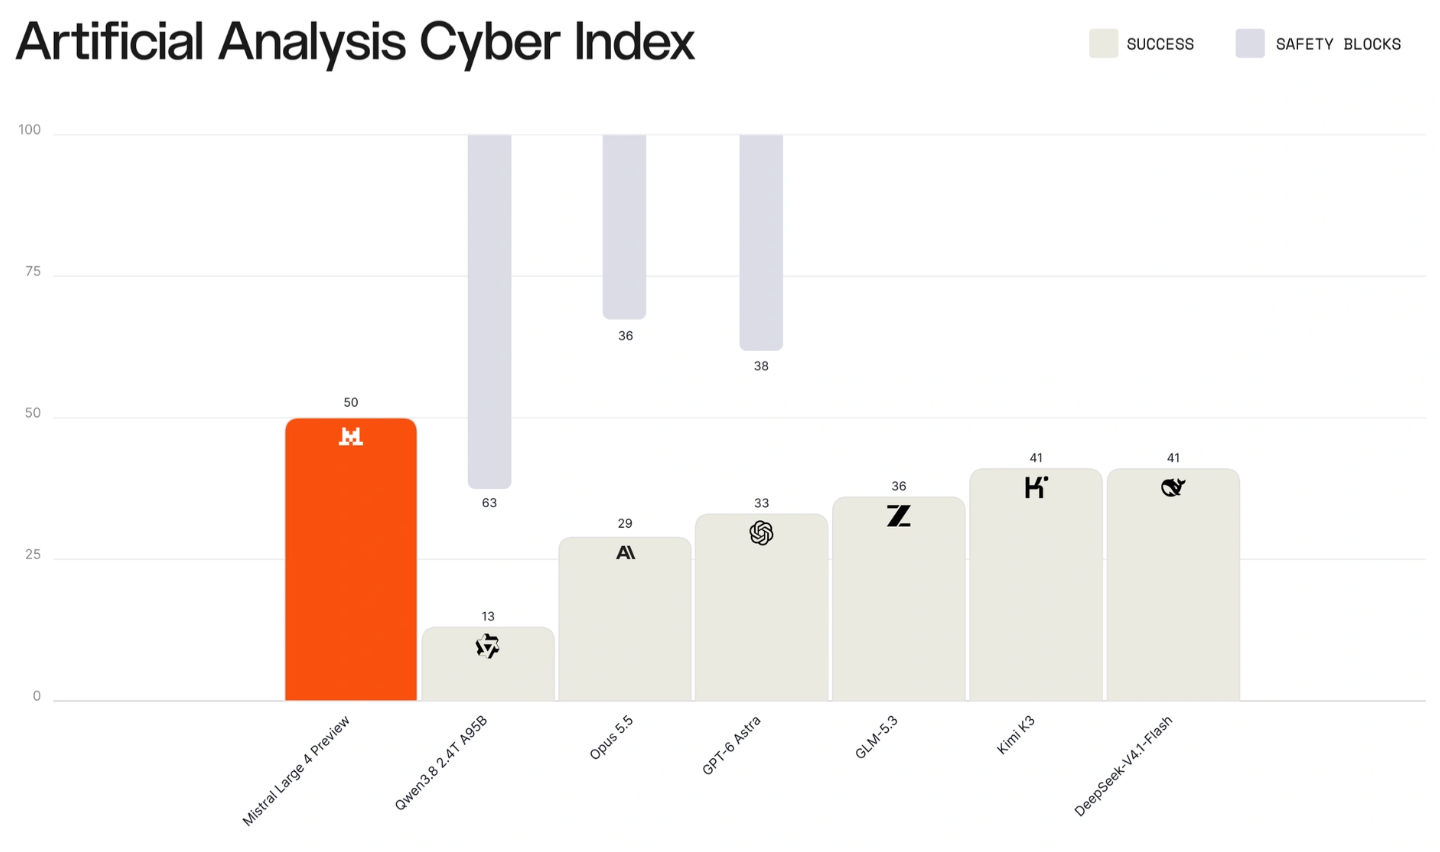
Puis la nuance, selon les propres mots de Mistral : « Plusieurs modèles fermés de premier plan, dont Claude Opus 5.5 et GPT-6 Astra, obtiennent un score proche de zéro sur le même test car ils refusent d'effectuer la tâche. »
Alors lisez-le de cette façon :
| Affirmation | Ce que cela signifie réellement |
|---|---|
| « Large 4 bat Astra et Opus 5.5 en cybersécurité » | Sur ce test précis, les modèles fermés refusent de répondre. Large 4 répond et réussit généralement. |
| « Large 4 est le meilleur modèle de piratage » | Non établi. Un refus est un choix politique, pas un plafond de capacité. |
| « Large 4 est dangereux » | Également non établi. Mistral signale que son taux de refus moyen sur les requêtes cyber de JailbreakBench, StrongREJECT et AgentHarm est plus élevé que celui de tout autre modèle open-weight. |
Il y a une réelle capacité derrière ce titre. Large 4 résout également 93 % de Cybench, un ensemble de 40 exercices de capture du drapeau, que Mistral considère comme l'un des scores les plus élevés rapportés pour un modèle open-weight. Sur le benchmark de sécurité des agents B3, il résiste à 93,3 % des attaques.
Pour les équipes de sécurité, cette combinaison est la véritable histoire : un modèle que vous pouvez auto-héberger qui aidera à reproduire et à corriger une CVE dans votre propre code, tout en refusant la plupart des requêtes clairement nuisibles. Pour les équipes API, c'est un outil utile à avoir sur votre propre matériel plutôt que derrière le filtre de politique de quelqu'un d'autre.
Où Large 4 bat GPT-6 Astra en dehors de la cybersécurité
Le résultat en cybersécurité est le plus retentissant. Deux autres victoires contre Astra sont plus discrètes et plus significatives, car les deux modèles ont réellement tenté la tâche :
| Benchmark | Mistral Large 4 | GPT-6 Astra | Notes |
|---|---|---|---|
| Dense 200 (ancrage visuel) | 42% | 41% | Un point d'avance. Réel, mais étroit. |
| Finance Agent v2 (vals.ai) | Devant | Derrière | Mistral rapporte le classement, pas les scores. |
| Benchmark d'agent juridique Harvey | Meilleur modèle ouvert | Listé | Aucun chiffre de comparaison directe publié. |
Contre d'autres modèles ouverts, l'écart est plus grand :
| Benchmark | Mistral Large 4 | Qui il bat |
|---|---|---|
| AutomationBench (657 workflows) | 59,9% | Kimi K3, DeepSeek V4 Pro |
| AA-Briefcase (travail de connaissance) | 1 393 Elo | DeepSeek V4 Pro |
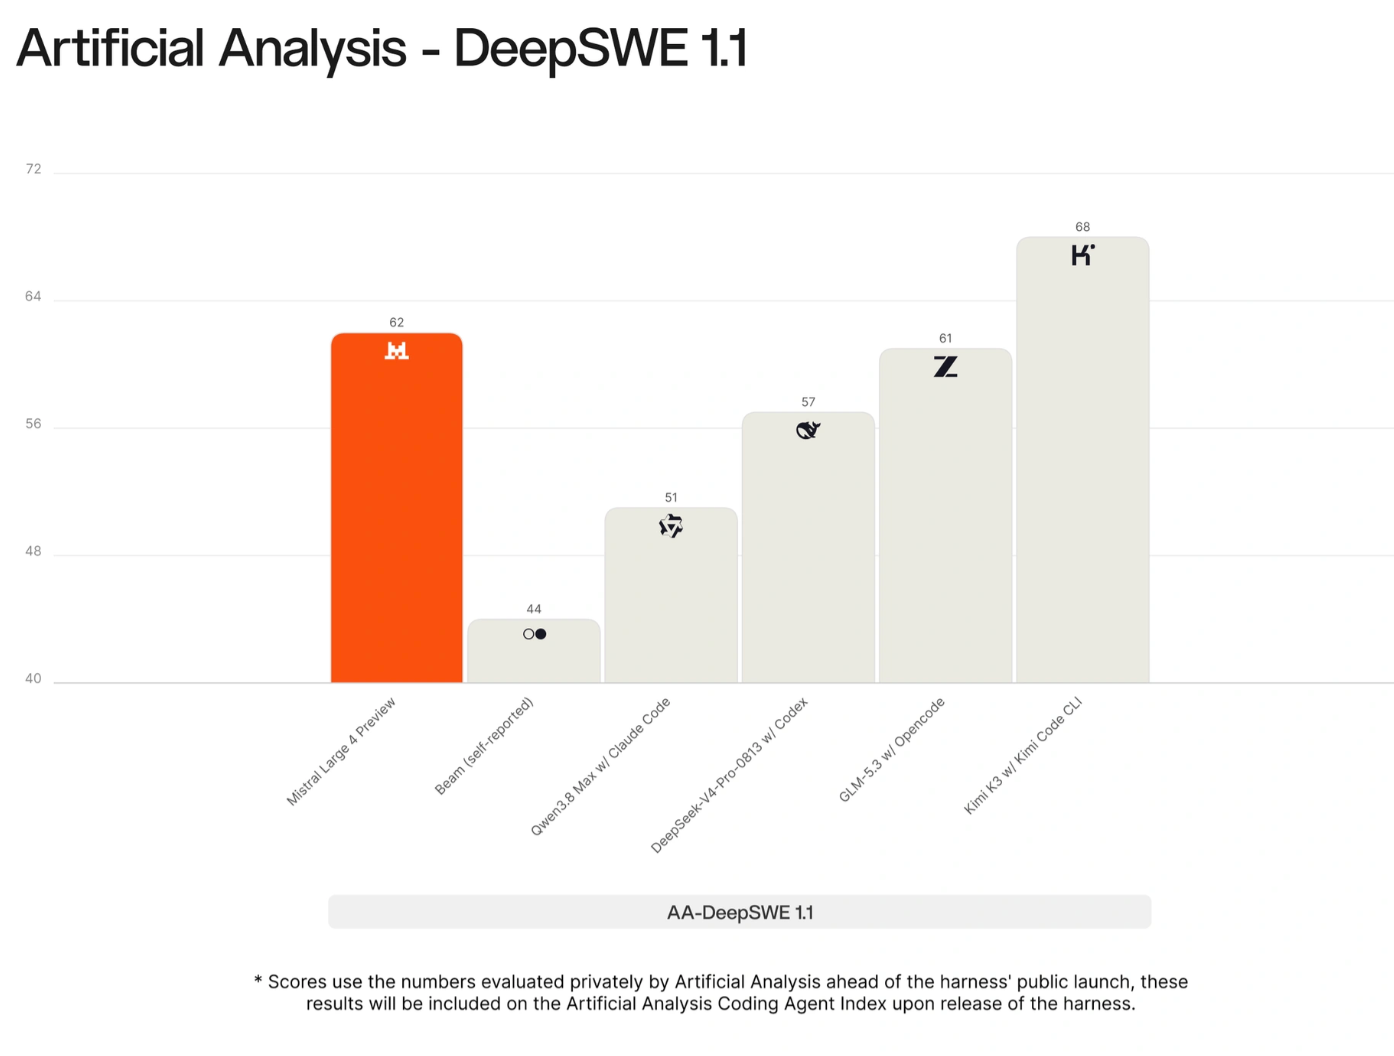
| DeepSWE v1.1 (codage) | 61,7% | Mène les modèles open-weight |
| SWE-Atlas-QnA | 59,4% | |
| Terminal-Bench 4.0 | 28,3% |
Tous ces chiffres proviennent de Mistral et concernent des modèles en prévisualisation. Aucun laboratoire indépendant ne les a encore réexécutés, et Euronews rapporte que l'apprentissage par renforcement était encore en cours de finalisation au moment du lancement. Traitez-les comme un signal fort, pas comme un verdict.
Où il est encore en retrait
Mistral a publié un résultat où un modèle fermé l'emporte clairement. Dans une évaluation humaine de la qualité de codage menée par Surge AI sur cinq modèles, Large 4 Preview s'est classé deuxième :
| Modèle | Score de codage humain (sur 5) |
|---|---|
| Claude Opus 5 | 4,22 |
| Mistral Large 4 Preview | 3,74 |
| GLM-5.3 | 3,60 |
| Kimi K3 | 3,59 |
| GLM-5.2 | 3,40 |
C'est une victoire nette sur les meilleurs modèles ouverts chinois, et un écart d'un demi-point derrière Claude. La formulation de Mistral est que Large 4 « comble l'écart » avec les modèles de pointe en codage, ce qui est une lecture honnête.
Manquant également : aucune comparaison avec Claude Fable 5.1 ou GPT-6 Sol n'est présente dans les documents de lancement. Si quelqu'un vous dit que Large 4 bat Fable, demandez le benchmark.
Spécifications en un coup d'œil
| Spécification | Mistral Large 4 |
|---|---|
| ID du modèle API | mistral-large-4 (alias mistral-large-4-0) |
| Version | 26.10, prévisualisation publique |
| Architecture | Mixture-of-experts, hybride instructif + raisonnement |
| Paramètres | 1,05 T au total, 49 milliards actifs, encodeur de vision de 1,6 milliard |
| Fenêtre de contexte | 1 million de tokens |
| Entrée | Texte, images |
| Raisonnement | paramètre reasoning_effort ("high" ou "none") |
| Outils | Appel de fonctions, sorties structurées, outils d'agent intégrés |
| Endpoints | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| Poids | Ouverts, d'ici fin octobre 2026 ; licence non encore publiée |
Prix : le modèle de pointe le moins cher que vous pouvez appeler aujourd'hui
C'est la partie qui devrait attirer l'attention des équipes API. La page de tarification de Mistral indique Large 4 à la moitié de son prix catalogue pendant la prévisualisation :
| Modèle | Entrée / 1M | Sortie / 1M | Poids ouverts |
|---|---|---|---|
| Mistral Large 4 (prix prévisualisation) | 0,68 $ | 2,09 $ | Oui, fin octobre |
| Mistral Large 4 (prix catalogue) | 1,36 $ | 4,18 $ | Oui, fin octobre |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | Non |
| GPT-6 Astra | 10,00 $ | 50,00 $ | Non |
Au prix de prévisualisation, la sortie de Large 4 coûte environ un vingt-quatrième de celle d'Astra. Même au prix catalogue, elle est environ 12 fois moins chère en sortie. L'entrée mise en cache tombe à 0,07 $ par million, ce qui est important pour les agents qui renvoient la même instruction système et les mêmes définitions d'outils à chaque tour.
Mistral n'a pas précisé quand la remise de prévisualisation prend fin, il est donc préférable de prévoir le budget en fonction du prix catalogue.
Devriez-vous changer ?
Essayez-le maintenant si :
- Vous exécutez des workflows d'agent ou d'automatisation du travail de connaissance et payez des prix de pointe. AutomationBench et AA-Briefcase suggèrent que Large 4 est compétitif ici pour une fraction du coût.
- Vous avez besoin d'une sortie multilingue dans toutes les langues de l'UE ou d'une inférence hébergée dans l'UE pour des raisons de conformité.
- Vous effectuez des travaux de sécurité défensive et rencontrez constamment des refus lors de la reproduction légitime de vulnérabilités.
- Vous voulez un modèle de pointe que vous pourrez auto-héberger dans quelques semaines.
Attendez si :
- La qualité du code est votre principale métrique. Claude est toujours en tête pour le codage évalué par des humains.
- Vous avez besoin de chiffres que vous pouvez défendre lors d'un examen. Attendez les benchmarks indépendants après la publication des poids.
- Vous utilisez Large 3 en production. La prévisualisation peut encore changer, et Mistral n'a pas encore publié d'ID versionné stable.
Comment tester Large 4 contre vos propres API dans Apidog
Les benchmarks vous indiquent les performances d'un modèle sur les tâches de quelqu'un d'autre. La façon la plus rapide de décider est d'exécuter Large 4 sur vos propres prompts et de le comparer avec le modèle que vous utilisez aujourd'hui. Apidog gère cela sans une ligne de code intermédiaire :
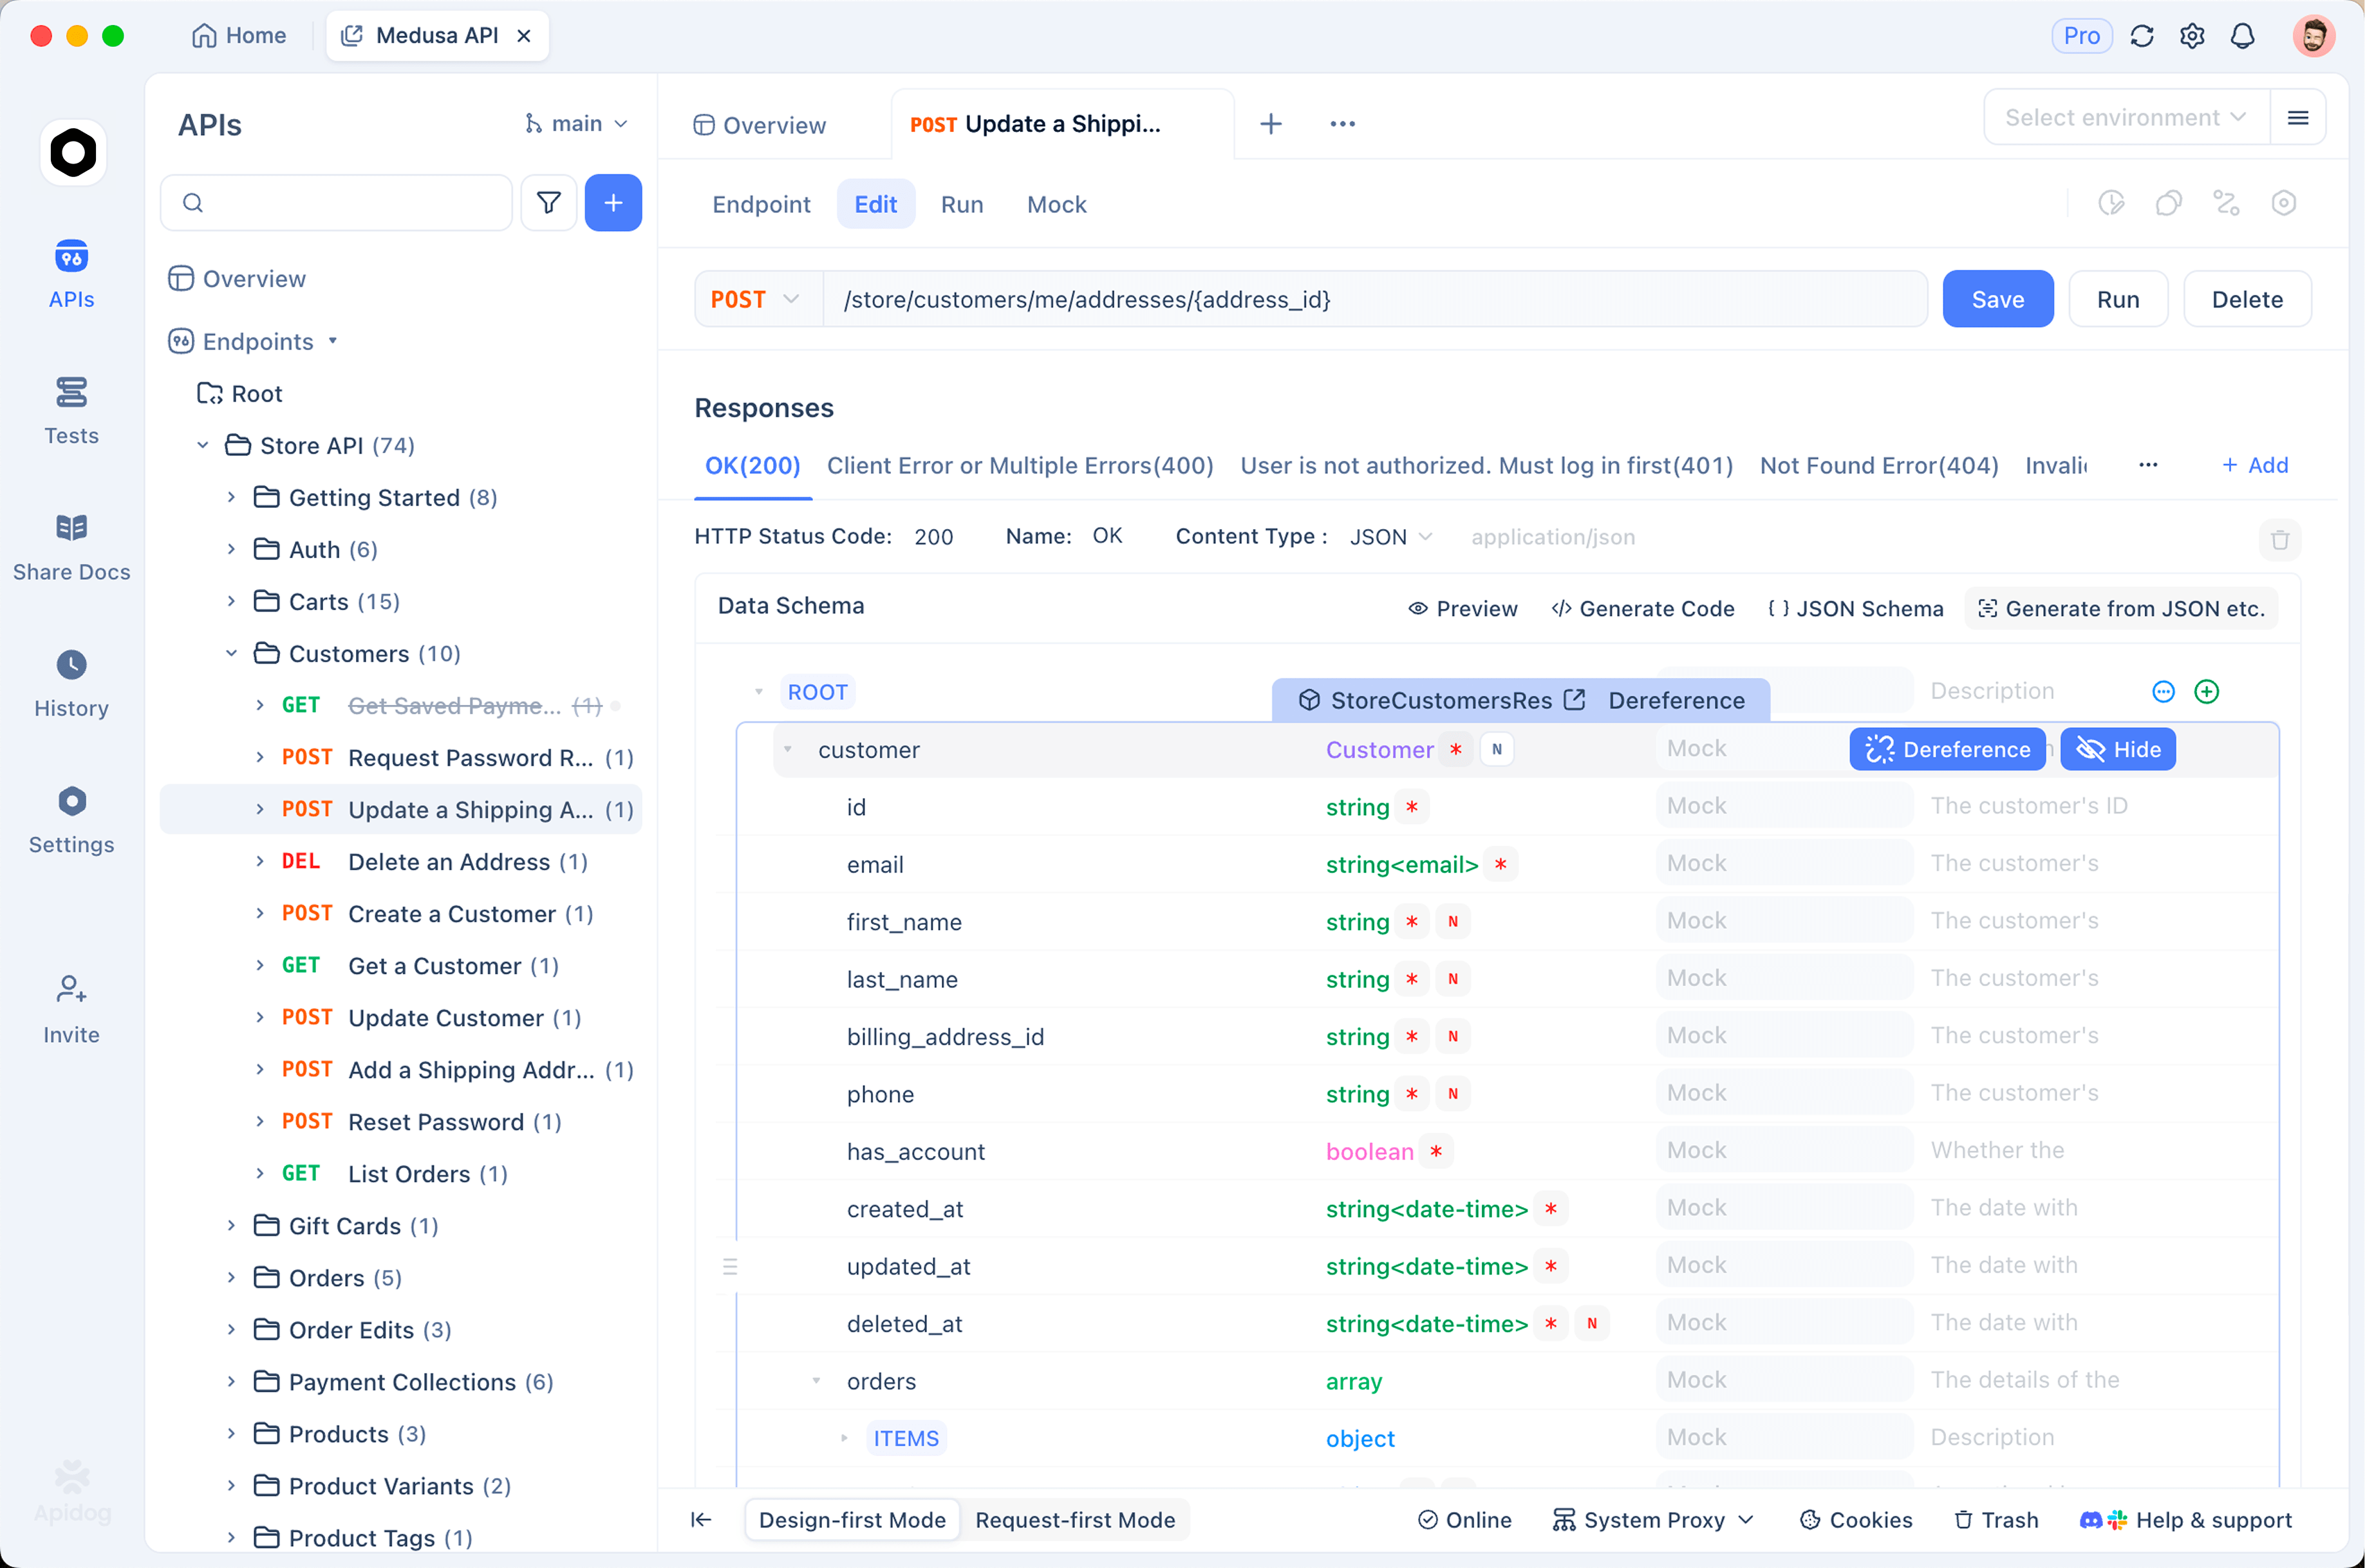
- Enregistrez la requête une fois. Créez
POST https://api.mistral.ai/v1/chat/completions, stockez votre clé en tant que variable d'environnement, et définissezAuthorization: Bearer {{MISTRAL_API_KEY}}. - Clonez-le par modèle. Dupliquez la requête, modifiez uniquement le champ
model(mistral-large-4vs. votre modèle actuel), et envoyez les deux. Apidog affiche la réponse, le statut, la latence et la taille côte à côte, et le blocusagevous donne le nombre de tokens pour une comparaison des coûts. - Ajoutez des assertions. Vérifiez un statut
200, une réponse non vide et une correspondance de schéma JSON si vous demandez une sortie structurée. Cela transforme une expérience ponctuelle en un test de régression. - Réexécutez-le à chaque mise à jour du modèle. Regroupez les requêtes dans un scénario de test et réexécutez-le lorsque Mistral met à jour la prévisualisation ou publie les poids. Vous verrez si la qualité a dérivé avant vos utilisateurs.
Deux atouts de Large 4 s'intègrent naturellement au travail API. Ses résultats en sécurité en font un bon second relecteur pour les tests de sécurité API, par exemple lorsque vous reproduisez un contournement d'authentification dans votre propre API de staging. Ses fonctions d'appel et ses sorties structurées vous permettent de transformer une spécification OpenAPI conçue dans Apidog en définitions d'outils qu'un agent peut appeler.
Pour un aperçu complet du code, y compris les clés, les blocs de raisonnement, les images, l'appel de fonctions et le calcul des coûts, consultez notre guide API Mistral Large 4. Vous venez d'un ancien modèle Mistral ? Les bases de l'API Mistral AI et le guide API Mistral Medium 3.5 s'appliquent toujours : même URL de base, même authentification, nouvel ID de modèle.
FAQ
Mistral Large 4 est-il open source ? Il est open-weight. Mistral indique que les poids seront publiés d'ici fin octobre 2026. La licence n'a pas encore été publiée, ne supposez donc pas qu'elle corresponde à l'Apache 2.0 de Large 3.
Mistral Large 4 bat-il vraiment GPT-6 Astra ? Sur l'ancrage visuel (42 % vs 41 %) et Finance Agent v2, oui, selon les chiffres de Mistral. Sur le test de vulnérabilité cyber, Astra obtient un score proche de zéro parce qu'il refuse, ce n'est donc pas une victoire comparable.
Batte-t-il Claude ? Pas sur le codage. Claude Opus 5 mène l'évaluation humaine du codage avec 4,22 contre 3,74. Claude Opus 5.5 refuse également la tâche de reproduction cyber, c'est pourquoi il obtient un score proche de zéro dans ce cas.
Que signifie « Le Chonk » ? C'est le surnom officieux de Mistral pour le modèle, une blague sur sa taille. Le nom officiel est Mistral Large 4, ou ML4.
Puis-je l'utiliser gratuitement ? Le plan gratuit de Mistral inclut 10 $ par mois en crédits API et l'accès à ses derniers modèles dans Le Chat et Vibe. Au prix de prévisualisation, 10 $ permettent d'acheter environ 4,8 millions de tokens de sortie sur Large 4.
En résumé
Mistral est de retour dans la discussion de pointe. Large 4 est le modèle open-weight le plus puissant en dehors de la Chine selon les chiffres de Mistral, il coûte une fraction d'Astra ou d'Opus 5.5, et il fonctionnera sur votre propre matériel en quelques semaines. L'affirmation « bat Astra et Claude en cyber » est réelle mais provient de refus, et le verdict honnête en matière de codage est « deuxième après Claude ». Testez-le sur vos propres API dans Apidog dès maintenant tant que le prix de prévisualisation est en vigueur, et suspendez votre décision de production jusqu'à ce que les benchmarks indépendants arrivent après le 27 octobre.