
Les poids ouverts de Mistral Large 4 ont été publiés sur Hugging Face le 29 octobre 2026. Vous obtenez le même modèle de 1,05 T de paramètres que Mistral sert sur son API, sous une licence MIT modifiée, en checkpoints FP8 et NVFP4, plus des quants GGUF communautaires. Vous pouvez le télécharger sans étape d’approbation, le servir sur 8 GPU de datacenter avec vLLM ou SGLang, ou ignorer le matériel et appeler mistral-large-4 sur l’API Mistral pour 0,70 $ par million de tokens d’entrée.
Ci-dessous : ce qui a changé depuis l’aperçu du 6 octobre, les tailles de téléchargement, le matériel par voie et la licence. Pour la présentation du modèle, lisez notre analyse du lancement de Mistral Large 4 ; pour les formats de requête et le code SDK, consultez le guide de l’API Mistral Large 4.
Que sont les poids ouverts de Mistral Large 4 ?
Les poids ouverts de Mistral Large 4 sont les checkpoints téléchargeables du modèle phare de Mistral, surnommé « Le Chonk ». C’est un modèle multimodal à mélange d’experts d’environ 1,05 T de paramètres au total, environ 49 B actifs par token (52 B en comptant les embeddings et les couches de sortie), un encodeur visuel de 1,6 B et une fenêtre de contexte de 1 M de tokens, publié sous la licence Mistral Ecosystem Open-Weight License.
La fiche modèle officielle liste 72 couches de texte et 128 experts routés, avec 4 choisis par token plus 1 expert partagé.
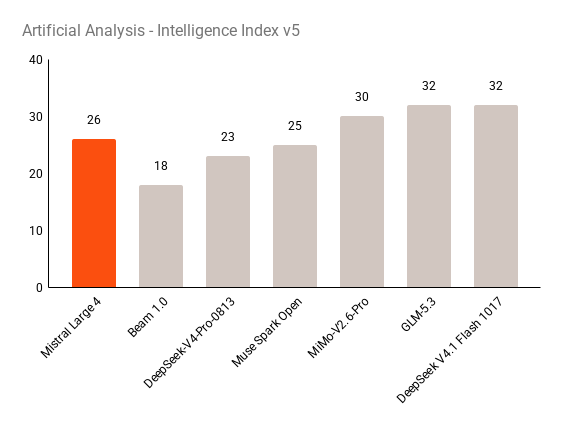
La publication n’est pas une copie figée de l’aperçu. L’annonce des poids ouverts de Mistral indique que le modèle a bénéficié de trois semaines supplémentaires d’apprentissage par renforcement axé sur le codage et la cybersécurité avant la sortie des poids.
Qu’est-ce qui a changé depuis l’aperçu du 6 octobre
Si vous avez testé Large 4 pendant l’aperçu, quatre éléments sont différents désormais.
| Domaine | Aperçu du 6 octobre | Publication ouverte du 29 octobre |
|---|---|---|
| Poids | API uniquement, poids promis plus tard | FP8 et NVFP4 sur Hugging Face, sans restriction |
| Modes de raisonnement | high ou none |
low, medium, high (par défaut high) ; low remplace none |
| Terminal-Bench 4.0 (rapporté par Mistral) | 28 % | 41 %, avec environ 30 % de tokens de sortie en moins |
| Résistance aux attaques de B3 Agent Security (rapporté par Mistral) | 93,3 % | 97,1 % |
| Prix API par million de tokens | Affiché avec une remise d’aperçu | 0,70 $ en entrée, 0,07 $ en entrée mise en cache, 2,10 $ en sortie |
Le changement de raisonnement casse le code. Si votre intégration d’aperçu envoie reasoning_effort: "none", remplacez-le par "low" : le billet de lancement sur Hugging Face note que Transformers exécute none en high, donc un réglage obsolète coûte des tokens au lieu d’échouer.
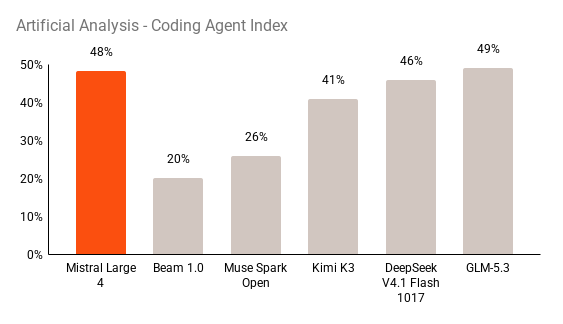
Tous les chiffres de benchmark dans ce billet sont rapportés par le fournisseur. Mistral affirme aussi 19,7 % sur le benchmark privé FrontierCode 2.0 de Cognition, le meilleur score en poids ouverts de son graphique, et 48 % sur l’Artificial Analysis Coding Agent Index, à peu près à égalité avec GLM-5.3. La réplication indépendante était encore en attente lorsque nous avons vérifié le 2 novembre.
Trois façons d’exécuter Mistral Large 4
Vous avez trois voies, et la bonne dépend de la quantité de matériel que vous contrôlez.
- Appelez l’API Mistral. ID du modèle
mistral-large-4, 0,70 $ en entrée, 0,07 $ en entrée mise en cache et 2,10 $ en sortie par million de tokens. Aucun GPU. - Utilisez un fournisseur hébergé. Mistral liste OpenRouter, des points de terminaison hébergés par NVIDIA et un conteneur NIM, ainsi que Microsoft Foundry, qui propose aussi des déploiements privés sur Azure.
- Auto-hébergez les poids. Téléchargez depuis Hugging Face et servez avec vLLM, SGLang, Transformers ou llama.cpp sur vos propres machines.
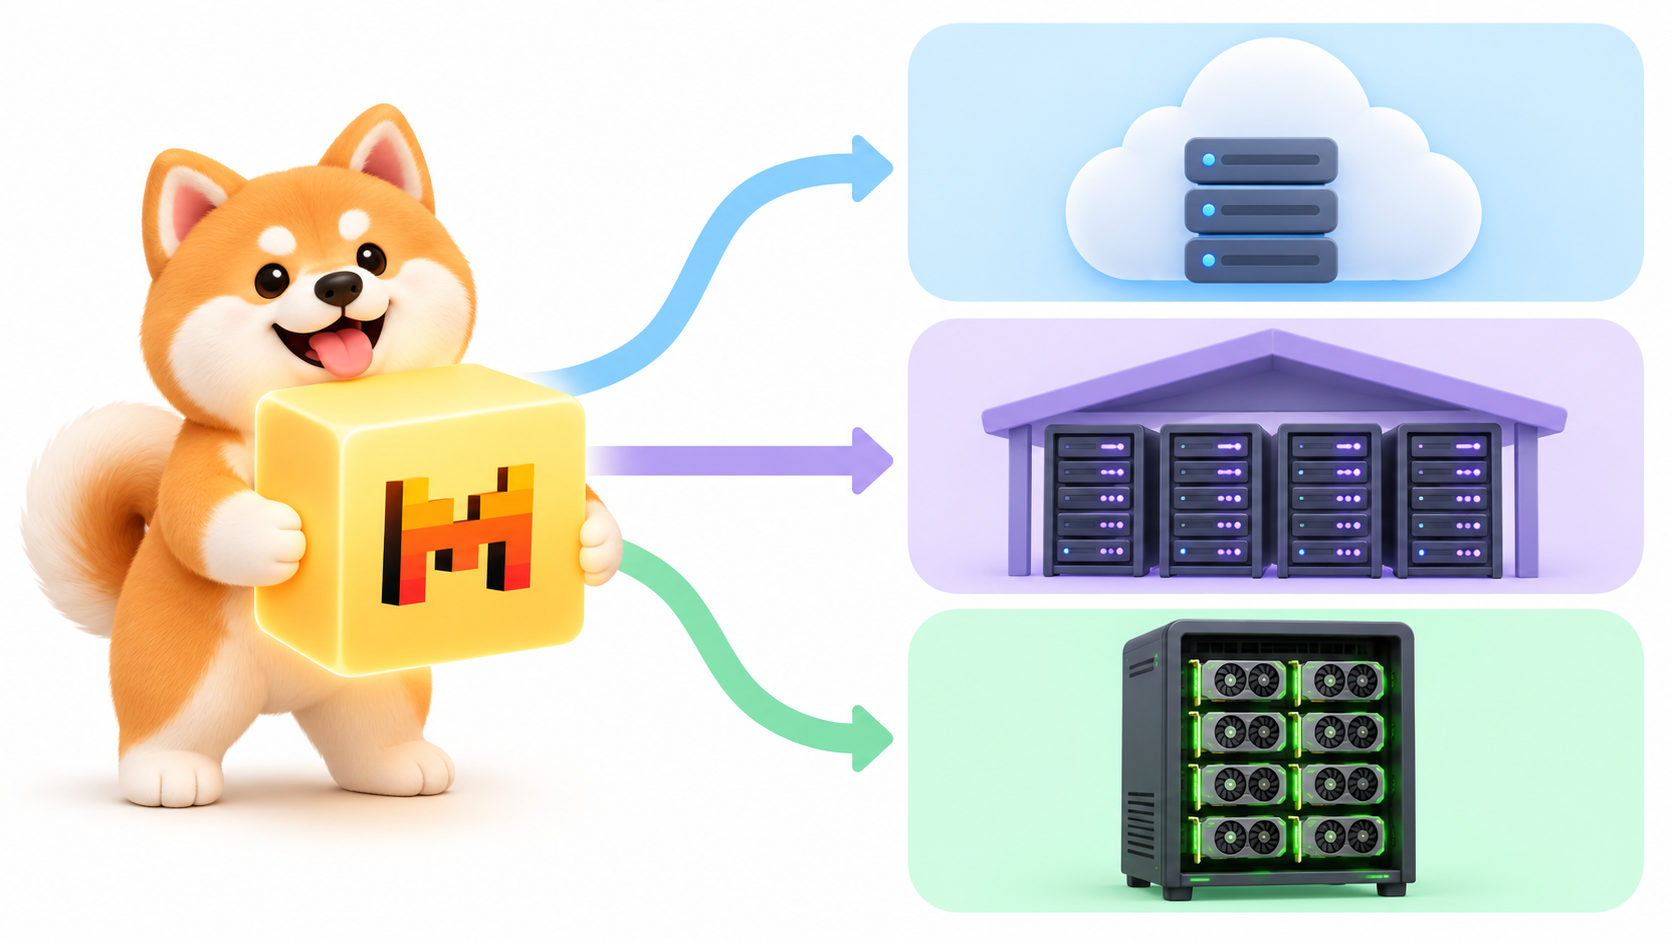
Commencez par la voie 1 ou 2. Passez à la voie 3 pour une raison concrète : des données qui ne peuvent pas quitter votre réseau, un fine-tuning que vous devez posséder, ou un volume qui garde un nœud de 8 GPU occupé.
Comment télécharger Mistral Large 4
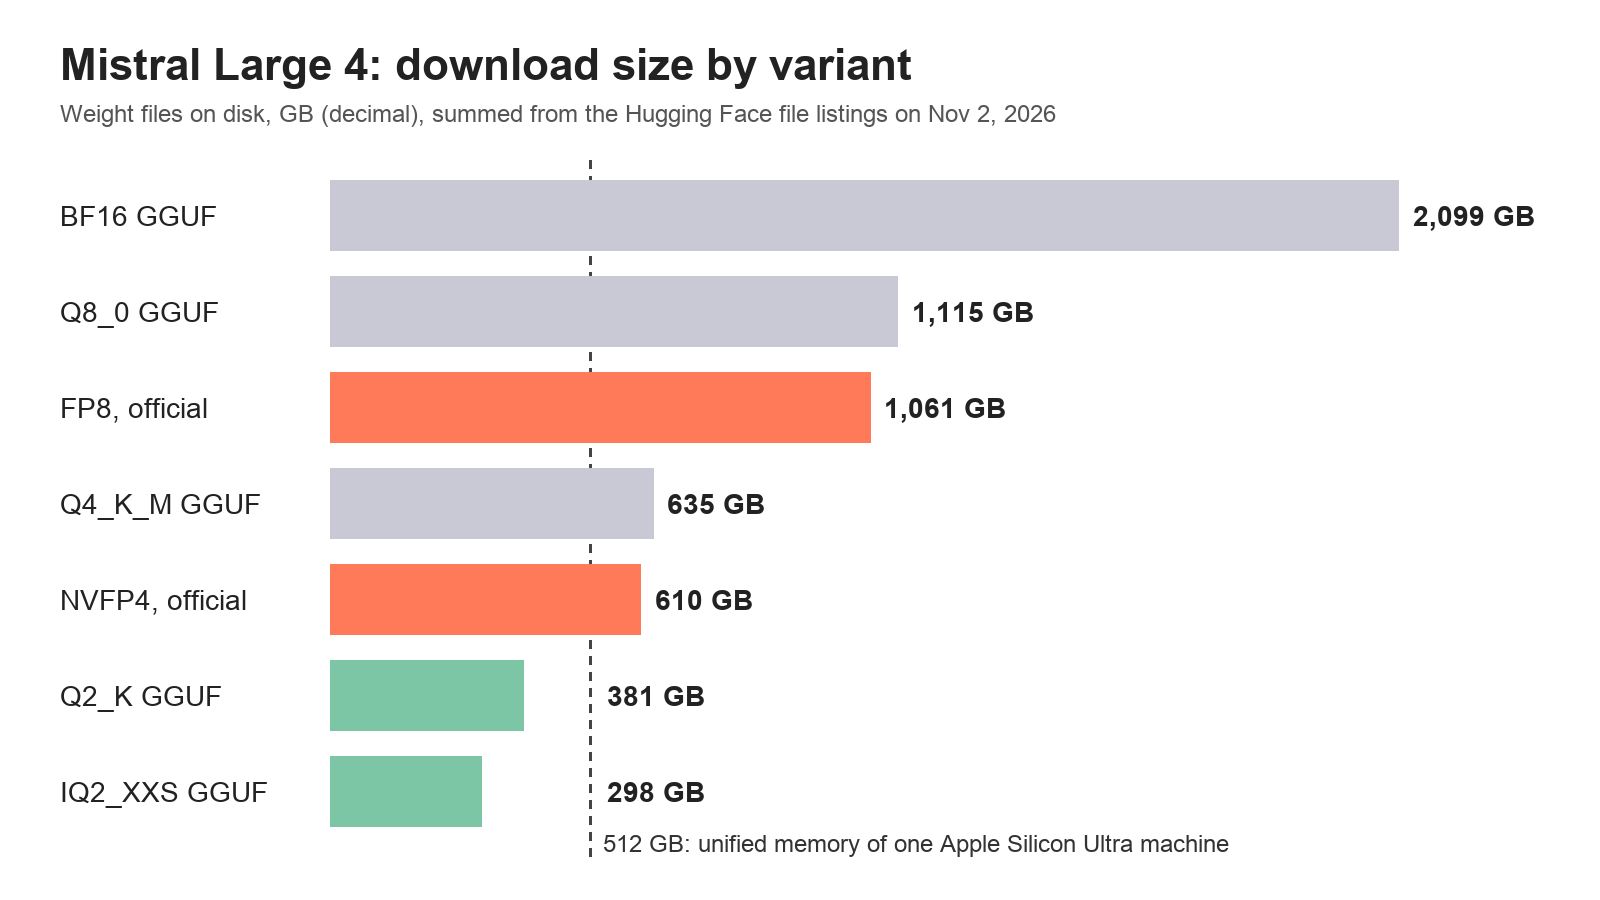
Les dépôts officiels ne sont pas soumis à restriction (l’API Hugging Face rapporte gated: false pour les deux), donc n’importe quel compte ou client anonyme peut les récupérer. La taille est la vraie barrière.
| Dépôt | Format | Taille sur disque |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, officiel | environ 1 061 Go |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, officiel | environ 610 Go |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | environ 1 115 Go |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | environ 635 Go |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | environ 381 Go |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | environ 298 Go |
Nous avons additionné ces valeurs à partir de la liste des fichiers de chaque dépôt le 2 novembre 2026. Unsloth publie aussi des quants GGUF sous unsloth/Mistral-Large-4-1T-A52B-GGUF.
Téléchargez uniquement les fichiers dont vous avez besoin avec la CLI Hugging Face :
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
Le téléchargement FP8 prend un peu plus de deux heures à 1 Gbps soutenu.
Comment auto-héberger Mistral Large 4
Chaque exemple de service officiel suppose un nœud avec 8 GPU et un parallélisme tensoriel de 8. Voici ce que chaque moteur attend.
| Moteur | Checkpoint | Matériel dans les exemples officiels |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8 ; Hugging Face Inference Endpoints utilisent 8x H200 |
| vLLM | NVFP4 | 8 GPU NVIDIA Blackwell |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU via torchrun |
| llama.cpp | Q2_K GGUF | Une machine Apple Silicon Ultra avec 512 Go de mémoire unifiée |
vLLM
La fiche modèle recommande vLLM et fournit une image Docker dédiée :
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Conservez les deux flags de parseur, sinon le texte de réflexion arrive dans content et les appels d’outils arrivent en texte brut. Pour un décodage plus rapide, la fiche documente un décodeur spéculatif DSpark optionnel : ajoutez --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
Sur 8x H200 avec ce décodeur spéculatif, Hugging Face a mesuré environ 65 tokens par seconde pour une requête et environ 480 tokens par seconde au total sur 1 000 conversations ShareGPT en charge.
SGLang fonctionne aussi : l’exemple sglang serve de la fiche modèle utilise --tp-size 8, --speculative-algorithm DSPARK et des parseurs de raisonnement et d’appels d’outils en auto.
llama.cpp sur un Mac
L’équipe llama.cpp a livré le support dès le jour 0. Le quant Q2_K (381 Go) tient sur une machine Apple Silicon Ultra avec 512 Go de mémoire unifiée :
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face rapporte environ 90 tokens par seconde en prefill et 15 en génération sur un M3 Ultra : correct pour des expériences privées, lent pour une boucle d’agent. Un quant 2 bits perd aussi en qualité, donc testez-le d’abord sur vos propres tâches.
L’échantillonnage recommandé par Mistral est temperature=1.0 et top_p=0.95 à chaque niveau de raisonnement.
Appeler votre modèle auto-hébergé
vLLM et SGLang exposent tous deux un serveur compatible OpenAI, donc la requête ressemble à n’importe quelle complétion de chat :
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Sur l’API hébergée, envoyez le même corps à https://api.mistral.ai/v1/chat/completions avec "model": "mistral-large-4" et une clé Bearer. La documentation du serveur compatible OpenAI de vLLM liste les champs qu’il accepte.
Laissez Claude Code tester les deux points de terminaison avec Apidog CLI
Un modèle auto-hébergé échoue silencieusement : un flag de parseur manquant fait fuiter le raisonnement dans content, ou un appel d’outil revient en texte brut. Laissez votre agent de codage vérifier les deux voies avec Apidog CLI au lieu de coller des commandes curl à la main.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Ensuite, donnez un prompt à Claude Code :
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
L’agent lit chaque schéma, valide sa charge utile et exécute le cas :
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Ajoutez --upload-report pour voir l’exécution dans l’application Apidog, ou placez la même ligne apidog run ... -r junit dans la CI pour qu’une mise à niveau de vLLM ne puisse pas être livrée avec des appels d’outils cassés. Notre guide Apidog CLI dans Claude Code couvre la configuration plus en détail. Le plan Free d’Apidog couvre jusqu’à 4 utilisateurs.
La licence : ce que vous pouvez et ne pouvez pas faire
La Mistral Ecosystem Open-Weight License est une licence MIT avec une condition ajoutée.
Vous pouvez : exécuter, déployer, affiner et modifier le modèle et ses dérivés, à des fins commerciales et non commerciales, tant que vous conservez l’avis de droit d’auteur et d’autorisation dans les copies.
Vous avez besoin d’une licence commerciale distincte de Mistral si : vous l’exécutez en tant que « Model as a Service », ce que la licence définit comme donner à un tiers l’accès au modèle ou à ses dérivés pour l’inférence ou le post-entraînement.
Cette condition ne s’applique pas à : l’usage interne, les produits destinés aux utilisateurs finaux où le modèle se trouve à l’intérieur de fonctionnalités ou de harnais spécifiques, le simple relais de requêtes vers un modèle hébergé par quelqu’un d’autre, et l’utilisation via les produits de Mistral eux-mêmes.
Un assistant de codage interne ou une fonctionnalité produit construite sur le modèle est acceptable ; revendre de l’inférence brute nécessite un accord. Ceci est un résumé, pas un avis juridique.
Pour un tutoriel similaire sur un autre modèle à poids ouverts, consultez notre guide d’auto-hébergement de GLM-5.3.
Faut-il auto-héberger ou appeler l’API ?
Appelez l’API lorsque votre volume est modeste, que vous voulez le contexte de 1 M sans ajuster les limites du serveur, ou que vous n’exploitez pas déjà des nœuds de 8 GPU. À 0,70 $ en entrée et 2,10 $ en sortie par million de tokens, 100 millions de tokens d’entrée plus 20 millions de tokens de sortie par mois reviennent à 112 $, avant toute remise de mise en cache.
Auto-hébergez lorsque vos données ne peuvent pas quitter votre réseau, lorsque vous voulez posséder un fine-tuning (Hugging Face montre l’entraînement LoRA avec TRL sur un nœud 8x B300), ou lorsqu’un volume régulier garde un nœud occupé. Le service Forge de Mistral est l’option managée pour affiner sur vos propres données.
FAQ
Les poids ouverts de Mistral Large 4 sont-ils gratuits à télécharger ?
Oui. Les deux dépôts officiels sur Hugging Face sont sans restriction, donc vous pouvez les télécharger sans demander d’accès. Les exécuter est ce qui coûte : le checkpoint FP8 officiel fait environ 1 061 Go et les exemples de service utilisent 8 GPU de datacenter.
Puis-je exécuter Mistral Large 4 sur un seul GPU ?
Aucune recette officielle ne couvre un seul GPU. Chaque exemple vLLM, SGLang et Transformers utilise 8 GPU avec parallélisme tensoriel. La plus petite configuration documentée est llama.cpp avec le quant Q2_K de 381 Go sur une machine Apple Silicon Ultra avec 512 Go de mémoire unifiée.
Mistral Large 4 est-il open source ?
Il est à poids ouverts, pas open source au sens de l’OSI. Vous obtenez les poids sous une licence MIT modifiée qui autorise l’usage commercial, mais proposer le modèle à des tiers comme service d’inférence ou de post-entraînement nécessite une licence commerciale distincte de Mistral.
Le modèle à poids ouverts est-il le même que le modèle de l’API ?
Mistral indique que le checkpoint publié a bénéficié de trois semaines supplémentaires d’apprentissage par renforcement après l’aperçu du 6 octobre, et l’API sert le modèle mis à jour sous mistral-large-4. Les modes de raisonnement ont aussi changé : utilisez low, medium ou high.
Combien coûte l’API Mistral Large 4 ?
Mistral liste 0,70 $ par million de tokens d’entrée, 0,07 $ par million de tokens d’entrée mise en cache et 2,10 $ par million de tokens de sortie, au 2 novembre 2026.