MCP ou CLI : tout se résume au moment où votre agent paie pour un outil. Un serveur MCP envoie le nom, la description et le JSON Schema de chaque outil au modèle avant même que vous tapiez quoi que ce soit. Une CLI ne coûte rien tant que l'agent ne l'exécute pas et ne lit pas son --help ou sa sortie. Sur une configuration mesurée, quatre serveurs MCP courants ajoutaient 11 923 tokens de définitions d'outils ; la skill Apidog CLI en ajoutait 112.
Cet écart résume toute l'histoire derrière deux articles Dev.to cette semaine. Un développeur a tapé « Run tests » dans un agent de code et a vu 28 400 tokens d'entrée dès la première requête, sans fichiers joints ni historique. Le coupable : sept serveurs MCP. Un autre a soutenu que MCP est d'une simplicité enfantine à mettre en œuvre, et que les parties difficiles (authentification, approbations, appels en double) commencent juste après que la démo fonctionne.
Cet article se concentre sur une seule question : combien les définitions d'outils coûtent à votre fenêtre de contexte, et à quel moment une CLI appelée à la demande par l'agent coûte moins cher ? Si votre problème concerne plutôt les réponses d'outils volumineuses, lisez l'article complémentaire sur l'élagage des réponses API trop verbeuses.
Pourquoi les serveurs MCP consomment des tokens de la fenêtre de contexte
Un serveur MCP annonce ses outils via la méthode tools/list. Selon la spécification des outils MCP, chaque outil comporte un name, une description et un inputSchema (un JSON Schema pour ses arguments). Pour que le modèle choisisse un outil, le client doit intégrer ces définitions dans la requête. Dans une configuration classique, cela se produit à chaque tour de chaque conversation, que l'agent appelle l'outil ou non.
Le coût augmente donc avec trois facteurs :
- Le nombre d'outils. Une intégration GitHub complète peut exposer des dizaines d'outils.
- La profondeur des schémas. Les objets imbriqués, les énumérations et les longues descriptions deviennent autant de tokens.
- Les tours de conversation. Une boucle d'agent renvoie les définitions à chaque étape.
L'article de necoz donne des chiffres : une pile de 52 outils coûtait 24 600 tokens de schémas au tour 1, contre 640 tokens pour une configuration à 4 outils, et environ 246 000 tokens sur une boucle de 10 étapes. À prendre comme la mesure d'un développeur, pas comme un benchmark. Le prompt caching réduit le coût en dollars des définitions répétées, mais les tokens occupent toujours la fenêtre et concurrencent votre code pour l'attention du modèle.
Il y a aussi un coût en qualité. La documentation sur la recherche d'outils d'Anthropic indique qu'une configuration multi-serveurs avec GitHub, Slack, Sentry, Grafana et Splunk « peut consommer environ 55 000 tokens de définitions avant que Claude ne fasse le moindre travail », et que la précision de sélection d'outils de Claude se dégrade au-delà de 30 à 50 outils disponibles.
Tokens des définitions d'outils MCP : une mesure que vous pouvez reproduire
Le 16/11/2026, j'ai démarré cinq serveurs MCP localement via stdio, envoyé initialize et tools/list depuis un script Node de 30 lignes, et compté les tokens du name, de la description et de l'inputSchema de chaque outil.
Une précision d'emblée : j'ai compté avec l'encodage o200k_base de tiktoken d'OpenAI parce qu'il fonctionne hors ligne. Claude, Gemini et les autres modèles utilisent leurs propres tokenizers, vos comptes varieront donc dans une certaine marge. Ce sont les ratios entre configurations qui comptent ici.
| Serveur MCP (version) | Outils | Tokens de définitions | Moyenne par outil |
|---|---|---|---|
@playwright/mcp 0.0.85 |
25 | 4 634 | 185 |
@modelcontextprotocol/server-filesystem 2.3.0 |
16 | 3 281 | 205 |
@modelcontextprotocol/server-memory 2.1.1 |
9 | 2 013 | 224 |
@modelcontextprotocol/server-everything 2.3.0 |
16 | 1 995 | 125 |
| Ces quatre réunis | 66 | 11 923 | 181 |
apidog-mcp-server 0.0.18 |
3 | 291 | 97 |
Quatre serveurs ordinaires coûtaient environ 12 000 tokens avant même que l'agent ne lise un fichier.
La dernière ligne est le contre-exemple intéressant. Le serveur MCP d'Apidog expose trois outils très ciblés (lire la spécification OpenAPI du projet, lire les fichiers $ref, rafraîchir la spécification), d'où un coût de 291 tokens. C'est le nombre d'outils et la profondeur des schémas qui font la facture, pas le protocole.
Côté CLI, j'ai mesuré ce qu'un agent lit réellement quand il utilise Apidog CLI 2.2.12 :
| Texte de la CLI | Quand il entre dans le contexte | Tokens |
|---|---|---|
| Description de la skill Apidog CLI (frontmatter) | À chaque session, dans la liste des skills | 112 |
| Corps de la skill Apidog CLI | Uniquement si la tâche correspond | 1 189 |
apidog --help |
Uniquement si l'agent l'exécute | 668 |
apidog test-case --help |
Uniquement si l'agent l'exécute | 511 |
apidog run --help |
Uniquement si l'agent l'exécute | 1 036 |
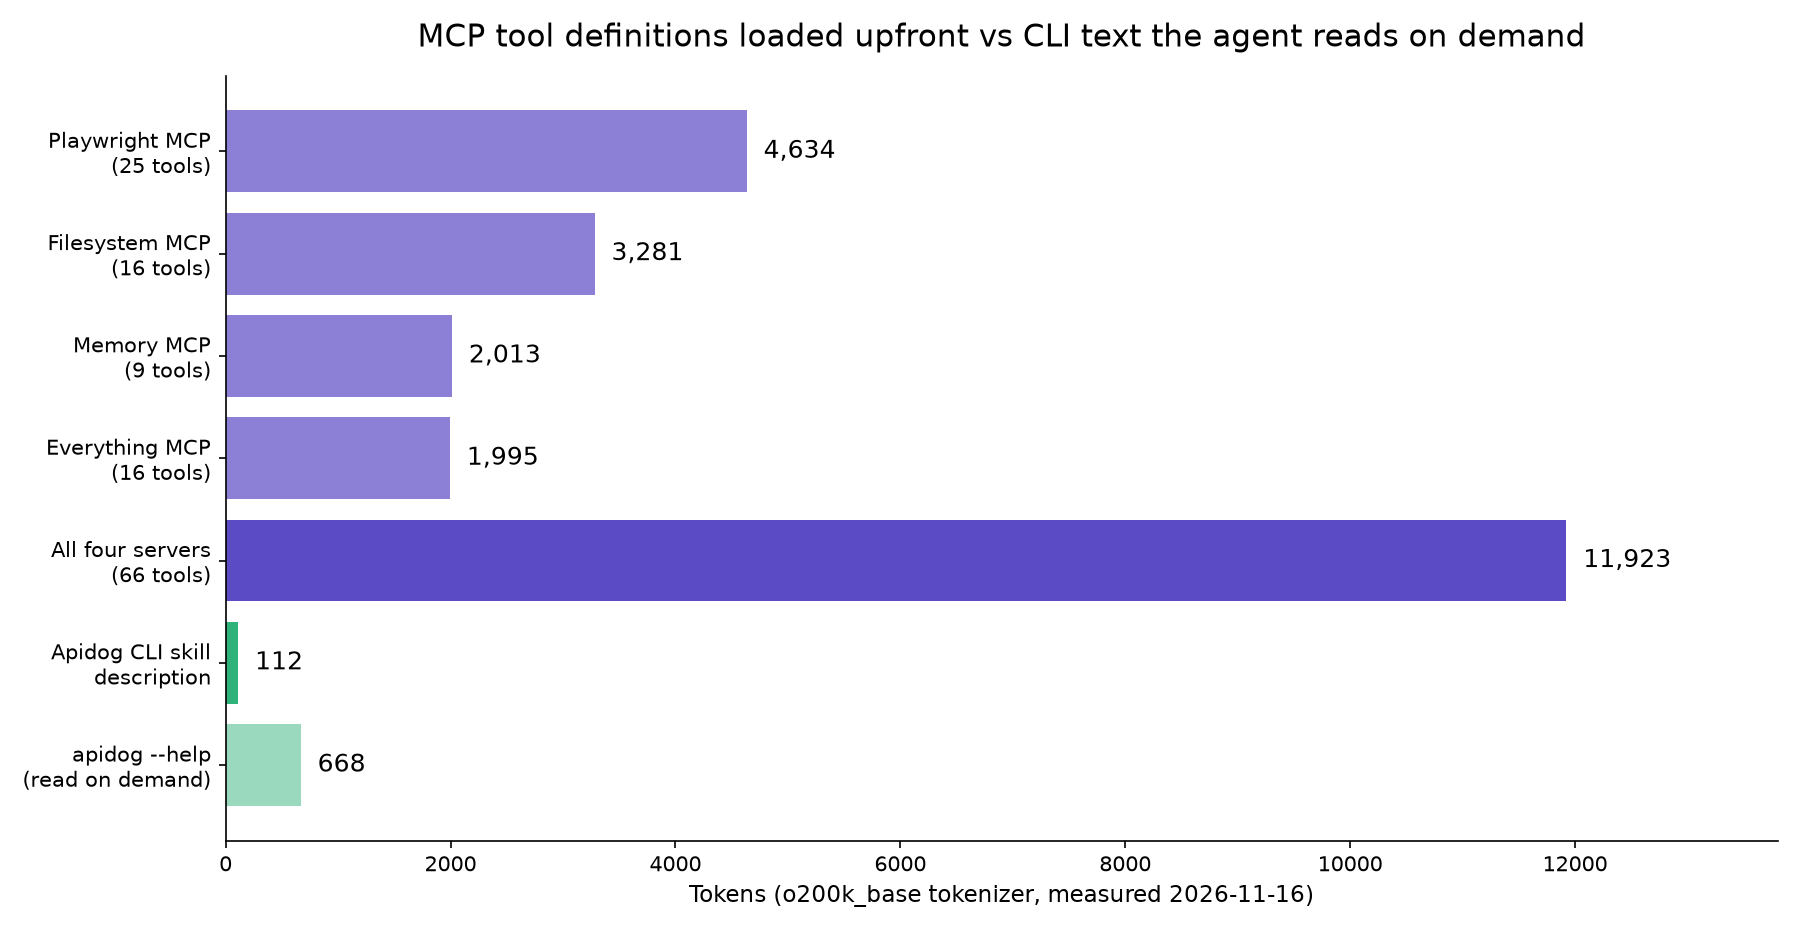
Le coût permanent de la voie CLI est de 112 tokens. Même si l'agent charge la skill complète et lit trois pages d'aide, on arrive à environ 3 500 tokens, et uniquement dans la conversation qui en a besoin.
MCP vs CLI : comparaison du coût en tokens
| Serveur MCP (définitions chargées d'emblée) | CLI appelée via le shell | |
|---|---|---|
| Coût initial | Le schéma de chaque outil, à chaque tour | Zéro, ou une courte description de skill |
| Découverte | tools/list structuré |
Texte --help, lu au besoin |
| Sortie | Ce que l'outil renvoie | Ce que la commande affiche (filtrable) |
| Fonctionne sur plusieurs clients | Tout client MCP, une seule config | Tout agent doté d'un outil shell |
| Arguments typés | Oui, via JSON Schema | Flags ; fichiers de charge utile validés séparément |
| Auth et permissions | Affaire du serveur (OAuth pour les serveurs HTTP distants) | Votre session locale et les permissions du shell |
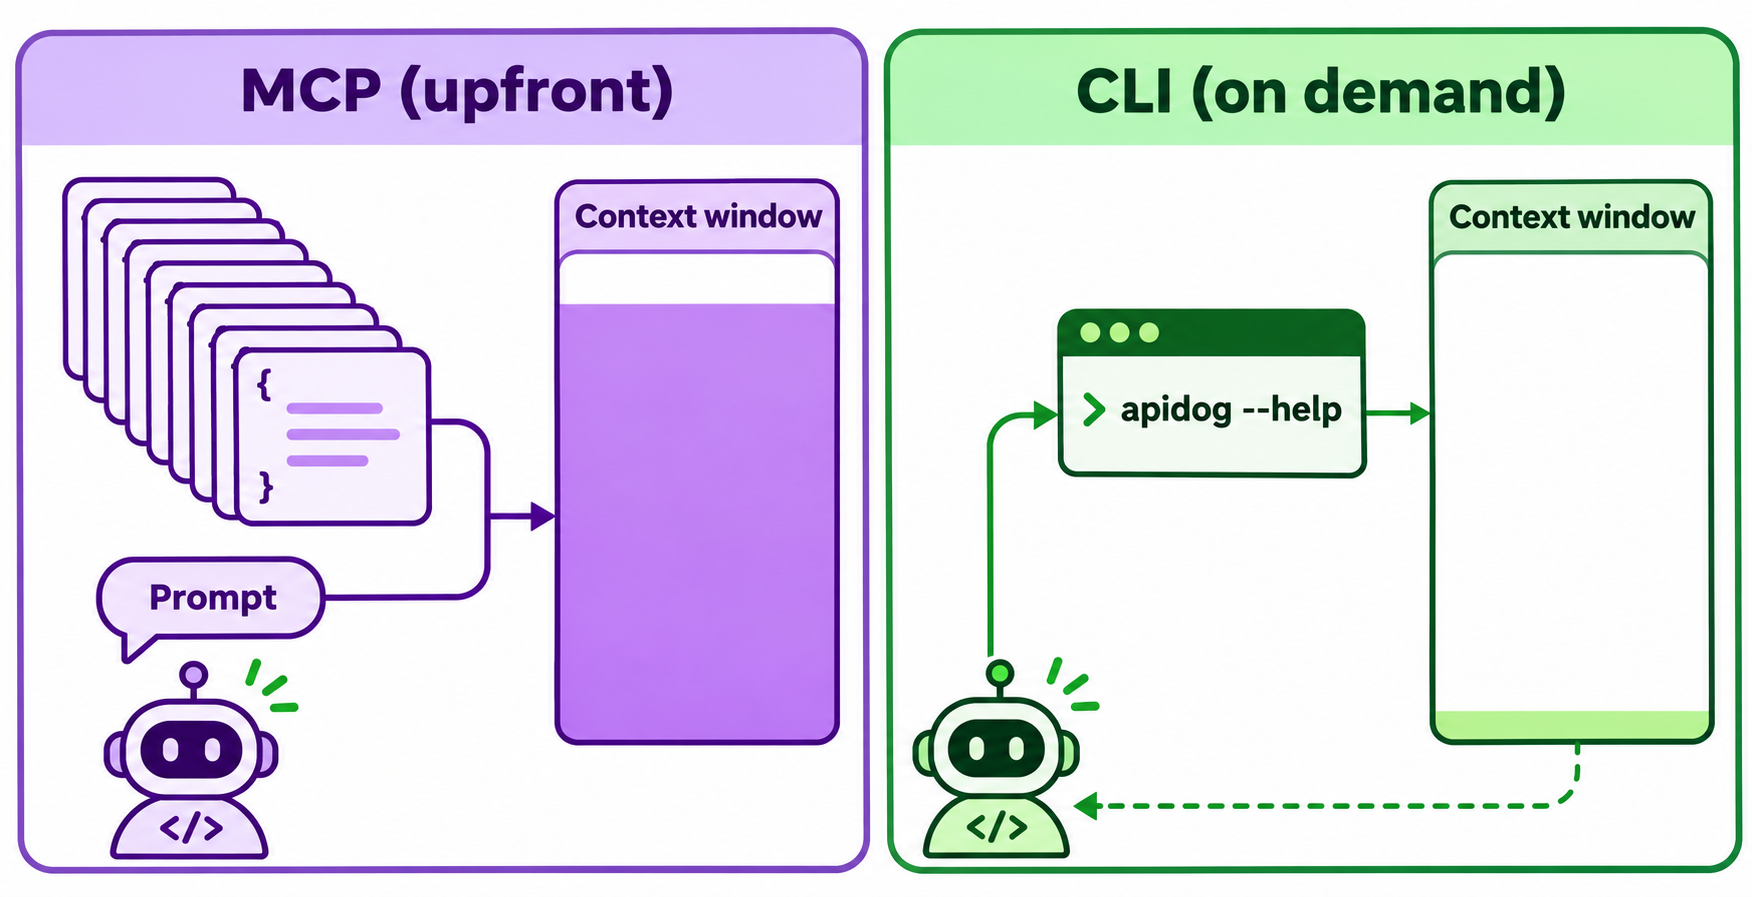
La CLI l'emporte sur le coût initial parce que l'agent dispose déjà d'un outil shell. Exécuter apidog endpoint list --project 123 utilise l'outil Bash qu'il aurait chargé de toute façon. La voie MCP l'emporte quand vous avez besoin de la même capacité dans plusieurs clients sans écrire une intégration pour chacun — c'est l'argument de Sylwia Lask : MCP ne remplace pas REST, c'est un moyen standard pour les clients IA de découvrir et d'appeler des outils.
Votre client diffère peut-être déjà les outils MCP
Avant de supprimer tous vos serveurs, regardez ce que fait votre agent. Le coût décrit plus haut suppose que les définitions sont chargées d'emblée. Certains clients ne le font plus par défaut.
La documentation MCP de Claude Code indique que la recherche d'outils est activée par défaut : « Seuls les noms d'outils et les instructions du serveur sont chargés au démarrage de la session », et les définitions complètes sont chargées quand Claude les recherche. Vous la contrôlez avec ENABLE_TOOL_SEARCH :
- non défini ou
true: les outils MCP sont différés et chargés à la demande auto: les outils sont chargés d'emblée tant que leurs définitions totalisent moins de 10 % de la fenêtre de contexteauto:N: idem, avec votre propre pourcentagefalse: tous les outils MCP sont chargés d'emblée
Deux exceptions à connaître. Les modèles antérieurs à Opus 4 et Sonnet 4 chargent les outils MCP d'emblée, quelle que soit la configuration, et un serveur réglé sur alwaysLoad: true échappe au diffèrement. Lancez /context dans Claude Code pour voir quels outils sont marqués comme différés. Sur l'API Claude elle-même, la même idée existe avec le tool search tool : vous définissez defer_loading: true sur les outils qui ne doivent pas être chargés d'emblée, et Anthropic indique que cela réduit généralement les tokens de définitions de plus de 85 %.
Le diffèrement résout le coût des définitions, pas celui des sorties : Claude Code avertit quand un outil MCP renvoie plus de 10 000 tokens et plafonne la sortie à 25 000 par défaut (MAX_MCP_OUTPUT_TOKENS). Le protocole est nouveau pour vous ? Commencez par ce qu'est MCP et pourquoi il compte pour les API.
Quand utiliser MCP ou CLI pour le travail sur les API
Pour la conception, les tests et la documentation d'API, voici comment répartir :
- Utilisez une CLI quand la tâche est quelque chose que vous exécuteriez de toute façon dans un terminal : lister des endpoints, exporter un fichier OpenAPI, créer et exécuter un cas de test, lancer une suite en CI. L'agent ne paie le texte d'aide que s'il en a besoin, et vous pouvez filtrer la sortie avec
jqou--reporterspour la garder concise. - Utilisez un serveur MCP ciblé quand l'agent a besoin d'un accès en lecture structuré à chaque tour, par exemple pour lire votre spécification OpenAPI pendant qu'il écrit du code client. Trois outils pour 291 tokens, c'est un prix raisonnable.
- Évitez de laisser cinq serveurs ou plus activés globalement dans tous vos projets. C'est précisément cette configuration qui a produit le « Run tests » à 28 400 tokens.
Quel que soit votre choix, les avertissements de Sylwia restent valables : un outil qui écrit des données nécessite des vérifications de permissions côté serveur, une étape d'approbation humaine pour les actions risquées, et une détection des doublons pour qu'une réexécution ne crée pas deux fois le même enregistrement.
Laissez votre agent de code piloter Apidog CLI
Voici la voie CLI pour le travail sur les API, avec votre agent de code aux commandes. Installez la CLI, connectez-vous une fois et ajoutez la skill pour l'agent :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Vous pouvez aussi dire à l'agent « Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI », et il suivra le guide d'installation pensé pour les agents.
Puis donnez-lui un seul prompt :
In Apidog project 123, list the endpoints, export the spec as OpenAPI 3.1 to
./openapi.json, then create a test case for GET /users/{id} that asserts a 200
status and an id field, run it against environment 456 and summarize failures.
Read --help for each command before using it. Print only the lines you need.
L'agent lit l'aide au fur et à mesure, valide son JSON, puis exécute le cas de test :
apidog endpoint list --project 123 --page 1 --page-size 500
apidog export --project 123 --format openapi --oas-version 3.1 --output ./openapi.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project 123 --file case.json
apidog run --test-case <caseId> --project 123 -e 456 -r cli,json
Chaque commande renvoie du JSON structuré, souvent avec agentHints.nextSteps, si bien que l'agent sait quoi exécuter ensuite sans charger un schéma pour chaque action possible. La même ligne apidog run ... -r junit s'intègre à la CI, comme le montre le guide du pipeline CI/CD avec Apidog CLI. Pour une démonstration dans Claude Code, voir Apidog CLI dans Claude Code, et pour les économies mesurées sur les appels d'outils, 30 % d'appels d'outils en moins, 25 % de tokens en moins.
Pour voir tous les groupes de commandes avant de vous lancer, consultez la page Apidog CLI.
Comment réduire dès aujourd'hui le coût en tokens de MCP
- Lancez
/contextdans Claude Code (ou l'équivalent dans votre client) et notez le total des définitions d'outils. - Déplacez les serveurs dont vous n'avez pas besoin de la config globale vers la config de projet.
- Activez le chargement différé (
ENABLE_TOOL_SEARCHdans Claude Code). - Remplacez les serveurs trop larges par une CLI accompagnée d'une courte skill pour le travail en ligne de commande.
- Pour les serveurs que vous développez, gardez peu d'outils et des descriptions courtes.
FAQ
Les outils MCP consomment-ils des tokens si l'agent ne les appelle jamais ? Dans un client qui charge les définitions d'emblée, oui. Le nom, la description et le schéma d'entrée de chaque outil sont envoyés dans chaque requête. Les clients avec chargement différé, comme Claude Code avec la recherche d'outils activée, n'envoient que les noms d'outils jusqu'à ce qu'un outil soit nécessaire.
Combien de tokens consomme un serveur MCP ? Cela dépend du nombre d'outils et de la profondeur des schémas. Dans ma mesure, @playwright/mcp a consommé 4 634 tokens pour 25 outils et le serveur MCP d'Apidog 291 pour 3 outils, comptés avec le tokenizer o200k_base.
Une CLI est-elle toujours moins coûteuse que MCP pour les agents IA ? En coût initial, presque toujours, car l'agent réutilise son outil shell. Par appel, une CLI peut néanmoins inonder le contexte si l'agent affiche une charge utile volumineuse ; filtrez donc la sortie dans les deux cas.
Le prompt caching règle-t-il l'encombrement du contexte par MCP ? Il abaisse le prix des définitions répétées. Il ne libère pas la fenêtre de contexte, et le modèle continue d'accorder son attention à ces tokens à chaque tour.
Faut-il arrêter d'utiliser les serveurs MCP ? Non. Utilisez des serveurs ciblés pour un accès structuré à chaque tour et pour partager une même capacité entre plusieurs clients. Déplacez le travail API de type terminal, comme les exports et l'exécution de tests, vers une CLI.