
Moonshot AI a lancé Kimi K3 le 16 juillet 2026, et la couverture du lancement l'a présenté comme un défi direct à Anthropic. TechCrunch a rapporté que K3 devrait combler l'écart avec les modèles à code source fermé, citant des sources qui affirmaient qu'il pourrait égaler, voire dépasser, Claude Opus 4.8. Cet article compare les deux modèle dimension par dimension, avec les chiffres vérifiables et ceux que nous ne pouvons pas clairement marqués.
En bref : K3 l'emporte sur le prix, la fenêtre contextuelle et l'ouverture ; Opus 4.8 offre les garanties d'un fournisseur géré mature. Comme les deux utilisent le format OpenAI SDK, vous pouvez exécuter la même requête sur chacun et comparer les sorties, la latence et le coût dans un outil comme Apidog.
TL;DR et le verdict en un coup d'œil
Kimi K3 est un modèle de type « mélange d'experts » de 2 800 milliards de paramètres avec une fenêtre contextuelle de 1 million de jetons, un prix d'entrée bon marché et des poids ouverts disponibles vers le 27 juillet 2026. Claude Opus 4.8 est un modèle propriétaire fermé de la gamme Opus d'Anthropic, plus cher, avec une forte réputation en matière de raisonnement et de capacités agentiques. Le classement indépendant d'Artificial Analysis attribue à K3 un indice d'intelligence de 57, le classant 4ème sur 189 modèles, le meilleur de sa catégorie parmi les poids ouverts.
Voici un aperçu rapide :
- Choisissez Kimi K3 pour une très grande fenêtre contextuelle, un faible coût à volume élevé, ou la possibilité d'auto-héberger et de fine-tuner les poids ouverts.
- Choisissez Claude Opus 4.8 pour une relation fournisseur mature, un support géré et des SLAs, ainsi qu'un long historique de production sur des tâches agentiques complexes, si vous êtes prêt à payer le supplément.
- C'est serré, pas encore tranché. Il n'existe pas encore de tableau de benchmark indépendant comparant K3 et Opus 4.8 de manière équitable, alors traitez avec prudence tout titre affirmant qu'« l'un bat l'autre globalement ».
Une note de cadrage. Le modèle phare actuellement disponible d'Anthropic est Claude Fable 5 ; Opus 4.8 est un niveau solide en dessous de cette frontière, ce n'est pas le vaisseau amiral. Le blog de lancement de Moonshot indique que K3 « est toujours en retrait par rapport aux modèles propriétaires les plus puissants, Claude Fable 5 et GPT 5.6 Sol », nommant Fable 5 et Sol, et non Opus. L'histoire honnête n'est donc pas « un modèle ouvert détrône Anthropic ». C'est « un modèle ouvert réduit l'écart, gagne sur le prix, le contexte et l'ouverture, et ne traîne qu'au sommet de la qualité ».
Le lancement, et pourquoi cette comparaison existe
K3 est la plus grande avancée de Moonshot dans l'échelle des poids ouverts, et avec un total de 2 800 milliards de paramètres, c'est le plus grand modèle à poids ouverts de Chine à ce jour. L'architecture repose sur Kimi Delta Attention, Attention Residuals, et une conception que Moonshot appelle Stable LatentMoE, qui active 16 experts sur 896 par jeton. Moonshot n'a pas publié le nombre de paramètres actifs, nous ne l'estimerons donc pas. L'explication détaillée sur ce qu'est Kimi K3 couvre l'architecture et l'accès en détail.
La comparaison existe parce que les entreprises se demandent constamment si les modèles fermés coûteux en valent la peine lorsqu'un modèle à poids ouverts se rapproche en termes de qualité et fonctionne sur leur propre matériel. Le cadre est devenu « K3 contre Opus 4.8 » plutôt que « K3 contre Fable 5 » parce qu'Opus 4.8 est le niveau où un challenger ouvert a une chance plausible. Le rapport TechCrunch présente le contexte du marché.
Kimi K3 et Claude Opus 4.8 en un coup d'œil
Voici la comparaison côte à côte sur les dimensions qui influencent une décision d'achat. Lorsqu'un chiffre n'est pas publiquement confirmé, la cellule l'indique.
| Dimension | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Fournisseur | Moonshot AI | Anthropic |
| Lancé | 16 juillet 2026 | Fait partie de la ligne Claude Opus 4 |
| Type de modèle | MoE de 2,8T paramètres (Stable LatentMoE, 16 sur 896 experts actifs) | Propriétaire, architecture non divulguée |
| ID/accès du modèle | kimi-k3, compatible OpenAI SDK |
API Claude (famille claude-opus-4-8) |
| Fenêtre contextuelle | 1 048 576 jetons (1M) | Grande, mais inférieure à la fenêtre de 1M de K3 |
| Prix d'entrée | 0,30 $ / M en cas de correspondance cache, 3,00 $ / M en cas d'échec cache | 5,00 $ / M |
| Prix de sortie | 15,00 $ / M | 25,00 $ / M |
| Vitesse de sortie | ~62 jetons/sec (Artificial Analysis) | Non cité ici ; voir Artificial Analysis |
| Score indépendant | Indice d'intelligence 57, n°4 sur 189 (Artificial Analysis) | Niveau propriétaire supérieur (voir Artificial Analysis) |
| Poids | Poids ouverts, vers le 27 juillet 2026 | Fermé |
| Position qualité | Meilleur parmi les modèles ouverts ; en retrait par rapport à Fable 5 et GPT 5.6 Sol (Moonshot) | Niveau propriétaire solide en dessous de la frontière Fable 5 d'Anthropic |
La plupart des cellules favorisent K3 en termes d'économie et d'accès. La qualité est la ligne contestée, et nous l'examinerons ensuite.
Intelligence et qualité : où le niveau supérieur tient toujours
La qualité est la dimension la plus difficile à cerner, car aucun benchmark indépendant partagé ne compare encore K3 et Opus 4.8 en face à face. Le signal indépendant le plus clair est Artificial Analysis, dont l'indice d'intelligence place K3 à la frontière ou près de la frontière sur un mélange d'évaluations de raisonnement, de codage et de connaissances, et le meilleur modèle à poids ouverts de ce classement. Il note également que K3 est plus lent que la moyenne et est verbeux.
Le contrepoids vient de Moonshot elle-même. Son blog de lancement est franc : la performance globale de K3 « est toujours en retrait par rapport aux modèles propriétaires les plus puissants, Claude Fable 5 et GPT 5.6 Sol ». Cette phrase nomme Fable 5 et Sol, et non Opus 4.8. L'aveu de Moonshot place donc K3 derrière Fable 5 et Sol, et ne dit rien sur une éventuelle défaite de K3 face à Opus 4.8.
Le tableau des benchmarks du fournisseur le confirme. Selon les chiffres de lancement de Moonshot, avec le réglage de raisonnement maximal, K3 surpasse Opus 4.8 sur chaque benchmark listé :
| Benchmark | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
Il s'agit de chiffres fournis par le fournisseur, et non d'une comparaison directe et indépendante : un laboratoire publie les suites où il est bien classé. Mais ce sont les chiffres réels publiés par Moonshot, et ils montrent K3 devant Opus 4.8 dans l'ensemble, y compris sur DeepSWE, la métrique de codage agentique la plus difficile de l'ensemble. Pour une vue étiquetée par source, consultez la ventilation des benchmarks de Kimi K3, et pour le concurrent de pointe qui surpasse réellement K3, Kimi K3 vs GPT-5.6 Sol. Le bilan honnête : selon les chiffres dont nous disposons, K3 est au moins à égalité avec Opus 4.8 et en avance sur la propre suite de Moonshot. Les vrais avantages d'Opus 4.8 ne sont pas les scores des benchmarks ; ce sont la maturité des outils d'Anthropic, son historique de fiabilité et les garanties d'un fournisseur géré.
Prix : l'écart le plus large
Le coût est le point où les deux divergent le plus, et les chiffres sont publiés. Kimi K3 facture 0,30 $ par million de jetons pour l'entrée en cas de correspondance cache, 3,00 $ pour l'entrée en cas d'échec cache, et 15,00 $ pour la sortie. Claude Opus 4.8 facture 5,00 $ pour l'entrée et 25,00 $ pour la sortie. K3 est donc considérablement moins cher pour l'entrée en cache (0,30 $ contre 5,00 $), toujours à moins de la moitié du prix pour un échec de cache (3,00 $ contre 5,00 $), et 40 % moins cher pour la sortie (15,00 $ contre 25,00 $).
Pour une charge de travail riche en contexte répété, comme un chatbot renvoyant le même prompt système et les mêmes documents, la tarification de K3 en cas de correspondance cache se traduit par une économie importante, et pour la génération à haut volume, l'écart de prix de sortie seul peut transformer une facture mensuelle. Pour modéliser votre propre trafic, le guide de tarification de Kimi K3 explique les niveaux, et l'article sur la tarification de Claude Opus 4.8 fait de même du côté d'Anthropic.
Une mise en garde : un coût par jeton moins cher n'est pas toujours synonyme de coût par tâche moins cher. Un modèle verbeux peut annuler une partie de son avantage par jeton en générant plus de jetons, et Artificial Analysis signale K3 comme verbeux, alors mesurez le coût total sur des prompts réels, pas sur la grille tarifaire.
Fenêtre contextuelle : de la place pour travailler
Le contexte est une victoire évidente pour K3 sur le papier. Kimi K3 expose une fenêtre de 1 048 576 jetons, suffisante pour contenir de très grandes bases de code, de longs ensembles de documents, ou des historiques de conversations multi-tours étendus en une seule requête sans découpage agressif. Claude Opus 4.8 offre également une grande fenêtre, mais en dessous du plafond de 1M de K3.
Si votre charge de travail est réellement à long contexte (un dépôt entier, un ensemble de contrats de la longueur d'un livre, un long corpus de recherche dans un seul prompt), K3 offre plus de marge avant de devoir construire des mécanismes de récupération. Mais une fenêtre plus grande est une capacité, pas une garantie de qualité sur toute l'étendue, alors validez que les réponses restent précises même avec un prompt d'un million de jetons avant de vous y fier.
Ouverture : poids ouverts versus fermés
L'ouverture modifie ce que vous êtes autorisé à faire avec le modèle, et aucune tarification ou benchmark ne peut s'y substituer. Les poids de Kimi K3 seront disponibles vers le 27 juillet 2026, offrant des options qu'un modèle fermé ne peut pas : l'auto-hébergement pour la résidence des données ou les environnements isolés, le fine-tuning sur vos propres données, et la liberté par rapport aux limites de débit ou à la feuille de route d'un fournisseur unique. Pour les industries réglementées, « les poids s'exécutent sur notre matériel » peut être le facteur décisif, quels que soient les scores des benchmarks.
Claude Opus 4.8 est fermé. Vous y accédez via l'API d'Anthropic et obtenez un service géré : hébergement cohérent, relation de support, politiques publiées et aucune infrastructure à gérer. La documentation API d'Anthropic couvre la famille de modèles. K3 vous donne le contrôle et la responsabilité ; Opus vous offre la commodité et un fournisseur sur lequel vous appuyer.
Vitesse et latence
La vitesse est plus nuancée qu'un simple chiffre. Artificial Analysis mesure K3 à environ 62 jetons de sortie par seconde, en dessous de la médiane d'environ 73 pour sa catégorie de prix, bien que son temps de première génération de jeton soit rapide (~1,99 secondes). K3 semble donc réactif au début d'une réponse mais génère le corps lentement, et la sortie verbeuse rend les longues complétions encore plus lentes. Nous n'avons pas de chiffre indépendant correspondant pour Opus 4.8, alors testez les deux avec vos propres prompts si le débit sur de longues sorties est important.
Matrice de décision par charge de travail
Plutôt que de couronner un seul vainqueur, adaptez le modèle à la tâche.
| Charge de travail | Mieux adapté | Pourquoi |
|---|---|---|
| Tâches à très long contexte (dépôts entiers, grands ensembles de documents) | Kimi K3 | La fenêtre de 1M de jetons réduit le travail de découpage et de récupération |
| Génération à volume élevé et sensible aux coûts | Kimi K3 | Tarifs d'entrée et de sortie inférieurs, forte tarification en cas de correspondance cache |
| Auto-hébergement, résidence des données ou fine-tuning | Kimi K3 | Poids ouverts vers le 27 juillet 2026 |
| Plafond de qualité de raisonnement et agentique le plus difficile | Tester les deux | Contesté : les propres benchmarks de lancement de Moonshot placent K3 devant Opus 4.8, mais ceux-ci sont effectués par le fournisseur et Opus a un historique de production plus long sur les agents complexes |
| Fiabilité et support essentiels | Claude Opus 4.8 | Service commercial géré avec SLAs, support et politiques publiées |
| Applications interactives sensibles à la latence | Tester les deux | K3 a un temps de première génération de jeton rapide mais une génération plus lente et plus verbeuse |
| Prototypes et projets secondaires à budget limité | Kimi K3 | Le chemin le moins cher vers une qualité quasi-frontière |
K3 domine en termes d'économie, de contexte et de contrôle, et selon les propres benchmarks de Moonshot, il égale ou surpasse Opus 4.8 en qualité également. Ce que possède Opus 4.8, c'est le confort d'un fournisseur géré. La plupart des équipes trouveront que certaines charges de travail penchent d'un côté et d'autres de l'autre, il est donc préférable de garder les deux à portée plutôt que de se standardiser sur l'un.
Cas d'utilisation réels
- Une startup qui développe un produit d'analyse de documents. Contrats longs, volume de requêtes élevé, marges serrées. Le contexte de 1M de K3 et sa tarification basse s'adaptent presque parfaitement, et les poids ouverts offrent une voie d'auto-hébergement si la résidence des données devient une exigence plus tard.
- Une entreprise qui automatise des workflows d'agents multi-étapes. La fiabilité est importante et les erreurs sont coûteuses. Les benchmarks de Moonshot placent K3 en tête, mais l'historique de production plus long d'Opus 4.8 est ce pour quoi certaines équipes paient un supplément tant que ces chiffres ne sont pas reproduits.
- Une banque réglementée qui ne peut pas envoyer de données à des API tierces. Le débat sur les benchmarks est hors de propos : les poids ouverts de K3 s'exécutent au sein de l'environnement propre de la banque, tandis qu'Opus 4.8, en tant que service API fermé, pourrait être totalement écarté.
Tester les deux avec la même requête dans Apidog
Les comparaisons sur papier ne vous mènent que si loin. Étant donné que Kimi K3 est compatible avec le SDK OpenAI et que Claude Opus 4.8 est accessible via sa propre API, vous pouvez configurer les deux comme des requêtes dans Apidog et envoyer la même charge utile à chacun.
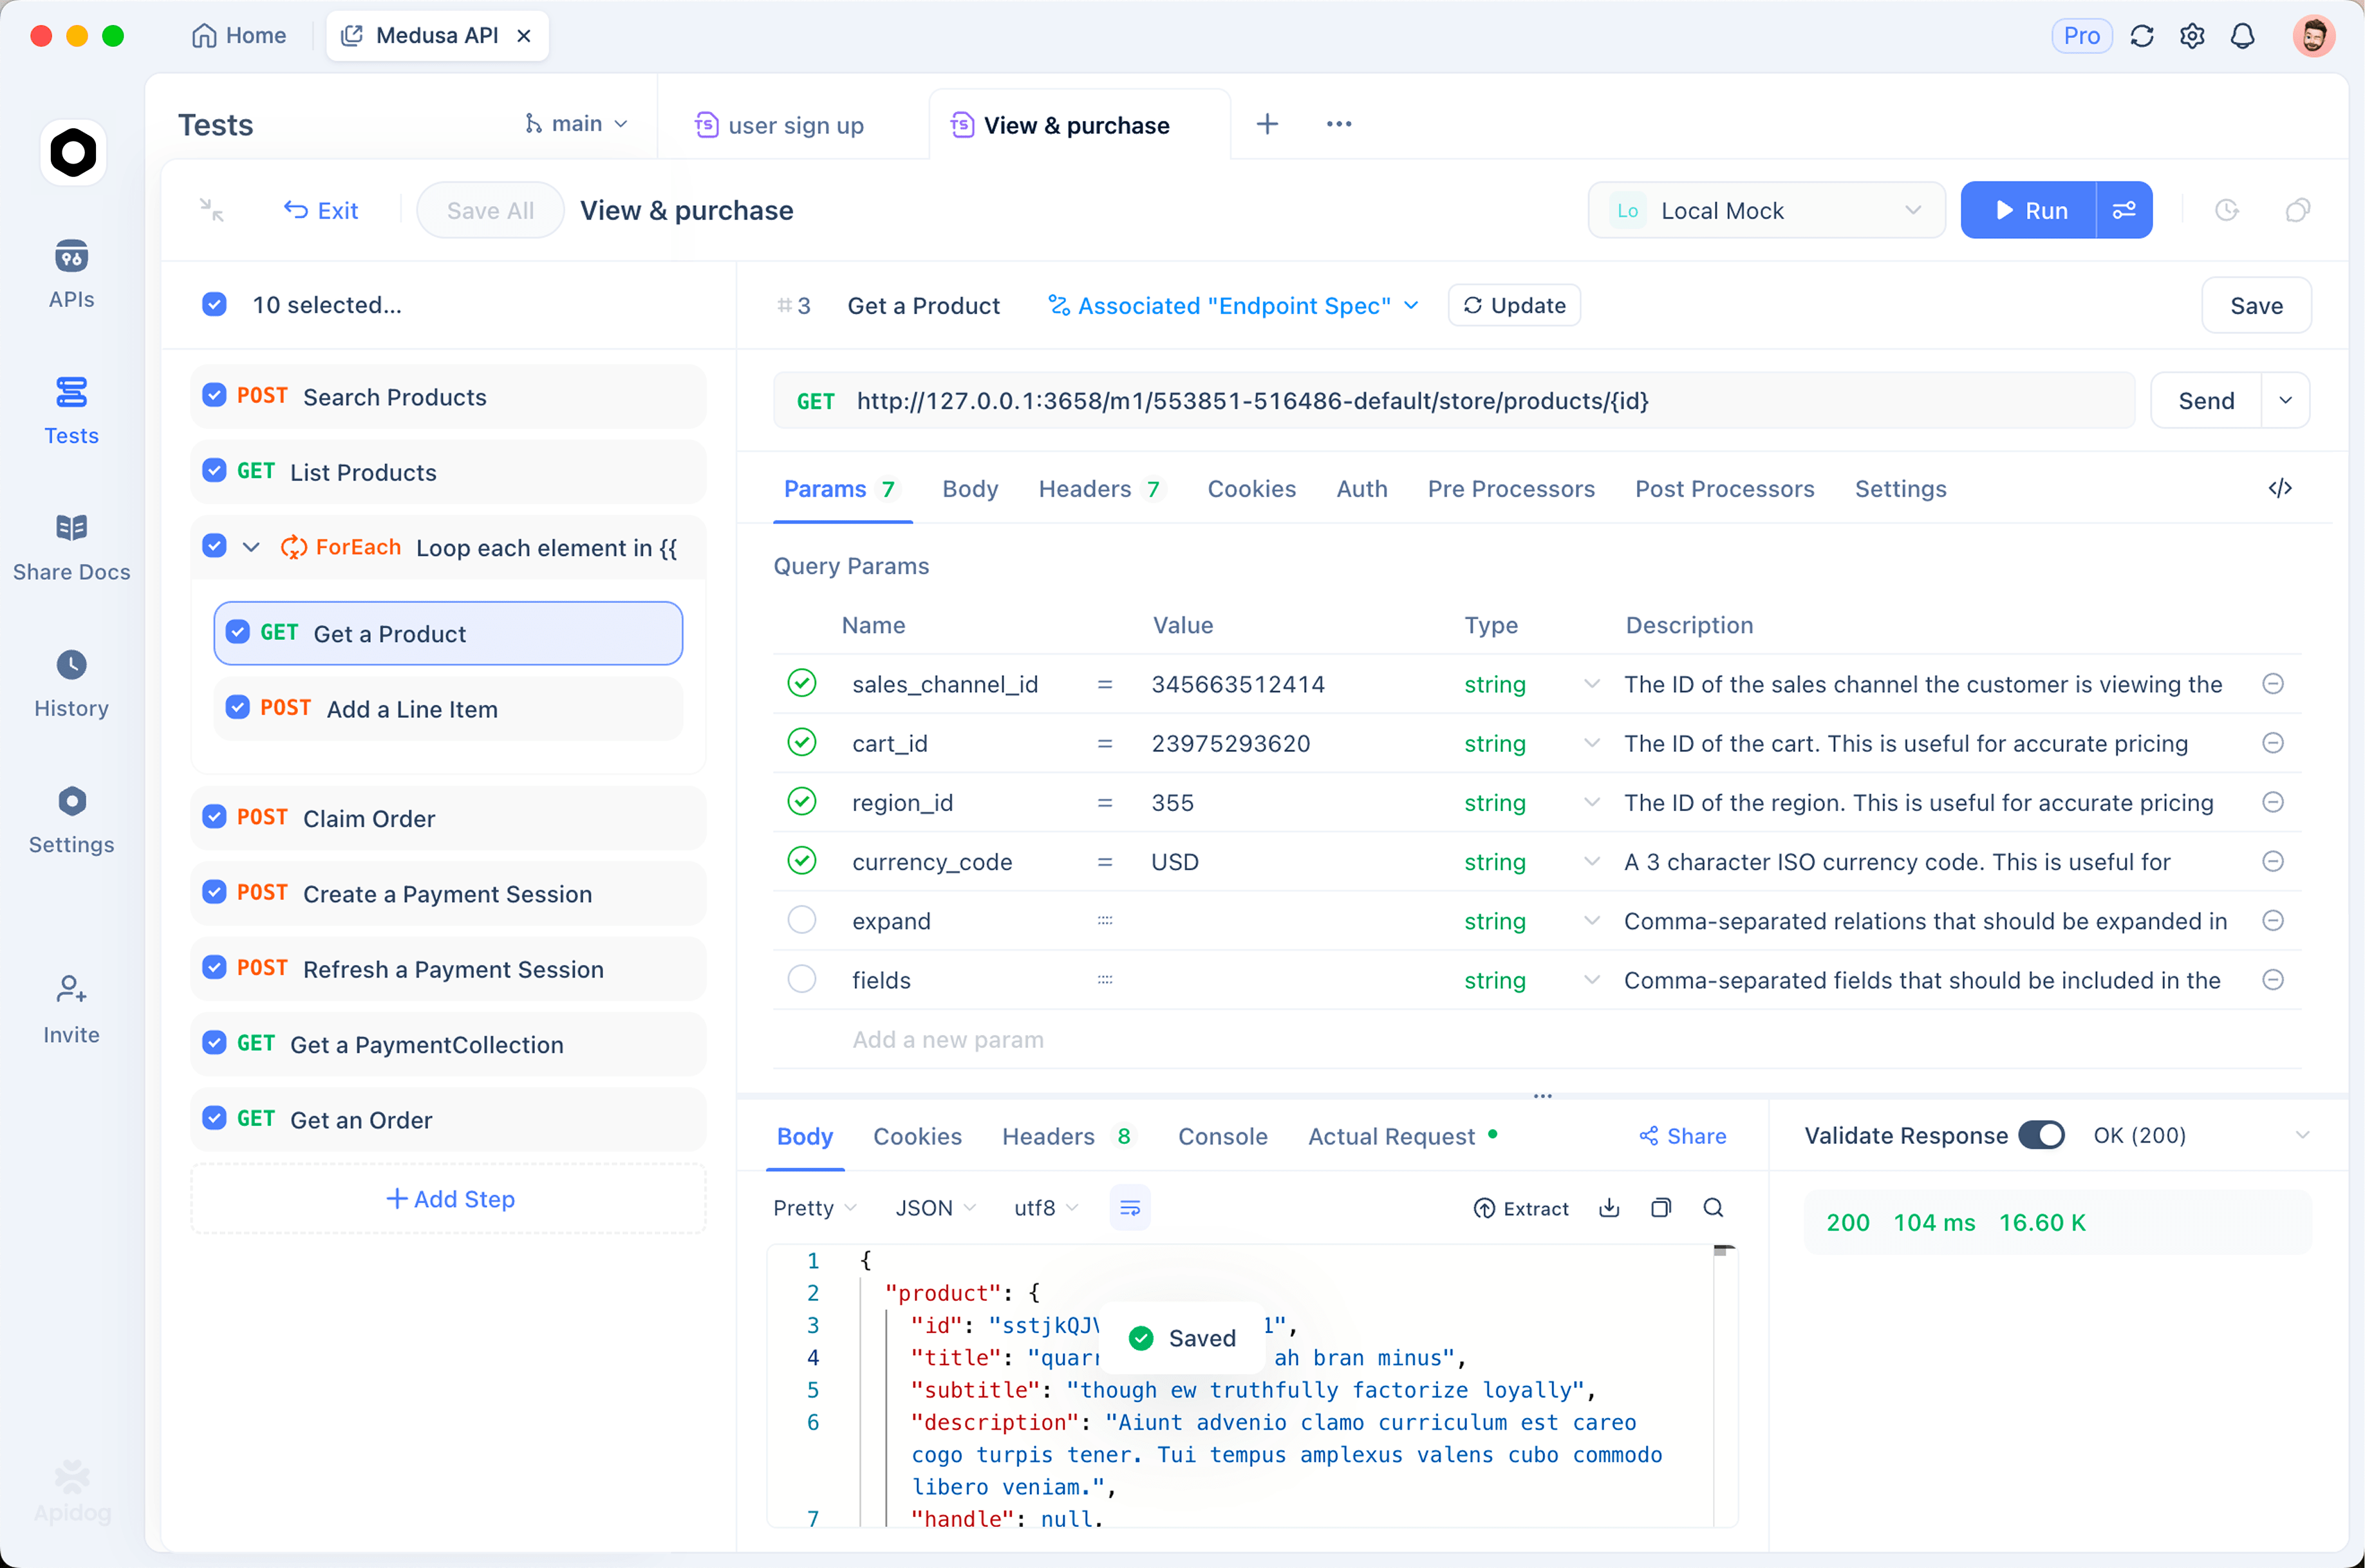
Créez une requête pour le point de terminaison K3 et une pour Opus, stockez vos clés et URL de base comme variables d'environnement, puis envoyez le même prompt aux deux. Apidog affiche le corps de la réponse, le statut et le timing pour chaque appel, afin que vous puissiez comparer la qualité de la réponse, la latence et le coût des jetons sur des entrées identiques, et les enregistrer comme une collection vous donne un harnais reproductible à réexécuter chaque fois que l'un des modèles est mis à jour. Vous pouvez effectuer ces vérifications avec Apidog dans VS Code, et l'approche sert également de test d'API sans Postman. Téléchargez Apidog pour le configurer vous-même. L'objectif : remplacer « quel modèle est globalement meilleur » par « lequel est meilleur pour ce prompt, à ce coût, à cette latence ».
Le bilan
Kimi K3 bat Claude Opus 4.8 de manière décisive sur le prix, la fenêtre contextuelle et l'ouverture, et selon les propres benchmarks de lancement de Moonshot, il surpasse également Opus 4.8 en qualité, bien que ces chiffres soient fournis par le fournisseur et n'aient pas encore été reproduits de manière indépendante. Ce que conserve Opus 4.8, c'est le côté assurance : un fournisseur géré, des politiques publiées et un historique de fiabilité prouvé sur les tâches agentiques difficiles. Si votre charge de travail est à long contexte, sensible aux coûts ou nécessite un auto-hébergement, K3 est le choix pragmatique ; si vous souhaitez une relation commerciale et un historique prouvé, Opus 4.8 mérite son supplément. Comme aucune comparaison directe indépendante n'existe encore, testez les deux sur vos propres prompts avant de vous engager.
Questions fréquemment posées
- Kimi K3 est-il meilleur que Claude Opus 4.8 ? C'est serré, et selon les chiffres dont nous disposons, K3 semble au moins à égalité. Il l'emporte sur le prix, le contexte et l'ouverture, et selon les propres benchmarks de lancement de Moonshot, il surpasse Opus 4.8 sur toutes les tâches listées, bien que ces chiffres soient fournis par le fournisseur et n'aient pas encore été reproduits de manière indépendante. Moonshot affirme que K3 est en retrait par rapport aux modèles propriétaires de pointe, mais il nomme Fable 5 et GPT-5.6 Sol, et non Opus 4.8, donc le véritable avantage d'Opus 4.8 réside dans son historique et son support géré, et non dans une avance en benchmark.
- Kimi K3 est-il beaucoup moins cher ? K3 facture 0,30 $ par million de jetons pour l'entrée en cas de correspondance cache, 3,00 $ pour l'entrée en cas d'échec cache, et 15,00 $ pour la sortie. Opus 4.8 facture 5,00 $ pour l'entrée et 25,00 $ pour la sortie. K3 est donc beaucoup moins cher pour l'entrée en cache, à moins de la moitié du prix pour un échec de cache, et environ 40 % moins cher pour la sortie. Les économies réelles dépendent de la proportion de votre entrée qui est mise en cache.
- Existe-t-il un benchmark indépendant comparant directement Kimi K3 et Opus 4.8 ? Pas encore. Artificial Analysis fournit des scores d'indice d'intelligence indépendants pour les modèles individuels, et Moonshot publie ses propres chiffres de benchmark, mais il n'existe pas de tableau de comparaison directe et équitable entre K3 et Opus 4.8. Traitez les victoires rapportées par les fournisseurs, y compris le chiffre « premier sur quatre des huit benchmarks d'automatisation », comme des auto-déclarations jusqu'à ce qu'elles soient reproduites de manière indépendante.
- Kimi K3 est-il un concurrent d'Opus 4.8 ou de Claude Fable 5 ? K3 est en concurrence sur l'ensemble du marché. La couverture du lancement l'a positionné face à Opus 4.8 parce que c'est le niveau qu'un challenger ouvert peut atteindre de manière plausible. La frontière actuelle d'Anthropic est Claude Fable 5, que Moonshot reconnaît K3 est toujours en retrait, donc K3 est mieux compris comme se rapprochant du domaine propriétaire plutôt que de le dépasser.