
Le Kimi K2.7 Code de Moonshot a été lancé avec des benchmarks comparés aux deux modèles que la plupart des développeurs payent réellement : Claude Opus et GPT-5.5. En bref, la frontière fermée obtient toujours de meilleurs scores sur la plupart des tâches de codage, mais pas avec la marge que son prix suggère. Kimi est un modèle à poids ouverts que vous pouvez télécharger et auto-héberger, et il se situe à quelques points des modèles que vous ne pouvez que louer.
Cette comparaison met les chiffres côte à côte, les évalue par rapport au coût et à l'ouverture, et vous indique lequel choisir pour quel travail.
En bref
- Qualité de codage brute : GPT-5.5 et Claude Opus sont en tête sur la plupart des suites. Kimi K2.7 Code est en retrait de quelques points.
- Coût : Kimi est beaucoup moins cher (0,95 $/4,00 $ par million de jetons) et gratuit à auto-héberger. Les modèles fermés coûtent plus cher et ne peuvent pas être hébergés sur votre propre matériel.
- Ouverture : Kimi distribue des poids ouverts sous une licence MIT modifiée. Opus et GPT-5.5 sont fermés.
- Verdict : choisissez le modèle de pointe pour la meilleure qualité en un seul coup ; choisissez Kimi lorsque le coût, le volume ou le contrôle des données sont plus importants que les quelques derniers points.
Les concurrents en un coup d'œil
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Type | Poids ouverts (MIT modifié) | Fermé | Fermé |
| Architecture | MoE, 1T total / 32B actifs | Non divulguée | Non divulguée |
| Fenêtre contextuelle | 256K jetons | Grande | Grande |
| Auto-hébergement | Oui | Non | Non |
| Tarification (par M de jetons) | 0,95 $ en entrée / 4,00 $ en sortie | Plus élevé, location uniquement | Plus élevé, location uniquement |
La différence structurelle est le point essentiel. Kimi vous dit exactement ce qu'il est et vous permet de l'exécuter vous-même. Les deux autres sont des services que vous appelez.
Benchmarks de codage
Ce sont les scores rapportés par Moonshot. Considérez-les comme le point de vue du fournisseur, puisque plusieurs suites sont propres à Moonshot, mais le modèle est cohérent et mérite d'être lu.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 occupe la première place sur les deux premiers ; Claude Opus mène sur MLS Bench Lite et reste proche partout. Kimi se situe un cran en dessous sur chacun. L'écart est réel mais faible sur Kimi Code Bench v2, plus large sur Program Bench. Si votre travail ressemble à ce deuxième benchmark, la frontière mérite son coût.
Benchmarks d'agents et d'utilisation d'outils
Les agents de codage vivent ou meurent des appels d'outils, pas seulement de la génération de code. Ici, l'image se resserre.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
Sur MCP Mark Verified, Kimi devance en fait Claude Opus, bien que GPT-5.5 soit loin devant. Sur MCP Atlas, les trois se situent à environ cinq points. Pour les charges de travail agiles, Kimi est plus proche du peloton que ne le suggèrent ses scores de codage bruts, ce qui est important car c'est exactement là que les coûts des jetons s'accumulent.
Le coût est l'avantage de Kimi
Les benchmarks mesurent la qualité. Ils ne mesurent pas la facture. Kimi K2.7 Code coûte 0,95 $ par million de jetons d'entrée et 4,00 $ par million de jetons de sortie, avec des hits de cache à 0,19 $ par million. Les modèles de pointe fermés coûtent nettement plus cher par jeton, et vous ne pouvez pas y échapper en les hébergeant ; il n'y a pas de téléchargement.
Deux facteurs aggravent les économies :
- Les poids ouverts signifient une option à zéro jeton. Auto-hébergez sur votre propre matériel et le coût par jeton disparaît entièrement. Vous l'échangez contre du temps GPU.
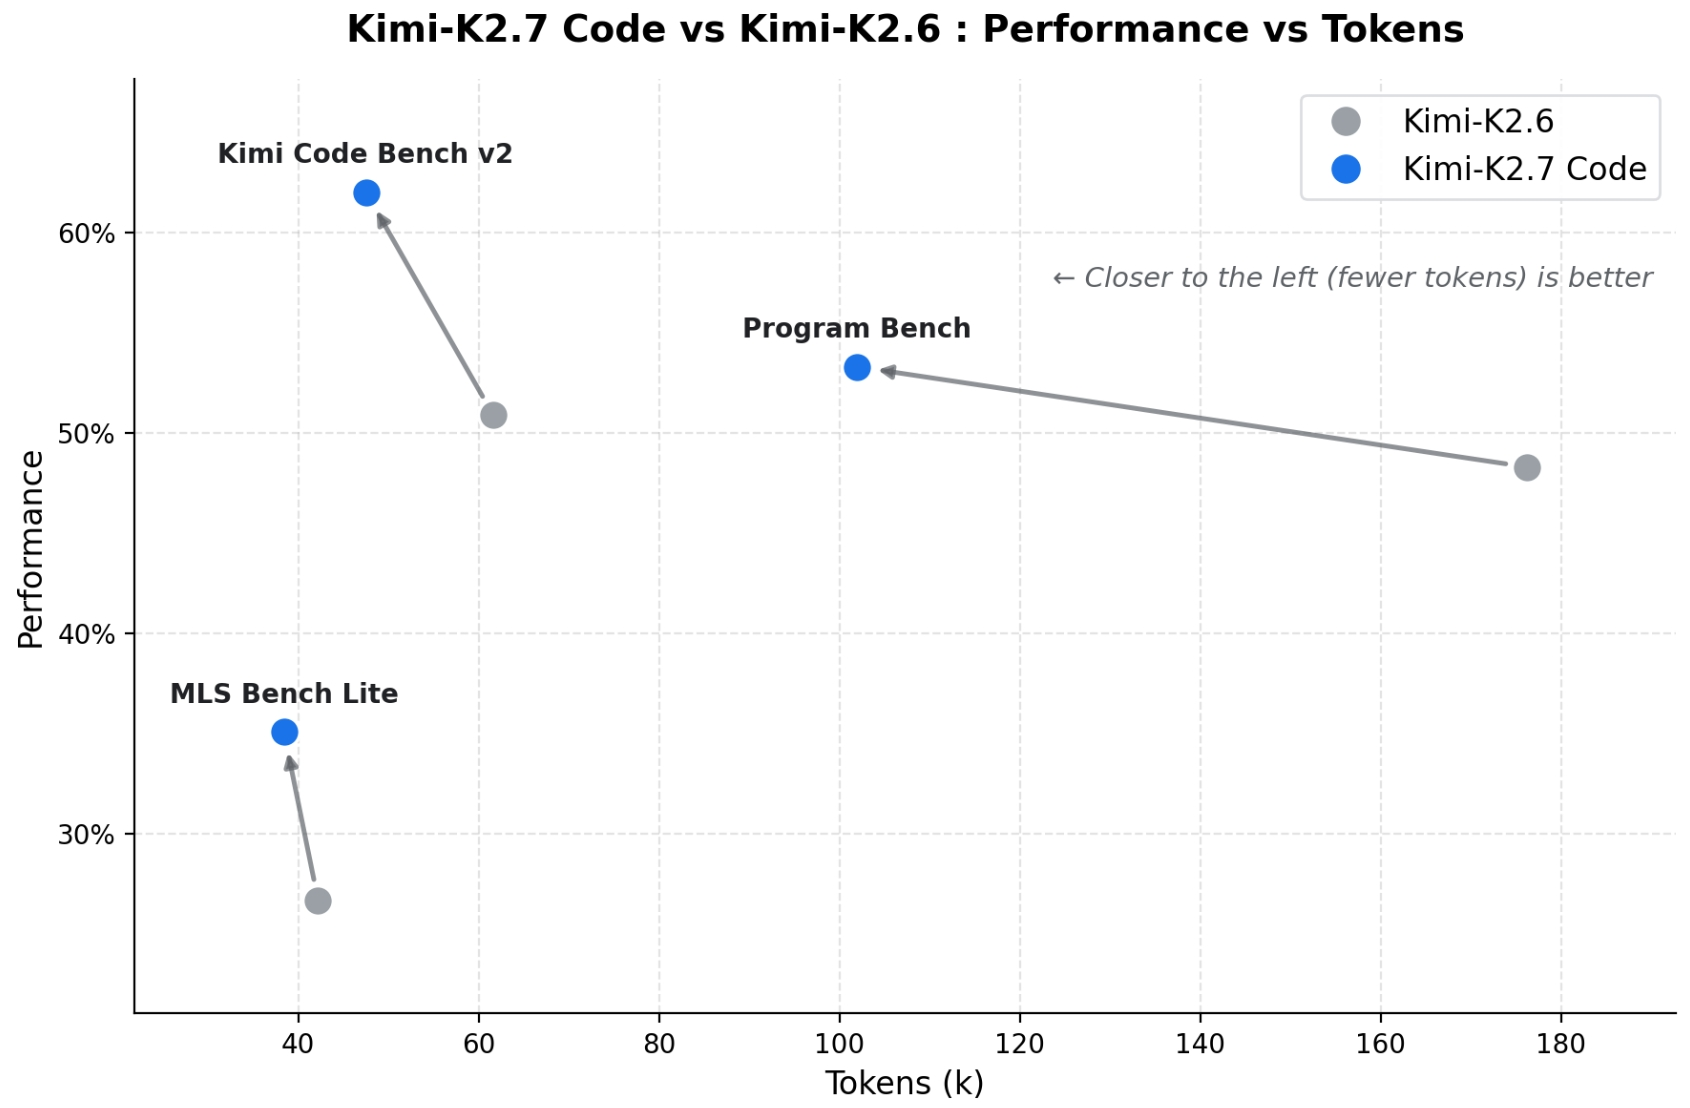
- Un raisonnement plus léger. K2.7 Code utilise environ 30 % moins de jetons de réflexion que K2.6 pour le même travail, donc chaque étape d'agent coûte moins cher. Notre guide sur la réduction des coûts des jetons d'agent explique plus en détail pourquoi cela s'additionne.
Pour un agent effectuant des centaines d'appels d'outils par tâche, un modèle qui est 90 % aussi bon pour une fraction du prix l'emporte souvent sur la valeur totale.
Contexte et ouverture
Les trois gèrent bien les contextes longs ; la fenêtre de Kimi est de 256K jetons, assez pour un service complet plus ses tests en une seule invite. Le principal différenciateur est la licence. Les poids MIT modifiés de Kimi vous permettent d'affiner, d'auditer et d'exécuter le modèle en environnement isolé. Pour les équipes soumises à des règles de conformité ou de résidence des données, ce n'est pas un luxe ; c'est le facteur décisif, et les modèles fermés sont simplement hors de question.
Quand choisir lequel
Choisissez GPT-5.5 ou Claude Opus si :
- Vous avez besoin de la plus haute qualité de codage en un seul coup et que quelques points de benchmark justifient le coût.
- Vous êtes à l'aise avec la location d'un service fermé avec un SLA géré.
- Vos tâches les plus difficiles ressemblent à Program Bench, où l'écart est le plus grand.
Choisissez Kimi K2.7 Code si :
- Vous exécutez des charges de travail d'agents à volume élevé où le coût des jetons décide de la viabilité.
- Les données doivent rester sur votre propre infrastructure.
- Vous souhaitez affiner ou auditer le modèle.
- Vous optimisez la valeur totale, pas le sommet du classement.
Pour un champ plus large, notre comparaison MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 couvre les autres challengers à poids ouverts, et DeepSeek V4 vs Claude Opus pour le codage explore un autre affrontement ouvert vs fermé. Si vous comparez les agents plutôt que les modèles, consultez Claude Code vs OpenAI Codex.
Testez la comparaison vous-même
Les benchmarks sont un point de départ, pas un verdict pour votre base de code. Le vrai test consiste à exécuter les trois sur vos propres tâches et à lire les résultats. Le Kimi Code CLI vous offre l'agent gratuitement pour commencer, et vous pouvez appeler directement l'API de chaque modèle pour comparer les sorties brutes.
Lorsque vous le faites, testez les endpoints dans Apidog : envoyez la même invite à chaque modèle, enregistrez les appels côte à côte, et comparez la qualité de réponse, la latence et l'utilisation des jetons en un seul endroit. Téléchargez Apidog pour réaliser le test.
FAQ
Kimi K2.7 Code est-il meilleur que Claude Opus ou GPT-5.5 ? Sur les benchmarks de codage rapportés par Moonshot, non ; les modèles fermés obtiennent de meilleurs scores sur la plupart des suites. L'avantage de Kimi est ses poids ouverts et son coût beaucoup plus faible tout en restant à quelques points.
Kimi est-il beaucoup moins cher ? Il coûte 0,95 $ par million de jetons d'entrée et 4,00 $ par million de jetons de sortie, et est gratuit à auto-héberger. Les modèles de pointe fermés coûtent plus cher par jeton et ne peuvent pas être auto-hébergés.
Puis-je exécuter Kimi K2.7 Code moi-même ? Oui. Les poids sont ouverts sous une licence MIT modifiée ; servez-les avec vLLM, SGLang ou KTransformers.
Lequel est le meilleur pour les agents de codage ? Pour la qualité brute, GPT-5.5 est en tête. Pour les agents à volume élevé et économiques, Kimi offre un meilleur rapport qualité-prix, et il est proche sur les benchmarks d'agents.
Ces benchmarks sont-ils neutres ? Plusieurs suites sont propres à Moonshot, il faut donc les lire comme le point de vue du fournisseur. L'écart constant avec la frontière est le signal utile, pas les chiffres exacts.
Résumé
Kimi K2.7 Code ne surpasse pas Claude Opus ou GPT-5.5 sur la plupart des benchmarks de codage, et Moonshot ne prétend pas le contraire. Il obtient quelques points de moins tout en coûtant beaucoup moins cher et en proposant des poids ouverts que vous pouvez exécuter vous-même. Pour la plus haute qualité possible, la frontière fermée l'emporte toujours. Pour les agents à volume élevé, les déploiements privés ou toute personne évaluant la valeur totale plutôt que le sommet du classement, Kimi est le choix le plus judicieux. Exécutez les trois sur votre propre code, comparez les sorties dans Apidog, et laissez votre charge de travail décider.