
La plupart des gens découvrent un nouveau modèle en ouvrant une boîte de discussion et en y tapant du texte. Jev pénalise ce réflexe. C'est le modèle Système Un de TypeSafe AI, et il ne produit pas du tout de prose : vous lui fournissez l'état du programme ainsi qu'un ensemble de questions typées, et il renvoie des décisions accompagnées de probabilités. Ce changement de rôle constitue toute la technique. Votre modèle de langage continue d'écrire ; Jev décide de ce qui se passe ensuite, et votre code décide quoi faire de la décision.
Ce guide couvre l'architecture autour de l'appel, et non l'appel lui-même. Si vous avez d'abord besoin d'une introduction, commencez par ce qu'est Jev, puis lisez le billet de lancement de TypeSafe pour comprendre le cadre de l'entreprise.
Ce en quoi Jev excelle
Trois primitives couvrent tout ce que fait Jev. noul renvoie la probabilité qu'une affirmation concernant l'état soit vraie. choice sélectionne une option parmi une carte de critères (jusqu'à 255 options) et renvoie le choix, la distribution de probabilité complète et une valeur de confiance. score positionne l'état sur une grille ordonnée de 2 à 10 niveaux et renvoie le niveau, une légende, les probabilités et la confiance. Les informations générales sur l'entreprise et la famille de modèles se trouvent dans notre article sur TypeSafe AI.
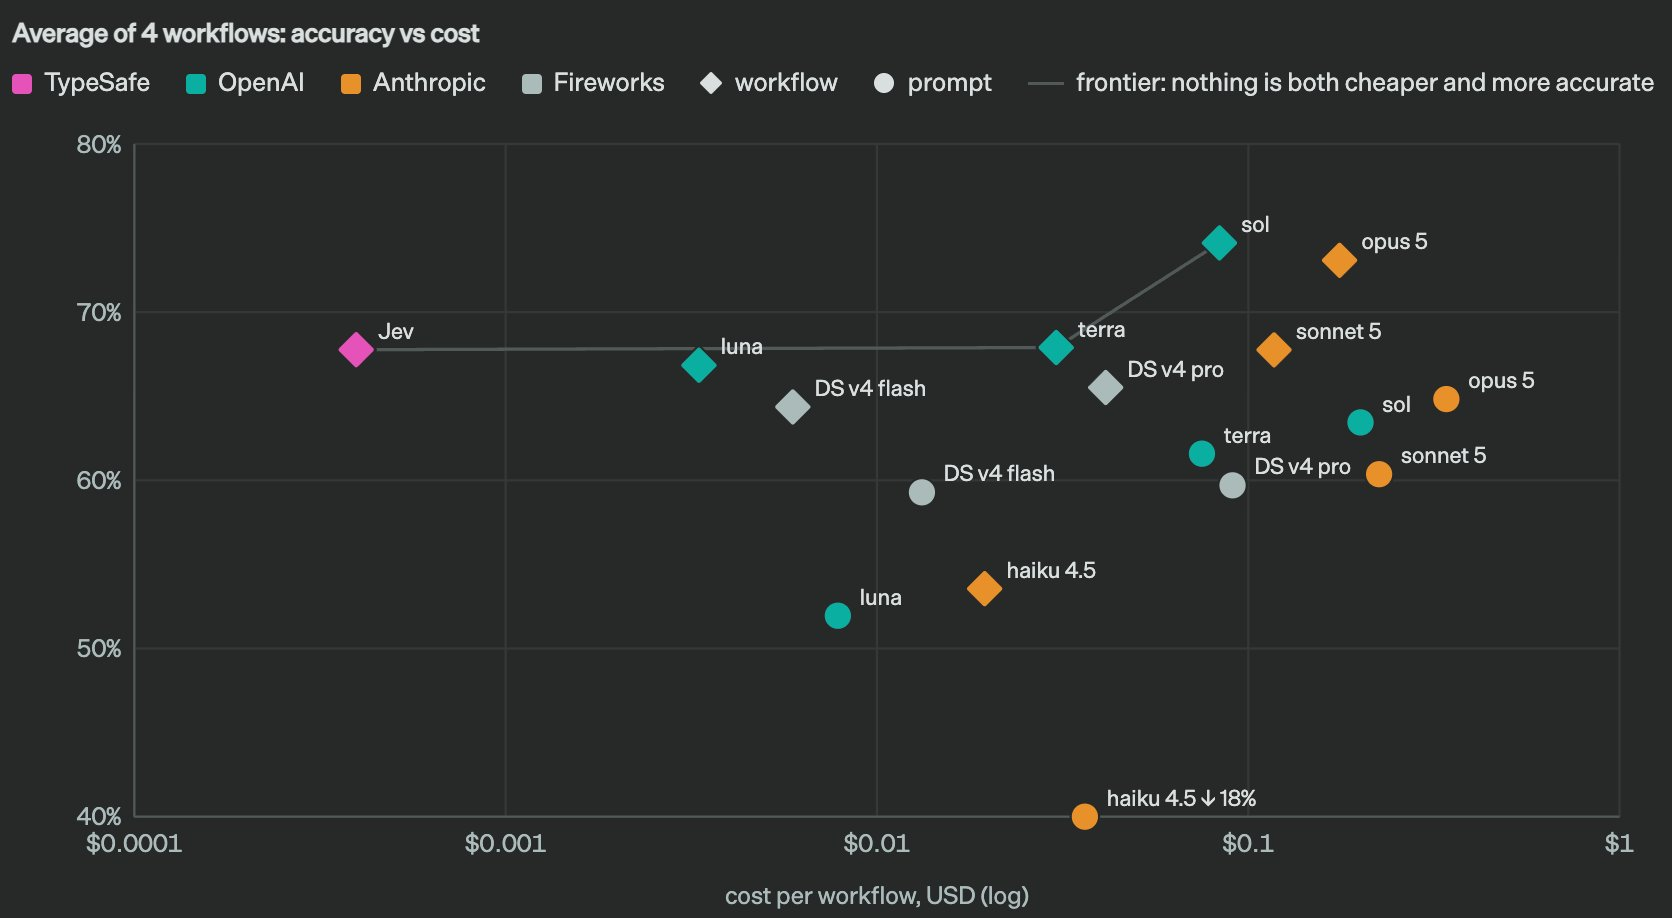
Quatre propriétés sont importantes pour l'architecture. Chaque réponse arrive dans un type que votre programme comprend déjà. Chaque réponse porte sa propre incertitude, de sorte que « pas sûr » devient une branche plutôt qu'une surprise. De nombreuses questions sur un même état se résolvent en un seul passage. Et à 0,042 $ par million de jetons d'entrée, sans frais pour les jetons de sortie, vous pouvez vous permettre de poser la question à chaque événement plutôt que sur un échantillon.
Utilisez Jev comme juge, pas comme rédacteur
Quatre rôles, clairement séparés :
- Le LLM génère. Du code, un brouillon d'e-mail, un résumé, un plan.
- Jev décide. Il classe la requête, évalue le risque, choisit l'itinéraire et vérifie la sortie par rapport aux critères que vous avez définis à l'avance.
- Votre code contrôle. Les seuils et les règles décident s'il faut agir, réessayer, escalader ou arrêter.
- Un humain gère les cas limites. Une faible confiance associée à des enjeux élevés est transmise à une personne.
Voici pourquoi cette séparation fonctionne. Un modèle de langage est flexible car il peut émettre n'importe quoi, et cette même liberté le rend difficile à intégrer dans un flux de travail dont vous dépendez. Le cadre de TypeSafe est que Jev « abandonne la génération de chaînes de caractères » et gagne en retour un contrat étroit : l'ensemble des réponses possibles est fixé avant que la requête ne quitte votre serveur, chaque résultat correspond à la forme déclarée, et l'incertitude est un nombre que vous pouvez comparer à un seuil.
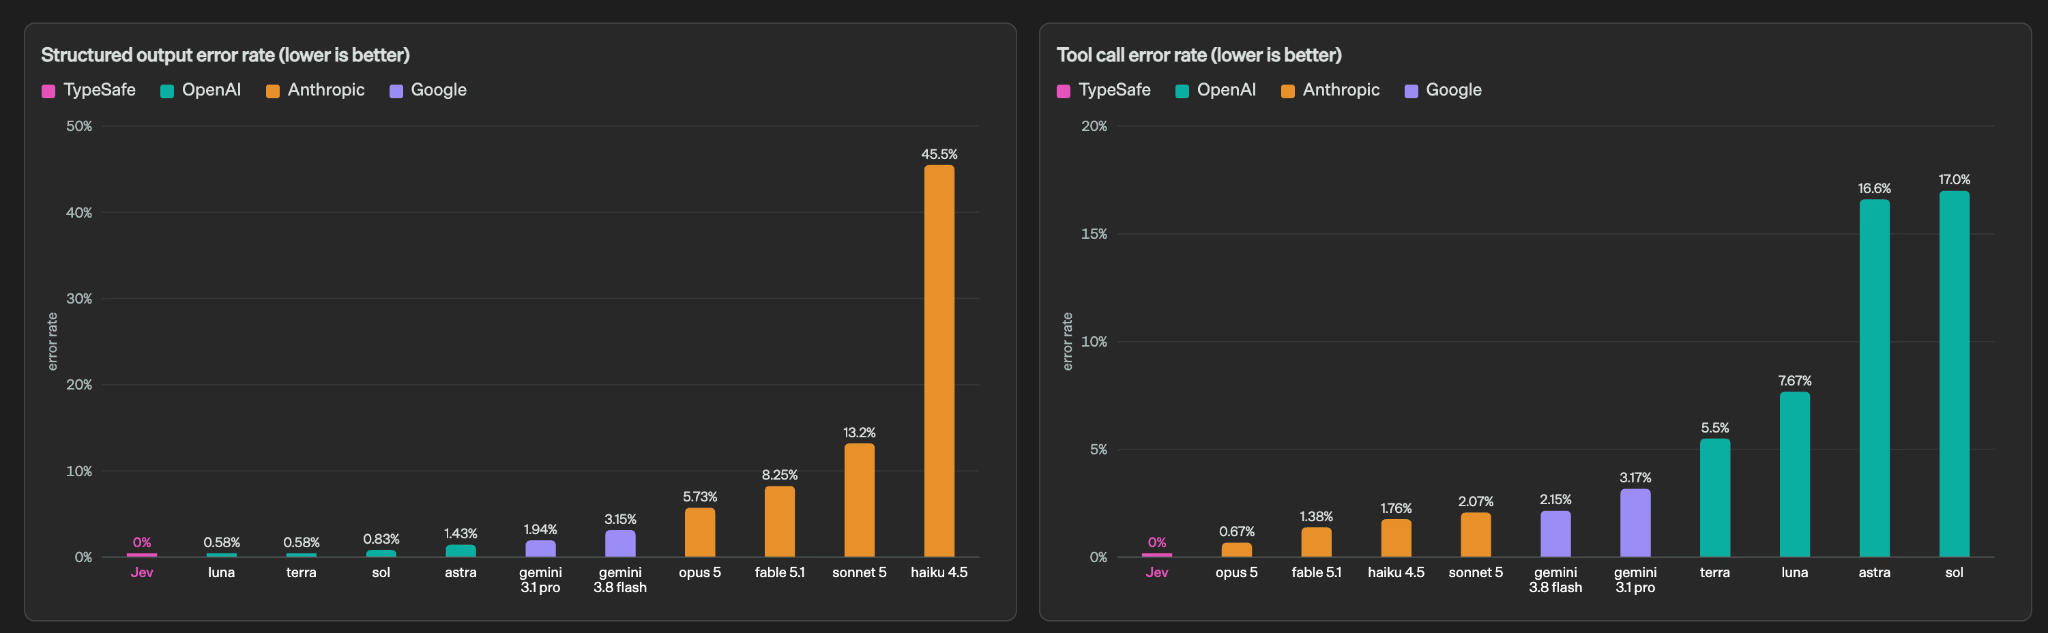
Le côté coût découle du même compromis. TypeSafe rapporte des temps de réponse de bout en bout de 70 ms à 500 ms, et revendique des chiffres de 193,6 fois plus rapide et 444,6 fois moins cher sur les flux de travail qu'il a testés. Considérez ces chiffres comme des données de fournisseur, non comme des benchmarks indépendants. Le point structurel demeure quoi qu'il en soit : le modèle coûteux ne s'exécute que lorsqu'il y a réellement quelque chose à écrire, et les jugements répétés autour de lui s'exécutent à moindre coût.
Concevoir des questions auxquelles Jev peut répondre
Chaque requête contient un état partagé et un ensemble de questions indépendantes. Jev lit l'état une seule fois et répond à toutes les questions. Un appel de triage de support ressemble à ceci :
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
Trois habitudes distinguent les questions efficaces des questions bancales.
Arrêtez d'écrire des prompts. Les personas, les exemples concrets et les longs préambules dirigent un générateur de texte. Jev ne génère pas de texte. Il a besoin de l'état, d'une question atomique et d'une description exacte de ce que signifie chaque réponse. Les critères descriptifs sont plus efficaces que les simples étiquettes : « Paiements, frais, factures, modifications d'abonnement » oriente mieux que le mot « facturation » seul. Ne lui demandez pas non plus de s'expliquer, car la réponse contient une décision, des probabilités et une confiance, et rien d'autre.
Une question, un jugement. « Ce prospect est-il précieux, urgent et susceptible d'acheter ? » est trois questions déguisées en une seule. Séparez-les et combinez les résultats dans le code, où vous pourrez voir les pondérations et les modifier.
Éloignez l'arithmétique du modèle. Jev juge le sens. Votre programme effectue les calculs, applique le tableau de remises et vérifie les conditions contractuelles. Cette division est ce qui rend l'ensemble auditable.
TypeSafe propose également une compétence prête à l'emploi qui enseigne ces conventions aux agents de codage, installable dans Claude Code avec claude plugin marketplace add typesafe-ai/skills ou ailleurs avec npx skills add typesafe-ai/skills. La page de la compétence d'agent contient les détails.
Gardez l'état propre
Un état pertinent est préférable à un état maximal. Trois sections le couvrent généralement : l'objet jugé, le contexte nécessaire pour lire cet objet, et les faits qui modifieraient la décision s'ils changeaient. Tout le reste est du bruit que vous payez pour envoyer.
Supprimez les lignes de log dupliquées, l'historique antérieur au problème actuel, et toute phrase qui énonce la conclusion que vous espérez que le modèle atteigne. Le plafond strict est de 64 000 jetons par requête, avec 32 000 disponibles pour l'état plus la question la plus longue, mais la précision peut varier bien avant d'atteindre cette limite. Lorsque le routage devient flou, réduire l'état est généralement une solution plus rapide que de réécrire les critères.
Questions parallèles et seuils de confiance
Comme Jev lit l'état une seule fois, la treizième question coûte beaucoup moins cher qu'un second aller-retour. Envoyez chaque jugement indépendant susceptible de modifier une action : intention, risque, urgence, sentiment, pertinence, étape suivante requise. Supprimez ensuite toute question dont la réponse ne modifie jamais ce que fait votre code. Un signal inutilisé est un coût de maintenance sans bénéfice.
Adaptez la primitive à la forme du jugement. Les gradations comme la sévérité, la qualité et l'adéquation appartiennent à score, et non à un oui/non forcé. Une seule affirmation factuelle appartient à noul. Un ensemble fixe de destinations appartient à choice.
Le seuil est l'endroit où l'architecture réside réellement. Une réponse typée peut toujours être une mauvaise réponse, donc la confiance décide de la suite des événements. Un modèle de départ fonctionnel : agir automatiquement au-dessus de 0,85, transmettre de 0,55 à 0,85 à un modèle plus puissant ou à une deuxième passe, et mettre en file d'attente tout ce qui est en dessous de 0,55 pour une personne. Ces nombres exacts sont illustratifs. Le modèle de routage par confiance de TypeSafe définit un seuil séparé par action basé sur le coût de l'erreur, et sa page de confiance vous dit de « tester avec vos propres données et d'ajuster au fur et à mesure que vous observez les résultats ». Une fois vos seuils ajustés, épinglez le modèle : jev-latest suit la dernière version stable, tandis que jev-1.13.0 fige le comportement que vous avez mesuré.
Testez la couche de décision dans Apidog
Une couche de décision ne vaut d'être fiable que si vous pouvez prouver son comportement. Cela signifie des requêtes et des assertions sauvegardées, et non un historique de commandes `curl` ponctuelles. Apidog vous offre les deux, et les assertions sont différentes des tests API normaux car vous vérifiez des nombres et des valeurs énumérées au lieu de chaînes de caractères.
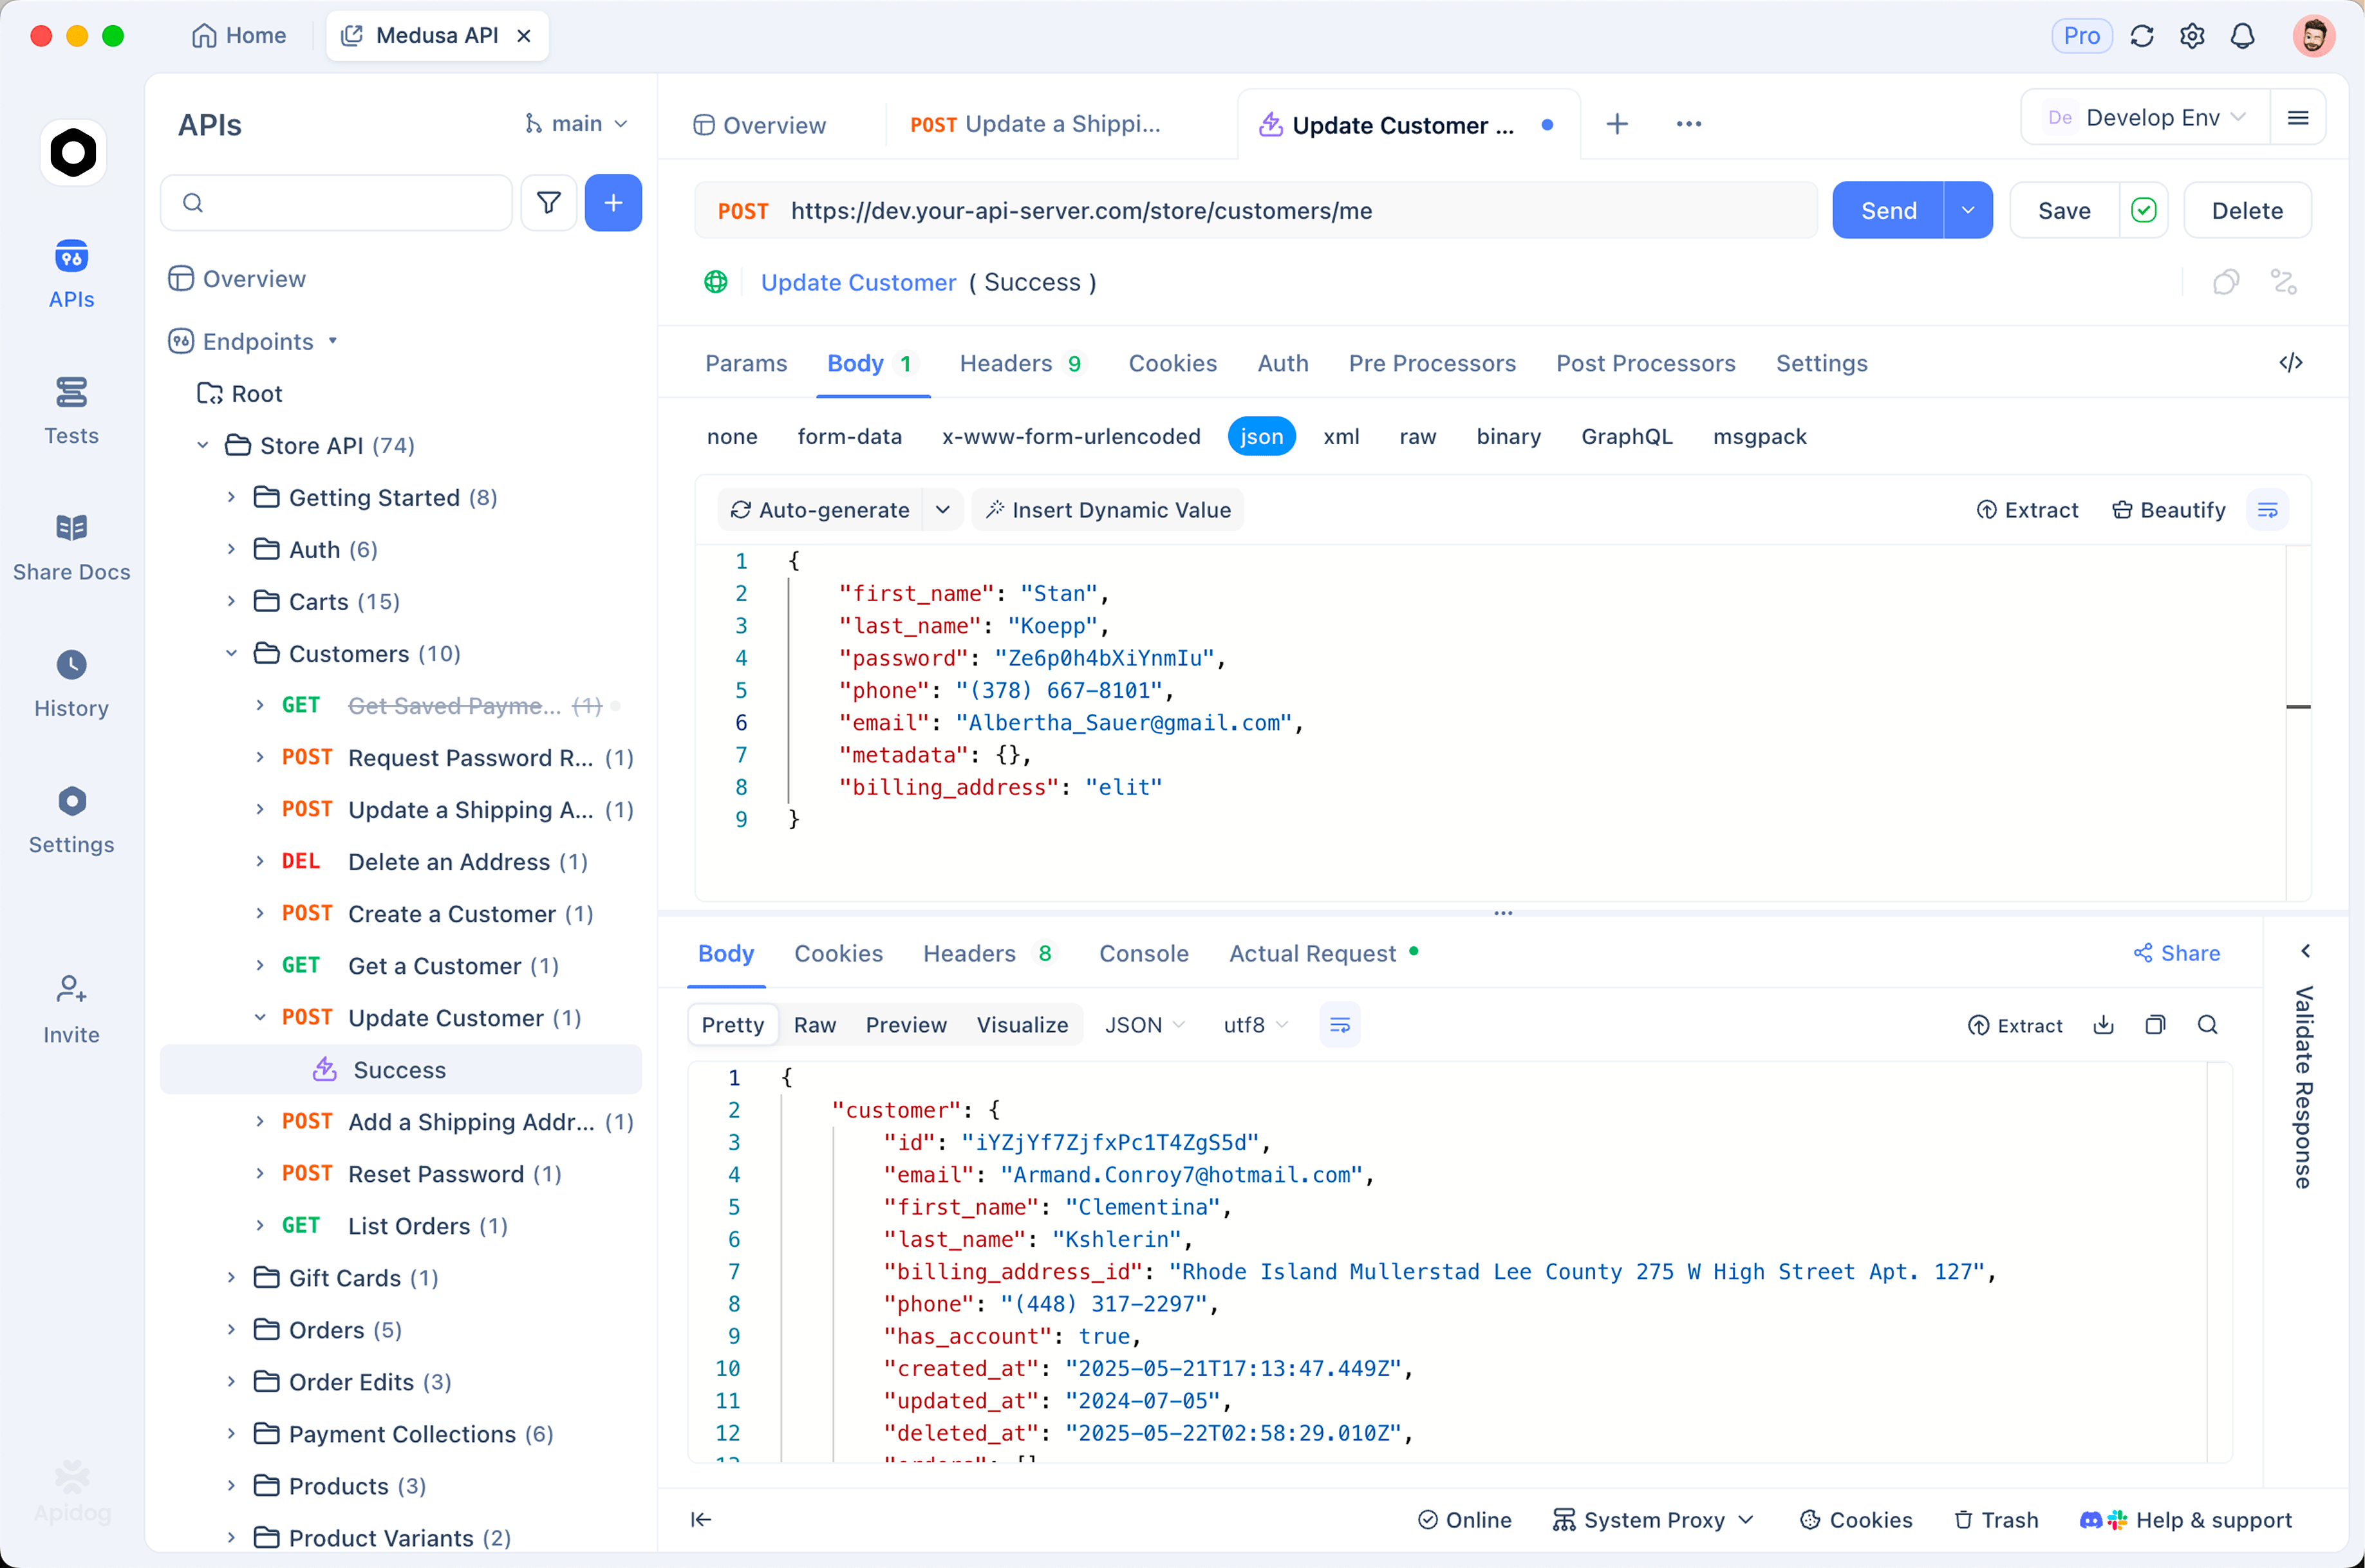
Stockez la clé comme variable d'environnement. Créez un environnement nommé TypeSafe, ajoutez TYPESAFE_API_KEY comme valeur locale pour qu'elle reste sur votre machine, et référencez-la comme {{TYPESAFE_API_KEY}} dans un jeton Bearer. Notre guide sur les environnements et variables secrètes couvre les règles de portée.
Envoyez l'appel réel. POST https://api.typesafe.ai/v1/systemone avec le corps état-plus-questions ci-dessus.
Affirmez la décision. Ajoutez des assertions de post-traitement comme answers.department.choice égal à billing, answers.urgent.noul supérieur à 0.9, et answers.frustration.score supérieur à 1.5. Désormais, un changement de comportement fait échouer un test au lieu de mal acheminer les tickets discrètement.
Puis construisez le scénario qui compte. Enregistrez un petit ensemble d'états étiquetés comme scénario de test : une question calme, une menace d'annulation en colère, et un message délibérément ambigu sur lequel un bon routeur devrait hésiter. Affirmez une confiance élevée sur les deux premiers et affirmez que la confiance chute en dessous de votre seuil sur le troisième. Ce scénario unique transforme le réglage des seuils en preuve plutôt qu'en conjecture, et il détecte l'échec le plus difficile à remarquer manuellement : quelqu'un reformule une description de critère, chaque réponse est toujours valide, et le routage se décale discrètement. Exécutez-le en CI et la réécriture échoue à la compilation.
Simulez la forme de la réponse afin que le travail frontend ne consomme pas de jetons. Étant donné que l'objet answers est déclaré avant la requête, la simulation et la réponse réelle ne peuvent pas diverger. Téléchargez Apidog pour configurer cela ; le plan gratuit couvre une équipe de quatre personnes.
Cinq flux de travail où une couche de décision est rentabilisée
- Le vérificateur universel. Enveloppez chaque appel coûteux de LLM. Vérifiez le prompt entrant pour l'injection, l'outil sélectionné pour les incompatibilités évidentes, la sortie pour les exigences manquantes, et la réponse finale pour les affirmations non étayées par le matériel source. Des vérifications bon marché autour d'un cerveau coûteux.
- La tour de contrôle du support. Classez le ticket, détectez l'urgence, la frustration, l'intention de remboursement et le risque d'annulation en un seul appel, puis acheminez. Le bénéfice est moins de tickets dans la mauvaise file d'attente et moins de comptes précieux laissés en suspens.
- Qualification des leads. Évaluez l'adéquation à l'entreprise, la maturité technique, la douleur exprimée, l'intention d'achat et l'urgence comme des signaux distincts, puis combinez-les avec des pondérations que vous possédez et pouvez défendre lors d'une revue de pipeline.
- Le routeur de modèles. Décidez par requête si le code déterministe, un petit modèle, un modèle de pointe ou un humain doit le gérer. C'est généralement là que les économies de coûts apparaissent en premier.
- Tâches sur de grands ensembles de données. Exécutez les mêmes jugements sémantiques sur les journaux de support, les avis, les fiches, les transcriptions ou les traces d'agents pour extraire des caractéristiques structurées et classer les enregistrements qui méritent un examen humain. Une analyse qui ne devient pratique que lorsque chaque décision est rapide et presque gratuite.
FAQ
Ai-je encore besoin d'un modèle de langage ? Oui. Jev ne peut pas écrire la réponse, le résumé ou le code. Il décide quel système doit le faire, et il peut ensuite évaluer le brouillon par rapport à des critères explicites tels que la conformité à la politique ou si la réponse contient une promesse que vous ne faites pas.
En quoi est-ce différent du mode JSON ou des sorties structurées ? Les sorties structurées contraignent le formatage d'un modèle de texte ; le modèle génère toujours des jetons et peut toujours affirmer quelque chose de faux sous une forme valide. Jev renvoie une distribution de probabilité sur un ensemble de réponses que vous avez définies, de sorte que l'incertitude est un champ de premier ordre. Notre explication sur les sorties structurées d'OpenAI couvre l'autre aspect de cette comparaison.
Comment puis-je y accéder ? Jev est en accès anticipé avec une liste d'attente, ce n'est donc pas encore en libre-service. TypeSafe fait passer les développeurs de la liste par lots, et vous vous connectez sur console.typesafe.ai une fois que vous avez accès. Il est également disponible via Vercel AI Gateway sous le nom typesafe-ai/jev via experimental_evaluate dans AI SDK 7, qui est SDK-only et non exposé sur les points de terminaison compatibles OpenAI. Notre tutoriel sur l'obtention d'une clé API Jev contient les détails de la requête et du SDK.
Puis-je exécuter quelque chose de similaire localement ? Plusieurs projets reproduisent des parties de l'idée avec un décodage contraint sur des poids ouverts. Nous les avons comparés dans OpenJev et les alternatives open source à Jev, y compris la fidélité de chacun à la confiance calibrée.
Où cela vous mène
Jev n'est pas le modèle qui remplace vos autres modèles. C'est la couche qui décide quand, où et si ils s'exécutent. Construisez-le ainsi : un état propre, des questions atomiques avec des critères explicites, une évaluation parallèle, et un seuil de confiance devant chaque action. Prouvez ensuite que le seuil fonctionne avec un scénario sauvegardé dans Apidog avant qu'il n'achemine un seul ticket réel.