
DeepSeek V4 Pro a quitté la préversion le 12 août 2026. La version GA, estampillée 0813, alimente désormais le point d'API deepseek-v4-pro et est livrée avec des chiffres qui ressemblent à des fautes de frappe : une fenêtre contextuelle d'un million de jetons, 384 000 jetons de sortie maximale et un prix d'entrée qui tombe à 0,003625 $ par million de jetons sur les accès au cache. Comme l'a rapporté Unite.AI, le modèle qui a passé quatre mois en préversion est désormais le produit phare de DeepSeek.
La couverture du lancement vous indique ce qui a été livré, pas comment l'appeler. Ce guide couvre la partie pratique : première requête avec le SDK OpenAI, les modes de réflexion et le champ reasoning_content, le streaming, l'appel d'outils, et le calcul du cache de prompt qui décide si ce contexte de 1 million est abordable ou ruineux. Si vous souhaitez d'abord connaître l'historique de l'architecture, lisez Qu'est-ce que DeepSeek V4 et revenez ensuite.
TL;DR
- DeepSeek-V4-Pro-0813 est l'instantané GA derrière le point d'accès
deepseek-v4-proà partir du 12 août 2026, la version à cibler en production. - L'API est compatible OpenAI : dirigez le SDK
openaivershttps://api.deepseek.com, définissezmodel="deepseek-v4-pro", et c'est fait. Le format Anthropic Messages et l'API DeepSeek Responses fonctionnent également. - Contexte d'un million de jetons, sortie maximale de 384 000 jetons, trois modes de réflexion (
non-think,think high,think max) qui renvoient un champreasoning_contentavec la réponse. - Tarification : 0,435 $/M en entrée (manque de cache), 0,003625 $/M en entrée (accès au cache, 120 fois moins cher), 0,87 $/M en sortie. Le cache est automatique sur les préfixes de prompt répétés.
- DeepSeek a averti le 6 août qu'une augmentation de prix « significative » de l'API est à venir. Aucun chiffre ni date n'est encore disponible, prévoyez donc une marge de manœuvre.
- Testez le point d'accès, inspectez le flux SSE et gardez les environnements pro/flash côte à côte dans Apidog avant de l'intégrer à quoi que ce soit de réel.
Ce que la version GA 0813 change pour les développeurs
La préversion a été ouverte en avril 2026, le modèle V4 Flash, son petit frère, a été livré en juillet, et le 12 août, le modèle Pro est passé en disponibilité générale sous la version 0813, suivant la convention habituelle de DeepSeek pour les horodatages (de la même manière que v3-0324 marquait un instantané de V3).
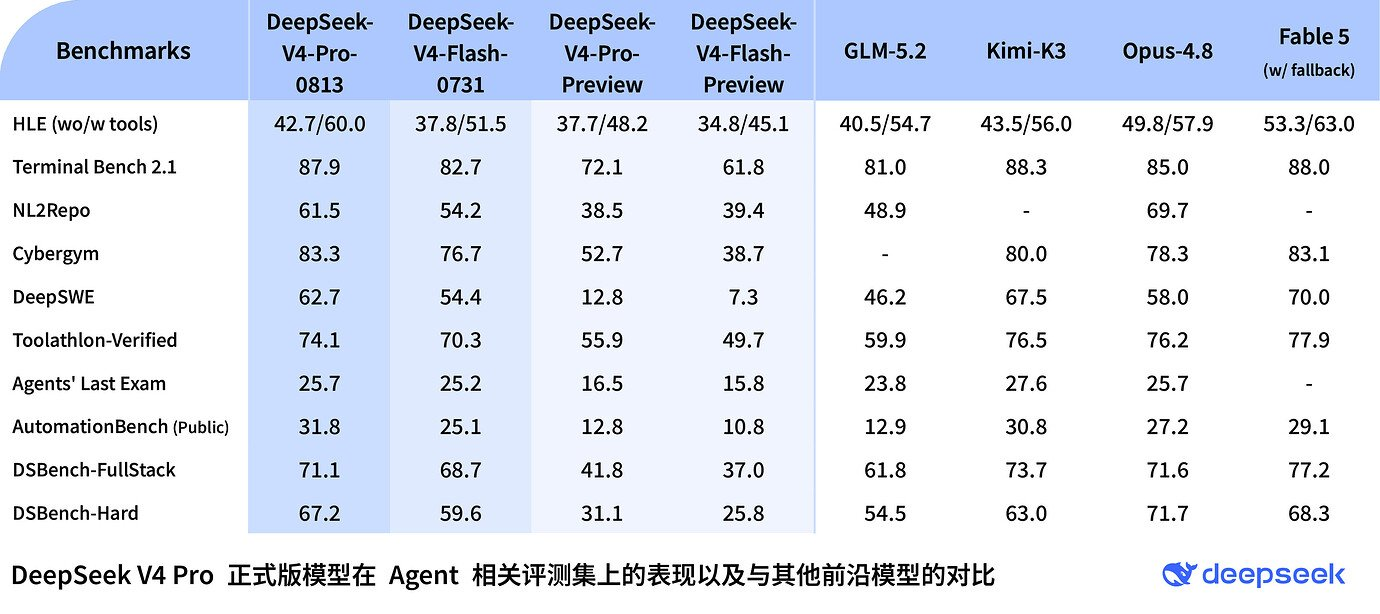
Trois choses changent avec la GA :
- L'instantané est stable. Les modèles en préversion peuvent changer, ce qui invalide silencieusement les évaluations et l'ajustement des prompts. La version 0813 est une cible fixe jusqu'à ce que DeepSeek annonce un nouvel instantané.
- Le point d'accès est l'alias de production. Sur l'API officielle, vous appelez
deepseek-v4-proet obtenez la version 0813 ; pour épingler explicitement l'instantané, OpenRouter le liste commedeepseek/deepseek-v4-pro-0813. - Toutes les fonctionnalités sont activées. Les modes de réflexion, l'appel de fonctions, les sorties structurées, le cache de prompt et l'API multi-format (OpenAI, Anthropic, Responses) sont tous actifs sur le point d'accès GA.
En interne, V4 Pro est un modèle de mélange d'experts avec un total de 1,6 trillion de paramètres et 49 milliards actifs par jeton. La principale histoire d'ingénierie est l'efficacité : deux schémas d'attention, Compressed Sparse Attention et Heavily Compressed Attention, réduisent le calcul d'inférence d'un seul jeton à 27 % de celui de V3.2 et le cache KV à 10 %. Cette réduction du cache KV est ce qui rend un contexte d'un million de jetons utilisable à ces prix plutôt qu'une fonction de démonstration.
DeepSeek V4 Pro 0813 : spécifications en un coup d'œil
| Spécification | DeepSeek V4 Pro 0813 |
|---|---|
| Date de sortie | GA le 12 août 2026 (instantané 0813) |
| Architecture | Mélange d'experts, 1,6 billion de paramètres au total, 49 milliards actifs par jeton |
| Mécanisme d'attention | Compressed Sparse Attention + Heavily Compressed Attention |
| Coût d'inférence vs V3.2 | 27 % du calcul d'un seul jeton, 10 % du cache KV |
| Fenêtre contextuelle | 1 000 000 de jetons |
| Sortie maximale | 384 000 jetons |
| Modes de réflexion | non-think, think high, think max |
| Prix en entrée | 0,435 $/M jetons (manque de cache), 0,003625 $/M (accès au cache) |
| Prix en sortie | 0,87 $/M jetons |
| Formats d'API | OpenAI Chat Completions, Anthropic Messages, DeepSeek Responses |
| ID du modèle | deepseek-v4-pro |
| Modèle plus petit | deepseek-v4-flash (284 milliards au total / 13 milliards actifs), 0,14 $/M en entrée, 0,28 $/M en sortie |
En termes de capacités, la fiche technique de DeepSeek indique SWE-bench Verified à 80,6 %, Terminal Bench 2.0 à 67,9 %, GPQA Diamond à 90,1 % et LiveCodeBench à 93,5 % pour V4-Pro-Max, la configuration de réflexion maximale. Ce sont des chiffres auto-déclarés par le fournisseur que personne n'a encore vérifiés, alors effectuez vos propres évaluations spécifiques à la tâche avant de migrer quoi que ce soit d'important.
Obtenez une clé API et faites votre première requête
La configuration prend environ cinq minutes :
- Créez un compte sur la plateforme DeepSeek (platform.deepseek.com) et ajoutez du crédit, l'API est prépayée.
- Ouvrez les clés API, générez une clé et copiez-la immédiatement (elle n'est affichée qu'une seule fois).
- Exportez-la comme variable d'environnement plutôt que de la coller dans le code :
export DEEPSEEK_API_KEY="sk-..."
L'API utilise le protocole OpenAI Chat Completions, le package openai standard est donc le client. https://api.deepseek.com et https://api.deepseek.com/v1 fonctionnent tous deux comme URL de base ; le /v1 est une compatibilité de protocole, pas une version de modèle.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Affichez response.usage dès le premier jour. Avec un modèle aussi bon marché sur les accès au cache et aussi cher sur les manques de cache d'un million de jetons, la comptabilité des jetons fait la différence entre une erreur d'arrondi et une facture réelle.
La même requête via HTTP brut, utile pour les tests de fumée et pour l'importation dans les outils d'API :
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
La référence complète des paramètres se trouve dans la documentation officielle de DeepSeek, y compris le point d'accès compatible Anthropic (utilisable depuis le SDK Anthropic et Claude Code sans rien réécrire) et l'API DeepSeek Responses.
Travailler avec les trois modes de réflexion
V4 Pro expose le raisonnement comme un cadran plutôt qu'un modèle distinct. Un point d'accès, trois modes :
- non-think : le modèle répond directement. Le plus rapide et le moins cher, adapté à l'extraction, la classification, le formatage et les résumés.
- think high : le modèle raisonne avant de répondre et renvoie ce raisonnement dans un champ
reasoning_content. C'est le mode par défaut pour le codage, le débogage et l'analyse en plusieurs étapes. - think max : budget de raisonnement maximal, la configuration derrière les chiffres de référence V4-Pro-Max. Réservez-le aux problèmes vraiment difficiles.
Les modes correspondent au paramètre standard reasoning_effort, aucune configuration spécifique au fournisseur n'est donc nécessaire :
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
Deux notes pratiques. Premièrement, ne réintroduisez jamais reasoning_content dans l'historique de la conversation ; envoyez uniquement le content des tours précédents. Deuxièmement, les jetons de raisonnement sont facturés comme des jetons de sortie à 0,87 $/M, donc think max coûte de l'argent et entraîne une latence réelle. Adaptez le mode à la tâche au lieu de le régler par défaut au maximum.
Streaming des réponses
Avec une sortie maximale de 384 000 jetons et des modes de réflexion qui peuvent raisonner longuement, les requêtes sans streaming offrent une mauvaise expérience utilisateur. Définissez stream=True et gérez les deux types de delta : dans les modes de réflexion, les blocs reasoning_content arrivent en premier, puis la réponse :
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
Un modèle d'interface utilisateur judicieux : afficher la phase de raisonnement réduite à un indicateur « réflexion », puis passer à l'affichage normal lorsque les deltas de content commencent. En coulisses, il s'agit d'événements envoyés par le serveur standard ; notre guide sur le streaming des réponses API avec SSE couvre les mécanismes.
Appel d'outils et sorties structurées
V4 Pro prend en charge l'appel de fonctions de style OpenAI, ce qui signifie que les boucles d'agent existantes peuvent être portées sans modification. Définissez les outils, lisez les tool_calls, exécutez, ajoutez les résultats, répétez :
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
Les sorties structurées fonctionnent via le paramètre standard response_format lorsque vous avez besoin d'un JSON garanti et parsable. Une présentation complète des boucles d'outils multi-étapes mérite son propre article ; la documentation officielle couvre les détails de la structure des messages.
Économie du cache de prompt : le chiffre qui change votre architecture
Voici la spécification qui mérite plus d'attention que les benchmarks. DeepSeek met en cache automatiquement les préfixes de prompt, sans en-têtes de contrôle de cache ni configuration TTL, et les préfixes répétés sont facturés 0,003625 $/M au lieu de 0,435 $/M. C'est une réduction de 120 fois pour les entrées que l'API a déjà vues.
Faites les calculs sur une charge de travail réaliste. Supposons que vous construisiez un agent de codage qui détient un contexte de dépôt de 200 000 jetons et effectue 50 appels dans une session :
- Sans cache : 50 appels × 200 000 jetons × 0,435 $/M ≈ 4,35 $ en coûts d'entrée.
- Avec le cache automatique : un manque de cache (0,087 $) + 49 accès au cache (≈ 0,0007 $ chacun) ≈ 0,12 $.
Même session, environ 35 fois moins cher, et il suffit d'une structure de prompt : contenu stable en premier (prompt système, documentation, contexte du dépôt), contenu volatile en dernier (le dernier message de l'utilisateur, horodatages, ID de requête). Toute modification au début du prompt invalide le préfixe mis en cache à partir de ce point, de sorte qu'un horodatage dans votre prompt système convertit silencieusement chaque appel en un manque de cache à prix plein.
Cela recadre également la fenêtre contextuelle d'un million de jetons : la remplir coûte 0,435 $ en cas de manque, mais en tant que préfixe de session stable, elle coûte environ un tiers de centime par appel. Pour la théorie générale, consultez Qu'est-ce que le cache de prompt.
Tester deepseek-v4-pro dans Apidog
Avant que V4 Pro n'approche du code de production, soumettez le point d'accès à un débogueur approprié. Étant donné que l'API de DeepSeek est compatible OpenAI, Apidog la prend en charge sans manipulation spéciale :
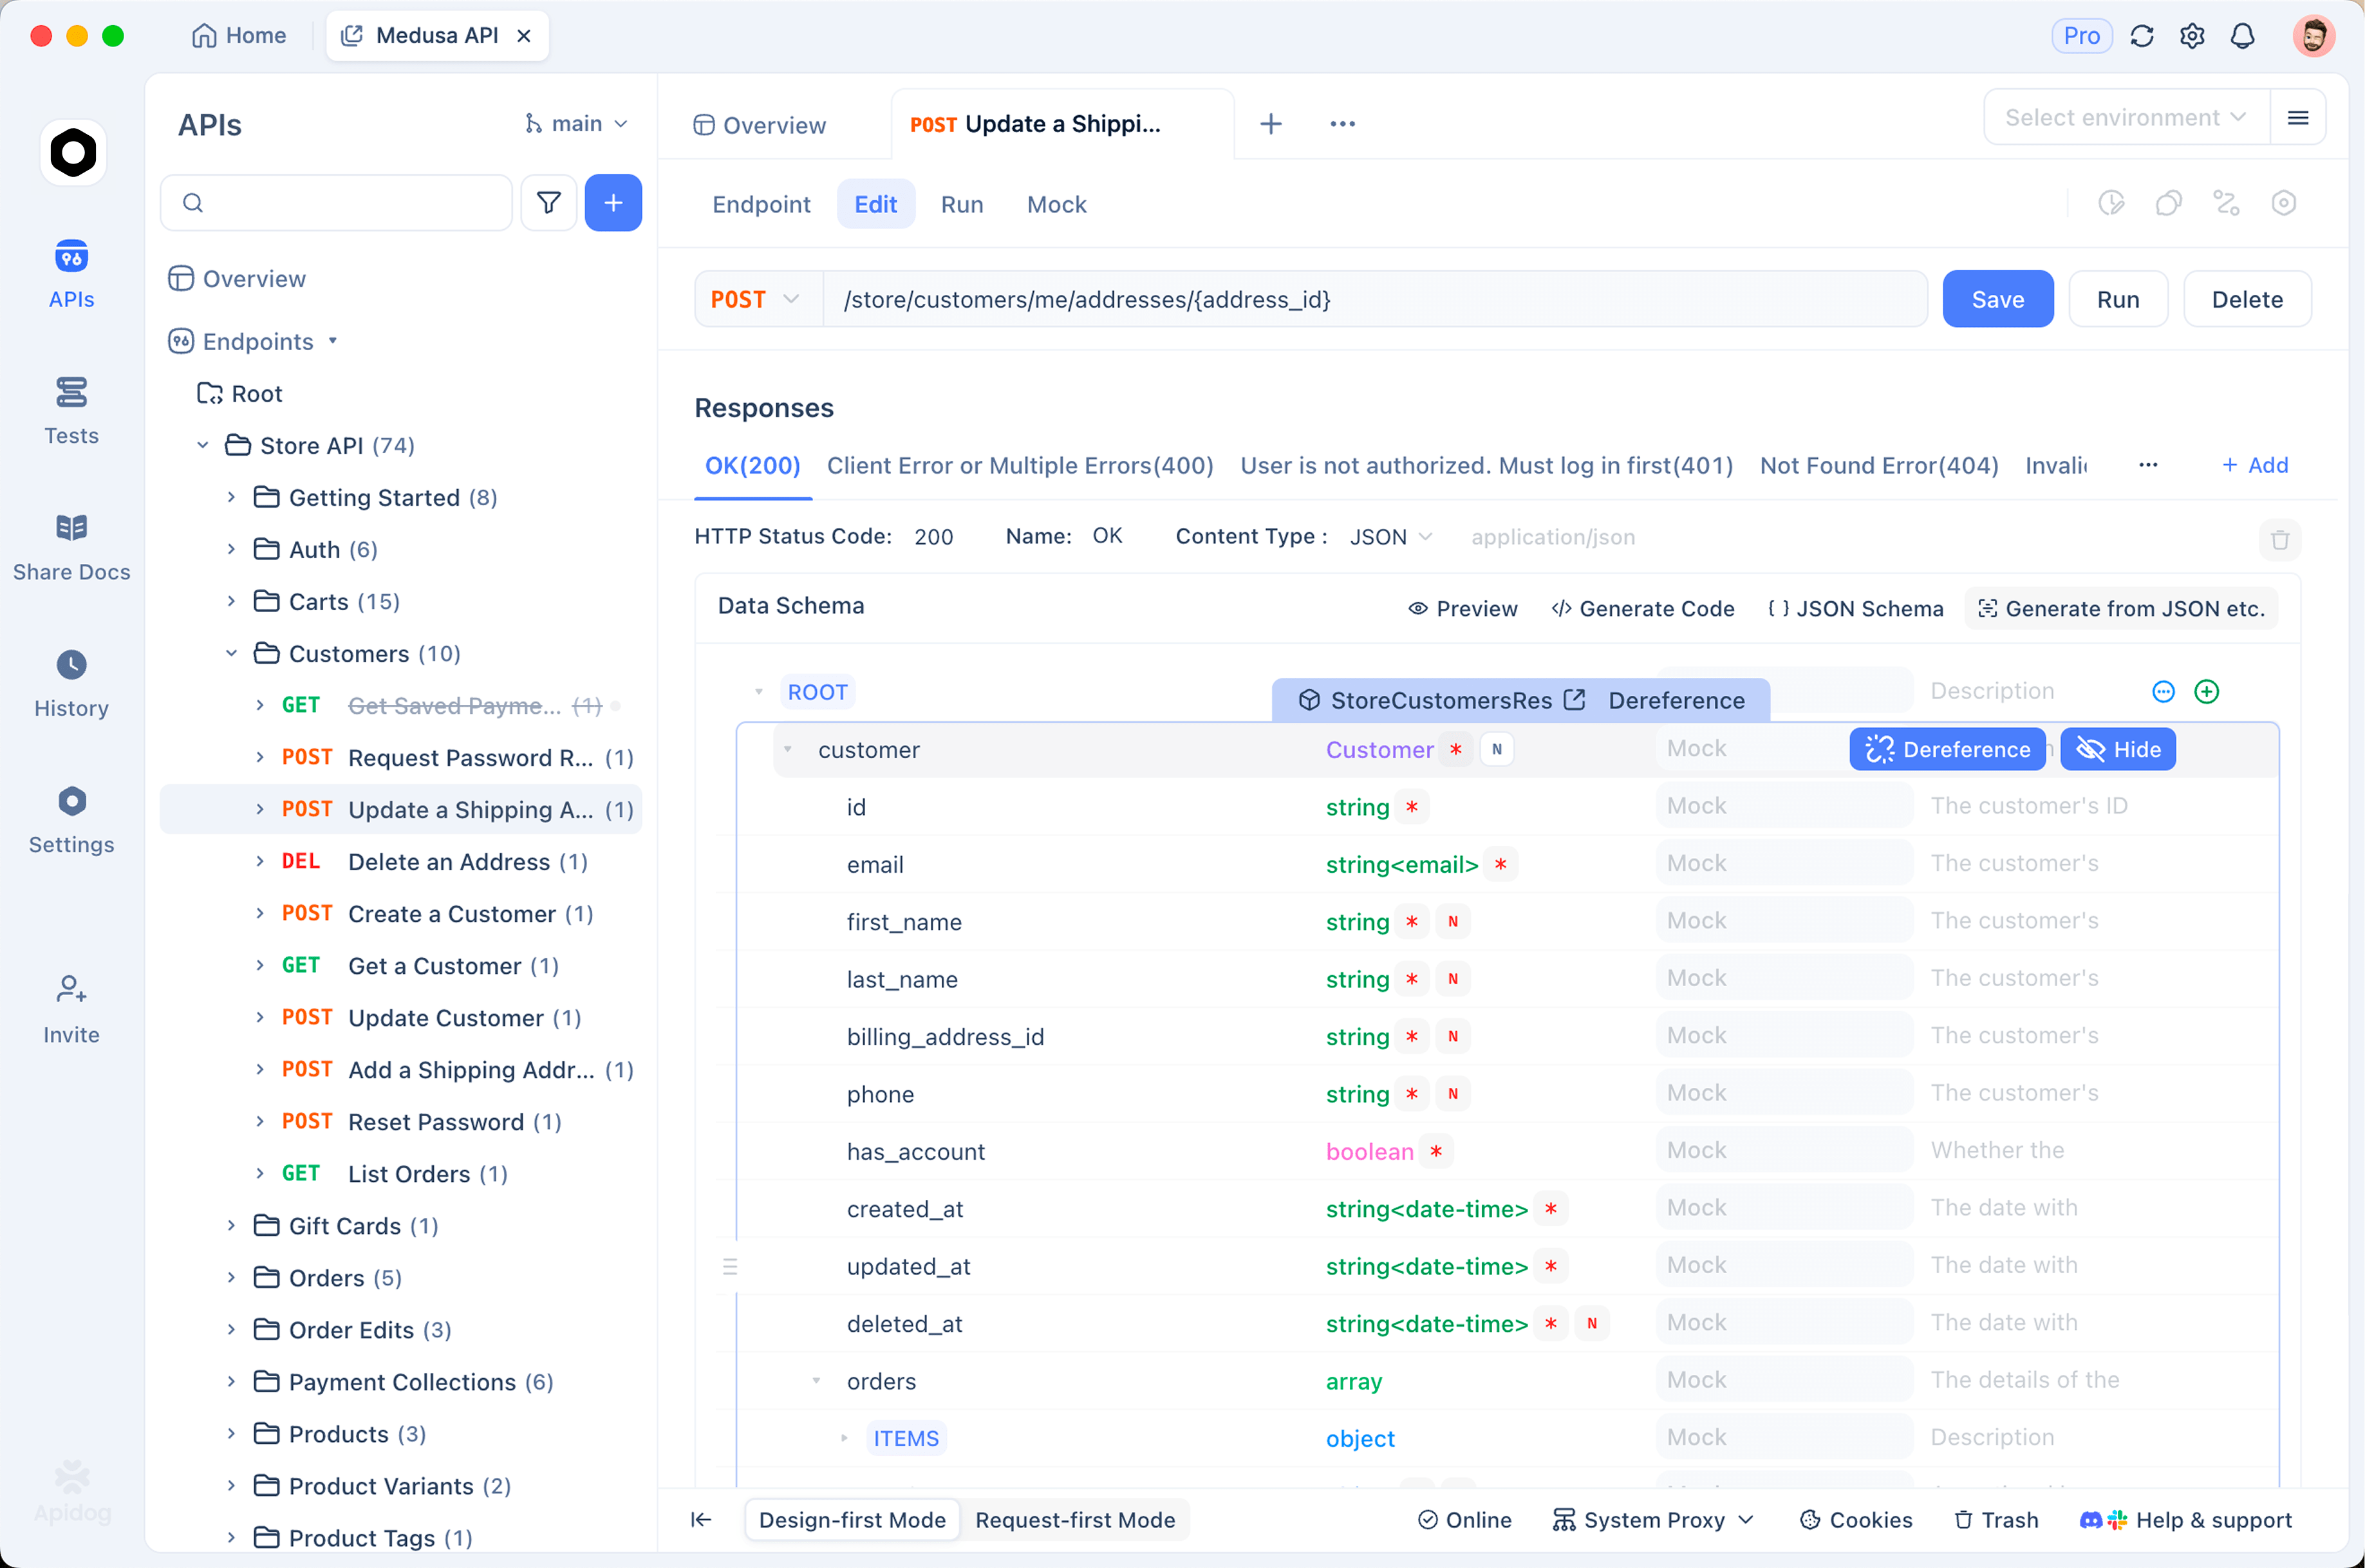
- Importez le point d'accès. Collez la commande curl précédente dans Apidog et elle devient une requête éditable, les en-têtes, l'authentification et le corps étant automatiquement analysés.
- Configurez des environnements pour Pro et Flash. Stockez
base_urlet votre clé API comme variables d'environnement, et faites du nom du modèle une variable également. Le passage entredeepseek-v4-proetdeepseek-v4-flashdevient un changement d'environnement en un clic, ce qui fait de la question « Pro vaut-il 3 fois le prix de Flash sur ce prompt ? » une question empirique plutôt qu'un débat. - Inspectez le flux SSE. Envoyez une requête avec
"stream": trueet Apidog affiche le flux d'événements comme une chronologie en direct au lieu d'un mur de lignesdata:brutes, fusionnant les deltas pour que vous puissiez voirreasoning_contentarriver avant la réponse. Lorsqu'un appel en mode think-max semble lent, cette vue vous montre exactement où le temps est passé. - Enregistrez la session en tant que collection. Lorsque DeepSeek livrera le prochain instantané, réexécutez les mêmes requêtes et comparez le comportement avant de passer à la mise à niveau, le même flux de travail que les équipes utilisent généralement pour les points d'accès compatibles OpenAI.
La visionneuse de réponses affiche également le bloc usage sur chaque requête, ce qui est le moyen le plus rapide de vérifier votre taux d'accès au cache pendant que vous ajustez la structure du prompt.
Tarification actuelle et augmentation à venir
Prix catalogue actuels pour les deux points d'accès V4 :
| Modèle | Entrée (manque) | Entrée (accès au cache) | Sortie |
|---|---|---|---|
deepseek-v4-pro |
0,435 $/M | 0,003625 $/M | 0,87 $/M |
deepseek-v4-flash |
0,14 $/M | 0,28 $/M |
Même aux prix Pro, cela sous-cote largement les modèles frontaliers occidentaux. Mais planifiez en tenant compte d'une mise en garde : le 6 août 2026, six jours avant la GA, DeepSeek a averti qu'une augmentation de prix « significative » de l'API est à venir, sans chiffres ni date d'entrée en vigueur.
Mesures de protection pratiques tant que le chiffre est inconnu :
- Mesurez votre coût réel par tâche dès maintenant, avec les données d'« usage » des charges de travail réelles, afin de pouvoir modéliser toute augmentation annoncée en quelques minutes plutôt que de deviner.
- Maximisez les accès au cache. Si l'augmentation s'applique proportionnellement, les architectures à préfixes lourds conservent la majeure partie de leur avantage.
- Gardez V4 Flash comme solution de repli de routage. À 0,14 $/0,28 $ avec 13 milliards de paramètres actifs, il gère les tâches simples à volume élevé, de sorte que Pro est réservé aux requêtes qui en ont besoin.
Pour une analyse plus approfondie de la structure tarifaire de V4 et de sa comparaison entre les fournisseurs, consultez notre guide de tarification de l'API DeepSeek V4.
FAQ
Mon code SDK OpenAI existant fonctionnera-t-il sans modification ?
Presque. Changez base_url pour https://api.deepseek.com, remplacez la clé API et définissez model="deepseek-v4-pro". Les complétions de chat, le streaming, les outils et les sorties structurées suivent les formats OpenAI. Les équipes utilisant le SDK Anthropic peuvent utiliser le point d'accès Anthropic Messages de DeepSeek à la place.
Quand devrais-je utiliser V4 Flash au lieu de V4 Pro ?
Flash (284 milliards au total, 13 milliards actifs) est le modèle de volume : classification, extraction, chat simple, tout ce qui est sensible à la latence et qui n'a pas besoin de raisonnement approfondi. Pro justifie son prix de sortie 3 fois plus élevé sur le codage agentique, l'analyse de longs contextes et les charges de travail en mode de réflexion. Acheminez par tâche, pas par fidélité.
Puis-je utiliser V4 Pro 0813 dans Cursor ?
Oui, Cursor accepte les points d'accès personnalisés compatibles OpenAI, de sorte que la version GA s'intègre comme un modèle personnalisé. Nous détaillons la configuration exacte dans Comment utiliser DeepSeek V4 Pro avec Cursor.
En résumé
Le premier jour avec un modèle GA est le bon moment pour développer la mémoire musculaire : clé, première requête, modes de réflexion, streaming, et une mise en page de prompt consciente du cache. V4 Pro récompense cette dernière habitude plus que tout modèle précédent, la réduction de 120x du cache fait de la structure du prompt une décision d'architecture. Connectez les exemples ci-dessus, surveillez les chiffres d'« usage », et conservez une collection Apidog enregistrée afin de pouvoir revérifier le comportement lors de l'arrivée du prochain instantané ou du changement de prix annoncé.