
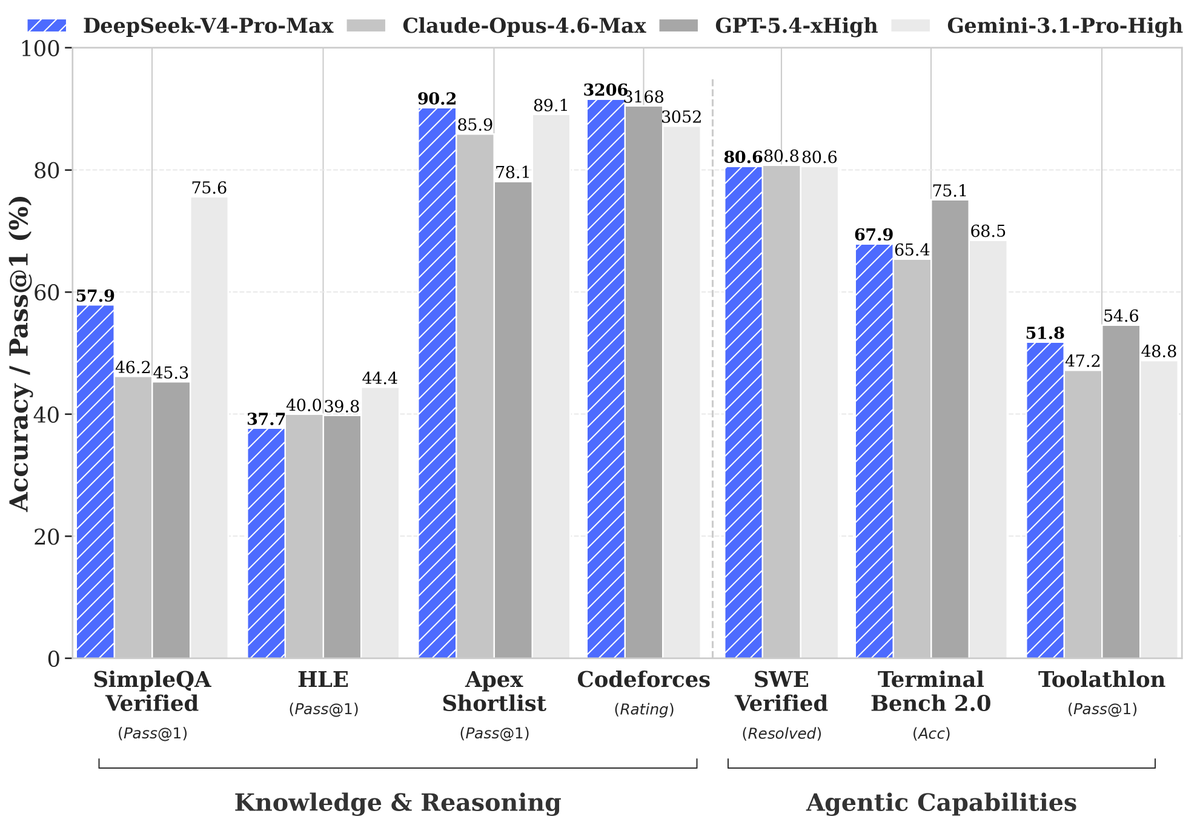
DeepSeek V4 a été lancé le 23 avril 2026, et contrairement à la plupart des lancements de modèles de pointe, les options gratuites sont réelles. Le chat web officiel utilise V4-Pro sans carte de crédit. Les poids sont sous licence MIT et téléchargeables dès aujourd'hui. Les agrégateurs comme OpenRouter et Chutes proposent généralement des niveaux gratuits quelques jours après une version DeepSeek. En additionnant tout cela, vous pouvez exécuter des charges de travail V4 sérieuses pour zéro dollar avant même de décider de recharger un compte.
Ce guide passe en revue chaque chemin sans coût que nous pouvons vérifier, lequel correspond à quel cas d'utilisation, et comment mettre en place une collection prête pour la production dans Apidog afin que le passage à la facturation payante reste fluide lorsque l'utilisation augmente.
bouton
Pour un aperçu du produit, consultez qu'est-ce que DeepSeek V4. Pour la présentation complète de l'API, consultez comment utiliser l'API DeepSeek V4.
En bref
- chat.deepseek.com — chat web gratuit sur V4-Pro avec les commutateurs Think High et Think Max. Pas de carte. Fonctionne aujourd'hui.
- Poids Hugging Face + votre propre GPU — Licence MIT, V4-Flash fonctionne sur 2 à 4 H100, V4-Pro nécessite un cluster.
- Niveaux gratuits OpenRouter et Chutes — passerelles tierces qui ouvrent généralement un quota gratuit sur les modèles DeepSeek dans la semaine suivant le lancement.
- Fournisseurs d'inférence Hugging Face — un point de terminaison partagé et limité en débit qui expose V4 pour une expérimentation précoce.
- Crédits d'essai Kaggle, Colab et RunPod — calcul gratuit pour des exécutions ponctuelles lorsque vous souhaitez tester l'auto-hébergement.
- Chaque chemin gratuit plafonne l'utilisation. Pour les charges de travail de production, passez à la facturation payante avant que le plafond ne soit atteint.
Option 1 : chat.deepseek.com (l'option gratuite par défaut)
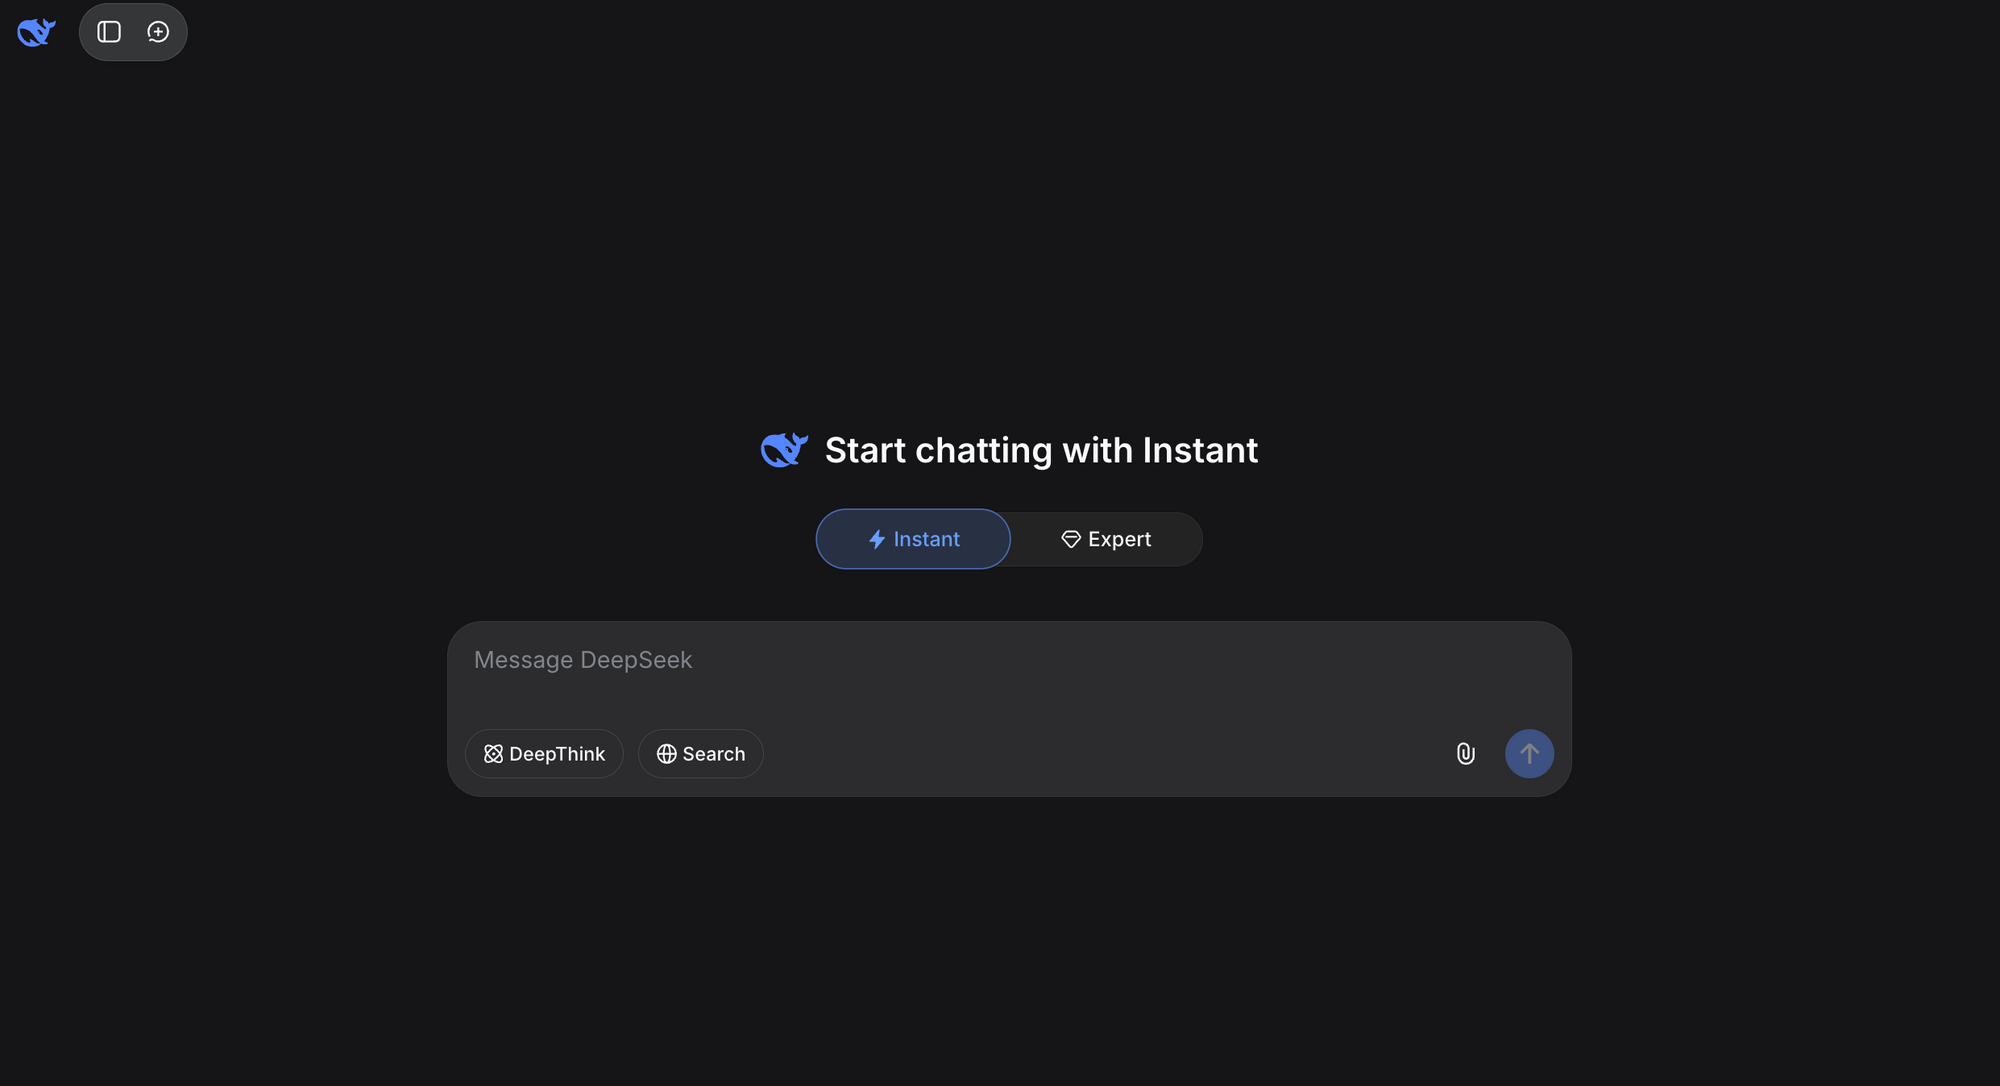
Le chemin gratuit le plus rapide et le plus fiable est l'interface de chat officielle. V4-Pro est le modèle par défaut ; le commutateur en haut du composeur bascule entre les modes de raisonnement Non-Think, Think High et Think Max.
Configuration
- Ouvrez chat.deepseek.com.
- Connectez-vous avec un e-mail, Google ou WeChat.
- Confirmez que le modèle actif indique V4-Pro.
- Commencez à taper.
Ce que vous obtenez
- La fenêtre de contexte complète de 1M de jetons.
- Téléchargement de fichiers pour les PDF, les images et les bundles de code.
- Recherche web à la demande.
- Les trois modes de raisonnement, y compris Think Max.
- Historique des conversations et dossiers.
À quoi ressemblent les plafonds
DeepSeek ne publie pas de nombre fixe de messages par jour ; le niveau gratuit est soumis à une limitation logicielle en cas de charge. Une utilisation intensive peut ralentir les réponses ou mettre les requêtes en file d'attente, mais bloque rarement de manière rigide. Si vous commencez à voir des limites de débit persistantes, c'est le signal pour ralentir la cadence ou passer à l'API.
Bonnes tâches pour l'interface web : tester si V4 bat Claude sur votre prompt le plus difficile, coller un tarball de dépôt pour une revue architecturale, exécuter Think Max sur un contrat que vous paieriez autrement un avocat pour lire. Mauvaises tâches : tout ce qui nécessite automatisation ou reproductibilité.
Option 2 : Auto-héberger V4-Flash sur votre propre GPU
V4-Flash est la variante sous licence MIT que la plupart des gens peuvent raisonnablement auto-héberger. Avec un total de 284 milliards de paramètres et 13 milliards actifs, une machine multi-H100 l'exécute en FP8 avec un débit sérieux, et une quantification INT4 le fait fonctionner sur une seule carte de 80 Go.
Le coût ici est le matériel, pas la licence. Si vous disposez déjà d'une capacité GPU, c'est l'option gratuite la plus durable ; elle ne peut pas être limitée en débit, dépréciée ou retirée.
Télécharger les poids
pip install -U "huggingface_hub[cli]"
huggingface-cli login
huggingface-cli download deepseek-ai/DeepSeek-V4-Flash \
  --local-dir ./models/deepseek-v4-flash
Attendez-vous à environ 500 Go en FP8. Réservez de l'espace disque.
Servir avec vLLM
pip install "vllm>=0.9.0"

vllm serve deepseek-ai/DeepSeek-V4-Flash \
  --tensor-parallel-size 4 \
  --max-model-len 1048576 \
  --dtype auto \
  --port 8000
Une fois qu'il est opérationnel, pointez n'importe quel client compatible OpenAI vers http://localhost:8000/v1. Le point de terminaison accepte la même forme de requête que l'API DeepSeek payante ; Apidog le considère comme une autre URL de base et toutes vos collections enregistrées fonctionnent sans modification.
Vérification de la réalité du matériel
| Variante | Cartes minimales (FP8) | Cartes minimales (INT4) | Débit réaliste |
|---|---|---|---|
| V4-Flash | 2 × H100 80 Go | 1 × H100 80 Go | 50 à 150 jetons/s |
| V4-Pro | 16 × H100 80 Go | 8 × H100 80 Go | dépend du cluster |
Si vous n'avez pas de cartes inutilisées, le calcul favorise généralement l'API plutôt que la location de GPU à l'heure. L'option d'auto-hébergement est principalement destinée aux équipes disposant d'une capacité existante ou de fortes exigences de conformité.
Option 3 : Niveau gratuit OpenRouter
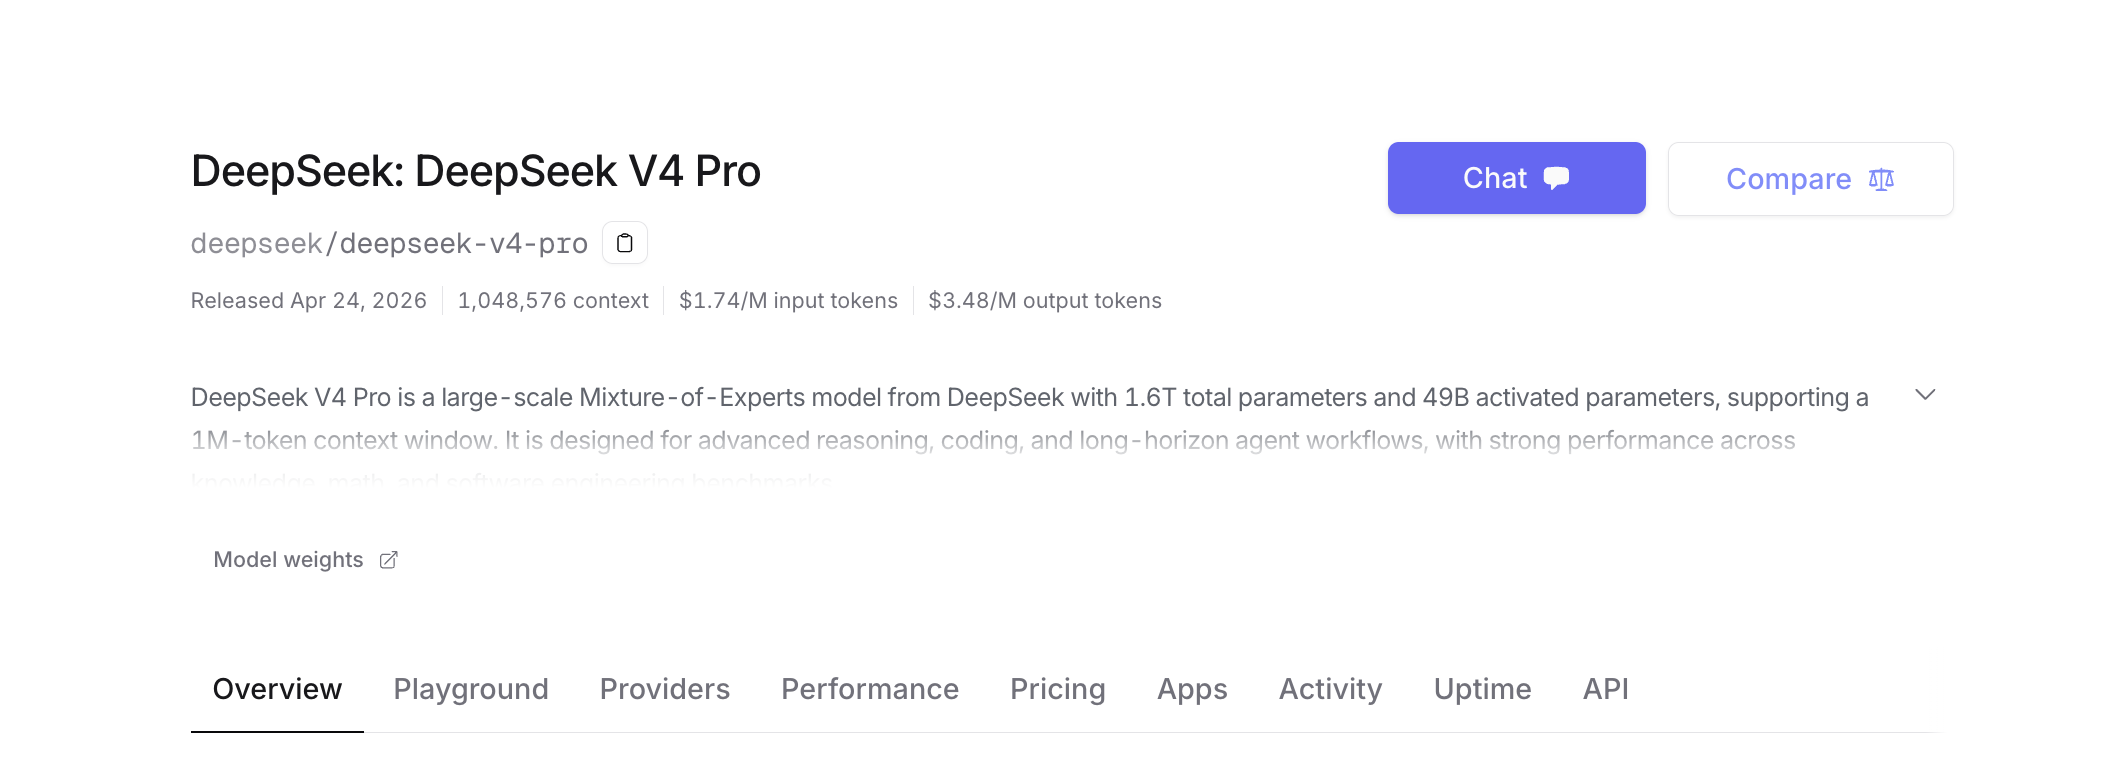
OpenRouter est une passerelle au niveau des requêtes qui agrège des modèles à poids ouverts et fermés derrière une seule API. La plateforme ouvre régulièrement des niveaux gratuits sur les nouvelles versions de DeepSeek, et le schéma s'est maintenu pour V3, V3.1 et V3.2.
Configuration
- Inscrivez-vous sur openrouter.ai.
- Créez une clé API.
- Vérifiez le catalogue de modèles pour
deepseek/deepseek-v4-prooudeepseek/deepseek-v4-flash; les variantes gratuites sont généralement suffixées:free. - Appelez-le avec le SDK compatible OpenAI.
from openai import OpenAI

client = OpenAI(
    api_key=OPENROUTER_KEY,
    base_url="https://openrouter.ai/api/v1",
)

response = client.chat.completions.create(
    model="deepseek/deepseek-v4-flash:free",
    messages=[{"role": "user", "content": "Write a Python CLI for semver bumping."}],
)

print(response.choices[0].message.content)
Plafonds
Les niveaux gratuits sur OpenRouter sont généralement plafonnés à quelques centaines de requêtes par jour et par clé et réduisent la priorité en cas de charge. Parfait pour le prototypage, peu fiable pour la production.
Option 4 : Fournisseurs d'inférence Hugging Face
Hugging Face propose un service d'inférence hébergé qui expose les checkpoints V4 peu après leur sortie. Les limites de débit sont strictes et la latence varie, mais l'appel est gratuit.
from huggingface_hub import InferenceClient

client = InferenceClient(model="deepseek-ai/DeepSeek-V4-Flash")

response = client.chat_completion(
    messages=[{"role": "user", "content": "Summarize the V4 technical report in 5 bullets."}],
    max_tokens=512,
)

print(response.choices[0].message.content)
Le jeton HF est gratuit. Pour une utilisation plus intensive, passez à un compte Pro ; les limites de débit s'assouplissent, mais le coût reste un ordre de grandeur inférieur à celui de l'API officielle pour des charges de travail comparables.
Option 5 : Crédits d'essai sur Colab, Kaggle, RunPod et Lambda
Chaque grand fournisseur de location de GPU offre des crédits d'essai. Bien utilisés, ils couvrent des expériences ponctuelles avec V4-Flash sans jamais dépenser d'argent réel.
- Google Colab. Le niveau gratuit T4 est trop petit pour V4. Colab Pro+ offre 500 unités de calcul par mois, assez pour une poignée d'expériences V4-Flash sur un A100.
- Kaggle. Heures GPU hebdomadaires gratuites sur T4 et P100. Trop petites pour V4-Pro, parfois suffisantes pour des expériences V4-Flash quantifiées.
- RunPod. Un crédit d'essai de 10 $ couvre quelques heures sur un H100. Assez pour lancer vLLM, exécuter une suite de benchmarks et l'arrêter.
- Lambda. Promotions occasionnelles d'heures gratuites sur H100 et H200 ; surveillez la page d'inscription pour les offres actives.
Aucune de ces options n'est un chemin gratuit à long terme. Elles fonctionnent bien pour une expérience limitée et rien d'autre.
Créez une collection Apidog agnostique du fournisseur
L'avantage pratique de ces nombreuses options gratuites est que vous pouvez tester le même prompt sur toutes sans duplication de travail. Le flux de travail :
- Téléchargez Apidog.
- Créez une collection avec quatre environnements :
chat(espace réservé),deepseek(https://api.deepseek.com/v1),openrouter(https://openrouter.ai/api/v1),self-hosted(http://localhost:8000/v1). - Enregistrez une seule requête POST vers
{{BASE_URL}}/chat/completions. - Stockez la clé de chaque fournisseur comme variable secrète afin que le corps de la requête soit identique dans tous les environnements.
- Basculez les environnements pour effectuer des tests A/B du même prompt sur chaque backend.
C'est le même modèle utilisé pour la collection gratuite GPT-5.5 ; un seul outil, chaque fournisseur, aucun travail dupliqué.
Quelle option gratuite choisir ?
Quatre heuristiques couvrent la plupart des décisions.
- Je veux me faire une opinion en cinq minutes. Utilisez chat.deepseek.com.
- Je veux prototyper un produit. Utilisez le niveau gratuit d'OpenRouter jusqu'à ce que vous atteigniez le plafond, puis rechargez sur DeepSeek.
- J'ai des GPU et une histoire de conformité. Auto-hébergez V4-Flash sur vLLM.
- J'ai besoin d'une utilisation gratuite à long terme. Cela n'existe pas. Chaque niveau gratuit hébergé a un plafond quelque part. Associez chat.deepseek.com pour le travail interactif avec un modeste complément payant pour l'automatisation.
Quand quitter le niveau gratuit
Trois signaux indiquent que vous avez dépassé le niveau gratuit.
- Vous êtes limité en débit plus d'une fois par jour. Cela signifie que la charge de travail est suffisamment importante pour mériter un budget.
- Vous avez besoin de SLA. Les niveaux gratuits n'en offrent pas. L'API officielle oui.
- Vous avez besoin de journaliser, d'auditer ou de vous conformer. L'API payante renvoie des enregistrements de facturation clairs ; la plupart des niveaux gratuits d'agrégateurs non.
Lorsque l'un de ces cas se présente, passez à l'API officielle. Le minimum de recharge est de 2 $ et la tarification par jeton est la plus basse du niveau de pointe.
FAQ
Est-ce que chat.deepseek.com est vraiment gratuit ?Oui. Pas de carte de crédit, pas de période d'essai. Le service est limité en douceur mais non payant.
Ai-je besoin d'un compte Hugging Face pour télécharger les poids ?Techniquement non, le dépôt est public. Pratiquement oui ; un compte connecté vous offre de meilleures limites de débit pour le téléchargement.
Quel chemin gratuit exécute le vrai V4-Pro ?chat.deepseek.com exécute le V4-Pro complet. Les niveaux gratuits d'OpenRouter proposent plus souvent V4-Flash. Si vous avez besoin de la sortie V4-Pro et que vous ne voulez pas payer, le chat web est le chemin fiable.
Puis-je mettre un niveau gratuit derrière un produit ?Non, ce n'est pas responsable. Les niveaux gratuits limitent le débit, modifient les conditions et disparaissent parfois. Si vous livrez V4 à des clients, utilisez l'API payante ou auto-hébergez.
L'auto-hébergement est-il vraiment gratuit ?La licence est gratuite. Le matériel ne l'est pas. Si vous possédez déjà une capacité GPU, le coût marginal est l'électricité. Si vous louez, le calcul perd généralement face à l'API payante.
Y aura-t-il un niveau gratuit Apidog pour les tests ?Apidog lui-même est gratuit pour la conception et les tests d'API ; il ne coûte des crédits que lorsque vous l'utilisez pour appeler des API payantes. Donc oui, vous pouvez combiner un espace de travail Apidog gratuit avec chat.deepseek.com ou OpenRouter pour un flux de travail entièrement gratuit.