
DeepSeek-V4.1-Flash est devenu généralement disponible sur l'API le 10 septembre 2026, et il est arrivé avec deux faits qui font du « gratuit » une véritable question plutôt qu'un argument marketing. Les poids sont sous licence MIT sur Hugging Face, donc le modèle lui-même ne coûte rien. Et l'API officielle facture les entrées en cache à 0,003 $ par million de jetons hors pointe, suffisamment proche de zéro pour que la frontière entre gratuit et presque gratuit cesse d'être importante pour la plupart des projets personnels.
Il n'y a toujours pas de niveau gratuit permanent sur l'API DeepSeek. Quiconque vous dit le contraire décrit une promotion de routeur ou l'application de chat grand public. Ce guide classe toutes les manières honnêtes d'utiliser V4.1-Flash sans payer, puis montre le calcul du chemin payant afin que vous puissiez décider si "presque gratuit" est suffisamment proche. Si vous voulez d'abord l'histoire de l'architecture, lisez ce qu'est DeepSeek-V4.1-Flash et revenez.
Une note d'abord. Plusieurs chemins gratuits passent par des points d'accès tiers qui vous limitent en débit et parfois échangent les modèles silencieusement. Les tester avec Apidog en enregistrant les réponses et en vérifiant le champ du modèle permet de ne pas gaspiller votre quota gratuit pour votre propre débogage. Ce flux de travail est proche de la fin.
TL;DR
Classé de « gratuit sans conditions » à « presque gratuit avec une carte enregistrée » :
- L'application de chat DeepSeek sur chat.deepseek.com. Gratuit, pas de carte. Idéal pour évaluer manuellement la qualité des résultats.
- Les poids ouverts sur Hugging Face. Gratuits sous licence MIT, mais 552 milliards de paramètres signifient que le matériel est le coût.
- Les routeurs tiers tels qu'OpenRouter. Des niveaux gratuits existent pour certains modèles, certaines fois, avec des limites de débit et des compromis sur la politique de données.
- Crédits d'essai inclus dans les outils de codage. Utile uniquement lorsque l'outil intègre déjà DeepSeek comme backend.
- L'API officielle. Non gratuite, mais un projet personnel coûte environ 1,35 $ par mois hors pointe.
Option 1 : L'application de chat DeepSeek
L'application grand public sur chat.deepseek.com est la voie sans friction. Inscrivez-vous avec un e-mail ou un numéro de téléphone, sans carte, et commencez à envoyer des requêtes.
Deux mises en garde. Premièrement, le modèle que l'application utilise après la version d'aujourd'hui est [À VÉRIFIER]. La note de version couvre l'API, et l'application a déjà pris du retard sur l'API ou exécuté une version ajustée séparément. Deuxièmement, l'application est une interface de chat, pas une API. Vous ne pouvez pas la scripter, envoyer des requêtes par lots ou l'intégrer à un produit.
L'application répond donc à une question : V4.1-Flash gère-t-il suffisamment bien votre domaine pour justifier une intégration ? Collez l'entrée que vos utilisateurs envoient, images comprises, puisque le modèle est nativement multimodal. Si les réponses sont satisfaisantes, passez à l'une des options ci-dessous.
Option 2 : Les poids ouverts
DeepSeek a publié les poids et le rapport technique de V4.1-Flash sous licence MIT. Vous pouvez les télécharger, les exécuter, les affiner et expédier des produits basés dessus sans payer DeepSeek ni demander de permission.
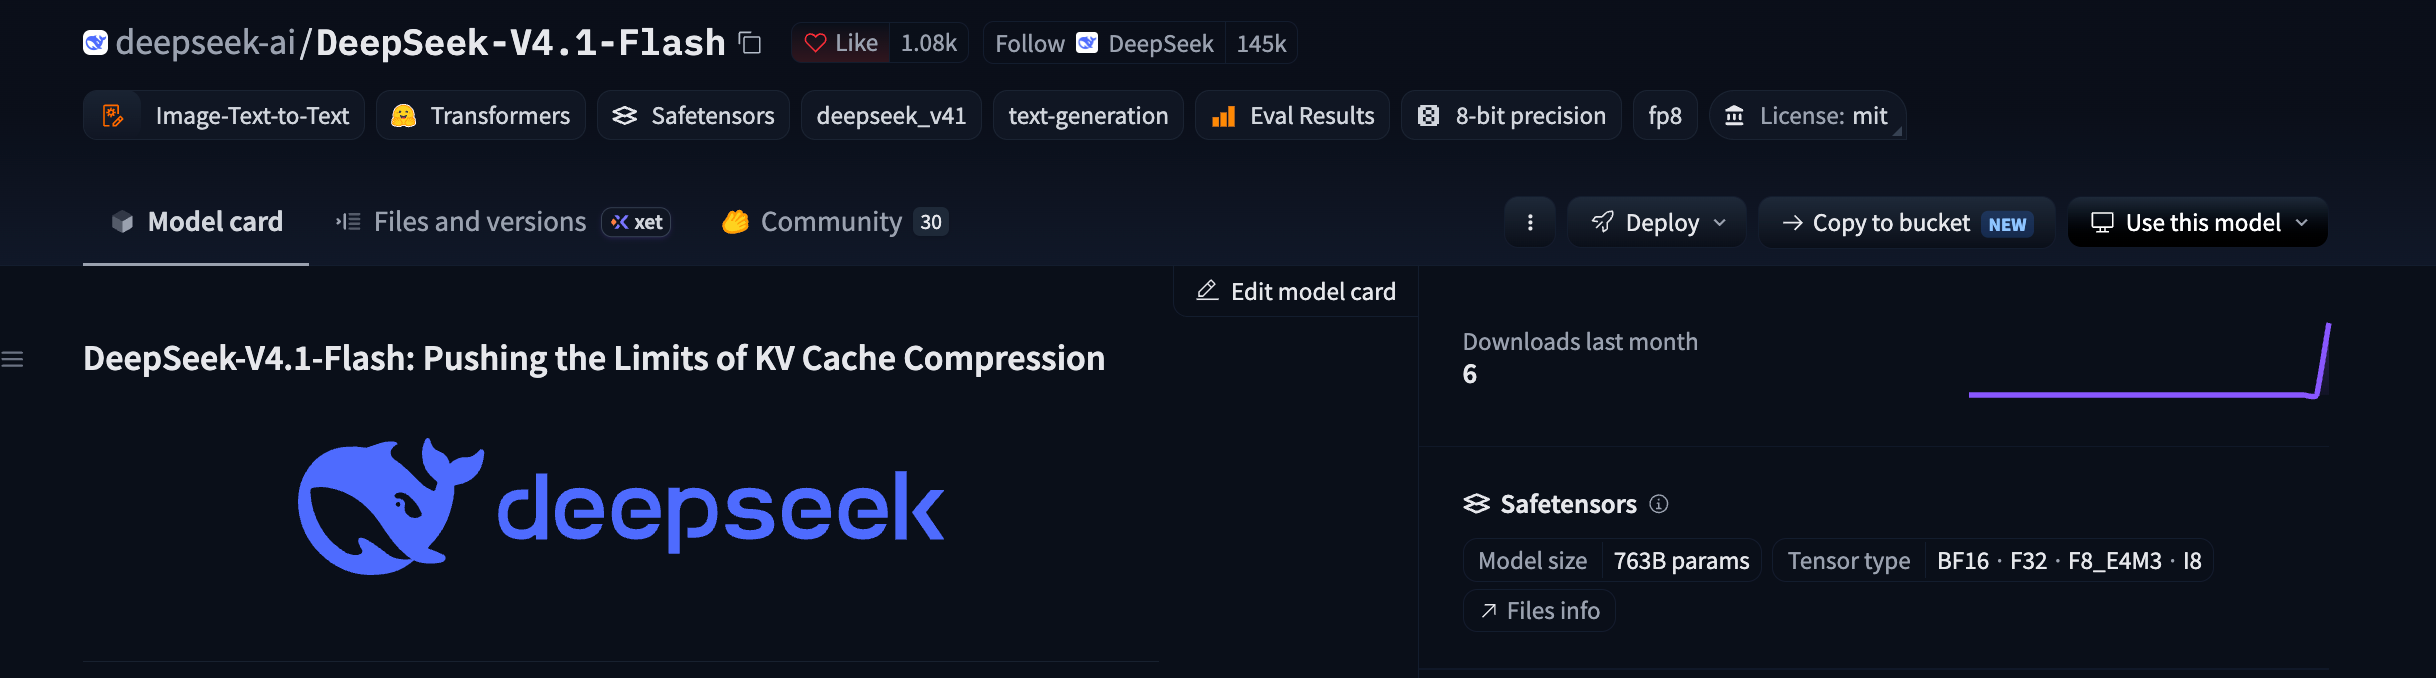
Le hic, c'est la taille. V4.1-Flash est une architecture de mixture-of-experts de 552 milliards de paramètres (763 milliards avec l'encodeur de vision). Seuls 8 milliards de paramètres sont actifs pendant le préremplissage et 16 milliards pendant le décodage, mais l'ensemble complet des paramètres doit tout de même résider quelque part. En 8 bits, cela représente environ 552 Go pour le backbone seul ; en 4 bits, environ 280 Go. Une seule carte graphique grand public n'y arrive pas. Le cache KV est la bonne nouvelle : à 890 octets par jeton en cache FP4, un contexte complet de 1 million de jetons nécessite environ 0,9 Go.
Ici, « gratuit » signifie libre de licence, pas libre d'exécution. Lisez comment exécuter DeepSeek-V4.1-Flash localement pour connaître les niveaux de matériel et les moteurs d'inférence à vérifier avant de télécharger 280 Go. Si vous disposez déjà du matériel, c'est l'option gratuite la plus durable de cette page : pas de limites de débit, pas de politique de données, pas de substitutions silencieuses de modèles.
Option 3 : L'API officielle n'est pas gratuite, mais elle est presque
La plateforme DeepSeek est basée sur le paiement à l'utilisation. Vous rechargez un solde, créez une clé et êtes facturé par jeton. Il n'y a pas de niveau gratuit permanent.
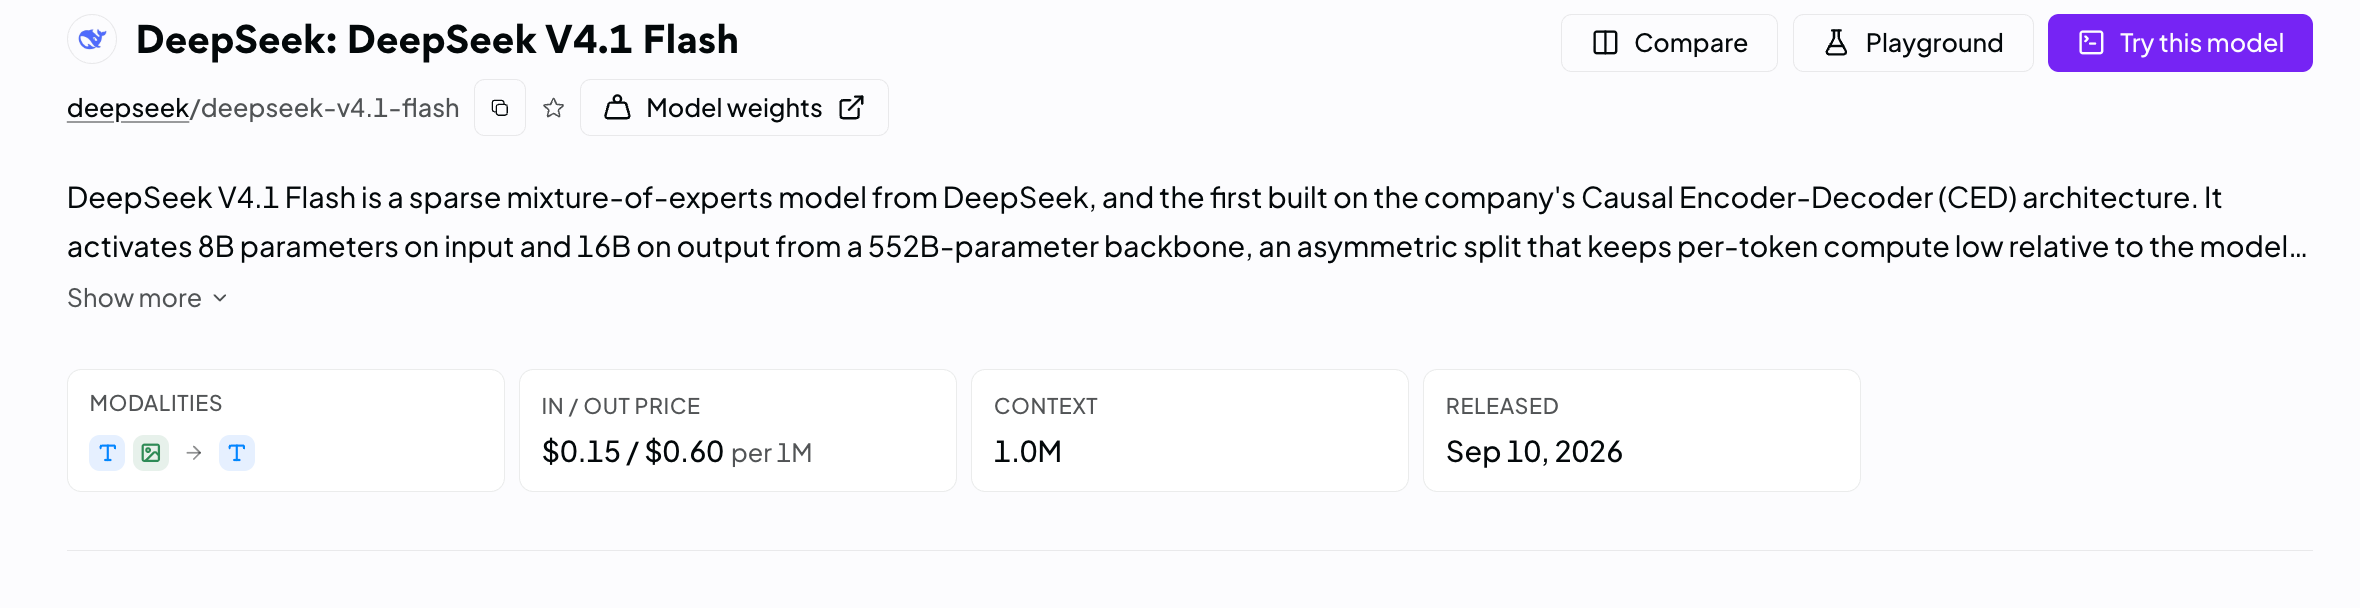
Ce qui lui vaut une place sur une page « gratuite », c'est son prix. Voici le tableau complet en USD de la page officielle des tarifs, effectif le 10 septembre 2026 à 04:00 UTC, par million de jetons :
| Type de jeton | deepseek-flash hors pointe | deepseek-flash en pointe |
|---|---|---|
| Entrée, cache trouvée | $0.003 | $0.006 |
| Entrée, cache manquée | $0.15 | $0.30 |
| Sortie | $0.60 | $1.20 |
Les heures de pointe sont du lundi au vendredi, de 01:00 à 04:00 et de 06:00 à 10:00 UTC (09:00 à 12:00 et 14:00 à 18:00 à Pékin). Tout le reste, week-ends inclus, est hors pointe à moitié prix. La mise en cache contextuelle est automatique, de sorte que les requêtes système répétées atteignent le cache sans code supplémentaire.
Maintenant, le calcul. Supposons qu'un projet personnel envoie 5 millions de jetons d'entrée fraîche (cache manquée) et génère 1 million de jetons de sortie par mois, le tout hors pointe :
- 5M d'entrées avec cache manquée à 0,15 $ par 1M = 0,75 $
- 1M de sorties à 0,60 $ par 1M = 0,60 $
- Total : 1,35 $ par mois
Si une partie de cette entrée est une requête système répétée, le coût diminue encore. 1 million de jetons en cache trouvée hors pointe coûte 0,003 $, donc une requête système de 2 000 jetons réutilisée sur 10 000 requêtes (20 millions de jetons mis en cache) ajoute six cents. La facture s'arrondit à quelques centimes, et vous obtenez le modèle exact que vous avez demandé avec un plafond de 2 500 requêtes concurrentes. L'explication des tarifs de V4.1-Flash couvre la manière dont le calcul varie avec la structure des requêtes.
Un appel minimal, avec le bloc d'utilisation affiché pour que vous puissiez voir la répartition du cache :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Options 4 et 5 : routeurs, niveaux gratuits et crédits inclus
OpenRouter est l'endroit habituel où chercher un point d'accès gratuit pour un nouveau modèle à poids ouverts. Les routeurs regroupent plusieurs hôtes derrière une API compatible OpenAI, et les hôtes proposent parfois un niveau gratuit pour un modèle afin d'attirer du trafic. Savoir si V4.1-Flash y est listé aujourd'hui, et si un hôte propose un niveau gratuit pour celui-ci, est [À VÉRIFIER] ; le modèle a quelques heures et les listes changent rapidement.
Trois avertissements s'appliquent à chaque niveau gratuit de routeur :
- Les limites de débit sont strictes. Les plafonds par minute et par jour signifient qu'une boucle de test peut épuiser le quota d'une journée en une heure.
- Les politiques de données diffèrent selon l'hôte. Le trafic gratuit est souvent ce qu'un hôte est autorisé à enregistrer ou à utiliser pour l'entraînement. Lisez la politique avant d'envoyer quoi que ce soit de privé.
- Les niveaux gratuits changent chaque semaine. Ce qui est gratuit le lundi peut devenir payant le vendredi, ou être redirigé vers un autre hôte. Ne construisez pas une dépendance de production sur un tel niveau.
L'échec à surveiller est la substitution silencieuse de modèle : vous demandez V4.1-Flash et un modèle plus ancien répond parce que l'hôte gratuit est tombé en panne. Le champ model de la réponse est votre première ligne de défense, et le flux de travail ci-dessous le vérifie.
Certains outils de codage, notamment Cursor et les agents de style Codex, incluent des crédits d'essai que vous pouvez dépenser sur les backends pris en charge par l'outil. Si un outil que vous utilisez déjà liste DeepSeek comme modèle sélectionnable, ces crédits constituent un chemin gratuit légitime pour la durée de l'essai. Ne vous inscrivez pas à un outil uniquement pour atteindre DeepSeek de cette manière ; les montants de crédit et les modèles éligibles changent trop souvent pour être documentés.
Quelle option correspond à votre situation
| Option | Coût | Modèle garanti ? | Limites de débit | Idéal pour |
|---|---|---|---|---|
| Application de chat DeepSeek | Gratuit | Dépend de la version de l'application | Plafonds d'utilisation de l'application | Évaluation manuelle, vérifications rapides |
| Poids ouverts (MIT) | Licence gratuite, votre matériel | Oui, vous l'exécutez | Aucune | Confidentialité, affinage, GPUs propriétaires |
| API officielle | Environ 1,35 $/mois pour un usage amateur | Oui | 2 500 requêtes concurrentes | Tout ce que vous déployez |
| Niveau gratuit du routeur | Gratuit tant que ça dure | Non, les hôtes changent | Plafonds par minute et par jour | Prototypes, comparaisons |
| Crédits d'outil inclus | Gratuit pendant l'essai | Dépend de l'outil | Défini par l'outil | Codage à l'intérieur de cet outil |
Si vous prévoyez de déployer, dépensez le dollar pour l'API officielle. Si vous évaluez, commencez par l'application de chat. Si vous avez des GPUs, les poids l'emportent sur toutes les autres options.
Tester les points d'accès gratuits dans Apidog sans gaspiller de quota
Les chemins gratuits présentent deux modes de défaillance : vous atteignez la limite de débit en débogant votre propre code, et le routeur vous fournit un modèle différent sans le dire. Les deux sont peu coûteux à prévenir avec Apidog, qui teste la couche API devant le point d'accès que vous choisissez.
- Ajoutez le point d'accès une seule fois. Créez
POST {{BASE_URL}}/chat/completionsavecBearer {{API_KEY}}dans l'en-tête d'autorisation. Chaque option, à l'exception de l'application de chat, utilise le même format compatible OpenAI, donc une seule requête enregistrée les couvre toutes. - Créez un environnement par fournisseur. Un environnement
officialdéfinitBASE_URLsurhttps://api.deepseek.comavec votre clé DeepSeek ; un environnementrouterpointe vers l'hôte gratuit. Le changement se fait via un menu déroulant. - Enregistrez les réponses réelles, puis simulez-les. Envoyez quelques requêtes représentatives via le point d'accès gratuit, enregistrez les réponses et servez-les depuis le serveur de maquette d'Apidog. Pendant que vous construisez l'analyse, les tentatives de réessai et l'interface utilisateur, votre application utilise la maquette et le quota gratuit reste intact.
- Vérifiez le champ du modèle. Enregistrez la requête comme un cas de test affirmant que le champ
modeldans la réponse contient la chaîne renvoyée par l'hôte pour V4.1-Flash. Exécutez-le au début de chaque session, et un modèle échangé fera échouer le test avant que vous ne passiez une heure à chercher une « régression » dans vos requêtes. - Vérifiez le bloc d'utilisation. Vérifiez que
usage.prompt_tokensetusage.completion_tokenssont supérieurs à zéro, et lisez le nombre de hits du cache sur l'API officielle à partir du même bloc. Après une semaine, vous saurez ce qu'un niveau gratuit vous a économisé et si vos requêtes sont mises en cache aussi bien que vous le supposiez.
Téléchargez Apidog et la boucle prend moins de dix minutes. Une fois les assertions créées, apidog-cli les exécute en CI afin qu'un échange de routeur interrompe une build au lieu d'une démo.
FAQ
DeepSeek-V4.1-Flash est-il gratuit à utiliser ? Le modèle est gratuit sous licence MIT et gratuit à utiliser dans l'application de chat DeepSeek. L'API officielle est basée sur le paiement à l'utilisation, sans niveau gratuit permanent. DeepSeek est-il gratuit retrace comment cette distinction s'est maintenue sur toute la gamme de modèles.
L'API DeepSeek a-t-elle un essai gratuit ? Pas de façon permanente. Le chemin le moins coûteux est l'API officielle hors pointe : 5 millions de jetons d'entrée avec cache manquée plus 1 million de jetons de sortie coûtent 1,35 $.
Quelle est la manière la moins chère d'appeler V4.1-Flash via l'API ? Envoyez en dehors des heures de pointe et structurez les requêtes de sorte que les préfixes partagés atteignent le cache, car un hit coûte 50 fois moins cher qu'un miss. Qu'est-ce que la mise en cache des prompts explique comment organiser un prompt pour cela.
Puis-je exécuter V4.1-Flash sur un ordinateur portable ? Pas le modèle complet. 552 milliards de paramètres représentent environ 280 Go en 4 bits pour le backbone seul. Le guide local lié ci-dessus couvre ce qui est réaliste à chaque niveau de matériel.
Une version de routeur gratuite est-elle le même modèle que l'API officielle ? Seulement si l'hôte le déclare et que vos tests le confirment. Vérifiez le champ model et comparez les sorties sur un ensemble de requêtes fixes par rapport au point d'accès officiel. Les guides sur DeepSeek V4 gratuitement et l'API V4 gratuitement effectuent la même vérification pour la génération précédente.
Ce que cela implique pour vous
V4.1-Flash est gratuit de deux manières qui comptent le plus : les poids sont sous licence MIT et l'application de chat ne coûte rien. Tout ce qui se trouve entre ces deux pôles est un niveau gratuit qui évoluera ou une API officielle à un prix suffisamment bas pour que le « gratuit » ne vaille plus la peine d'être optimisé. À 1,35 $ par mois, la voie la moins chère est généralement de payer.
Quel que soit le point d'accès que vous choisissez, mettez Apidog devant lui : simulez les réponses pendant le développement, vérifiez le champ du modèle, enregistrez l'utilisation. Le quota gratuit est une ressource. Dépensez-le pour le modèle, pas pour vos propres bugs.