
Un agent de codage IA a exécuté un script, l'a vu réussir, puis a vu une table de base de données de production disparaître. Le post-mortem de Hacker News est devenu viral avec un titre percutant : « L'IA n'a pas supprimé votre base de données, vous l'avez fait. » Le message a fait mouche parce que c'est vrai. L'agent a suivi une définition d'outil, l'outil a atteint un véritable point d'accès, le point d'accès n'avait pas de garde-fous, et un humain avait donné les clés à un processus qui ne fait pas de pause pour demander si DELETE FROM users semble suspect. Un autre fil de discussion r/ClaudeAI racontait une histoire similaire sous un angle différent : un agent dans une boucle de facturation a consommé des centaines de dollars en jetons avant que quiconque ne s'en aperçoive. Surface différente, même classe d'échec. Le problème n'est pas que le modèle est stupide. Le problème est que personne n'a testé l'API.
TL;DR
Les agents échouent en production lorsque leurs outils n'ont pas de garde-fous côté API : limites de débit manquantes, pas d'idempotence, suppressions à chaud, schémas cassés. Vous corrigez cela en quatre étapes : testez la conformité des définitions d'outils de l'agent par rapport à votre spécification OpenAPI, exécutez un serveur de maquette pour les points d'accès destructeurs, appliquez des budgets par agent et des clés d'idempotence, et rejouez les scénarios de défaillance en CI. Apidog vous offre l'importation OpenAPI, les maquettes et l'exécuteur de scénarios pour tout faire à partir d'un seul projet.
Introduction
Il y a un an, « tester l'agent IA » signifiait inviter Claude ou GPT et évaluer la réponse. Ce n'est plus la norme. Les agents d'aujourd'hui appellent des fonctions, ces fonctions atteignent vos API, et vos API communiquent avec de véritables bases de données, des processeurs de paiement et des services tiers. Une mauvaise définition d'outil ou une limite de débit manquante n'est pas un problème de style. C'est un incident de production qui vous sera attribué.
L'histoire virale de Hacker News ce mois-ci a mis en lumière ce changement. L'auteur a soutenu que l'IA n'avait pas supprimé la base de données ; c'est l'humain qui l'a fait, en donnant à l'agent un accès en écriture sans mettre de contrôles entre le modèle et les données. Le fil de discussion a explosé parce que chaque développeur qui le lisait avait pensé : « J'ai failli livrer ça. » Quelques semaines plus tôt, un post Reddit décrivait une boucle de facturation où un agent a réessayé un appel échoué tellement de fois que la facture a dépassé les 800 euros avant que quiconque ne le remarque. Même cause profonde : la confiance placée dans la mauvaise couche.
Vous pouvez corriger cela. La couche modèle est importante, mais la couche API est celle où vous arrêtez l'hémorragie. Cet article vous montre comment tester les intégrations API des agents IA de bout en bout. Nous couvrirons les quatre garde-fous nécessaires à toute configuration agent-API, présenterons un flux de travail Apidog étape par étape pour simuler des points d'accès destructeurs, et terminerons par des techniques avancées comme la détection de dérive de schéma et la séparation à double clé. Vous repartirez avec des modèles concrets que vous pourrez copier dans votre dépôt dès aujourd'hui. Téléchargez Apidog avant de commencer afin de pouvoir suivre les étapes du serveur de maquette.
Pourquoi les échecs des agents ressemblent à des échecs d'API
Lisez suffisamment de post-mortems d'agents et un schéma apparaît : le modèle n'est pas le protagoniste. L'API l'est.
Prenez l'injection de prompt. Un utilisateur télécharge un PDF avec des instructions cachées, l'agent le lit, et l'appel d'outil suivant se dirige vers votre point d'accès /admin/users avec delete_all=true. Le modèle n'a pas choisi cela ; il a suivi des instructions qu'il n'avait aucune raison de ne pas croire. La solution n'est pas de renforcer le prompt. La solution est de construire une API qui n'expose pas delete_all=true à un jeton provenant d'une session de contexte utilisateur. L'OWASP appelle cela LLM01 dans son Top 10 des LLM, et la mesure d'atténuation est l'autorisation côté API, pas l'ingénierie de prompt.
Prenez les schémas d'outils défectueux. Votre spécification OpenAPI indique que amount est un entier en cents. La définition d'outil de l'agent indique que amount est un flottant en dollars. Trois mois plus tard, quelqu'un rembourse une charge de 19 cents comme 19 dollars et vous découvrez l'écart par la comptabilité. Le modèle n'avait pas tort ; il a utilisé le schéma que vous lui avez donné. Le schéma a dérivé de l'API. Personne n'a testé le contrat.
Prenez les limites de débit manquantes. Un agent dans une boucle de réessai martèle votre point d'accès d'e-mail transactionnel mille fois en deux minutes parce que le planificateur de l'agent n'arrêtait pas de marquer l'étape comme « pas encore réussie ». Chaque réessai coûte de l'argent. Chaque réessai met en file d'attente un véritable e-mail. Au moment où vous vous réveillez, votre fournisseur a signalé votre compte et vos clients reçoivent du spam. Le modèle n'était pas malveillant. Le modèle fonctionnait à partir d'un outil qui n'avait pas de plafond.
Prenez l'idempotence manquante. L'agent appelle POST /payments pour facturer un client, reçoit un délai d'attente réseau, réessaye parce que le planificateur pense que l'appel a échoué, et maintenant le client est facturé deux fois. La couche agent ne peut pas savoir si l'appel original a réussi ; l'API ne lui a pas donné un moyen de le demander. Les clés d'idempotence résolvent ce problème en cinq lignes de code serveur, mais vous devez les écrire.
Le fil conducteur : dans chacun de ces incidents, l'agent fait exactement ce que ses outils lui disent de faire. Les outils sont l'API. Donc, lorsque vous auditez les points de rupture de la fiabilité des agents, examinez d'abord le contrat API, ensuite le harnais de l'agent, et presque jamais le modèle lui-même. Ce recadrage est important car il vous indique où investir. Vous n'avez pas besoin d'un modèle plus intelligent. Vous avez besoin d'API testables avec les garde-fous activés.
Les quatre garde-fous essentiels à toute intégration agent-API
Quatre contrôles séparent les configurations d'agents qui échouent en toute sécurité de celles qui échouent coûteusement. Si vous n'avez le temps d'en ajouter qu'un ce trimestre, commencez par le premier. Si vous pouvez faire les quatre, vous aurez couvert plus de 90 % des scénarios d'incidents que vous rencontrerez en 2026.
1. Tests de contrat de schéma d'outils
Votre spécification OpenAPI est la source de vérité pour votre API. Votre agent a une définition d'outil distincte, souvent écrite à la main ou copiée-collée de la documentation. Ces deux artefacts dérivent constamment. Les tests de contrat font échouer votre build CI dès qu'ils divergent.
Voici une vérification Python minimale qui valide une définition d'outil de style Claude par rapport à la spécification OpenAPI en direct :
import json
from jsonschema import Draft202012Validator

def validate_tool_against_openapi(tool_def: dict, openapi_spec: dict) -> list[str]:
    """Return a list of mismatch errors, empty list = pass."""
    errors = []
    op = openapi_spec["paths"][tool_def["path"]][tool_def["method"].lower()]
    api_schema = op["requestBody"]["content"]["application/json"]["schema"]
    tool_schema = tool_def["input_schema"]

    api_props = set(api_schema.get("properties", {}).keys())
    tool_props = set(tool_schema.get("properties", {}).keys())

    for missing in api_props - tool_props:
        if missing in api_schema.get("required", []):
            errors.append(f"Tool missing required field: {missing}")
    for extra in tool_props - api_props:
        errors.append(f"Tool defines field not in API: {extra}")

    for prop, api_def in api_schema.get("properties", {}).items():
        if prop in tool_schema.get("properties", {}):
            tool_def_prop = tool_schema["properties"][prop]
            if api_def.get("type") != tool_def_prop.get("type"):
                errors.append(
                    f"Type mismatch on {prop}: API={api_def.get('type')} "
                    f"tool={tool_def_prop.get('type')}"
                )
    return errors
Exécutez ceci sur chaque PR qui modifie la spécification OpenAPI ou les définitions d'outils. Faites échouer le build si la liste n'est pas vide. Cette simple vérification aurait détecté le bug float-vs-cents dans la section précédente des mois avant qu'un remboursement ne soit émis.
2. Environnements de bac à sable et de maquette pour les points d'accès destructeurs
Les agents ont besoin d'un endroit pour s'entraîner. Ils ne devraient jamais s'entraîner en production. Le modèle est simple : chaque point d'accès qui modifie l'état a un équivalent de maquette qui renvoie la même forme de réponse sans effectuer le travail. Votre boucle de développement d'agent utilise les maquettes. Vos tests de staging utilisent une base de données bac à sable. La production reste intacte jusqu'à ce qu'un humain approuve le déploiement.
Apidog génère des maquettes directement à partir de la spécification OpenAPI, incluant des valeurs de champ réalistes basées sur les modèles Faker. Vous pointez l'URL de base de votre agent vers le serveur de maquette pendant le développement, exécutez une centaine d'itérations de votre prompt, et observez son comportement. Si l'agent continue d'essayer de faire un PUT vers /users/{id}/delete parce qu'il a mal compris la documentation, la maquette le détecte. La table utilisateur en production ne voit jamais l'erreur. Voir le développement contract-first pour le modèle plus large dans lequel cela s'inscrit.
3. Clés d'idempotence et suppressions logiques pour les opérations irréversibles
Chaque point d'accès en écriture que votre agent peut appeler devrait accepter une clé d'idempotence. Chaque suppression devrait être une suppression logique par défaut, avec un chemin de suppression physique distinct que les humains autorisent.
Le middleware ressemble à ceci dans Express :
const idempotencyCache = new Map();

function idempotency(req, res, next) {
  const key = req.headers['idempotency-key'];
  if (!key) {
    return res.status(400).json({ error: 'Missing Idempotency-Key header' });
  }
  if (idempotencyCache.has(key)) {
    const cached = idempotencyCache.get(key);
    return res.status(cached.status).json(cached.body);
  }
  const originalJson = res.json.bind(res);
  res.json = function (body) {
    idempotencyCache.set(key, { status: res.statusCode, body });
    setTimeout(() => idempotencyCache.delete(key), 24 * 60 * 60 * 1000);
    return originalJson(body);
  };
  next();
}

app.post('/payments', idempotency, createPayment);
L'agent génère un UUID par opération logique et le réutilise lors des réessais. Votre API renvoie la réponse mise en cache lors du deuxième appel au lieu de facturer deux fois. Ce même modèle protège contre les doubles envois dans les API de messagerie, la création de lignes en double dans les CRM, et la plupart des autres scénarios du type « l'agent a réessayé et maintenant nous avons un désordre ».
4. Plafonds budgétaires par agent
Chaque agent reçoit un budget. Budget de jetons, budget de requêtes, budget en dollars, budget temps. Lorsque le budget est épuisé, l'agent s'arrête. Sans exception. L'incident Reddit de 800 euros s'est produit parce que personne n'avait fixé de plafond à une boucle incontrôlée, et au moment où l'humain a vérifié, les dégâts étaient faits.
Un middleware budgétaire qui enveloppe votre passerelle API pourrait suivre :
- Jetons par session, plafonnés à 50 000
- Appels API par minute, plafonnés à 30
- Dépenses cumulées en cents, plafonnées à 500
- Profondeur d'appel d'outil, plafonnée à 10 appels imbriqués
Lorsqu'un plafond est atteint, renvoyez HTTP 429 avec un en-tête Retry-After structuré et un en-tête X-Budget-Exceeded spécifiant le plafond. Le planificateur de l'agent peut alors soit faire remonter le problème à un humain, soit annuler la tâche. Couplez cela avec la journalisation afin de pouvoir voir quels agents dépassent les limites et ajuster en conséquence.
Ces quatre contrôles se cumulent. Les tests de contrat détectent les erreurs de schéma évidentes. Les maquettes détectent les erreurs destructrices. L'idempotence détecte les tempêtes de réessais. Les budgets détectent les boucles incontrôlées. Ensemble, ils transforment « l'agent a fait quelque chose de terrible » en « l'agent a rencontré un 429, a journalisé le problème et a demandé de l'aide. » C'est la norme.
Tester les appels API d'agents avec Apidog
Maintenant, la partie pratique. Voici comment configurer un flux de travail complet de test agent-API dans Apidog. Vous aurez besoin de la spécification OpenAPI pour l'API que votre agent appelle, ainsi que d'une liste des définitions d'outils de l'agent.
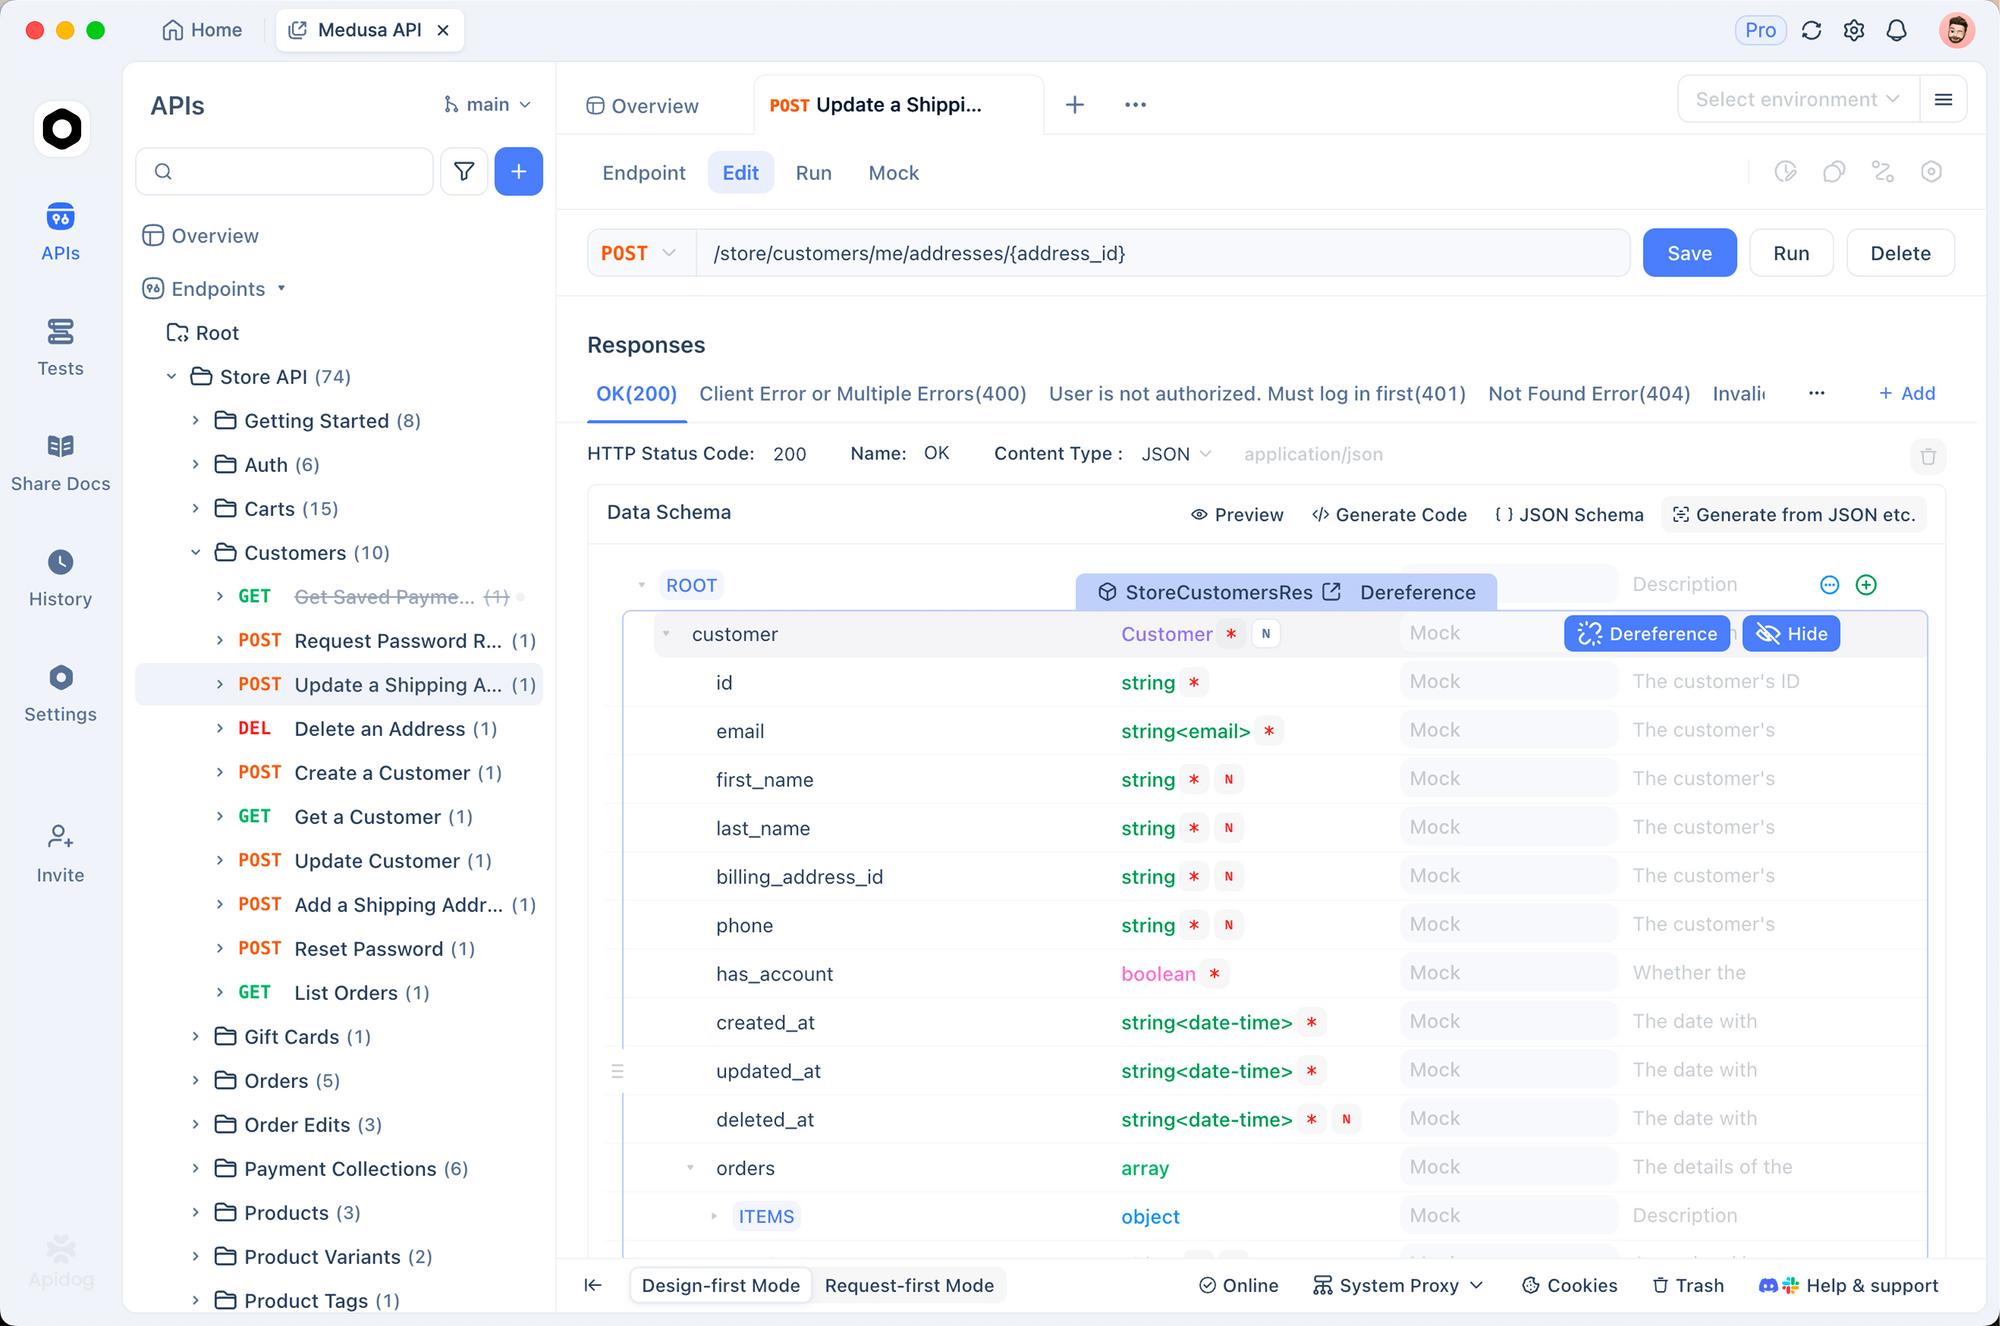
Étape 1 : Importer la spécification OpenAPI
Ouvrez Apidog, créez un nouveau projet et importez votre fichier OpenAPI 3.x. Apidog analyse chaque chemin, schéma et exemple, et crée les points d'accès correspondants dans le projet. Si votre API n'est pas encore documentée dans OpenAPI, c'est le moment de le faire ; la fiabilité de l'agent dépend d'une source de vérité unique que vos humains et vos agents IA peuvent lire. Le guide du workflow API axé sur la conception explique cela si vous partez de zéro.
Étape 2 : Définir des réponses de maquette pour les points d'accès destructeurs
Trouvez chaque point d'accès qui modifie les données : POST, PUT, PATCH, DELETE. Pour chacun, cliquez sur le point d'accès et ajoutez une réponse de maquette. Apidog peut auto-générer des maquettes réalistes à partir de votre schéma, mais vous devriez remplacer les valeurs de champ afin qu'elles ressemblent à des données de test, et non à des données de production. Utilisez des préfixes comme mock_user_ et des horodatages de 1970 afin que toute fuite soit évidente dans les journaux.
Démarrez le serveur de maquette. Apidog vous fournit une URL stable comme https://mock.apidog.com/m1/votre-identifiant-de-projet/. Pointez l'URL de base de l'API de votre agent vers le serveur de maquette pendant le développement. Maintenant, votre DELETE /users/{id} renvoie un 200 avec une charge utile utilisateur factice, et votre base de données réelle est en sécurité. Voir le développement contract-first pour le modèle plus large dans lequel cela s'inscrit.
Étape 3 : Écrire un scénario qui simule la séquence d'appels de l'agent
Les scénarios Apidog vous permettent d'enchaîner les appels API avec des assertions, de la même manière qu'une suite de tests. Pour un agent qui trie les tickets de support, le scénario pourrait être :
- POST
/auth/tokenavec des identifiants de test, capturer le jeton d'authentification - GET
/tickets?status=openavec le jeton, capturer le premier ID de ticket - POST
/tickets/{id}/triageavec une catégorie, affirmer 200 et capturer le champ "assigné à" - POST
/notificationsavec un message basé sur un modèle, affirmer que le corps du message correspond à une expression régulière
Vous répétez en fait ce que l'agent fera, sur le serveur de maquette, avec des assertions à chaque étape. Si un développeur modifie le schéma de ticket et que l'expression régulière ne correspond plus, le scénario échoue et vous le savez avant que l'agent n'atteigne la production. Voir le test d'API pour les ingénieurs QA pour le manuel de test de scénarios plus large.
Étape 4 : Exécuter depuis l'intégration continue (CI)
Apidog fournit une CLI qui exécute des scénarios depuis une GitHub Action, un pipeline GitLab ou tout autre exécuteur CI. La commande ressemble à apidog run -t scenario-id --env test. Intégrez-le à votre pipeline de PR afin que chaque modification de la spécification OpenAPI ou des définitions d'outils de l'agent déclenche une relecture complète du scénario.
Étape 5 : Comparer deux versions de modèle côte à côte
Lorsque vous évaluez l'opportunité de passer d'un modèle à un autre, vous voulez savoir si les appels d'outils du nouveau modèle se comportent de la même manière sur les mêmes scénarios. Exécutez l'agent sur le même scénario Apidog avec le modèle A, capturez la trace. Exécutez à nouveau avec le modèle B, capturez la trace. Comparez les corps de requête. Des surprises apparaissent immédiatement : le modèle B transmet une valeur de priority différente, ou omet un champ, ou utilise un format différent pour les dates. Vous détectez les dérives comportementales avant le déploiement. C'est l'un des modèles couverts dans l'intégration API GPT-5.5, où l'évaluation du nouveau comportement du modèle est un besoin récurrent.
L'ensemble du flux de travail prend environ une heure à configurer la première fois et quelques minutes par exécution par la suite. L'avantage est que chaque modification de votre API ou de vos outils d'agent est testée par rapport au même niveau d'attentes.
Techniques avancées et astuces de pro
Quelques modèles que les équipes expérimentées adoptent une fois les bases établies.
- Fixez la température à zéro dans les tests. Les agents non déterministes entraînent des échecs de test non déterministes. Lorsque vous testez le comportement des appels d'outils, réglez la température sur 0 et initialisez toutes les sources de hasard. Vous testez la couche d'outils, pas la couche de créativité.
- Capturez les traces d'appels d'outils. Chaque exécution de test enregistre la séquence exacte des appels d'outils effectués par l'agent, avec les arguments. Comparez-la à la base de référence précédente. Si l'agent commence soudainement à appeler
/usersdeux fois au lieu d'une, vous voulez le savoir immédiatement, pas trois semaines plus tard lorsque la facture arrive. - Ne donnez jamais à un agent des identifiants de production. Les agents obtiennent des comptes de service à portée limitée. Les identifiants de production résident dans des coffres-forts, pas dans des fichiers
.envqu'un agent peut lire. Si un agent doit appeler un point d'accès de production, il passe par un proxy qui signe les requêtes avec des jetons de courte durée. - Séparez les clés API de lecture et d'écriture. La plupart des tâches des agents sont principalement en lecture. Émettez des clés en lecture seule pour celles-ci. Les clés d'écriture sont réservées aux tâches nécessitant une approbation humaine. Ce simple changement réduit de moitié le rayon d'action d'un agent compromis.
- Utilisez le code HTTP 423 Locked pour les points d'accès nécessitant une approbation humaine. Lorsqu'un agent tente d'appeler un point d'accès qui requiert une confirmation humaine, renvoyez 423 avec un champ
confirmation_url. Le planificateur de l'agent voit l'état verrouillé, affiche l'URL à un humain et attend. C'est plus clair qu'un 403, car 403 implique « vous ne pouvez pas faire cela » tandis que 423 implique « vous ne pouvez pas encore faire cela ». - Échouez en mode fermé en cas de dérive de schéma. Si la définition d'outil de l'agent ne correspond pas à votre spécification OpenAPI, le build échoue. N'envoyez pas d'avertissement. Envoyez une erreur. Le coût de quelques builds échoués supplémentaires est bien inférieur à celui d'un incident de production.
Erreurs courantes à éviter :
- Coder en dur l'URL de maquette dans les invites de l'agent. Utilisez des variables d'environnement afin que la même invite s'exécute sur les environnements de maquette, de staging et de production.
- Ignorer l'idempotence sur les « petits » points d'accès. Chaque écriture en a besoin. L'envoi d'e-mails ne fait pas exception.
- Journaliser des corps de requête complets en production. Les informations personnelles identifiables (PII) fuient dans votre pile d'observabilité. Rédigez les jetons, e-mails et identifiants avant qu'ils n'atteignent les journaux.
- Permettre aux agents d'avoir un accès direct à la base de données. Passez toujours par l'API. L'API est l'endroit où résident vos tests.
- Faire confiance au score de confiance de l'agent. Le score reflète la certitude du modèle quant à la réponse, pas la sécurité de l'API. Un agent confiant à 99 % peut toujours appeler le mauvais point d'accès.
Si votre agent communique avec des services internes qui ne sont pas derrière une seule passerelle API, les modèles de test de microservices expliquent comment répartir les tests de scénario entre les services.
Alternatives et outillage
Vous avez des options. Voici une comparaison équitable des quatre approches courantes.
| Approche | Temps de configuration | Point fort | Point faible | Idéal pour |
|---|---|---|---|---|
| Tests unitaires artisanaux | Faible | Contrôle total, pas de dépendance fournisseur | Maintenance élevée, facile à dériver de l'API réelle | Petits projets, équipes de développeurs individuels |
| Faisceau d'évaluation LangSmith / LangGraph | Moyen | Relecture de trace intégrée, métriques conscientes du modèle | Lourd côté agent, léger côté API | Équipes IA axées sur l'évaluation |
| Postman + Postbot | Moyen | Interface utilisateur familière, grande bibliothèque de modèles | Le serveur de maquette est un module complémentaire payant, la syntaxe des scénarios est datée | Équipes déjà investies dans Postman |
| Scénarios Apidog + maquettes | Moyen | OpenAPI natif, maquettes gratuites, CLI de scénario pour CI | Moins de reconnaissance de marque que Postman | Équipes qui veulent un seul outil pour la conception, les maquettes et les tests |
Le résumé honnête : si vous utilisez LangSmith, continuez à faire ce qui fonctionne côté agent et ajoutez une couche de test API distincte. Si les prix de Postman ou son modèle de maquette ne vous conviennent plus, Apidog est un excellent remplaçant. Si vous débutez, choisissez l'outil qui gère OpenAPI, les maquettes et les scénarios dans un seul projet, car c'est là que 80 % de votre temps de test agent-API sera consacré.
Certaines équipes les associent. Ils conservent LangSmith pour les évaluations au niveau du prompt et utilisent Apidog pour les tests de contrat côté API et les relectures de scénarios. Cela fonctionne bien ; les outils servent des couches différentes.
Cas d'utilisation réels
L'agent met à jour les lignes de la base de données de production. Une équipe de succès client a développé un agent qui met à jour les champs de compte à partir des tickets de support. Avant le lancement, ils ont configuré chaque point d'accès en écriture pour exiger une clé d'idempotence et ont exécuté 200 relectures de scénarios dans Apidog contre une base de données bac à sable. Les relectures ont détecté deux cas où l'agent a tenté de définir subscription_status sur une chaîne qui ne figurait pas dans l'énumération. Ils ont ajouté la validation de schéma et ont livré sans incident.
L'agent appelle une API de paiements. Une équipe fintech développant un agent de remboursement automatisé a défini des plafonds stricts : maximum 5 remboursements par session, maximum 50 dollars par remboursement, idempotence requise à chaque appel. Ils ont exécuté la suite de tests de contrat contre l'OpenAPI de Stripe sur chaque PR. Six mois plus tard, ils ont traité 12 000 remboursements sans aucune double facturation.
L'agent trie les problèmes GitHub. Une équipe plateforme a construit un agent de tri des problèmes inspiré par Clawsweeper. Ils ont simulé l'API GitHub dans Apidog, ont fait passer l'agent par 50 tests de scénario couvrant les cas limites (problèmes supprimés, étiquettes manquantes, entrée utilisateur mal formée), et ont découvert trois plantages avant le lancement. L'agent gère maintenant le tri sur un dépôt public avec 5 000 problèmes ouverts.
Conclusion
Si vous ne deviez retenir qu'une chose de ce guide, c'est ceci : l'agent n'est pas le problème. L'API est le problème, ou la solution, selon que vous l'avez testée ou non.
Cinq points à retenir :
- Considérez les schémas d'outils comme des contrats et exécutez des tests de contrat en CI.
- Simulez les points d'accès destructeurs pour chaque boucle de développement d'agent.
- Exigez des clés d'idempotence sur chaque écriture que votre agent peut appeler.
- Définissez des plafonds budgétaires par agent qui échouent en mode fermé lorsqu'ils sont atteints.
- Rejouez les scénarios sur chaque PR qui touche l'API ou les définitions d'outils.
Les incidents viraux de cette année ne seront pas les derniers. Chaque équipe qui déploie des agents rencontrera l'un de ces modes de défaillance au moins une fois. Les équipes qui se rétablissent rapidement sont celles qui avaient déjà mis en place les garde-fous. Téléchargez Apidog et commencez par l'étape du serveur de maquette ; cela seul vous évitera une nuit blanche ce trimestre. Pour la perspective de l'équipe QA sur ce même problème, consultez les outils de test API pour les ingénieurs QA. Pour un contexte plus large sur la rédaction de définitions d'outils que les agents peuvent utiliser en toute sécurité, consultez comment écrire des fichiers AGENTS.md.
FAQ
Comment tester les appels API des agents IA sans dépenser d'argent en jetons ?
Exécutez votre agent contre un serveur de maquette pendant le développement. Les URL de maquette d'Apidog renvoient des réponses réalistes gratuitement, de sorte que vos boucles de test ne consomment pas de crédits API réels. Fixez la température à 0 et utilisez un petit ensemble de prompts fixes. Vous pouvez exécuter des milliers d'itérations de test pour le coût du serveur de maquette, qui est de zéro. Consultez la liste de contrôle de test de l'ingénieur QA pour la configuration complète.
Quelle est la différence entre tester l'agent et tester l'API ?
Le test d'agent vérifie si le modèle choisit le bon outil et remplit correctement les arguments. Le test d'API vérifie si le point d'accès se comporte correctement lorsqu'il est appelé. Les deux sont importants. Un agent parfait appelant une API cassée produit toujours des résultats cassés, et un agent cassé appelant une API parfaite livre toujours des bugs. Vous avez besoin que les deux couches soient testées séparément.
Ai-je besoin de clés d'idempotence sur chaque point d'accès ?
Oui, sur chaque point d'accès en écriture. Les lectures sont idempotentes par définition. Les écritures ne le sont pas, et les agents réessayent. Les cinq lignes de middleware pour prendre en charge un en-tête d'idempotence se rentabilisent dès la première fois que l'agent réessaie une erreur 500 et que vous n'obtenez pas de ligne en double.
Comment empêcher l'injection de prompt de déclencher de mauvais appels API ?
Ne vous fiez pas uniquement à la couche de prompt. L'API doit appliquer l'autorisation basée sur le contexte utilisateur original, et non sur la requête de l'agent. Si une session de contexte utilisateur ne peut normalement pas atteindre /admin/delete-all-users, alors l'agent agissant au nom de cet utilisateur ne devrait pas pouvoir le faire non plus, indépendamment de ce que dit le prompt. Le Top 10 des LLM de l'OWASP couvre cela en détail.
Puis-je utiliser Apidog directement avec Claude ou GPT, sans écrire ma propre couche d'outils ?
Vous pointez les définitions d'outils de votre agent vers l'URL de maquette Apidog pendant les tests. Claude et GPT prennent en charge les URL de base HTTP arbitraires dans leurs définitions d'outils, donc l'échange se fait via une variable d'environnement. Lorsque vous êtes prêt à tester contre l'environnement de staging ou de production, modifiez la variable.
Quel est le bon plafond budgétaire pour un agent ?
Commencez de manière stricte et assouplissez avec les données. Commencez avec 50 000 jetons par session, 30 appels API par minute, 5 dollars par tâche. Surveillez les métriques pendant deux semaines. Augmentez les plafonds que vous atteignez légitimement. Réduisez les plafonds que vous n'atteignez jamais. Révisez mensuellement. L'objectif n'est pas un nombre fixe ; c'est un nombre suffisamment strict pour attraper les boucles incontrôlées et suffisamment souple pour permettre le travail réel.
Comment détecter la dérive de schéma entre les outils de mon agent et mon API ?
Exécutez une comparaison de schémas en CI sur chaque PR. Comparez la définition d'outil de l'agent (schéma JSON) avec le schéma de corps de requête OpenAPI pour le même point d'accès. Faites échouer le build s'ils divergent. L'extrait de code Python de 30 lignes dans la section des garde-fous ci-dessus le fait ; copiez-le dans votre dépôt et intégrez-le dans GitHub Actions.