DeepSeek a mis les poids de DeepSeek-V4.1-Flash sur Hugging Face sous licence MIT le 10 septembre 2026, le jour même où le modèle est devenu GA sur l'API. C'est un timing inhabituel. La plupart des laboratoires livrent d'abord le point d'accès hébergé et ne publient les poids que des semaines plus tard, voire pas du tout.
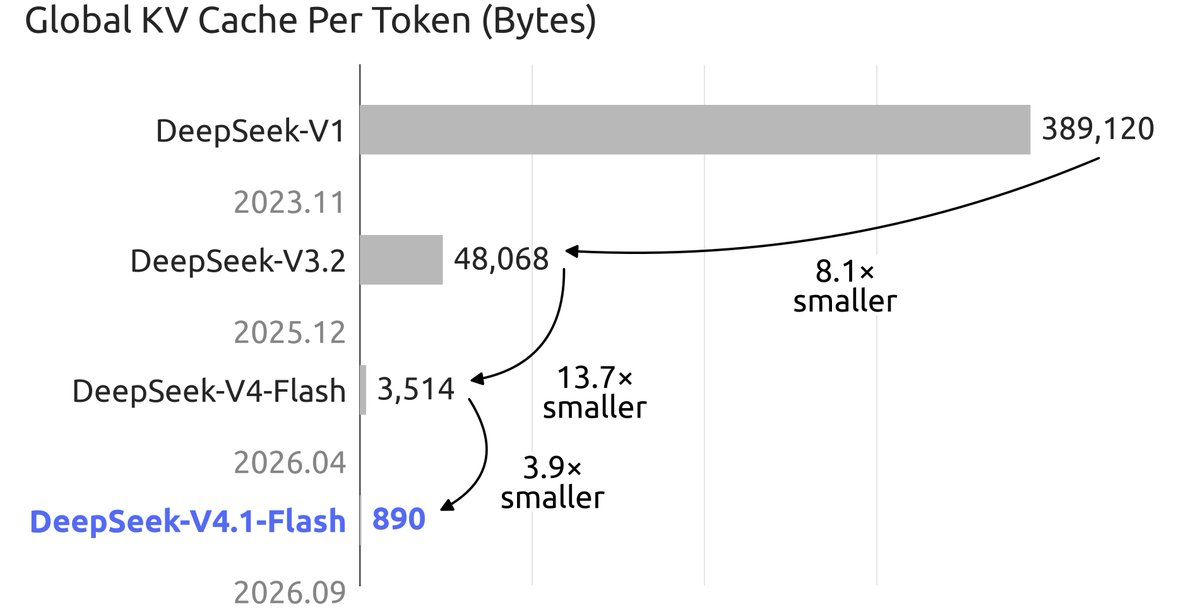
Le chiffre phare effraiera la plupart des lecteurs : 552 milliards de paramètres dans le cœur, 763 milliards avec l'encodeur de vision. Mais la conception sous-jacente est plus propice à l'auto-hébergement que ne le suggère la taille. Seuls 8 milliards de paramètres sont actifs pendant le pré-remplissage et 16 milliards pendant le décodage, et le nouveau cache KV FP4 coûte 890 octets par jeton, soit environ un quart de ce dont V4-Flash avait besoin. Le calcul est bon marché. La mémoire est le véritable obstacle.
Les gens essaieront quand même. Ce guide vous donne les calculs de mémoire, les chemins réalistes pour chaque niveau de matériel, les commandes de configuration génériques et un moyen de tester un point de terminaison local compatible OpenAI par rapport à l'API hébergée dans Apidog. Si vous souhaitez d'abord un aperçu du modèle, lisez Qu'est-ce que DeepSeek-V4.1-Flash ? et revenez.
En bref
- Poids : 552 milliards de paramètres MoE, licence MIT. Environ 552 Go en 8 bits, environ 280 Go en 4 bits, cœur seul.
- Cache KV : 890 octets par jeton. Un contexte complet d'un million de jetons nécessite environ 0,9 Go. Cette partie est résolue.
- Le service réaliste en 4 bits nécessite 4 à 8 GPU de la classe 80 Go. Tout ce qui est en dessous est déchargement sur CPU ou SSD, et lent.
- L'API hébergée facture 0,15 $ par million de jetons d'entrée manqués en dehors des heures de pointe. Pour la plupart des équipes, cela bat à lui seul la facture d'électricité.
Ce que vous téléchargez
La fiche du modèle décrit un cœur Mixture-of-Experts de 552 milliards de paramètres avec une nouvelle architecture Causal Encoder-Decoder : 40 couches, divisées en 20 encodeurs et 20 décodeurs. Chaque couche achemine à travers 384 experts plus 1 expert partagé. L'encodeur de vision DeepSeek-ViT pousse le checkpoint complet à 763 milliards de paramètres, et vous téléchargez l'ensemble même si vous n'avez besoin que de texte.
Trois détails importent pour l'inférence locale :
- Les paramètres actifs sont petits. 8 milliards actifs pendant le pré-remplissage, 16 milliards pendant le décodage. Les FLOPs par jeton ressemblent à un modèle dense de taille moyenne. Le problème est que chacun des 552 milliards de paramètres doit résider quelque part où la passe avant peut l'atteindre.
- Le cache KV est FP4. La note de version indique que le cache utilise 1/4 de la HBM et 1/8 du stockage SSD de la génération précédente. À 890 octets par jeton, le contexte long n'est plus le problème de mémoire qu'il était auparavant.
- L'attention est intrinsèquement éparse. L'Attention Éparse Compressée 2 avec trois modes statiques a été entraînée avec un contexte de 64K et étendue à 1M à la fin de l'exécution de 45T jetons. C'est pourquoi les chiffres KV restent faibles à 1M.
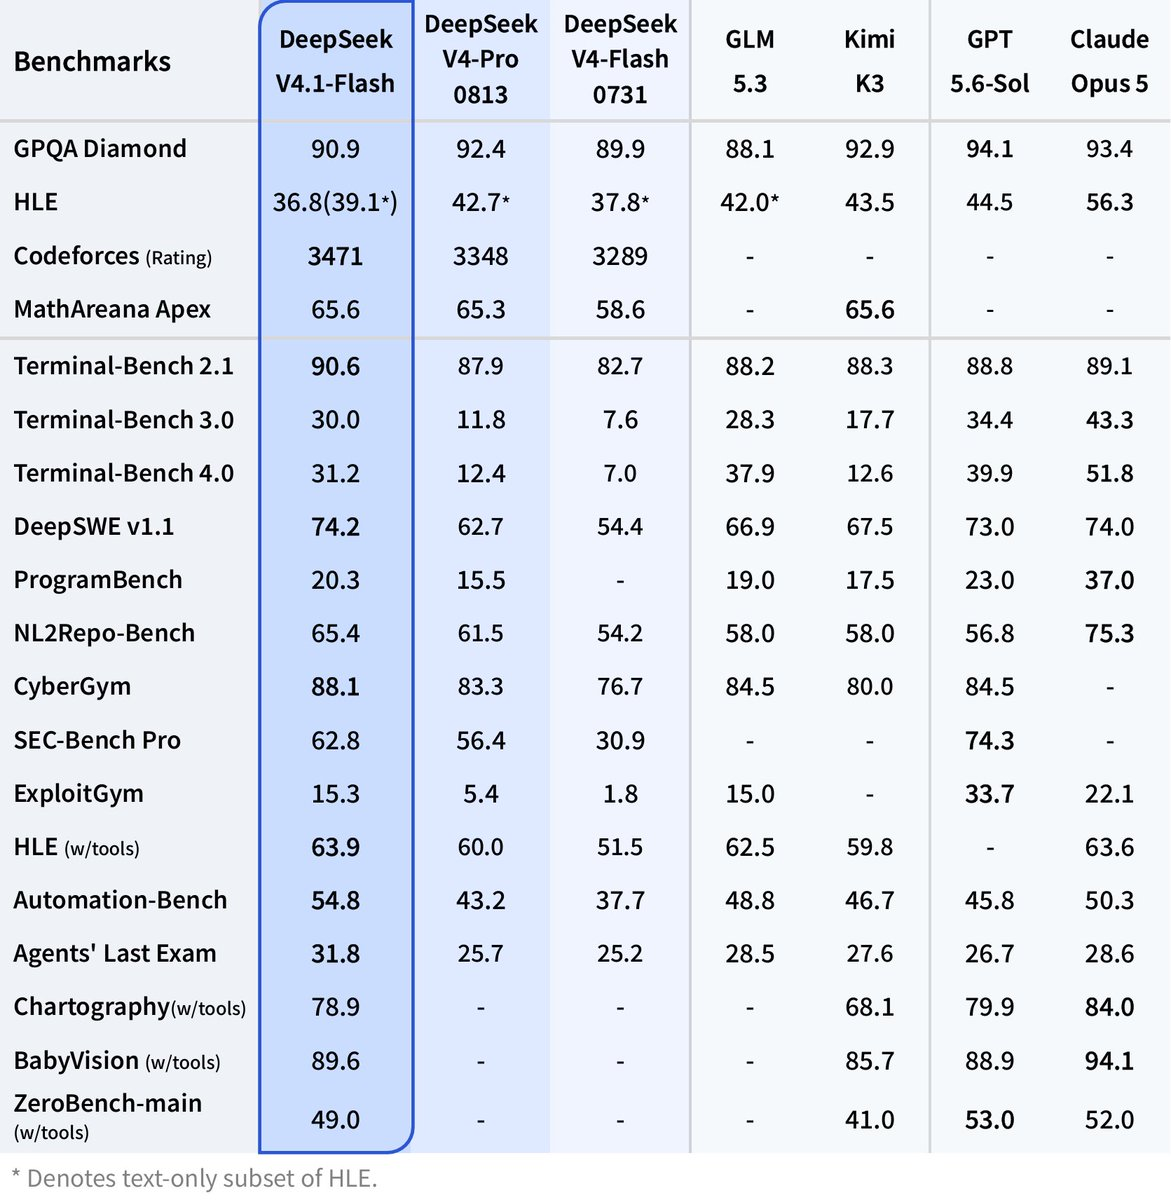
Le rapport technique couvre l'architecture en détail. Chaque chiffre de référence sur la fiche est rapporté par DeepSeek ; traitez-les comme des affirmations.
Le calcul de la mémoire
Les chiffres ci-dessous sont des multiplications directes, non des mesures, et ils excluent la surcharge du moteur, les activations et l'encodeur de vision.
| Composant | Taille | Comment c'est calculé |
|---|---|---|
| Poids du cœur, 8 bits | ~552 Go | 552 milliards de paramètres x 1 octet |
| Poids du cœur, 4 bits | ~280 Go | 552 milliards de paramètres x 0,5 octet |
| Cache KV, par jeton | 890 octets | D'après la fiche du modèle |
| Cache KV à 128K de contexte | ~0,11 Go | 890 x 128 000 |
| Cache KV à 1M de contexte | ~0,89 Go | 890 x 1 000 000 |
Deux choses sautent aux yeux. Premièrement, le cache KV est une erreur d'arrondi. Une session d'un million de jetons tient en moins d'un gigaoctet, vous pouvez donc conserver des dizaines de sessions longues en mémoire sans toucher au budget des poids. Deuxièmement, les poids sont le problème entier. Aucune astuce de quantification ne permet de faire tenir 552 milliards de paramètres sur un seul GPU grand public, et la conception à 8 milliards de paramètres actifs n'aide pas, car le routage MoE a toujours besoin de chaque expert chargé et adressable.
C'est aussi pourquoi les configurations déchargées semblent déséquilibrées. Le pré-remplissage traite les lots sur l'ensemble de l'invite et reste lié au calcul. Le décodage charge 16 milliards de paramètres actifs depuis la RAM ou le SSD pour chaque jeton. La bande passante, et non les FLOPs, détermine vos jetons par seconde.
Niveaux de matériel réalistes
Pas de chiffres de débit ici. Personne en dehors de DeepSeek n'a eu les poids assez longtemps pour publier des benchmarks fiables.
Niveau 1 : serveur multi-GPU, 4 à 8 cartes de la classe 80 Go. Quatre cartes de 80 Go vous donnent 320 Go, suffisamment pour les poids en 4 bits avec une petite marge pour le cache KV et la surcharge du moteur. Huit cartes vous donnent 640 Go, suffisamment pour le checkpoint en 8 bits ou un déploiement confortable en 4 bits avec de grands lots. C'est le seul niveau où "l'exécuter localement" signifie un service de qualité production avec parallélisme tensoriel, et c'est un achat à cinq ou six chiffres ou une location cloud à plusieurs dollars par heure.
Niveau 2 : station de travail unique à haute mémoire avec déchargement CPU. Un boîtier avec 512 Go ou plus de RAM système et un ou deux GPU peut contenir les poids en 4 bits en RAM et diffuser les couches d'experts vers le GPU à la demande. Cela fonctionne, et c'est lent, car la bande passante de décodage est votre bus DDR5 au lieu de la HBM. Utilisez-le pour les tâches par lots et les évaluations nocturnes, pas pour le chat interactif.
Niveau 3 : Apple Silicon avec streaming SSD. Le chemin de l'amateur. Un Mac Studio de 512 Go contient les poids en 4 bits dans la mémoire unifiée, ce qui est une option réelle si vous en possédez déjà un. En dessous, vous êtes dans le territoire du fil Kimi K3 HN : poids répartis sur des SSD externes, mmap faisant le gros du travail, environ 1 jeton par seconde. Cela prouve que le modèle fonctionne, pas qu'il est utile sur cette machine. Notre guide pour exécuter Kimi K3 localement couvre les mêmes compromis sur un modèle plus grand, et comment exécuter DeepSeek V4 localement couvre la génération précédente.
Le chemin d'installation
Avec le matériel en place, le flux est : télécharger, servir derrière un point d'accès compatible OpenAI, tester.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
Sur une ligne de 1 Gbit/s, chaque 100 Go prend environ 15 minutes à pleine vitesse. Prévoyez une heure ou plus.
Le service est là où réside la mise en garde. Le support Day-0 dans vLLM, SGLang, llama.cpp et Ollama pour l'architecture CED et l'attention CSA2 est [À VÉRIFIER] ; un nouveau type de couche nécessite généralement un correctif moteur avant le chargement des poids, et la note de version ne nomme pas de moteurs spécifiques. Recherchez "DeepSeek-V4.1" dans le journal des modifications de chaque projet avant de vous engager dans un téléchargement. Une fois le support existant, le service avec vLLM sur 8 GPU ressemble à ceci :
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Un `llama-server` de llama.cpp ou un modèle Ollama expose le même point d'accès de type `http://localhost:8000/v1` une fois qu'une conversion GGUF existe, de sorte que tout client SDK OpenAI fonctionne en changeant une seule ligne :
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
Les valeurs `temperature=1.0` et `top_p=0.95` correspondent aux paramètres recommandés par la fiche du modèle. Pour Ollama, notre guide Ollama couvre le flux Modelfile, et le guide vLLM couvre en détail les drapeaux multi-GPU.
L'alternative pragmatique : l'API hébergée
En dehors des heures de pointe, la page de tarification indique que `deepseek-flash` coûte 0,15 $ par million de jetons d'entrée manqués, 0,003 $ par million de jetons d'entrée en cache et 0,60 $ par million de jetons de sortie. Les heures de pointe doublent ces prix. Ainsi, un milliard de jetons d'entrée plus 200 millions de jetons de sortie par mois coûtent environ 270 $ en dehors des heures de pointe et 540 $ aux heures de pointe, avant que les accès au cache ne réduisent davantage le coût des entrées. Un serveur à 8 GPU de la classe 80 Go coûte plus que cela par mois en électricité et en refroidissement uniquement sous charge soutenue, avant d'amortir le matériel ou de payer quelqu'un pour le surveiller. À moins d'avoir une règle de résidence des données ou du matériel déjà inutilisé, l'API l'emporte sur le coût. Le changement consiste en une modification de `base_url` ; notre guide de l'API DeepSeek-V4.1-Flash vous explique comment faire.
Le local l'emporte lorsque la contrainte n'est pas l'argent : environnements isolés, données d'invite que vous ne pouvez envoyer nulle part, ou recherche nécessitant de modifier les poids.
Testez un point d'accès local par rapport à l'API hébergée dans Apidog
Quelle que soit l'approche que vous choisissez, prouvez que le serveur local se comporte comme la référence avant d'y diriger le trafic. La dérive de quantification, un mauvais modèle de chat ou un jeton d'arrêt manquant se manifestent tous par des différences de sortie subtiles. Voici le flux de travail dans Apidog :
- Créez deux environnements. Un nommé
localavecbase_urldéfini surhttp://localhost:8000/v1, un nomméhostedavecbase_urldéfini surhttps://api.deepseek.comet votre vraie clé. Chaque requête utilise{{base_url}}/chat/completionsetBearer {{api_key}}. - Enregistrez un petit ensemble d'invites comme requêtes. Cinq à dix invites qui représentent votre charge de travail : une extraction JSON, une correction de code, un résumé de contexte long. Définissez
modelsurdeepseek-flashdans toutes ; cela fonctionne sur les deux serveurs. - Ajoutez des assertions. Pour la tâche JSON, affirmez que la réponse est analysée et qu'une clé requise existe. Pour chaque requête, affirmez que
finish_reasonest égal àstop, ce qui détecte la troncation due à un mauvais réglage de contexte. - Exécutez l'ensemble sur les deux environnements. Basculez le menu déroulant de l'environnement de
hostedàlocalet réexécutez le même scénario de test. Un échec qui n'apparaît que surlocalest votre problème de quantification ou de modèle, isolé en un clic. - Surveillez le streaming. Définissez
stream: trueet utilisez la vue SSE pour voir les événements arriver un par un. Un serveur local qui met en tampon toute la réponse avant de l'envoyer semble correct sur un appel non-streaming et incorrect ici. - Intégrez-le à votre CI. Exécutez le scénario avec
apidog-clià chaque mise à niveau du moteur, afin qu'un modèle de chat cassé fasse échouer un pipeline au lieu d'un utilisateur.
Téléchargez Apidog et l'ensemble du flux s'exécute à partir d'un seul projet.
FAQ
- Puis-je exécuter DeepSeek-V4.1-Flash sur un ordinateur portable ? Pas utilement. Le cœur en 4 bits pèse environ 280 Go. Un ordinateur portable peut le diffuser depuis un SSD comme l'a fait l'expérience Kimi K3, à environ 1 jeton par seconde, ce qui est une démonstration, pas un flux de travail. Utilisez l'API ou l'une des options de comment utiliser DeepSeek-V4.1-Flash gratuitement.
- Est-ce que 8 milliards de paramètres actifs signifie que je n'ai besoin que de 8 Go de VRAM ? Non. Les paramètres actifs définissent le calcul par jeton, pas la mémoire. Le routage MoE peut choisir n'importe lequel des 384 experts par couche pour n'importe quel jeton, donc tous les 552 milliards de paramètres doivent être chargés et accessibles.
- Combien de mémoire le contexte de 1M nécessite-t-il ? Environ 0,89 Go de cache KV à 890 octets par jeton. C'est la partie peu coûteuse de ce modèle. Les poids sont la partie coûteuse.
- La licence est-elle sûre pour un usage commercial ? Oui. Les poids sont sous licence MIT, selon la fiche du modèle Hugging Face.
Où cela vous mène
DeepSeek-V4.1-Flash est ouvert de la manière qui compte légalement et techniquement : poids MIT, rapport technique public et une conception de cache KV qui rend les sessions de 1M de jetons presque gratuites en mémoire. Il n'est pas ouvert de la manière qui vous permet de l'exécuter sur la machine sous votre bureau. Pour la plupart des équipes, la bonne approche est l'API hébergée à 0,15 $ par million de jetons d'entrée en dehors des heures de pointe, avec un déploiement local réservé aux données qui ne peuvent pas quitter le bâtiment.
Dans tous les cas, testez avant de faire confiance. Pointez Apidog vers les deux points d'accès, exécutez les mêmes requêtes enregistrées et laissez les assertions vous dire si votre construction locale correspond à la référence.