
Pour documenter les API Kafka, rédigez un contrat pour chaque topic. Il doit indiquer le nom du topic, la clé de l'événement, le schéma du payload, les en-têtes, les garanties d'ordre et de livraison, les groupes de consommateurs, la durée de rétention et le propriétaire. Stockez ensuite ce contrat à côté de votre documentation d'API HTTP, afin que producteurs et consommateurs consultent une seule source de vérité au lieu d'ingénierie inverse sur les messages d'un cluster en production.
Ce guide détaille chaque élément de ce contrat, comment l'écrire en AsyncAPI, comment faire évoluer les schémas en toute sécurité, et comment laisser votre agent de code faire le travail avec l'Apidog CLI.
Si vous débutez dans la conception orientée événements, commencez par comment construire des API événementielles et le guide des webhooks et de l'architecture événementielle.
Qu'est-ce qu'une API Kafka ?
Une API Kafka est l'ensemble des topics, des formats de messages et des règles de livraison que les services utilisent pour échanger des événements via un cluster Apache Kafka. Contrairement à une API REST, personne n'appelle un point de terminaison en attendant une réponse. Les producteurs écrivent des enregistrements dans des topics, les consommateurs les lisent à leur propre rythme, et le contrat réside dans la structure et la signification de ces enregistrements.
La documentation Kafka le dit clairement : « un événement possède une clé, une valeur, un horodatage et des en-têtes de métadonnées optionnels. » Kafka lui-même ne vérifie pas le contenu de la valeur. Un producteur peut écrire du JSON un jour et un format JSON différent le lendemain, et le broker acceptera les deux. C'est pourquoi les API Kafka ont plus besoin de contrats écrits que les API HTTP : rien dans la couche de transport n'empêche un changement incompatible.
Les topics non documentés échouent de manière prévisible : un consommateur devine le type d'un champ à partir d'un seul échantillon et plante sur un null, ou un nouveau service ignore qu'il reçoit chaque message au moins une fois et facture deux fois lors des réessais.
Quoi documenter pour chaque topic Kafka
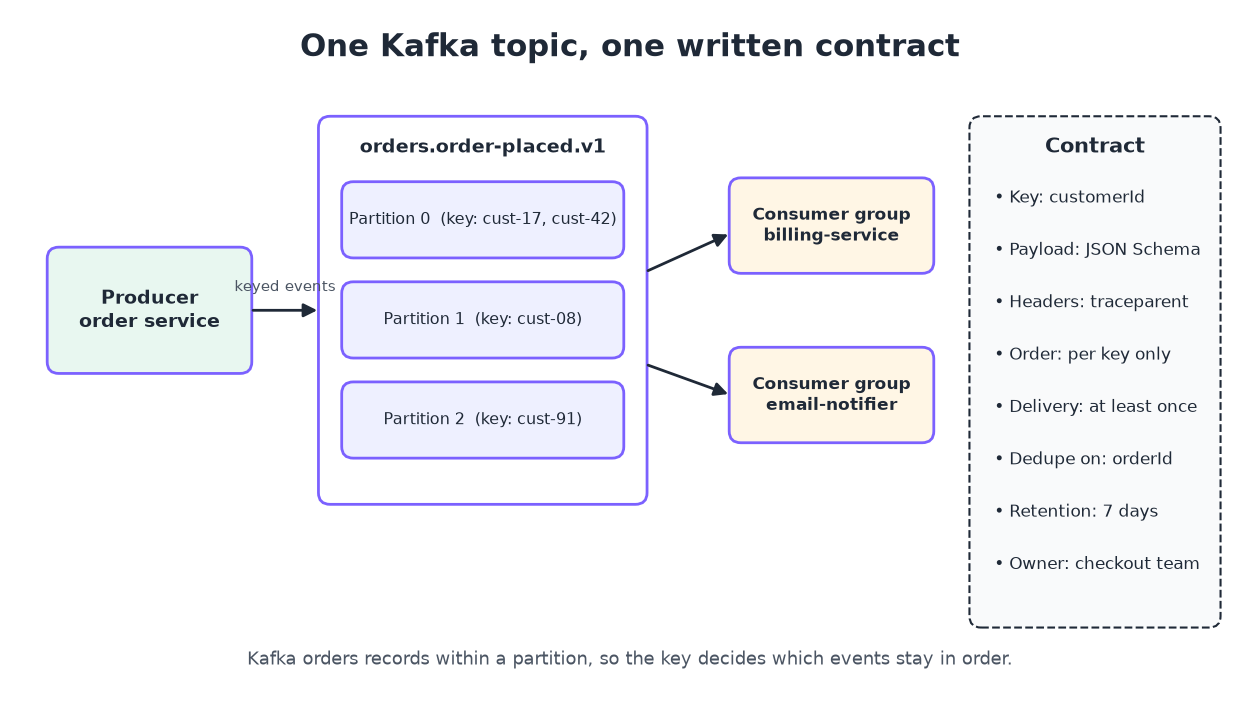
Chaque topic nécessite les mêmes informations essentielles. Utilisez ce tableau comme liste de contrôle :
| Champ du contrat | Ce qu'il faut noter | Exemple |
|---|---|---|
| Nom du topic | Nom complet et convention de nommage | orders.order-placed.v1 |
| Objectif | Une phrase sur la signification de l'événement | « Une commande a été payée et est prête à être expédiée » |
| Clé de l'événement | Quel champ sert de clé, et pourquoi | customerId, pour que les commandes d'un client restent ordonnées |
| Schéma du payload | Chaque champ, type, caractère obligatoire et format | JSON Schema, Avro ou Protobuf |
| En-têtes | Nom, type et signification de chaque en-tête | traceparent, schema-version |
| Partitions et ordre | Nombre de partitions et garantie d'ordre | 12 partitions, ordre par customerId |
| Sémantique de livraison | Au moins une fois, producteur idempotent, transactions | Au moins une fois ; les consommateurs doivent dédupliquer sur orderId |
| Groupes de consommateurs | Groupes connus et rôle de chacun | billing-service, email-notifier |
| Rétention | Durée pendant laquelle les enregistrements restent lisibles | 7 jours |
| Propriété | Équipe propriétaire, contact et politique de versioning | Équipe Checkout, #checkout-events |
Les lignes sur l'ordre et la livraison sont les plus importantes : les lecteurs ne peuvent pas les déduire d'un simple échantillon de message.
Comment documenter les API Kafka en 6 étapes
- Listez chaque topic et son propriétaire. Extrayez la liste des topics de votre cluster et indiquez qui produit dans chacun.
- Définissez la clé. Notez quel champ sert de clé et ce que cela implique pour l'ordre.
- Rédigez le schéma du payload. Décrivez chaque champ avec JSON Schema, Avro ou Protobuf.
- Décrivez les en-têtes et les métadonnées. Incluez les en-têtes de traçage, de version de schéma et de type de contenu.
- Énoncez les garanties. Documentez la sémantique de livraison, la portée de l'ordre, la rétention et les groupes de consommateurs.
- Publiez-la là où les gens cherchent. Placez le contrat à côté de votre documentation d'API HTTP et versionnez-le comme du code.
Étapes 1 et 2 : topics et clés
Un schéma de nommage comme <domain>.<event>.<version> indique aux lecteurs qui possède le topic et quelle version ils consultent. Documentez ensuite la clé, car elle détermine la partition. La documentation de Kafka précise que « les événements avec la même clé (par exemple, un identifiant client ou véhicule) sont écrits dans la même partition », et que les consommateurs lisent les événements d'une partition « exactement dans l'ordre où ils ont été écrits ».
Votre contrat doit donc dire « ordre par customerId », et non « ordonné ». Kafka ne garantit l'ordre qu'à l'intérieur d'une partition, jamais sur un topic entier.
Étape 3 : le schéma du payload
Le payload est la partie sur laquelle les consommateurs écrivent leur code, décrivez-le donc champ par champ. Voici un JSON Schema pour un événement order-placed :
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
La description « use it to deduplicate » indique au consommateur quoi faire du champ, et pas seulement son type. Novice avec ce format ? Lisez qu'est-ce que JSON Schema.
Étapes 4 et 5 : en-têtes et garanties
Listez chaque en-tête (contexte de traçage, version de schéma, type de contenu) et précisez si les consommateurs peuvent s'y fier. Notez ensuite la garantie de livraison, dans les termes de Kafka. La documentation de conception de Kafka indique que « Kafka garantit par défaut une livraison at-least-once », ce qui signifie que les messages « ne sont jamais perdus mais peuvent être redelivrés ». Si votre producteur utilise l'option idempotente ou des transactions, dites-le. Sinon, demandez aux consommateurs de dédupliquer, et nommez le champ de déduplication.
Documentez aussi les groupes de consommateurs. Au sein de chaque groupe abonné, une partition « est consommée par exactement un consommateur » à la fois. Cela indique aux lecteurs jusqu'où un groupe peut passer à l'échelle : un consommateur actif par partition.
Rédiger le contrat en AsyncAPI
Les outils ont besoin d'un format lisible par machine, et pour Kafka c'est généralement AsyncAPI, une spécification « utilisée pour décrire des API pilotées par messages dans un format lisible par machine ». Elle joue le rôle qu'OpenAPI joue pour REST.
Un document AsyncAPI 3.0 contient info, servers, channels, operations et components. Un canal correspond à un topic via son address, et chaque opération a une action de type send ou receive :
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPI propose aussi des bindings Kafka au niveau du serveur, du canal, de l'opération et du message. C'est là que vont les détails propres à Kafka, ceux que les champs génériques ne peuvent pas exprimer. Conservez la spécification dans le dépôt du producteur, afin que la pull request qui modifie un événement modifie aussi son contrat.
Évolution des schémas Kafka : documenter la règle de compatibilité
Votre schéma va évoluer. Le contrat doit préciser quelles modifications sont sûres. Si vous utilisez un registre de schémas, documentez son mode de compatibilité. La documentation Confluent sur l'évolution des schémas liste ces modes, et note que « le type de compatibilité par défaut du Confluent Schema Registry est BACKWARD » :
| Mode | Qui peut lire quoi |
|---|---|
| BACKWARD | Les consommateurs sur le nouveau schéma peuvent lire les données écrites avec le schéma précédent |
| BACKWARD_TRANSITIVE | Les consommateurs sur le nouveau schéma peuvent lire les données de tous les schémas antérieurs |
| FORWARD | Les consommateurs sur le schéma précédent peuvent lire les données écrites avec le nouveau schéma |
| FORWARD_TRANSITIVE | Les consommateurs sur n'importe quel schéma antérieur peuvent lire les données écrites avec le nouveau schéma |
| FULL | Compatibilité ascendante et descendante avec le schéma précédent |
| FULL_TRANSITIVE | Compatibilité ascendante et descendante avec tous les schémas antérieurs |
| NONE | Les vérifications de compatibilité sont désactivées |
En pratique, avec BACKWARD, vous pouvez ajouter des champs optionnels et supprimer des champs disposant de valeurs par défaut. Renommer un champ obligatoire ou changer son type casse les consommateurs. Lorsque vous avez besoin d'un changement incompatible, publiez une nouvelle version du topic (orders.order-placed.v2), documentez les deux, et fixez une date de retrait pour l'ancienne.
Laissez votre agent de code documenter les API Kafka avec Apidog CLI
Les contrats rédigés à la main deviennent obsolètes dès que quelqu'un modifie un producteur. Votre agent de code peut lire le code du producteur, écrire les schémas et maintenir la documentation à jour pendant que vous relisez. L'Apidog CLI fournit à Claude Code, Codex, Cursor ou tout agent terminal les commandes nécessaires pour le faire dans un projet Apidog.
Installez la CLI, connectez-vous et ajoutez la skill Apidog pour que votre agent connaisse les commandes :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Vous pouvez aussi confier l'installation à l'agent : dites-lui de lire le guide d'installation d'Apidog CLI et de se configurer lui-même.
Puis donnez un seul prompt à votre agent :
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
L'agent examine la structure du payload, valide son fichier, puis écrit le schéma et la page de contrat :
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema create stocke le payload comme un schéma de données réutilisable. Vos points de terminaison HTTP peuvent référencer le même modèle, de sorte qu'un Order défini une seule fois couvre à la fois la réponse REST et l'événement Kafka. apidog doc create écrit un document Markdown dans l'arborescence du projet, qui contient le contrat du topic du tableau ci-dessus. Lorsqu'un producteur change, relancez le prompt et l'agent utilise apidog schema update. Pour un tutoriel plus détaillé sur la documentation pilotée par agent, consultez comment documenter des API depuis la CLI et Apidog CLI dans Claude Code.
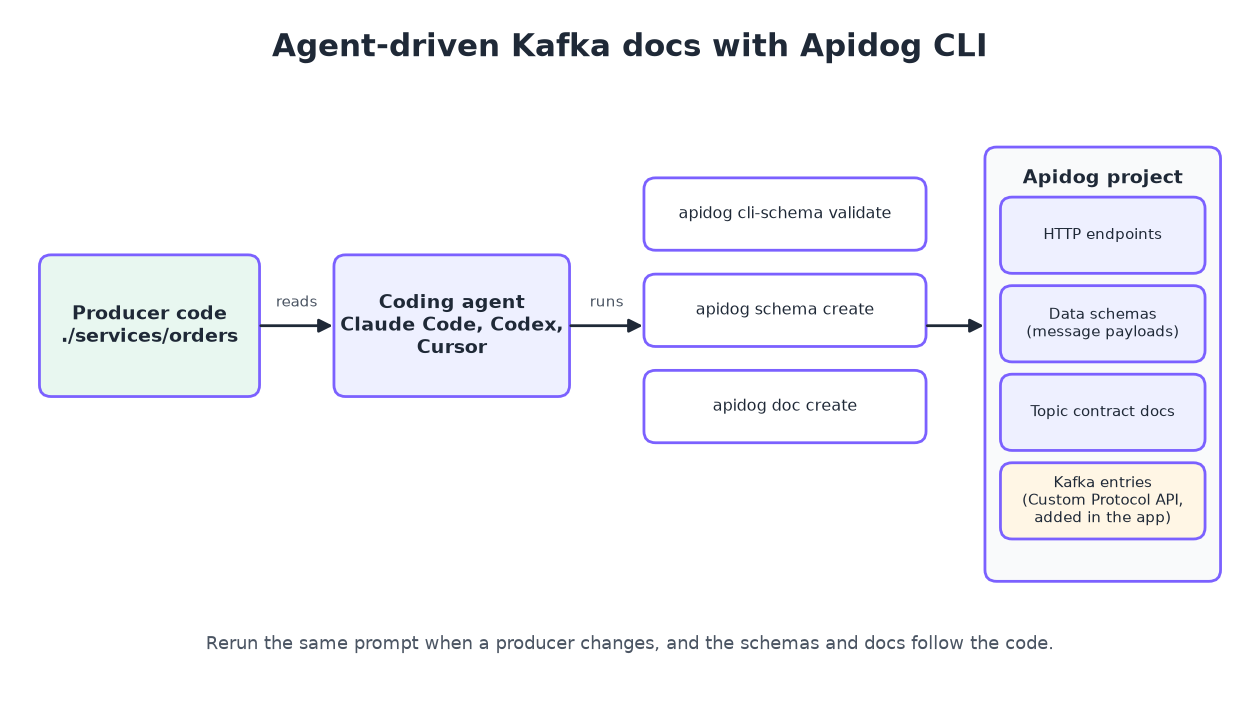
Une étape reste dans l'application. La fonctionnalité Custom Protocol API d'Apidog documente les points de terminaison Kafka aux côtés de ceux HTTP : choisissez New Other Protocol APIs, puis Other Custom Protocol API, sélectionnez Kafka comme protocole, et renseignez l'URI (le topic), le nom, le statut, les mainteneurs, les tags et la description. Ces entrées partagent l'arborescence de dossiers, la recherche et Quick Share avec votre documentation HTTP. La CLI n'a pas encore de commande pour les points de terminaison à protocole personnalisé : c'est donc la seule partie à créer manuellement.
Apidog Free couvre jusqu'à 4 utilisateurs, une petite équipe peut donc garder sa documentation REST et Kafka dans un seul projet sans frais.
FAQ
Existe-t-il un OpenAPI pour Kafka ?
AsyncAPI joue ce rôle. Il décrit les serveurs, les canaux (topics), les opérations et les payloads de messages en YAML ou JSON, avec des bindings spécifiques à Kafka.
Faut-il un registre de schémas pour documenter les API Kafka ?
Non, mais c'est utile. La documentation énonce les règles ; un registre les applique à l'écriture. Si vous en utilisez un, documentez son mode de compatibilité.
Quelle est la différence entre documenter un topic Kafka et un point de terminaison REST ?
Une documentation REST décrit une requête et une réponse. Une documentation Kafka décrit un message unique que de nombreux consommateurs liront plus tard ; elle nécessite donc aussi la clé, la portée de l'ordre, la garantie de livraison, la rétention et les groupes de consommateurs. Aucun de ces éléments n'apparaît dans une documentation REST classique.
Apidog peut-il tester des messages Kafka ?
Apidog documente les points de terminaison Kafka via Custom Protocol API, mais n'envoie ni ne consomme de messages Kafka. Utilisez-le pour héberger le contrat et les schémas de payload, et testez le code producteur et consommateur avec votre bibliothèque cliente Kafka.
À quelle fréquence mettre à jour la documentation Kafka ?
Chaque fois qu'un producteur modifie un message. Associez-la à la revue de code : la pull request qui change l'événement met à jour le contrat, ou votre agent le régénère avec Apidog CLI.