
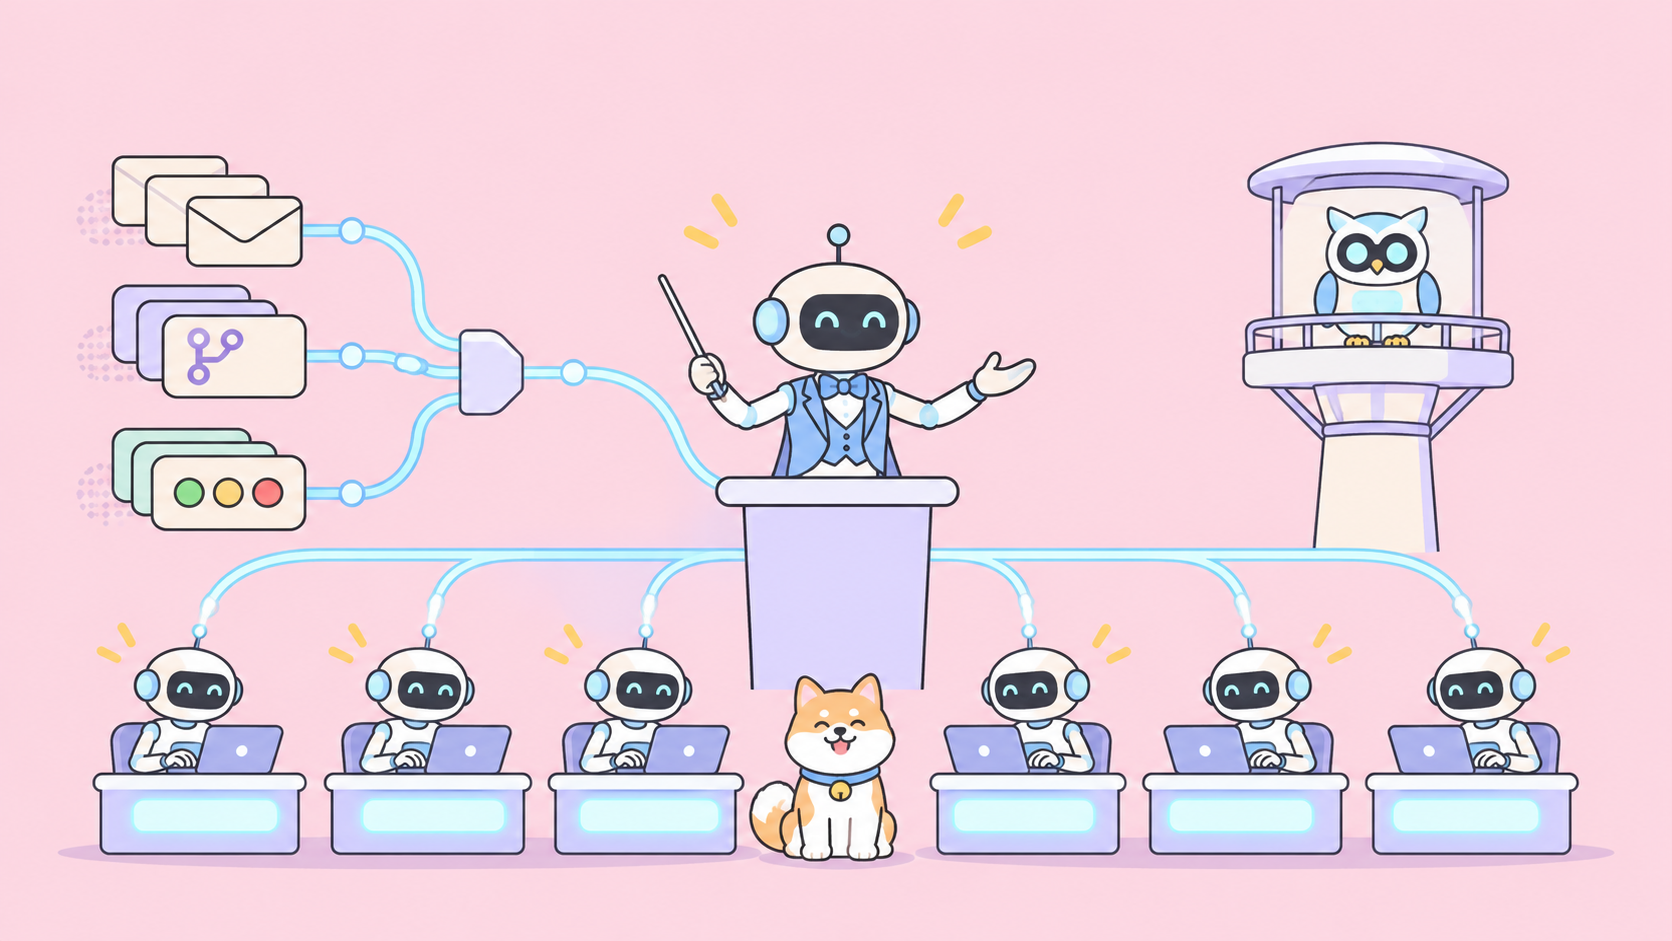
Pour concevoir un super-agent comme celui décrit par DeepSeek Harness, divisez votre agent en deux couches : une session Router permanente qui communique avec les humains et répartit le travail, et plusieurs sessions Worker isolées qui exécutent chacune une tâche spécifique avec l'ensemble des outils à disposition. Alimentez ces deux niveaux à l'aide de déclencheurs d'événements (Triggers : chat, GitHub, CI), acheminez les messages de suivi par fil de discussion (Thread), et intégrez un composant de surveillance indépendant (Watchdog) pour garder un œil sur l'ensemble du système.
Ce guide transforme l'essai d'architecture de DeepSeek Harness, « Exploring Super-agent Design », en un plan de mise en œuvre étape par étape. Une précision toutefois : cet article expose une architecture conceptuelle et non une fonctionnalité prête à l'emploi. Certaines briques existent sous la forme d'un plugin prototype nommé dsh-superagent-prototype, qualifié par ses auteurs de « produit non officiel de DeepSeek ». Les extraits de code ci-dessous sont fournis à titre purement illustratif et ne proviennent pas du code de DeepSeek.
Qu'est-ce qu'un super-agent ?
Un super-agent est un coéquipier IA unique et toujours en ligne, capable de recevoir des événements provenant de multiples canaux (messagerie, pull requests, CI), d'exécuter de nombreuses tâches en parallèle dans des sessions isolées, et d'interagir avec les utilisateurs sous une identité unique et cohérente.
Le problème : les sessions d'agents sont isolées, et « une personne ne peut généralement suivre que 3 à 5 sessions actives à la fois ». Une tâche individuelle est limitée par les capacités du modèle, tandis que le multitâche est limité par l'attention humaine. Le super-agent s'attaque à cette seconde contrainte.
Il repose sur quatre piliers :
- Continu : un agent unique sur la messagerie instantanée comme sur GitHub. Vous échangez sur le plan A dans le chat, passez au plan B dans un commentaire de PR, et il suit le fil sans interruption.
- Productif : il exécute les tâches en parallèle et prend en charge votre prochaine consigne avant même d'avoir terminé la précédente.
- Proactif : il surveille les événements en arrière-plan et reste discret tant qu'aucune intervention n'est requise.
- Persistant : il fonctionne en continu et est capable de récupérer automatiquement en cas d'erreur.
Si vous découvrez le framework, commencez par consulter notre article pour savoir ce qu'est DeepSeek Harness et comment il se compare à Claude Code.
Architecture d'un super-agent : les cinq modules clés
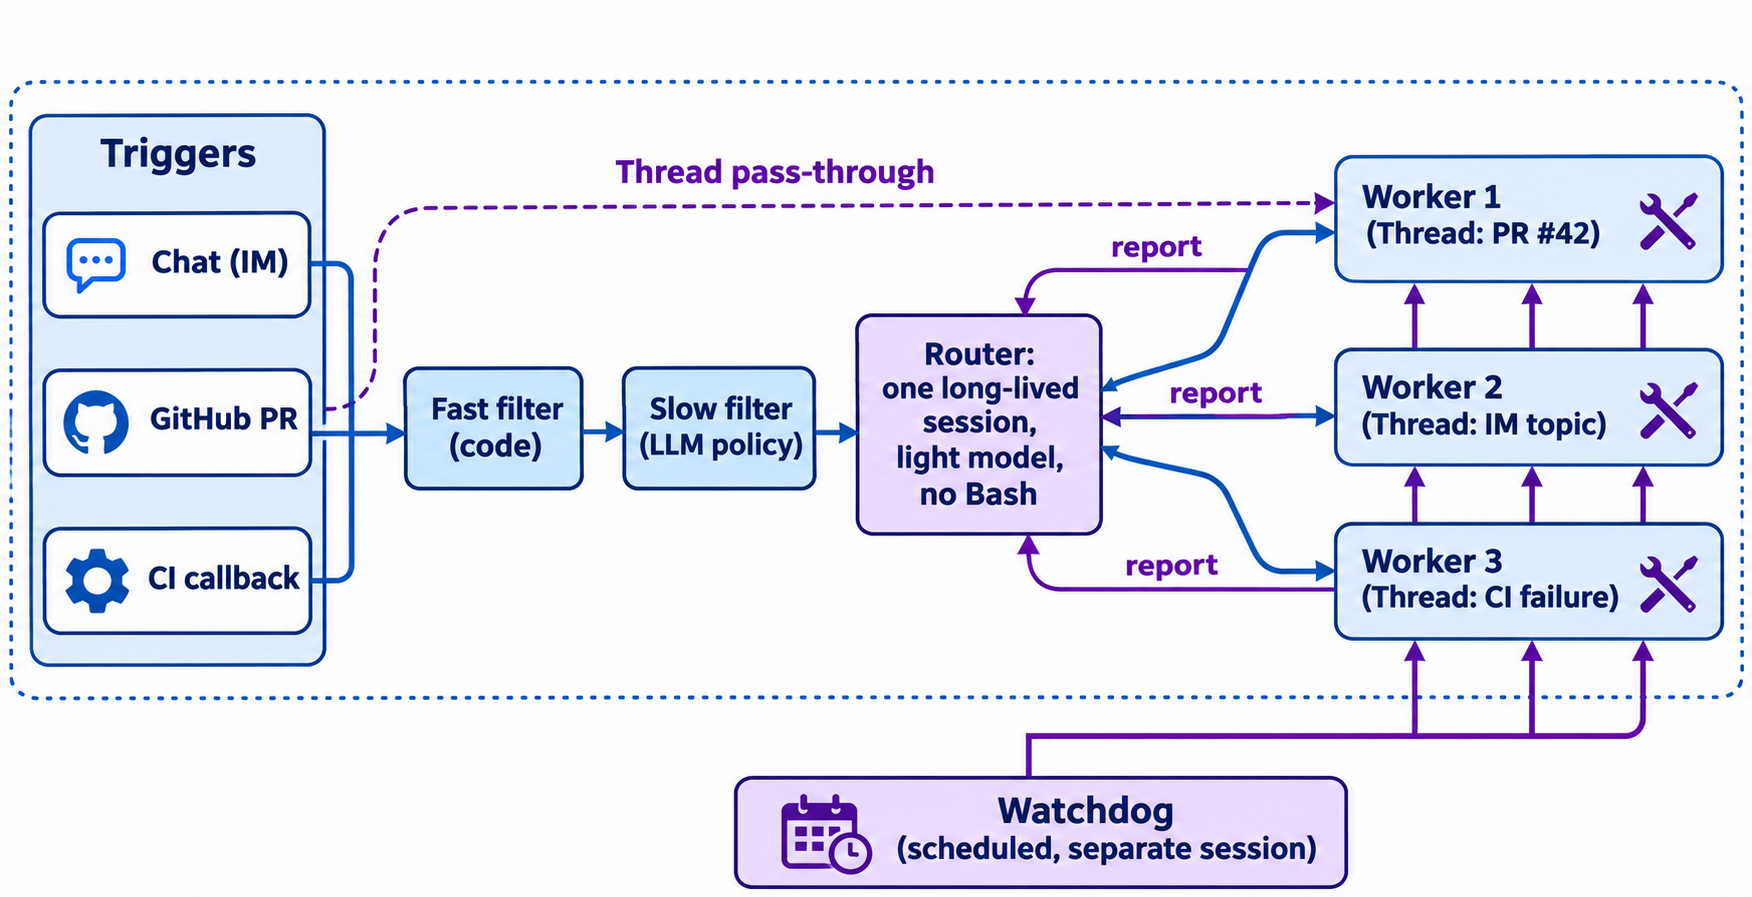
L'essai détaille cinq modules fondamentaux. Voici leur rôle ainsi que l'étape à laquelle vous les implémenterez :
| Module | Rôle | Étape de conception |
|---|---|---|
| Architecture à deux niveaux | Le Router répartit les tâches, les Workers les exécutent | 1 |
| Triggers orientés événements | Transforme les événements de chat, GitHub et CI en entrées pour l'agent | 2 |
| Full-duplex et multicanal | Outils asynchrones, réponses adaptées au canal | 4 |
| Séparation calcul, état et environnement | Boucle sans état (stateless), état persisté en base de données, machines inchangées | 5 |
| Watchdog | Session distincte qui surveille la progression et les erreurs | 6 |
Étape 1 : Séparer le Router des Workers
Le Router est une session persistante et unique. Il gère l'ensemble des interactions humaines ainsi que l'attribution des tâches, sans jamais exécuter de travail lui-même. Il peut fonctionner sans outil Bash, et un modèle plus léger et économique est amplement suffisant. Lorsque plusieurs Triggers surviennent au cours d'un même cycle du Router, ils sont regroupés par lots pour l'appel suivant : une entrée longue, une sortie courte, combinées lors du pré-remplissage (prefill).
Chaque Worker constitue une session isolée dédiée à une tâche précise. Il dispose d'un outillage complet et du modèle le plus performant dont vous disposez. Il ne communique jamais directement avec les humains, mais rend compte au Router. Un Worker peut lui-même faire appel à des sous-agents ou représenter une équipe complète d'agents.
Ne confondez pas ce fonctionnement avec celui d'une équipe d'agents classique. Un chef d'équipe décompose une tâche complexe unique et interdépendante ; le Router, quant à lui, se contente de ventiler des tâches indépendantes. Il est d'ailleurs tout à fait possible de combiner les deux approches.
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
Étape 2 : Convertir les événements en Triggers
Chaque entrée transmise à un super-agent constitue un Trigger : un message de chat, un événement de webhook GitHub, un payload de l'API Slack Events ou un callback de CI. La plupart de ces événements ne devraient même pas atteindre le modèle : l'essai propose donc un filtrage en deux étapes.
- Le chemin rapide, par le code. Filtrez selon la source, le groupe et des listes d'autorisation d'utilisateurs ou de bots. Chaque source se voit attribuer un mode : « répondre uniquement aux requêtes explicites », « candidat » ou « ignorer ».
- Le chemin lent, via un LLM. Les événements candidats sont soumis à un modèle qui applique des règles formulées sous forme de prompts, par exemple « répondre dès qu'un bug est signalé dans ce canal ».
Votre point de terminaison d'ingestion doit accuser réception rapidement et traiter la demande de manière asynchrone. Les bonnes pratiques relatives aux webhooks de GitHub exigent une réponse 2XX en moins de 10 secondes, ce qu'un appel de modèle ne peut garantir. Renvoyez un code 202 Accepted, placez le Trigger en file d'attente et laissez le Router le traiter. Notre guide sur la conception de webhooks fiables aborde la gestion des nouvelles tentatives et l'idempotence pour cette couche.
Étape 3 : Acheminer les messages de suivi par Thread
Un Thread correspond à une suite continue d'événements liés à une même PR, un sujet de messagerie instantanée ou un fil de discussion d'e-mails. Le Worker instancié lors du premier événement d'un Thread s'abonne à celui-ci. Les événements suivants sont ensuite directement transmis à ce Worker, sans solliciter à nouveau le Router.
Cette association fonctionne selon une relation plusieurs-à-plusieurs (many-to-many). Si deux Workers interviennent sur la même PR, tous deux en reçoivent les événements et peuvent résoudre les conflits directement au sein de la PR, sans avoir à échanger de messages entre eux.
Faire l'impasse sur cette étape a un coût immédiat : lors des expérimentations présentées dans l'essai, la suppression de ce mécanisme de pass-through a contraint le Router à prendre environ 30 % de décisions supplémentaires et a entraîné une hausse de la consommation de tokens d'environ 37 %.
Étape 4 : Gérer le contexte comme un cache et rendre les outils asynchrones
Le Router ne pouvant pas tout conserver en mémoire, l'essai propose d'aborder le contexte comme un cache :
- Intégrez en ligne (inline) les éléments probablement indispensables : identifiants, résumés concis, messages adjacents.
- Délestez (spill) le reste : tronquez l'information et conservez une référence que l'agent pourra consulter au besoin.
L'attribution d'identifiants stables aux Triggers, Threads et Workers forme un graphe de référence que les auteurs qualifient de « Chain of Recall » (chaîne de rappel). L'agent navigue ainsi d'un Trigger à son Thread, puis au Worker responsable de son traitement, bénéficiant d'un rappel contextuel à plusieurs sauts sans saturer le prompt.
Passez ensuite au mode full-duplex. Remplacez l'outil bloquant run() par des opérations asynchrones start() et stop(). La commande start() renvoie immédiatement le statut « Started », et le résultat est transmis ultérieurement sous la forme d'un nouvel événement. C'est précisément ce mécanisme qui permet à l'agent de prendre en charge votre consigne suivante pendant que la précédente s'exécute encore. Selon l'essai, DeepSeek Harness intègre cette fonctionnalité, mais ne l'active pas par défaut.
Enfin, concevez des réponses adaptées au canal de diffusion. La règle validée lors des tests limite les réponses sur messagerie instantanée à 100 mots, tandis que GitHub, les e-mails et la documentation bénéficient de synthèses denses et structurées.
Cette approche autorise également l'exécution spéculative : au sein de leur groupe d'utilisateurs, une politique de type « reproduire et corriger en silence » ne propose que des correctifs simples et validés, restant silencieuse dans les autres cas.
Étape 5 : Dissocier le calcul, l'état et les environnements
Exécutez la boucle de l'agent dans des conteneurs cloud sans état (stateless) et enregistrez l'état de session dans une base de données. Les environnements d'exécution, eux, demeurent sur leurs hôtes respectifs : chaque machine héberge un démon léger, un principe baptisé BYOM (Bring Your Own Machine) dans l'essai. Si une boucle s'interrompt, elle peut redémarrer n'importe où et recharger son état, tandis que les dépôts de code restent bien ancrés sur leurs machines d'origine.
L'essai fait référence à l'article d'Anthropic « Scaling Managed Agents: Decoupling the brain from the hands », qui repose sur le même concept mais cible des bacs à sable (sandboxes) managés plutôt que vos propres machines.
Étape 6 : Ajouter un Watchdog
Le Watchdog est une session indépendante exécutée de manière planifiée, en dehors du système principal. Il prend en charge les erreurs d'API et interroge un modèle pour vérifier si chaque Worker progresse ou commence à dériver. Les responsables de la maintenance peuvent également l'interroger directement pour comprendre l'origine d'un échec. Maintenez-le strictement hors du processus du Router, afin qu'un blocage de ce dernier n'entraîne pas l'arrêt de son propre système de surveillance.
Les enseignements des expérimentations
Les auteurs ont soumis environ 300 messages de chat et de CI représentant une vingtaine de demandes de travail, ont simulé l'activité de programmation à l'aide d'un minuteur et ont exécuté chaque configuration à 5 reprises. Ils précisent que ces résultats sont « purement indicatifs ».
| Configuration | p50 (min) | p95 (min) | Tokens de lecture en cache par exécution |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| Sans pass-through de Thread | 12.6 | 15.5 | 31.8M |
| Session unique + outil sous-agent, prompt neutre | 20.4 | 29.5 | 6.1M |
| Session unique, prompt orienté délégation | 13.8 | 29.0 | 10.8M |
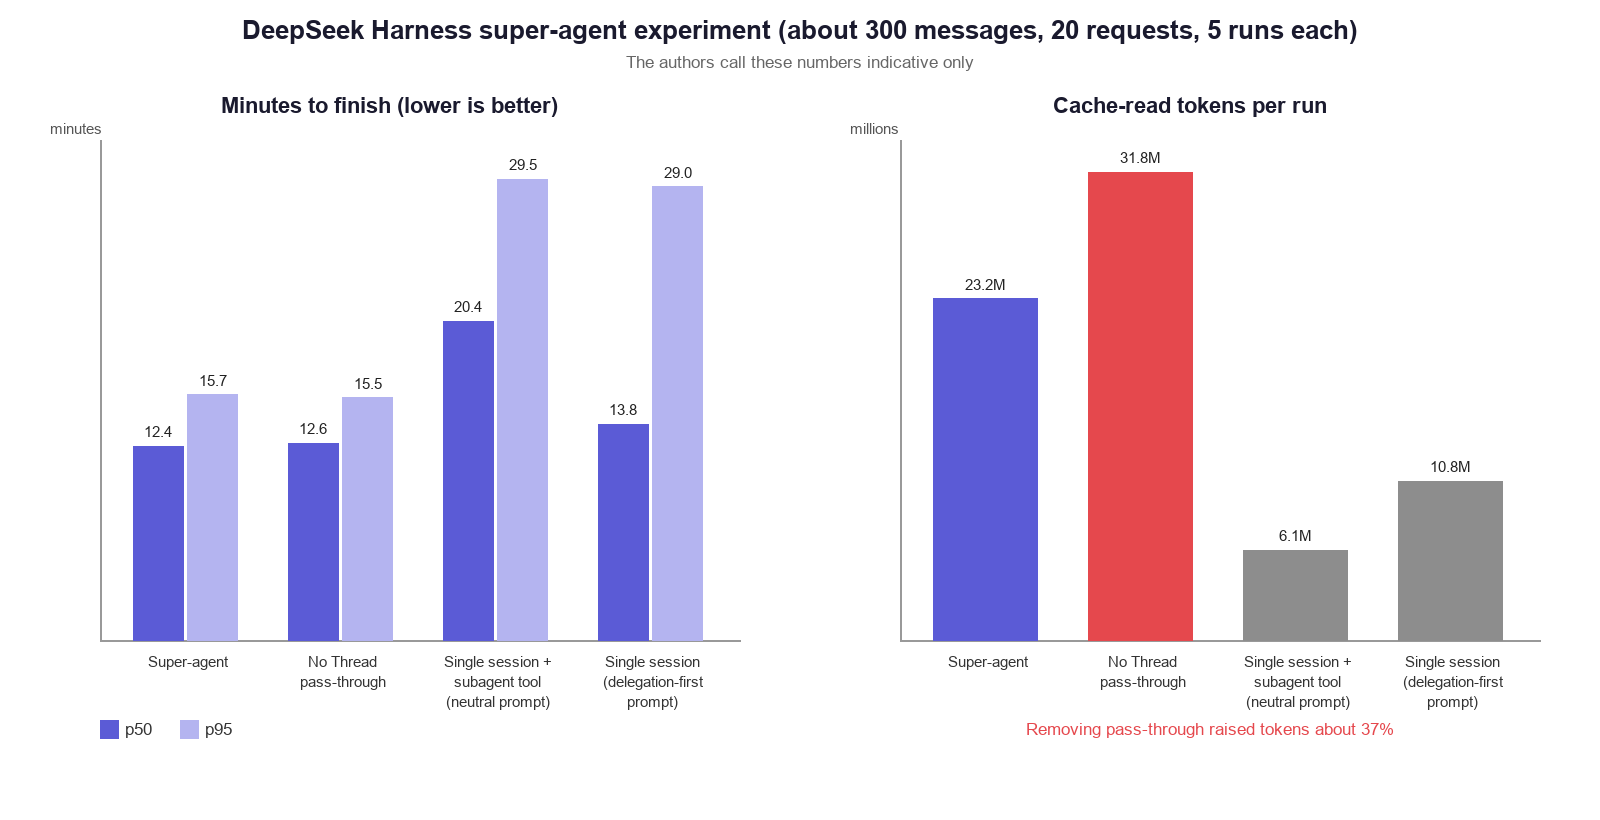
Deux constats majeurs se dégagent. Avec un prompt neutre, la session unique n'a jamais délégué au cours des 5 exécutions, ce qui s'est traduit par un p95 presque deux fois plus élevé que celui du super-agent. Un prompt favorisant la délégation a permis d'améliorer la médiane, mais pas la traîne (p95). Le super-agent consomme davantage de tokens qu'une session unique : vous échangez ainsi des tokens contre des gains de latence et une charge mentale humaine allégée.
Un second test a porté sur la montée en charge du Router seul. Alors que le volume de Triggers passait de 1 à 40 par minute, la taille des lots a augmenté de 1,0 à 2,8 et le temps par requête est passé de 2,5 s à 3,9 s, tandis que le temps par décision a chuté de 6,4 s à 1,6 s. C'est précisément ce regroupement par lots qui évite qu'un Router unique ne se transforme prématurément en goulet d'étranglement.
Tester l'ingestion des Triggers avec Apidog CLI
Tout Trigger prend vie sous la forme d'une requête HTTP atteignant votre point de terminaison d'ingestion ; tester cet endpoint est donc votre priorité absolue. S'il ignore un commentaire de PR ou attribue un nouvel identifiant thread_id à chaque événement, le routage par Thread échoue et chaque message de suivi repasse inutilement par le Router. Laissez votre agent de développement rédiger et exécuter ce test à l'aide d'Apidog CLI.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Transmettez ensuite ce simple prompt à votre agent :
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
L'agent consulte le schéma de chaque payload, valide son JSON, génère le point de terminaison et le scénario de test, puis lance l'exécution :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
Ce même appel apidog run avec l'option -r junit s'intègre directement dans votre pipeline CI/CD ; consultez notre article sur Apidog CLI en CI/CD. Si votre agent repose directement sur DeepSeek Harness, suivez ce guide d'installation ; pour Claude Code, reportez-vous à celui-ci. L'offre gratuite d'Apidog prend en charge jusqu'à 4 utilisateurs.
Défis en suspens
L'essai dresse également la liste des problématiques qui restent à résoudre :
- La mise à l'échelle du Router et le choix de la topologie des Workers lorsque la charge s'intensifie.
- La mémoire à long terme au-delà de la Chain of Recall.
- L'expérience utilisateur sans sessions : piloter un agent en l'absence d'une fenêtre de chat centralisée.
- La délimitation des contextes et les protocoles inter-agents, domaine pour lequel A2A constitue un candidat prometteur.
- La sécurité. Une injection de prompt atteignant la boucle cloud pourrait se propager à toutes les machines connectées, sans compter le risque de fuite d'identifiants présents dans le contexte. Les auteurs préconisent que les agents puissent utiliser des secrets d'authentification sans jamais y avoir un accès direct.
FAQ
Le super-agent est-il une fonctionnalité de DeepSeek Harness que je peux activer dès maintenant ? Non. Cet article expose une architecture théorique. Certaines parties existent dans le plugin prototype dsh-superagent-prototype, qui n'est pas un produit officiel de DeepSeek selon ses auteurs. Les outils full-duplex sont implémentés mais désactivés par défaut.
Pourquoi le Router utilise-t-il un modèle plus léger ? Son rôle se limite à répartir les tâches et à communiquer avec les utilisateurs ; il n'exécute aucune tâche technique et n'a pas besoin de Bash. Les Workers se chargent quant à eux des raisonnements complexes à l'aide du modèle le plus puissant.
En quoi un super-agent diffère-t-il d'une équipe d'agents ? Le coordinateur d'une équipe découpe une tâche complexe unique en plusieurs sous-parties interdépendantes. Le Router, lui, distribue des tâches autonomes et indépendantes. Un Worker peut d'ailleurs tout à fait piloter sa propre équipe d'agents au sein du super-agent.
Qu'est-ce que le pass-through de Thread ? Les événements de suivi sur une PR, un sujet de messagerie instantanée ou un fil d'e-mails sont transmis directement au Worker responsable de ce Thread, en pass... [truncated 795 chars]