
Groq donne à chaque compte une clé Free Plan pour son point de terminaison compatible OpenAI, et cette clé fonctionne dès l’inscription. Ce qui pose problème, ce n’est pas d’obtenir l’accès, mais de rester dans les limites une fois que votre application appelle réellement le modèle. Groq publie des chiffres Free Plan par modèle dans sa documentation, mais ces chiffres évoluent et votre propre compte peut différer. L’habitude fiable consiste à vérifier les paramètres de votre compte, puis à lire les en-têtes de réponse à chaque appel, car les limites peuvent changer en cours de session.
Ce guide couvre l’obtention d’une clé, la configuration d’un client OpenAI standard vers le point de terminaison de Groq, et la partie que la plupart des articles sur le « free tier » oublient : surveiller vos limites en temps réel au lieu de les découvrir via un 429 en production. Ensuite, votre agent de codage transforme cette vérification en un test CLI Apidog, afin qu’il soit reproductible, et non une commande curl ponctuelle que vous oubliez.
TL;DR
Groq propose deux niveaux : Free Plan et Developer Plan. Les limites de débit s’appliquent au niveau de l’organisation (pas par utilisateur) ; vous atteignez le premier plafond parmi les requêtes, les jetons ou les totaux journaliers, et les jetons mis en cache ne sont pas comptés contre vous. Groq publie des chiffres Free Plan par modèle, mais les chiffres qui s’appliquent à votre compte se trouvent sur la page des limites de votre console, donc la démarche fiable est de les lire à partir des en-têtes de réponse x-ratelimit-* à chaque appel plutôt que de faire confiance à un tableau qui peut changer sans préavis.
Obtenir une clé et appeler le point de terminaison
Créez un compte sur console.groq.com et générez une clé depuis la page des clés. Groq expose cette clé via une API compatible OpenAI, donc si vous avez déjà appelé le SDK d’OpenAI, vous connaissez déjà la forme. Pointez l’URL de base vers Groq au lieu d’OpenAI et gardez tout le reste identique :
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
Ou avec le client Python officiel OpenAI :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
La documentation de compatibilité OpenAI de Groq signale quelques lacunes à connaître avant de copier du code existant : logprobs, logit_bias, top_logprobs et messages[].name renvoient tous une erreur 400, n doit être égal à 1 si vous le définissez, et une température de 0 est convertie en un petit flottant positif au lieu d’un vrai décodage glouton.
Free Plan vs Developer Plan
Les termes de Groq sont directs : « Passez au plan Developer pour accéder à des limites plus élevées, au traitement Batch et Flex, et plus encore. » Le Free Plan est celui sur lequel chaque nouvelle clé démarre, et il est réellement utilisable pour les tests et les petits projets personnels.
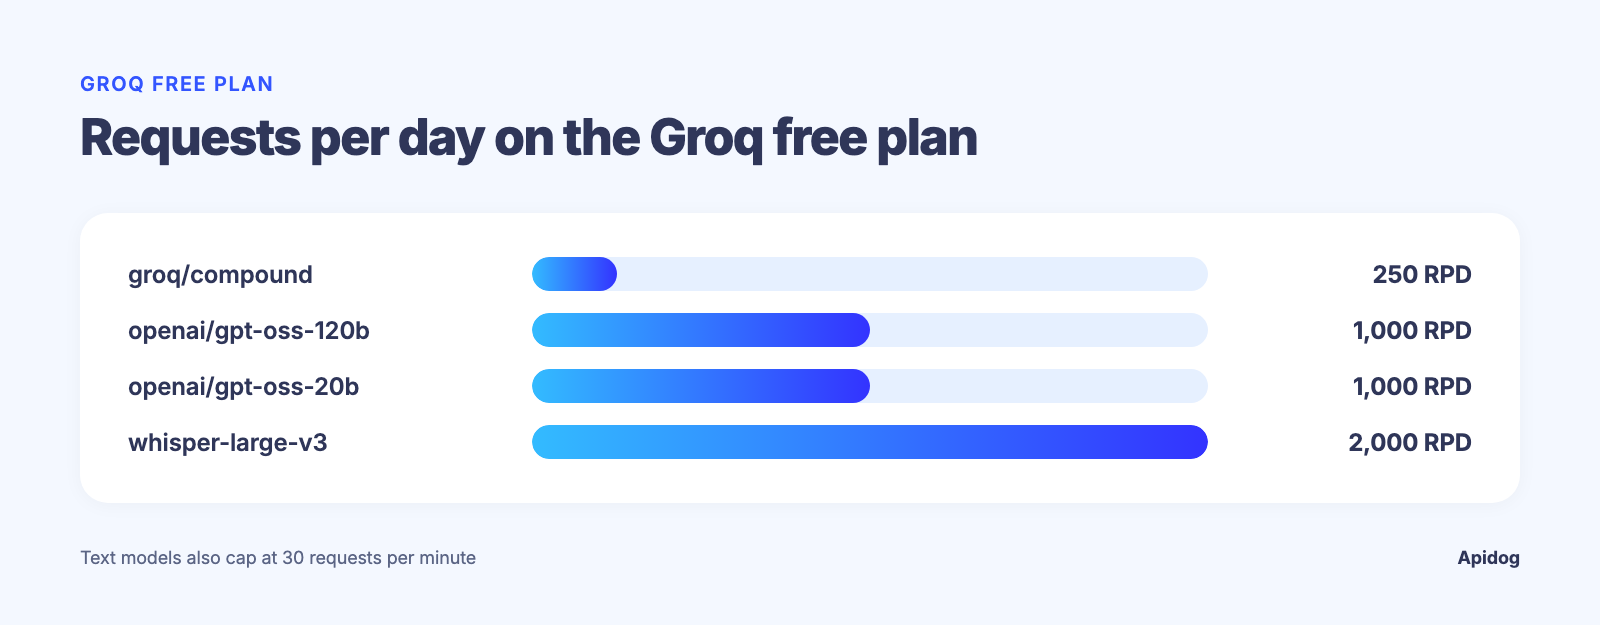
Voici ce que le Free Plan autorise pour quelques modèles, d’après la documentation sur les limites de débit de Groq consultée le 2026-09-15 :
| Modèle | RPM | RPD | TPM | TPD | Audio |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
Cette même page comporte un onglet Developer Plan avec des plafonds plus élevés pour chaque modèle, ainsi que le traitement Batch et Flex. Considérez le tableau ci-dessus comme un instantané, car Groq peut modifier ces chiffres sans préavis. Vos propres chiffres se trouvent sur la page des limites dans les paramètres de votre compte : faites davantage confiance à cette page qu’à celle-ci en cas de désaccord.
Deux détails de politique comptent plus que les chiffres bruts. Les limites de débit s’appliquent « au niveau de l’organisation, pas des utilisateurs individuels », donc cinq personnes partageant une même organisation Groq partagent une seule limite, et non cinq limites distinctes. Et « les jetons mis en cache ne sont pas comptés dans vos limites de débit », ce qui signifie qu’une structure d’invite bien mise en cache vous offre un débit réel supérieur à ce que suggère le chiffre affiché.
Modèles à connaître avant d’atteindre une limite
La limite qui compte dépend du modèle que vous appelez. Les modèles de texte et les systèmes Compound de Groq fonctionnent avec un contexte de 131 072 jetons :
| ID du modèle | Type |
|---|---|
llama-3.1-8b-instant |
Texte généraliste rapide |
llama-3.3-70b-versatile |
Texte généraliste plus grand |
openai/gpt-oss-120b |
Modèle de raisonnement à poids ouverts |
openai/gpt-oss-20b |
Modèle de raisonnement à poids ouverts plus petit |
groq/compound |
Système agentique |
groq/compound-mini |
Système agentique plus léger |
Les modèles Whisper, whisper-large-v3 et whisper-large-v3-turbo, ne rentrent pas dans ce tableau. Ce sont des modèles de transcription audio, et Groq mesure leur débit en secondes audio par heure et par jour (ASH/ASD), parallèlement à leurs propres plafonds RPM et RPD, et non en jetons.
Chaque modèle a ses propres plafonds RPM, RPD et de jetons, donc ne supposez pas que les limites de llama-3.1-8b-instant s’appliquent à openai/gpt-oss-120b.
Lisez les en-têtes de limite de débit au lieu de deviner
Chaque réponse de api.groq.com comporte un ensemble d’en-têtes qui vous indiquent exactement où vous en êtes, sans avoir besoin de consulter la console :
x-ratelimit-limit-requestsetx-ratelimit-limit-tokens, votre plafond pour la fenêtre actuellex-ratelimit-remaining-requestsetx-ratelimit-remaining-tokens, ce qu’il reste à l’instantx-ratelimit-reset-requestsetx-ratelimit-reset-tokens, quand la fenêtre se réinitialiseretry-after, envoyé lors d’un 429, vous indiquant combien de temps attendre
Lisez x-ratelimit-remaining-tokens après chaque appel et vous disposez d’une jauge en direct, et non d’un nombre statique que vous avez consulté une fois et oublié de revérifier. Voici une vérification rapide avec cURL, qui n’affiche que les en-têtes :
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
Exécutez cela plusieurs fois en boucle contre un script de test bavard et vous verrez x-ratelimit-remaining-tokens diminuer. Si votre application a besoin d’une logique de backoff, consultez notre guide sur comment implémenter la limitation de débit d’API pour des schémas qui respectent un en-tête retry-after au lieu de deviner un délai.
Laissez votre agent de codage exécuter la vérification avec Apidog CLI
Faire la danse curl-et-grep à la main fonctionne pour une session de débogage. Cela ne passe pas à l’échelle d’une équipe, et personne ne relance une commande shell ponctuelle avant chaque déploiement. Confiez plutôt la vérification à votre agent de codage : avec Apidog CLI, il écrit le test une fois et l’exécute chaque fois que vous le demandez. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Le jeton provient d’Apidog, sous Account Settings, API Access Token. Ensuite, donnez à l’agent une consigne :
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
Les commandes qu’il exécute, vérifiées avec Apidog CLI 2.2.7 :
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
Un budget qui diminue apparaît désormais comme un test échoué au lieu d’un 429 surprise pendant une démo. Placez cette dernière ligne dans votre job CI de pré-déploiement, comme dans notre guide sur le pipeline CI/CD avec Apidog CLI, ou demandez à l’agent un apidog scheduled-task create, qui exécute la suite sur un runner selon un cron. Cela importe d’autant plus, compte tenu de la mutualisation au niveau de l’organisation de Groq : un collègue exécutant un job par lots peut consommer le budget partagé dont votre point de terminaison de production aura besoin une heure plus tard. C’est la même idée que dans notre article sur tester les limites de débit d’une API GPT.
Que faire lorsque vous atteignez réellement la limite
Lorsqu’un 429 revient, respectez retry-after plutôt que de réessayer immédiatement. Une boucle de nouvelle tentative serrée contre une limite au niveau des requêtes ne fait que consommer votre budget restant plus vite et repousser davantage la fenêtre de réinitialisation. Si vous intégrez cela dans un service de production plutôt que dans un script de test, notre guide complet de l’erreur de limite de débit dépassée présente des stratégies de backoff qui fonctionnent chez différents fournisseurs, pas seulement Groq.
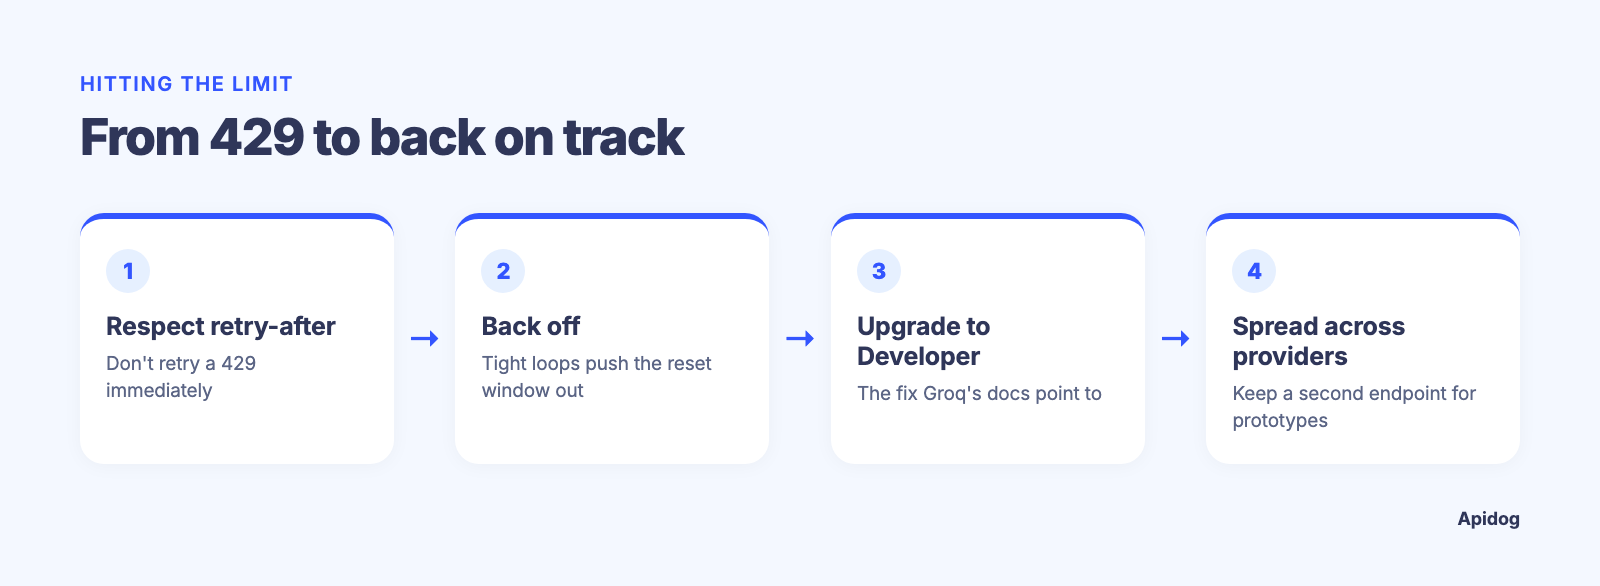
Si vous atteignez systématiquement le plafond du Free Plan, la solution la plus rapide est le passage au Developer Plan vers lequel Groq renvoie directement dans sa documentation. La deuxième solution la plus rapide, surtout pour un prototype, consiste à répartir le trafic entre plusieurs fournisseurs. Notre sélection d’alternatives à OpenRouter couvre d’autres points de terminaison utiles à garder sous la main pour exactement cette situation.
FAQ
Groq propose-t-il un niveau gratuit pour son API ? Oui. Chaque nouveau compte démarre sur le Free Plan avec accès au point de terminaison compatible OpenAI. Groq publie des exemples de limites du Free Plan pour plusieurs modèles, mais les plafonds qui s’appliquent réellement à votre compte se trouvent sur la page des limites dans les paramètres de votre console.
Comment vérifier ma limite de débit Groq actuelle ? Deux façons : ouvrez la page des limites dans les paramètres de votre compte, ou lisez les en-têtes x-ratelimit-limit-requests et x-ratelimit-limit-tokens sur n’importe quelle réponse d’API. Les en-têtes reflètent la limite réelle de votre compte au moment de votre appel, ce qui est plus fiable qu’un nombre que vous avez vu une fois et mémorisé.
Que se passe-t-il lorsque je dépasse la limite de débit de Groq ? Vous recevez une réponse 429 avec un en-tête retry-after indiquant combien de secondes attendre. Consultez notre guide sur la limite de débit dépassée pour gérer cela dans le code au lieu de deviner un délai.
Les jetons mis en cache sont-ils comptés dans ma limite de débit Groq ? Non. Groq indique directement que les jetons mis en cache ne sont pas comptés dans vos limites de débit, donc une structure d’invite qui réutilise un message système mis en cache obtient un débit réel supérieur à ce qu’implique la limite brute de jetons.
La limite de débit de Groq est-elle par utilisateur ou par organisation ? Par organisation. Chaque clé sous la même organisation Groq partage un seul pool de requêtes et de jetons, donc le script d’un collègue peut empiéter sur le budget dont votre application de production a besoin.
Quels modèles Groq ont la plus grande fenêtre de contexte ? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b et les systèmes Compound fonctionnent tous avec 131 072 jetons de contexte. Les modèles Whisper sont des modèles de transcription audio, pas de texte, donc Groq mesure leurs limites en durée audio à la place. Les limites de débit diffèrent d’un modèle à l’autre, même au sein de la même fenêtre de contexte, donc vérifiez chacun séparément.
Où cela vous mène
La façon gratuite d’utiliser l’API Groq n’est pas un nombre secret, c’est une habitude. Obtenez une clé, pointez le point de terminaison compatible OpenAI vers celle-ci, et lisez les en-têtes de réponse à chaque appel au lieu de faire confiance à un chiffre trouvé dans un article de blog, celui-ci inclus.
Demandez à votre agent de codage de créer cette vérification une fois avec Apidog CLI, avec une assertion sur les jetons restants pour chaque modèle, et elle s’exécutera à chaque déploiement par la suite. La configuration prend moins de temps que la lecture du reste de la documentation de Groq. Pour une couverture plus approfondie des tests d’une couche d’API d’IA sous charge, notre guide sur les meilleurs outils de test d’API pour les agents IA constitue une bonne prochaine étape.