
Grok 4.6 a été lancé le 12 août avec une affirmation qui redéfinit la décision concernant les modèles de pointe : une intelligence qui égale GPT-5.6 Sol sur l'Indice d'Analyse Artificielle, à 6 $ par million de jetons de sortie au lieu de 30 $. La plupart des articles comparatifs que vous trouverez utilisent encore Grok 4.5 comme référence, lequel était tellement en retard par rapport aux modèles de pointe que le prix n'avait pas d'importance. Ce n'est plus le cas, cette comparaison débute donc avec les chiffres de la version 4.6.
La réponse courte : GPT-5.6 Sol reste le meilleur choix pour les agents de codage à l'échelle d'un dépôt, Claude Fable 5 domine de peu le travail autonome à long terme, et Grok 4.6 est désormais le choix le plus avantageux, dont les capacités sont suffisamment proches pour obliger les deux autres à justifier leur prix. Le bon choix dépend de votre charge de travail, vous trouverez ci-dessous les chiffres, les considérations liées à l'API, et une méthode reproductible pour tester les trois sur votre propre environnement. Si vous souhaitez effectuer ce test dès aujourd'hui, Apidog vous permet d'interroger les trois API côte à côte depuis un seul espace de travail, gratuitement.
En bref
- Indice d'Intelligence : Claude Fable 5 en tête à 62 ; Grok 4.6 et GPT-5.6 Sol à égalité à 61.
- Tarification (sortie, par 1 million de jetons) : Grok 4.6 à 6 $, Claude Opus 4.8 à 25 $, GPT-5.6 Sol à 30 $, soit un écart de 5x.
- Contexte : GPT-5.6 Sol 1,05 million de jetons, Claude Fable 5 1 million, Grok 4.6 500K.
- Codage : Sol Max est en tête sur DeepSWE (73,0 % contre 65,9 % pour Grok) ; Fable 5 Max est en tête sur FrontierCode (63,6 % contre 61,3 %).
- Agents : Fable 5 Max est en tête sur APEX-Agents à 59,2 % ; Grok 4.6 (57,5 %) devance Sol Max (56,7 %).
- Coût par tâche accomplie : Grok 4.6 mesuré à 0,84 $ par Artificial Analysis, le plus bas parmi les modèles de pointe.
- Ne décidez pas uniquement sur la base des benchmarks : effectuez un test comparatif de 20 prompts sur votre propre charge de travail (méthode ci-dessous).
Spécifications et tarifs côte à côte
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Développeur | xAI | OpenAI | Anthropic |
| Indice d'Intelligence | 61 | 61 | 62 |
| Fenêtre contextuelle | 500K | 1,05M | 1M |
| Prix entrée / 1M | 2 $ | 12 $ | 10 $ |
| Prix sortie / 1M | 6 $ | 30 $ | 25 $* |
| Variante rapide/premium | 2x prix | Niveau Sol Max | Niveau Fable 5 Max |
| Style d'API | Compatible OpenAI | Natif OpenAI | Messages Anthropic |
| Date limite de connaissance | Fév 2026 |
*La tarification de Claude est celle d'Opus 4.8 ; la tarification du niveau Fable 5 varie selon le paramètre d'effort. Consultez notre guide de tarification GPT-5.6 et notre analyse des réductions de coûts Claude pour les matrices complètes.
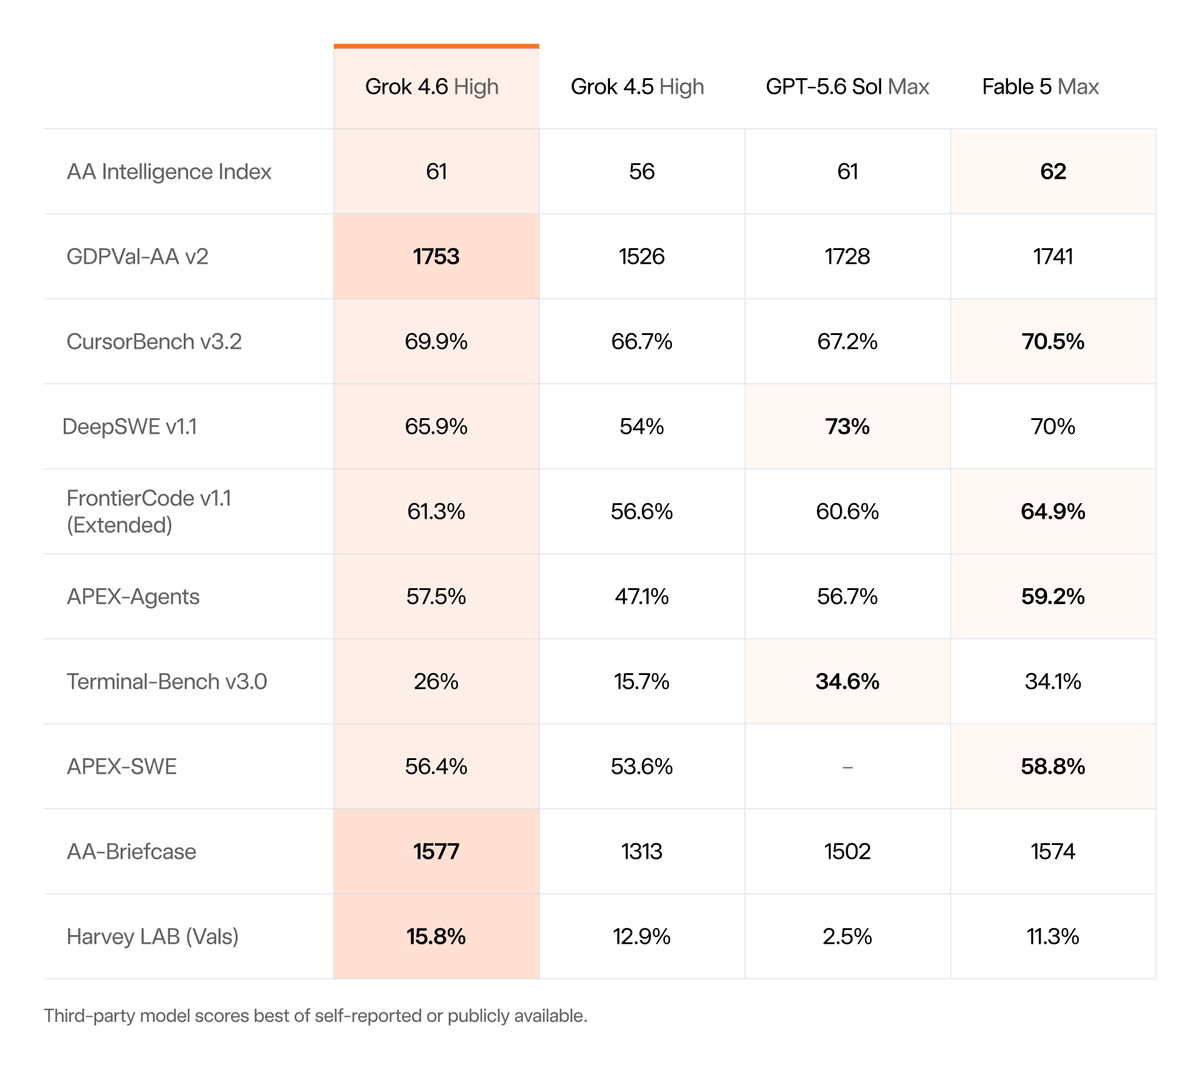
L'asymétrie des prix est la clé. En entrée, Grok facture un sixième de ce qu'OpenAI facture ; en sortie, un cinquième. Pour les charges de travail de chat, c'est intéressant ; pour les charges de travail d'agents, où une seule tâche peut générer des dizaines d'appels de modèle et de longs transcriptions d'utilisation d'outils, cela se transforme en la différence entre un agent à 50 $ par jour et un agent à 250 $ par jour.
Benchmarks de codage : Sol pour la profondeur, Grok pour la valeur
| Benchmark | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (correctifs à l'échelle du dépôt) | 65.9% | 73.0% | |
| FrontierCode v1.1 Étendu | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Lisez-le ainsi :
- L'avance de 7 points de GPT-5.6 Sol Max sur DeepSWE est réelle et importante. La correction de bugs à l'échelle d'un dépôt est le benchmark de codage le plus difficile et le plus économiquement précieux. Si votre agent travaille sur de grandes bases de code existantes avec une supervision minimale, Sol reste le pari le plus sûr. Notre comparaison GPT-5.6 Sol vs Claude Fable 5 couvre ce face-à-face en profondeur.
- Claude Fable 5 gagne en cohérence. Il est en tête de l'indice composite, de FrontierCode et d'APEX-Agents. Rien de « spiky » (irrégulier), il est simplement rarement pire que le deuxième. Ce profil convient au travail autonome à long terme où une mauvaise étape fait dérailler une heure de progression.
- Grok 4.6 n'est jamais loin derrière, et parfois devant. Mener CursorBench et Terminal-Bench tout en restant à portée des autres, pour une fraction du coût, est exactement le profil d'un modèle vers lequel vous dirigez la majeure partie de votre trafic, n'escaladant que les cas difficiles.
Une note d'honnêteté : ce sont des chiffres de semaine de lancement, largement rapportés par les fournisseurs. Les benchmarks de lancement de Grok 4.5 nécessitaient une lecture attentive, et la même prudence s'applique à chaque fournisseur ici.
Coût par tâche, pas coût par jeton
Les prix des jetons sont trompeurs lorsque les modèles diffèrent en verbosité et en taux de réessai. Un modèle bon marché qui échoue une exécution terminale crée un travail de révision et de réparation qui coûte plus cher que les jetons économisés. La meilleure métrique est le coût par tâche accomplie, et ici la mesure indépendante d'Artificial Analysis est frappante : Grok 4.6 a affiché une moyenne de 0,84 $ par tâche sur ses évaluations d'agents, le plus bas parmi les modèles de pointe, aidé par une utilisation relativement disciplinée des jetons plutôt que par de simples prix bas.
Un exemple concret. Supposons que votre agent de codage utilise en moyenne 500K jetons d'entrée et 100K jetons de sortie par tâche accomplie :
| Modèle | Coût entrée | Coût sortie | Par tâche |
|---|---|---|---|
| Grok 4.6 | 1,00 $ | 0,60 $ | 1,60 $ |
| Claude Opus 4.8 | 5,00 $ | 2,50 $ | 7,50 $ |
| GPT-5.6 Sol | 6,00 $ | 3,00 $ | 9,00 $ |
À 1 000 tâches par mois, Grok économise environ 6 000 à 7 400 $ par rapport aux alternatives, si son taux de succès sur votre charge de travail est maintenu. Cette condition est essentielle, c'est pourquoi vous devez tester avant de vous engager.
Ergonomie de l'API : ce que l'intégration vous coûte réellement
- Grok 4.6 est compatible OpenAI. Si vous avez un client de style OpenAI, il suffit de pointer
base_urlvershttps://api.x.ai/v1et vous êtes opérationnel. Il est également disponible sur OpenRouter, Vercel et Cloudflare pour les utilisateurs de passerelles. - GPT-5.6 Sol dispose de l'écosystème le plus riche : l'API de Réponses, l'appel d'outils programmatique et des SDK propriétaires partout. Consultez comment utiliser l'API GPT-5.6 pour la structure des niveaux.
- Claude Fable 5 utilise l'API Messages d'Anthropic, avec une forme de requête différente, une excellente fiabilité d'utilisation des outils, et un paramètre d'effort qui échange le coût contre la capacité au sein d'un même modèle.
La friction de migration est la plus faible entre Grok et OpenAI (format partagé), la plus élevée en passant vers ou depuis Anthropic. Si vous prévoyez de basculer ou de router entre les modèles, cette asymétrie doit être prise en compte dans votre décision d'architecture.
Fenêtres contextuelles : quand 500K suffisent
Sur le papier, la fenêtre de 1,05 million de jetons de GPT-5.6 Sol double celle de 500K de Grok 4.6, avec 1 million pour Claude Fable 5 juste derrière. En pratique, la question est de savoir ce que votre charge de travail contient réellement en contexte.
Une fenêtre de 500K jetons peut contenir environ 350 000 mots : l'intégralité du code d'un service de taille moyenne, un an de transcriptions de support, ou plusieurs centaines de pages de documents juridiques. La plupart des tâches d'agents ne l'atteignent jamais. Les charges de travail qui nécessitent véritablement le niveau d'un million de jetons sont restreintes : l'analyse d'un monorepo complet, des transcriptions d'agents multi-sessions très longues que vous refusez de résumer, et le traitement ponctuel de vastes ensembles de documents.
Deux observations pratiques tempèrent le choix basé uniquement sur la taille de la fenêtre. Premièrement, chaque modèle se dégrade à mesure que le contexte se remplit ; la qualité de récupération à 80 % de capacité est moins bonne qu'à 20 % sur les trois, de sorte que les architectures qui remplissent la fenêtre dépassent rarement les architectures qui récupèrent sélectivement. Deuxièmement, les jetons d'entrée sont là où les budgets s'épuisent : remplir la fenêtre complète de Sol coûte environ 12,60 $ par requête au prix catalogue, tandis que remplir celle de Grok coûte 1 $. Si vos prompts dépassent régulièrement 400K jetons, vous n'avez pas seulement besoin d'une fenêtre plus grande, vous avez besoin d'une stratégie de mise en cache et de récupération, quel que soit le fournisseur que vous choisissez.
Dates limites de connaissance et maturité de l'écosystème
Grok 4.6 est livré avec une date limite de connaissance fixée au 1er février 2026, la plus récente des trois, ce qui est important pour les agents de codage qui se réfèrent à des frameworks en évolution rapide. C'est un avantage réel mais mineur : toute pile d'agents sérieuse se base sur des outils de récupération et de documentation plutôt que de faire confiance à la connaissance paramétrique.
L'écosystème est l'histoire inverse. OpenAI possède la surface d'intégration tierce la plus profonde, Anthropic a la plus forte part de marché dans les frameworks d'agents, et xAI est le nouveau venu qui s'appuie sur la compatibilité OpenAI pour emprunter les deux. Ce pari fonctionne en grande partie : tout ce qui utilise le format de complétion de chat fonctionne avec Grok aujourd'hui, et la disponibilité des passerelles via OpenRouter, Vercel et Cloudflare signifie que vous pouvez l'adopter sans toucher à votre infrastructure. Ce que vous sacrifiez, c'est la finition propriétaire, les API de lot, les niveaux de mise en cache et les contrôles d'utilisation granulaires sont moins matures que ceux des opérateurs historiques.
Quel modèle pour quel travail
- Agent de codage autonome à l'échelle d'un dépôt, qualité avant tout : GPT-5.6 Sol. L'avance sur DeepSWE se traduit par moins d'exécutions interrompues sur de grandes bases de code.
- Travail de connaissance à long terme et sessions d'agents de plusieurs heures : Claude Fable 5. Meilleur score composite, meilleur benchmark d'agent, antécédents les plus solides en matière de stabilité.
- Trafic d'agents à haut volume, produits sensibles aux coûts, ou modèle par défaut d'un routeur : Grok 4.6. Résultats de niveau de pointe à des prix de commodité ; n'escaladez les 10 % de tâches les plus difficiles vers Sol ou Fable.
- Codage interactif dans un IDE : L'avance de Grok 4.6 sur CursorBench, plus sa variante rapide 2x, en fait un concurrent sérieux ; il a été effectivement conçu pour cela après avoir été entraîné sur de véritables sessions Cursor.
Testez les trois sur votre environnement en un après-midi
Les benchmarks prévoient des moyennes, pas votre charge de travail. Voici un test comparatif reproductible utilisant Apidog :
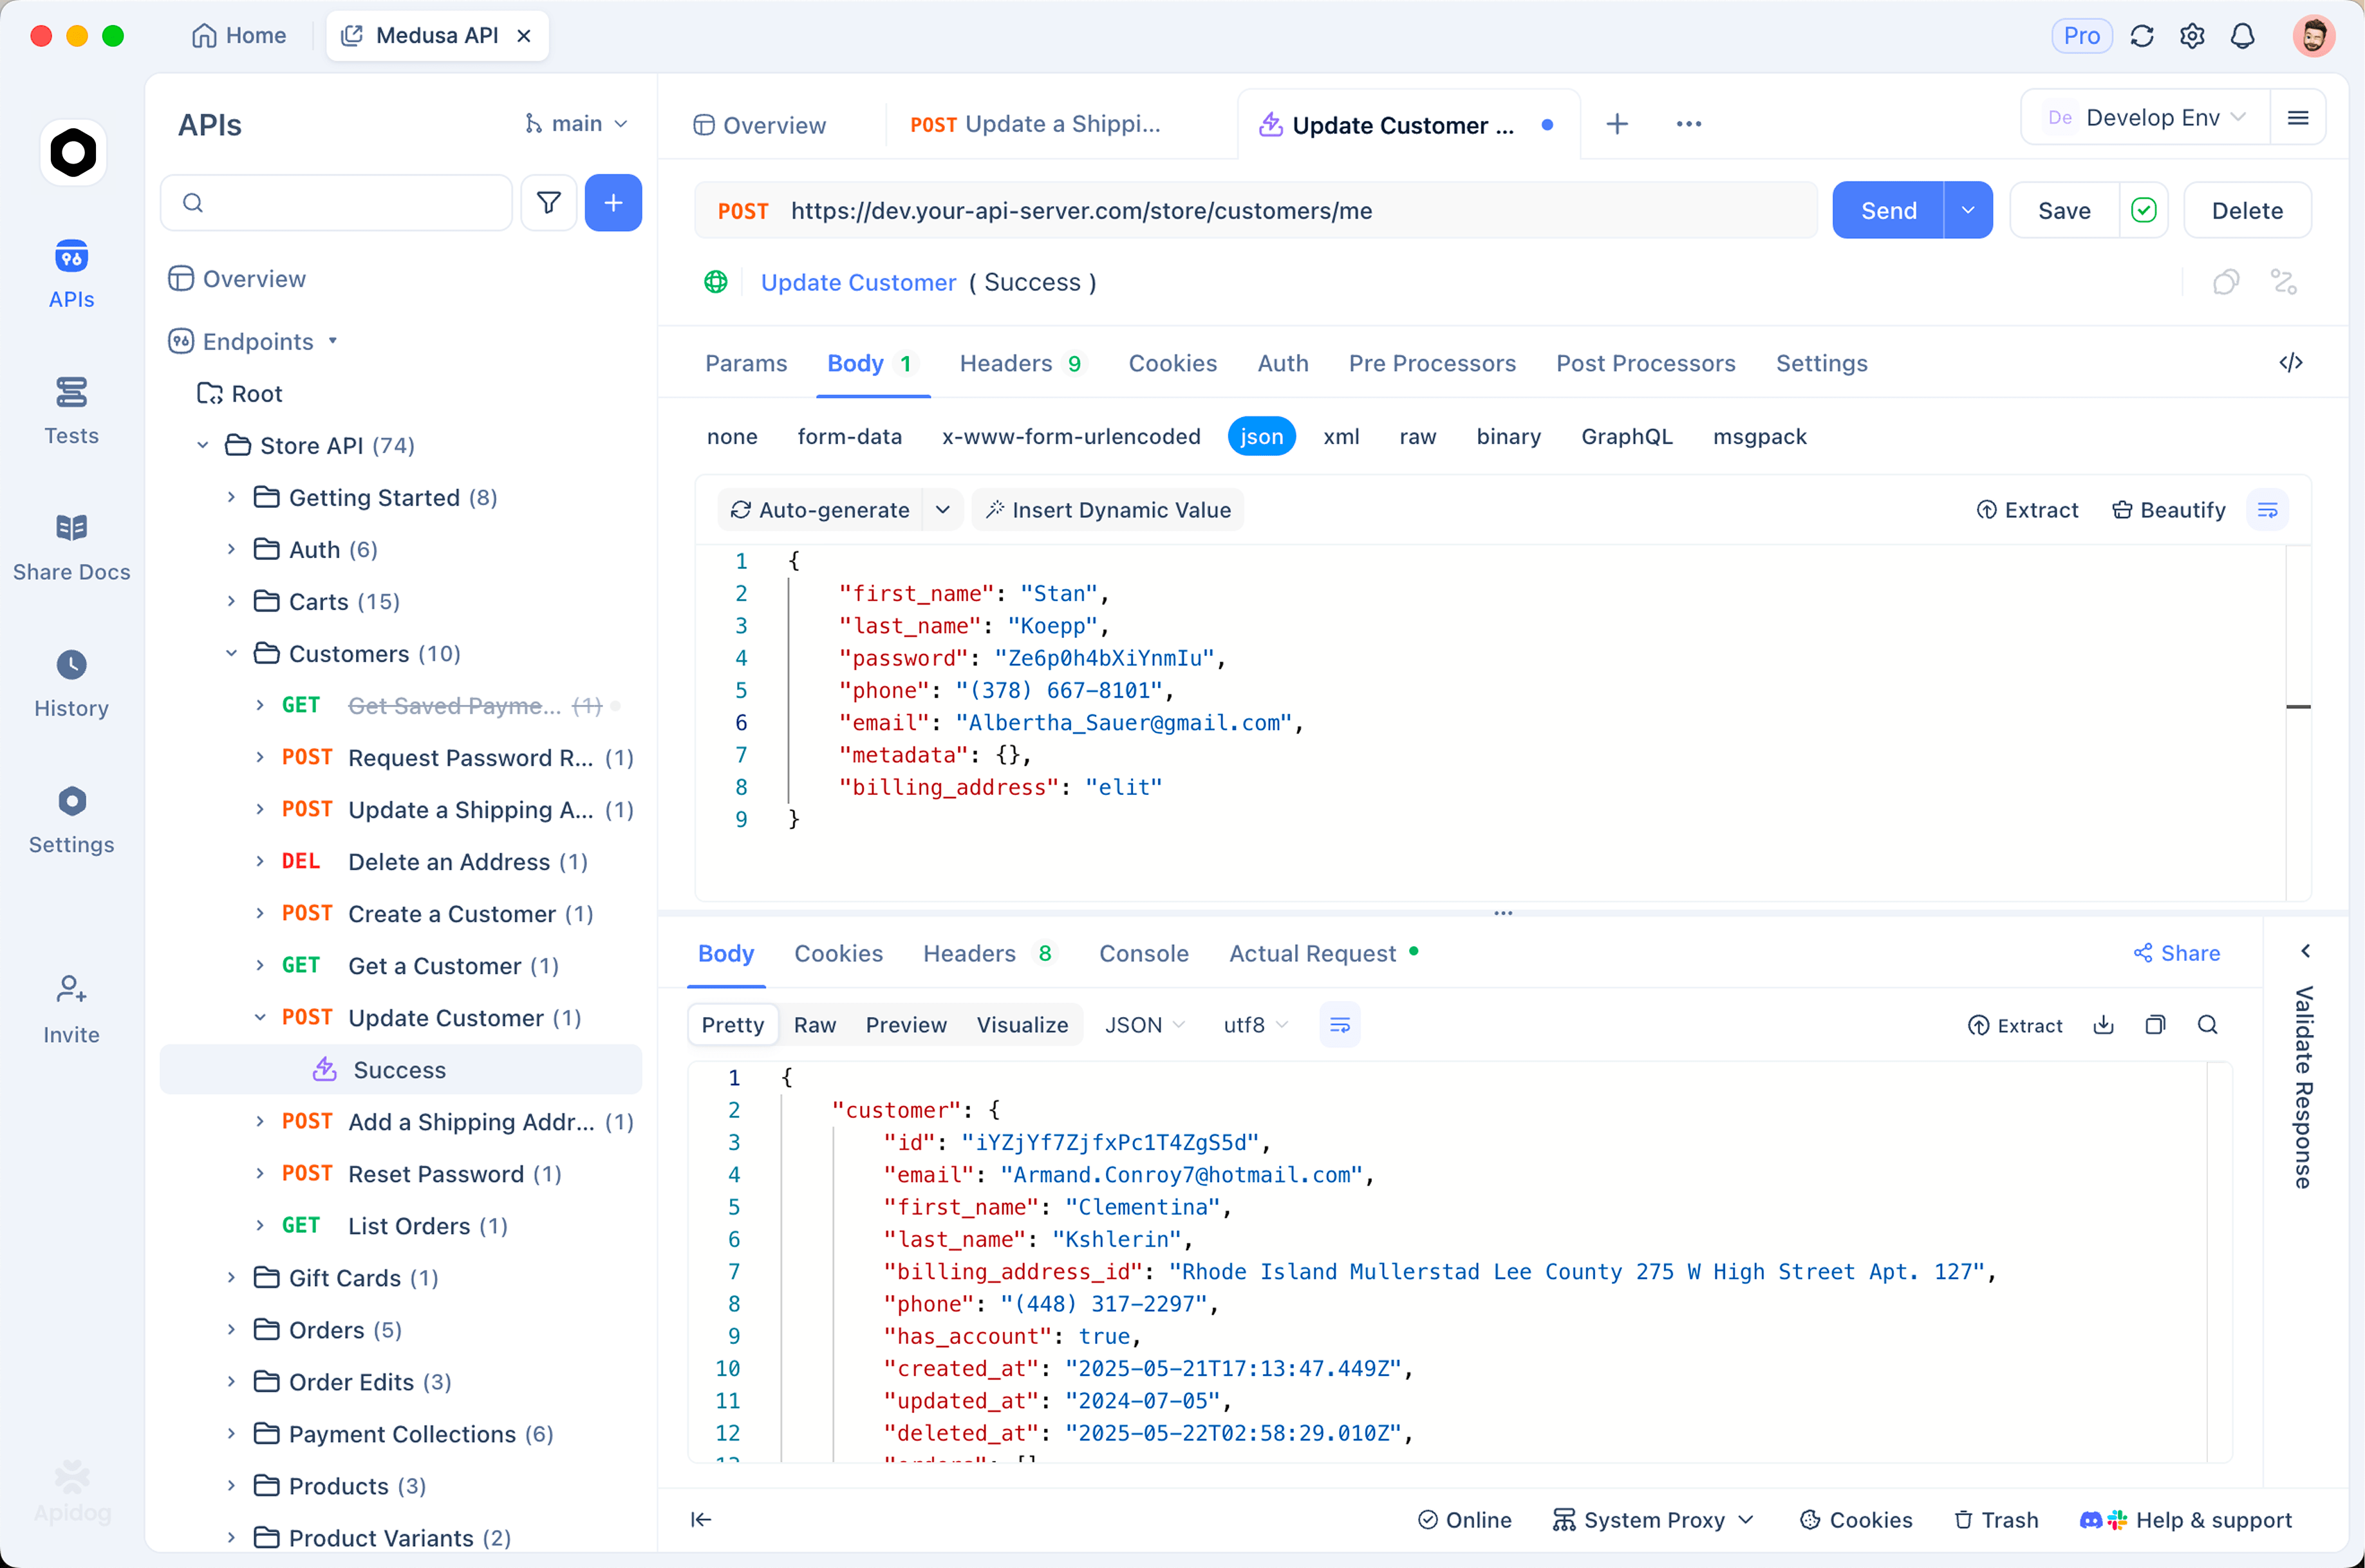
- Un projet, trois environnements. Créez des environnements pour xAI (
api.x.ai/v1), OpenAI et Anthropic, chacun avec sa propre authentification. La même requête permet de changer de fournisseur avec une seule liste déroulante. - Collectez 20 prompts réels. Extrayez des tâches réelles de votre produit, pas des questions triviales. Incluez votre prompt système, vos définitions d'outils si vous utilisez l'appel de fonctions, et au moins cinq cas notoirement difficiles.
- Affirmez ce qui vous importe. Ajoutez des assertions Apidog pour la validité de la réponse, l'utilisation des jetons à partir de l'objet
usage, et les seuils de latence. Pour les charges de travail d'appel d'outils, assurez-vous que le JSON de l'appel d'outil est parsé et correspond à votre schéma, les modèles échouent ici bien plus souvent que dans le texte. - Exécutez-le comme un scénario de test, trois fois par modèle. Les sorties des LLM varient ; trois exécutions révèlent la variance qu'une seule démo cache. Exportez les résultats et comparez le taux de succès et le coût par succès, non le coût par jeton.
- Gardez la suite. Lorsque la prochaine version du modèle sera lancée (au rythme actuel, d'ici quelques mois), relancez-la. Le choix du modèle est désormais une décision trimestrielle, et les équipes disposant d'un dispositif d'évaluation permanent basculent des semaines plus vite que les équipes qui se décident par anecdote.
FAQ
Grok 4.6 est-il meilleur que GPT-5.6 Sol ? Ils sont à égalité sur l'indice composite à 61. Sol domine clairement le codage à l'échelle d'un dépôt (DeepSWE 73,0 % contre 65,9 %) ; Grok est en tête sur CursorBench et Terminal-Bench et coûte 5 fois moins cher en sortie. Le terme « meilleur » dépend de si votre charge de travail ressemble plus à DeepSWE ou à une session IDE.
Grok 4.6 est-il meilleur que Claude Fable 5 ? Fable 5 est en tête sur l'indice (62 contre 61), FrontierCode et APEX-Agents, mais de peu. L'avantage de Grok est le prix. Pour un travail autonome où la précision est critique, Fable 5 ; pour un volume sensible aux coûts, Grok.
Quel modèle d'IA est le moins cher à la pointe en 2026 ? Grok 4.6, à 2 $/6 $ par million de jetons et un coût mesuré indépendamment de 0,84 $ par tâche d'agent. Les jetons de sortie du concurrent de pointe le plus proche coûtent environ 4 fois plus cher.
Dois-je migrer mon agent de production vers Grok 4.6 ? Pas uniquement sur la base des benchmarks. Exécutez d'abord le test comparatif ci-dessus sur votre charge de travail réelle, l'écart de prix de 5x ne sera rentable que si le taux de succès est maintenu sur vos tâches.
Puis-je utiliser les trois modèles derrière un seul format d'API ? En grande partie. Grok 4.6 utilise nativement le format de complétions de chat d'OpenAI, il partage donc le code client avec GPT-5.6. Claude nécessite l'API Messages d'Anthropic, ou une passerelle comme OpenRouter qui normalise les trois derrière une seule interface avec une légère majoration.
La fenêtre contextuelle plus petite de Grok 4.6 est-elle importante ? Pour la plupart des charges de travail d'agents et de chat, non ; 500K jetons sont bien au-dessus de l'utilisation typique, et les trois modèles se dégradent de toute façon près de leurs limites. Cela est important si vous traitez régulièrement des monorepos entiers ou d'énormes ensembles de documents en un seul appel, où la fenêtre de 1,05 million de jetons de Sol offre une réelle marge de manœuvre.