
Le match GPT-Live-1.1 vs GPT-Realtime se résume à une question d'architecture. GPT-Live-1.1 est un frontend vocal full-duplex qui délègue le raisonnement et les outils à un modèle backend distinct et facture 0,05 $ par minute active. GPT-Realtime-2.1 est un modèle speech-to-speech unique qui écoute, raisonne, appelle des outils et parle, facturé au token. Choisissez GPT-Live-1.1 si vous disposez déjà d'un agent texte ; choisissez Realtime si vous voulez qu'un seul modèle fasse tout.
OpenAI a intégré GPT-Live-1.1 à l'API le 20 novembre 2026 : vous disposez donc désormais de deux stacks vocales avec des endpoints, une facturation et des modèles d'outils différents. Notre article de juillet GPT-Live vs GPT-Realtime comparait la fonctionnalité ChatGPT avec l'API ; celui-ci oppose API et API.
GPT-Live-1.1 vs GPT-Realtime en un coup d'œil
Voici comment les deux stacks se comparent, d'après la page du modèle GPT-Live-1.1, la page du modèle gpt-realtime-2.1 et la page de tarification d'OpenAI consultées le 20 novembre 2026 :
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Conception | Voix full-duplex + backend délégué | Un seul modèle de raisonnement speech-to-speech |
| Entrée | Audio, texte | Audio, texte, image |
| Sortie | Audio, texte | Audio, texte |
| Facturation | 0,05 $/min en activité, 0,02 $/min en veille | 32 $ en entrée, 64 $ en sortie par million de tokens audio |
| Raisonnement et outils | Modèle backend, facturé séparément | Au sein du même modèle et du même prix |
| Appel de fonctions | Via la délégation | session.tools |
| Transports | WebRTC, WebSocket, SIP (entrant et sortant) | WebRTC, WebSocket, SIP (entrant) |
| Limites de débit | Sessions simultanées | Requêtes et tokens par minute |
Le guide des agents vocaux d'OpenAI résume cette distinction dans son tableau d'architecture. GPT-Live est destiné aux « conversations full-duplex avec un backend séparé ». La Realtime API sert à la « parole, au raisonnement et à l'usage d'outils dans une seule session ».
Architecture : délégation vs modèle unique
GPT-Live-1.1 sépare la parole de la réflexion. Le modèle vocal gère la conversation en temps réel et écoute pendant qu'il parle. Lorsqu'une requête demande du raisonnement, une recherche ou un outil, il délègue le travail à un modèle backend et poursuit la conversation pendant que celui-ci s'exécute.
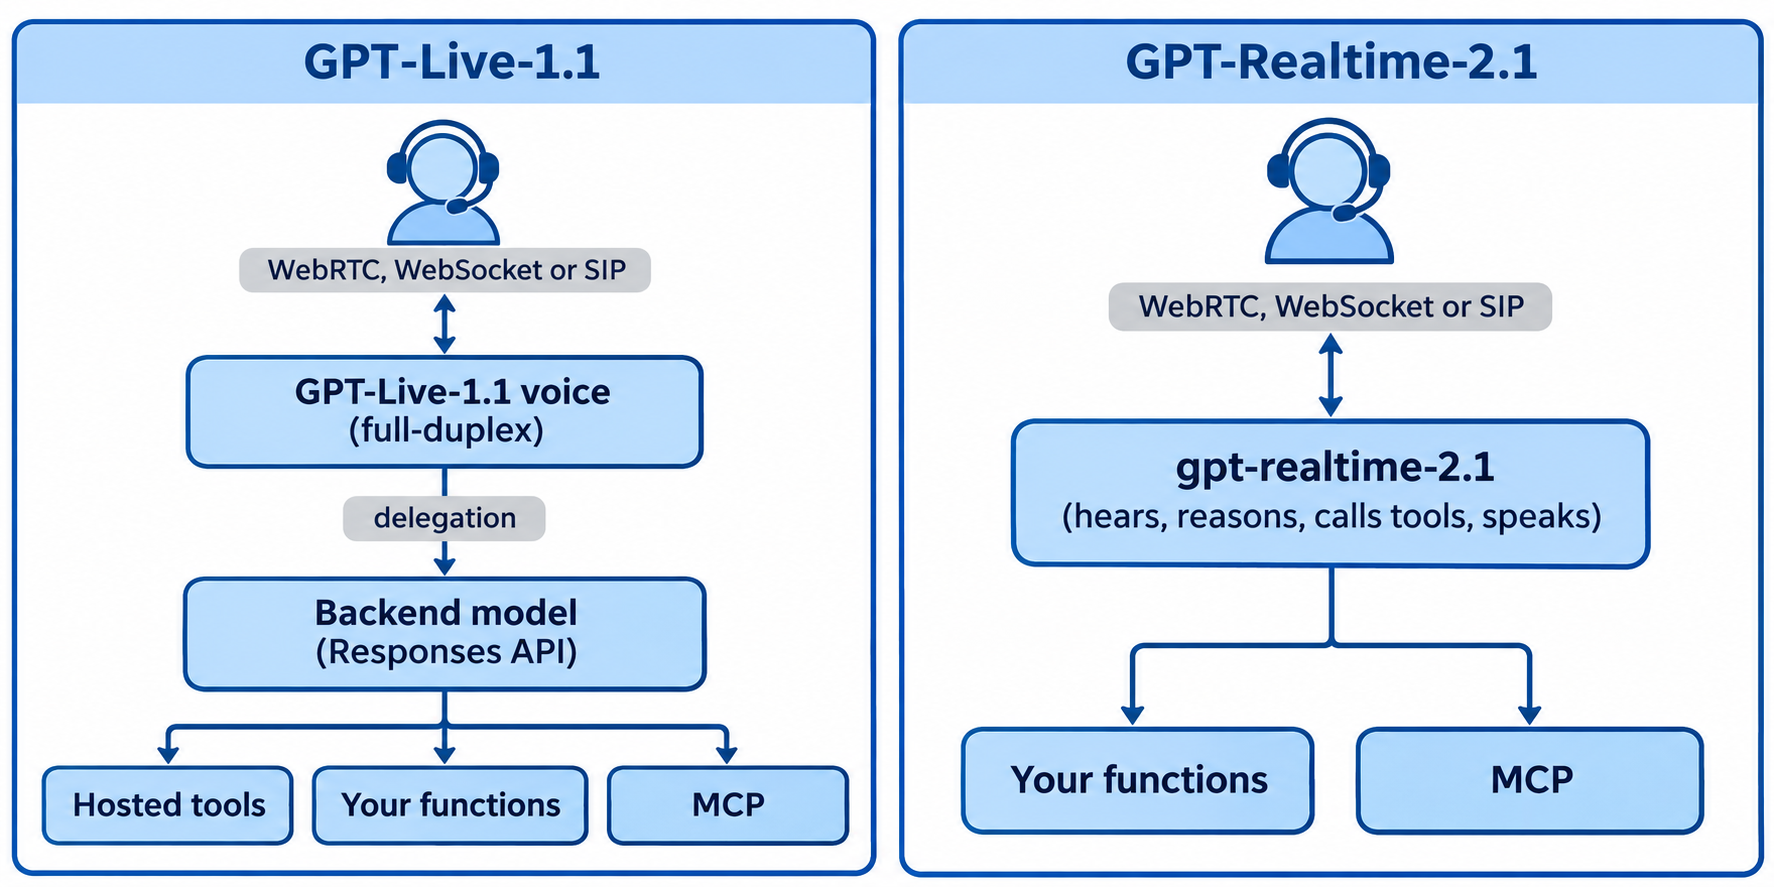
La délégation se configure une seule fois, à la création de la session, comme l'explique le guide des conversations live. Elle propose deux modes :
responses: OpenAI exécute le backend via la Responses API. Vous choisissez le modèle dansdelegation.responses.modelet ajoutezinstructions,tools,tool_choice,reasoningetservice_tier. La documentation conseille de commencer avecgpt-6-lunapuis de passer àgpt-6-solpour les tâches plus difficiles.client: c'est votre application qui exécute le backend. GPT-Live envoie un événementsession.delegation.createdet vous renvoyez les résultats via des événements tels quesession.instructions.append.
Le mode ne peut pas changer en cours de session ; en changer implique de créer une nouvelle session. En revanche, les paramètres du backend qu'elle contient peuvent être modifiés avec session.update.
gpt-realtime-2.1 adopte l'approche inverse : un seul modèle de raisonnement interprète l'audio, appelle les outils et répond vocalement. Pas de second modèle, pas de transfert, et tout le contexte au même endroit.
Avec GPT-Live-1.1, vous pouvez changer de backend, ou conserver votre agent texte existant, sans toucher à la couche vocale. Avec Realtime, le modèle vocal est l'agent.
Tarification : à la minute vs au token
GPT-Live-1.1 facture au temps, Realtime facture au token. Leurs coûts se comportent donc très différemment dès que les appelants marquent des pauses, s'étendent ou restent en ligne.
| Poste de coût | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| Audio | 0,05 $/min en activité, 0,02 $/min en veille | 32 $ en entrée, 64 $ en sortie par million de tokens | 10 $ en entrée, 20 $ en sortie par million de tokens |
| Texte | Facturé à la durée de la session | 4 $ en entrée, 24 $ en sortie par million de tokens | 0,60 $ en entrée, 2,40 $ en sortie par million de tokens |
| Entrée mise en cache | n/a | 0,40 $ par million de tokens | 0,30 $ audio, 0,06 $ texte par million |
| Raisonnement et outils | Modèle backend à ses propres tarifs | Inclus dans le prix au token | Inclus dans le prix au token |
GPT-Live facture à la seconde : un appel de 90 secondes coûte donc 0,075 $ de temps vocal, et non 0,10 $. Une session WebRTC est facturée 15 secondes le temps de son initialisation, ce montant étant crédité dès qu'elle démarre.
La veille est le levier de coût que Realtime n'a pas. En WebRTC, définissez wake_policy.type sur "speech" et idle_timeout_s sur un nombre entier compris entre 5 et 60. Après ce nombre de secondes sans parole, la session passe à 0,02 $ par minute jusqu'à ce que quelqu'un reparle. La veille n'est documentée que pour WebRTC : les sessions WebSocket et SIP facturent chaque seconde connectée au tarif actif.
Pour comparer les deux sur votre propre trafic, calculez un seuil de rentabilité plutôt que de partir au hasard. 0,05 $ achète environ 1 560 tokens audio d'entrée ou 780 tokens audio de sortie sur gpt-realtime-2.1, et environ 5 000 tokens d'entrée ou 2 500 tokens de sortie sur 2.1-mini. Récupérez les volumes de tokens audio par minute dans vos événements d'usage Realtime. Si votre minute active moyenne en consomme davantage, le temps vocal de GPT-Live est plus économique ; ajoutez ensuite la facture de tokens du modèle backend pour obtenir une vue complète.
Realtime intègre le raisonnement dans le prix au token ; GPT-Live ajoute une facture backend par tâche déléguée, mais réduit le coût des moments de silence grâce à la veille. Pour le volet tokens, consultez notre guide gpt-realtime-2.1-mini.
Appels de fonctions et outils
Les deux stacks appellent vos fonctions, mais depuis des endroits différents.
Avec Realtime, les outils sont attachés à la session. Le guide des outils Realtime montre un outil "type": "function" dans session.tools, envoyé avec session.update. Votre client exécute la fonction et renvoie un élément function_call_output. Les serveurs MCP distants fonctionnent aussi : ajoutez un outil avec "type": "mcp", un server_label et une server_url, et la Realtime API appelle le serveur pour vous. Vous pouvez également limiter les outils à un seul tour avec response.tools.
Avec GPT-Live-1.1, les outils résident sur le backend. Placez les outils de fonction, les serveurs MCP et les outils hébergés comme la recherche web, la recherche de fichiers et Code Interpreter dans delegation.responses.tools. Les événements du backend vous parviennent enveloppés dans des enveloppes response.event, et les résultats de vos fonctions sont renvoyés sous forme d'éléments function_call_output suivis d'un response.create.
L'avantage : la voix reste réactive pendant qu'un outil lent s'exécute sur le backend. Le prix à payer : deux modèles, deux flux d'événements et deux factures.
Prise de parole, interruptions et transports
C'est là que la différence se ressent le plus pour un appelant.
Prise de parole. GPT-Live-1.1 est full-duplex : il traite l'audio entrant pendant qu'il génère sa réponse, et peut donc écouter, émettre des signaux d'écoute et s'ajuster en pleine phrase. Realtime fonctionne par tours détectés via l'activité vocale. Le guide VAD de Realtime répertorie deux modes dans session.audio.input.turn_detection.type :
server_vad, le mode par défaut, ajusté avecthreshold,prefix_padding_msetsilence_duration_ms.semantic_vad, ajusté aveceagerness(low,medium,highouauto, qui équivaut àmedium).
Realtime gère l'interruption (barge-in) avec interrupt_response. GPT-Live n'a pas besoin de ce paramètre, puisqu'il écoute déjà pendant qu'il parle.
Transports. Les deux prennent en charge WebRTC dans le navigateur et WebSocket côté serveur. La téléphonie, elle, diffère. D'après le guide SIP, GPT-Live prend en charge le SIP entrant et sortant, et les appels sortants sont « disponibles pour toutes les organisations via la Live API, et non via l'endpoint de création d'appel de la Realtime API ». Un appel SIP GPT-Live connecté est limité à 2 heures. Le guide SIP de Realtime couvre les appels entrants via le webhook realtime.call.incoming.
Limites et contexte
| Limite | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| Contexte | 128 000 tokens par session, gérés automatiquement | 128 000 tokens |
| Nombre maximal de tokens en sortie | Non publié | 32 000 |
| Instructions | Jusqu'à 16 384 tokens | Non publié |
| Limites de débit | Sessions simultanées, par modèle | 400 RPM et 200 000 TPM sur le palier Build |
GPT-Live compte les sessions simultanées, pas les tokens. La page GPT-Live-1 indique 50 sessions simultanées sur Build, 300 sur Launch et 500 sur Grow, sans accès au palier Free. GPT-Live-1.1 dispose de sa propre limite, distincte, et sa page ne publie pas encore de chiffres : vérifiez la page des limites de votre organisation avant un lancement.
Les limites de Realtime montent jusqu'à 10 000 RPM sur Launch et 20 000 RPM sur Grow.
Quelle API vocale d'OpenAI choisir ?
Optez pour GPT-Live-1.1 lorsque la voix est une couche posée sur un agent auquel vous faites déjà confiance, et pour Realtime lorsque c'est le modèle vocal qui doit être l'agent.
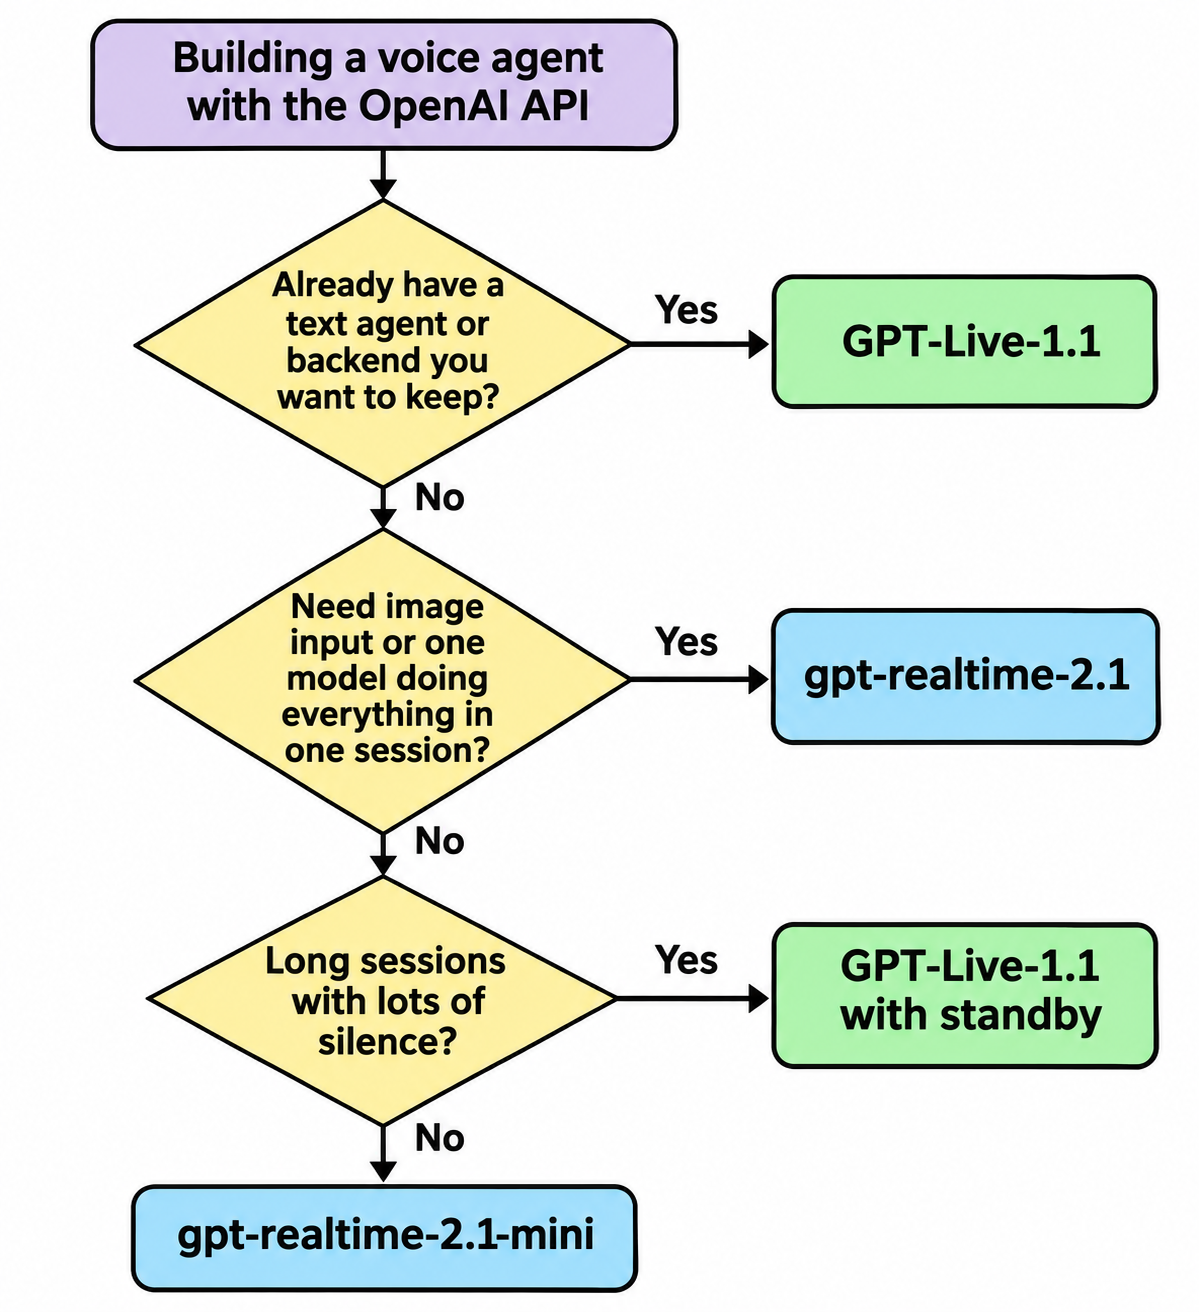
Choisissez GPT-Live-1.1 pour :
- Ajouter la voix à un agent texte, un bot de support ou un workflow existant sans le reconstruire.
- Les sessions longues avec des temps morts, comme le tutorat, le coaching ou les compagnons, où la veille est rentable.
- Les appels téléphoniques sortants, que seule la Live API propose.
- Les conversations qui exigent des chevauchements naturels et des signaux d'écoute.
Choisissez gpt-realtime-2.1 pour :
- Les agents vocaux autonomes où un seul modèle doit raisonner et agir.
- Les applications qui envoient des images avec la parole.
- Les équipes qui veulent un seul flux d'événements et une seule facture.
Choisissez gpt-realtime-2.1-mini pour les tâches vocales courtes, à fort volume et à faible coût, où le prix au token bat le prix à la minute. Notre guide de l'API GPT-Realtime-2 détaille la configuration de Realtime.
Laissez votre agent de code tester l'API d'outils avec Apidog CLI
Quelle que soit la stack retenue, les deux appellent la même chose : votre API d'outils. Une requête lente, c'est du silence à l'antenne dans les deux cas : testez sa latence et son contrat avant qu'un appelant ne l'entende. Laissez Claude Code, Codex ou Cursor s'en charger avec Apidog CLI.
Installez-le une fois pour toutes :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Puis donnez un seul prompt à votre agent :
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
L'agent importe la spec, vérifie la forme du payload, construit le scénario et l'exécute :
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20 répète l'exécution pour qu'une réponse chanceuse ne masque pas une queue lente, et --timeout-request 800 fait échouer tout appel assez lent pour laisser un appelant attendre. Remplacez -r cli,json par -r junit en CI pour qu'une régression bloque le déploiement, comme le montre notre guide CI/CD d'Apidog CLI. Vous débutez avec le workflow agent ? Commencez par Apidog CLI dans Claude Code. Le plan Free d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Lequel est le moins cher, GPT-Live-1.1 ou GPT-Realtime ? Cela dépend de vos tokens audio par minute et de votre backend. La voix GPT-Live coûte 0,05 $ par minute active, plus les tokens du modèle backend. Sur gpt-realtime-2.1, 0,05 $ achète environ 1 560 tokens audio d'entrée ou 780 tokens audio de sortie. Comparez avec vos propres journaux d'usage.
Peut-on utiliser l'appel de fonctions avec GPT-Live-1.1 ? Oui, via la délégation. Placez les outils de fonction dans delegation.responses.tools, ou exécutez vous-même le backend en mode de délégation client. Le modèle vocal n'accepte pas de liste d'outils directe comme le fait session.tools côté Realtime.
GPT-Realtime prend-il en charge la facturation en veille ? Non. La veille à 0,02 $ par minute est une fonctionnalité de GPT-Live, et uniquement pour les sessions WebRTC configurées avec wake_policy et idle_timeout_s. Realtime facture les tokens consommés par chaque session.
GPT-Live-1.1 peut-il passer des appels téléphoniques sortants ? Oui. Créez une session avec transport.type: "sip" et les détails de votre trunk SIP sur POST /v1/live/sessions. La documentation d'OpenAI précise que le SIP sortant passe par la Live API, et non par l'endpoint de création d'appel de la Realtime API.
GPT-Live-1.1 accepte-t-il des images en entrée ? Non. La page du modèle indique de l'audio et du texte en entrée comme en sortie. Si votre agent vocal doit voir des images, gpt-realtime-2.1 accepte les images en entrée à 5 $ par million de tokens.