
La tarification de GPT-Live-1.1 est basée sur le temps, pas sur les tokens. OpenAI facture la session vocale à 0,05 $ par minute active et 0,02 $ par minute en veille, au prorata de la seconde sans arrondi à la minute supérieure. Les appels au modèle backend et aux outils sont facturés séparément, à leurs tarifs habituels. Une heure de conversation ininterrompue coûte 3,00 $ en frais vocaux ; une heure en veille coûte 1,20 $.
La grille tarifaire est courte. Ce qui compte, c'est son comportement dans une application réelle, où les appelants marquent des pauses, où les backends réfléchissent et où les sessions restent ouvertes trop longtemps. Voici trois exemples chiffrés et les réglages qui permettent de garder une facture prévisible.
La tarification de GPT-Live-1.1 en un coup d'œil
GPT-Live-1.1 applique deux tarifs vocaux et une facture séparée pour le backend. Voici ce que listent la page du modèle GPT-Live-1.1 et la page de tarification OpenAI au 20 novembre 2026 :
| Frais | Tarif | Par heure | Remarques |
|---|---|---|---|
| Temps de session actif | 0,05 $ par minute | 3,00 $ | Parole, silence avant l'expiration du délai d'inactivité, attente des travaux backend |
| Temps de session en veille | 0,02 $ par minute | 1,20 $ | WebRTC uniquement, pendant que l'inférence est en pause |
| Modèle backend Responses | Tarifs de tokens normaux | Variable | Quel que soit le modèle choisi pour la délégation |
| Outils hébergés | Tarifs d'outils normaux | Variable | Recherche web, recherche de fichiers, Code Interpreter et autres |
Trois détails comptent plus que les tarifs vedettes :
- Facturation à la seconde. Un appel de 90 secondes coûte 0,075 $, pas 0,10 $ ; la durée n'est pas arrondie à la minute entière.
- Même prix que GPT-Live-1. Les deux modèles partagent des tarifs identiques, donc la migration ne change rien à la facture vocale.
- Frais de démarrage de 15 secondes. La création d'une session WebRTC facture 15 secondes pendant l'initialisation, créditées une fois la session en cours. Cela ne coûte supplémentaire que pour les sessions créées puis abandonnées.
Pour un aperçu des piles vocales, consultez GPT-Live vs GPT-Realtime.
Ce qui compte comme minutes actives ou en veille
Les minutes actives correspondent à tout moment où l'inférence fonctionne. Les minutes en veille correspondent au temps où une session WebRTC reste connectée avec l'inférence en pause, en attente de parole. L'écart de 0,03 $ par minute entre les deux détermine l'essentiel de votre facture vocale.
Le guide des coûts d'OpenAI détaille ce qui relève de la catégorie « actif » :
- Le temps où l'utilisateur ou le modèle parle.
- Le silence avant l'expiration de votre délai d'inactivité.
- Le temps d'attente des travaux backend pendant que l'inférence tourne.
Couper le micro ne déclenche pas la veille ; la session continue d'être facturée à 0,05 $ par minute.
La veille nécessite deux réglages à la création de la session, documentés dans le guide des conversations live :
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" indique à la session d'attendre une prise de parole avant de démarrer l'inférence. idle_timeout_s accepte un nombre entier de 5 à 60 et renvoie la session en veille après ce nombre de secondes sans transcript en entrée ni en sortie. Sans ce délai, l'inférence reste active jusqu'à la fin de la session, et vous ne bénéficiez jamais du tarif de veille.
Deux réserves : la veille n'est disponible qu'en WebRTC, donc les sessions WebSocket et SIP facturent chaque seconde connectée au tarif actif, et la première réponse après la veille peut être plus lente.
Exemples de coûts chiffrés
Les tarifs vocaux sont ceux publiés ; les volumes de tokens backend sont des hypothèses illustratives. Les prix backend proviennent de la page de tarification OpenAI : gpt-6-luna à 0,10 $ en entrée et 0,50 $ en sortie par million de tokens, gpt-6-sol à 2,00 $ en entrée et 10,00 $ en sortie par million de tokens (niveau standard, contexte court). Le guide de délégation d'OpenAI recommande de commencer avec gpt-6-luna et d'essayer gpt-6-sol pour les tâches backend plus complexes.
Exemple 1 : un service d'assistance téléphonique
Un appel d'assistance par téléphone ou WebSocket dure 6 minutes. La veille ne s'applique pas, donc les 6 minutes sont facturées comme actives. GPT-Live délègue 4 recherches à gpt-6-luna, chacune utilisant environ 6 000 tokens en entrée et 400 en sortie.
| Poste | Calcul | Coût |
|---|---|---|
| Vocal | 6 min x 0,05 $ | 0,30 $ |
| Entrée backend | 24 000 tokens x 0,10 $ / 1M | 0,0024 $ |
| Sortie backend | 1 600 tokens x 0,50 $ / 1M | 0,0008 $ |
| Par appel | 0,3032 $ |
À 10 000 appels par mois, cela représente environ 3 032 $, dont 3 000 $ de temps vocal. Réduire de 30 secondes la durée moyenne d'un appel économise plus que la totalité de la facture backend.
Exemple 2 : un tuteur de langues dans le navigateur
Une session de tutorat WebRTC de 30 minutes avec idle_timeout_s réglé sur 15. L'élève passe de longs moments à lire et réfléchir, donc la session tourne 18 minutes en mode actif et 12 minutes en veille. Le tuteur délègue 10 explications à gpt-6-sol, à environ 8 000 tokens en entrée et 600 en sortie chacune.
| Poste | Calcul | Coût |
|---|---|---|
| Vocal actif | 18 min x 0,05 $ | 0,90 $ |
| Vocal en veille | 12 min x 0,02 $ | 0,24 $ |
| Entrée backend | 80 000 tokens x 2,00 $ / 1M | 0,16 $ |
| Sortie backend | 6 000 tokens x 10,00 $ / 1M | 0,06 $ |
| Par session | 1,36 $ |
Sans la veille, ces mêmes 30 minutes de vocal coûteraient 1,50 $ au lieu de 1,14 $ : la veille réduit donc la facture vocale de 24 %.
Exemple 3 : un assistant de bureau toujours actif
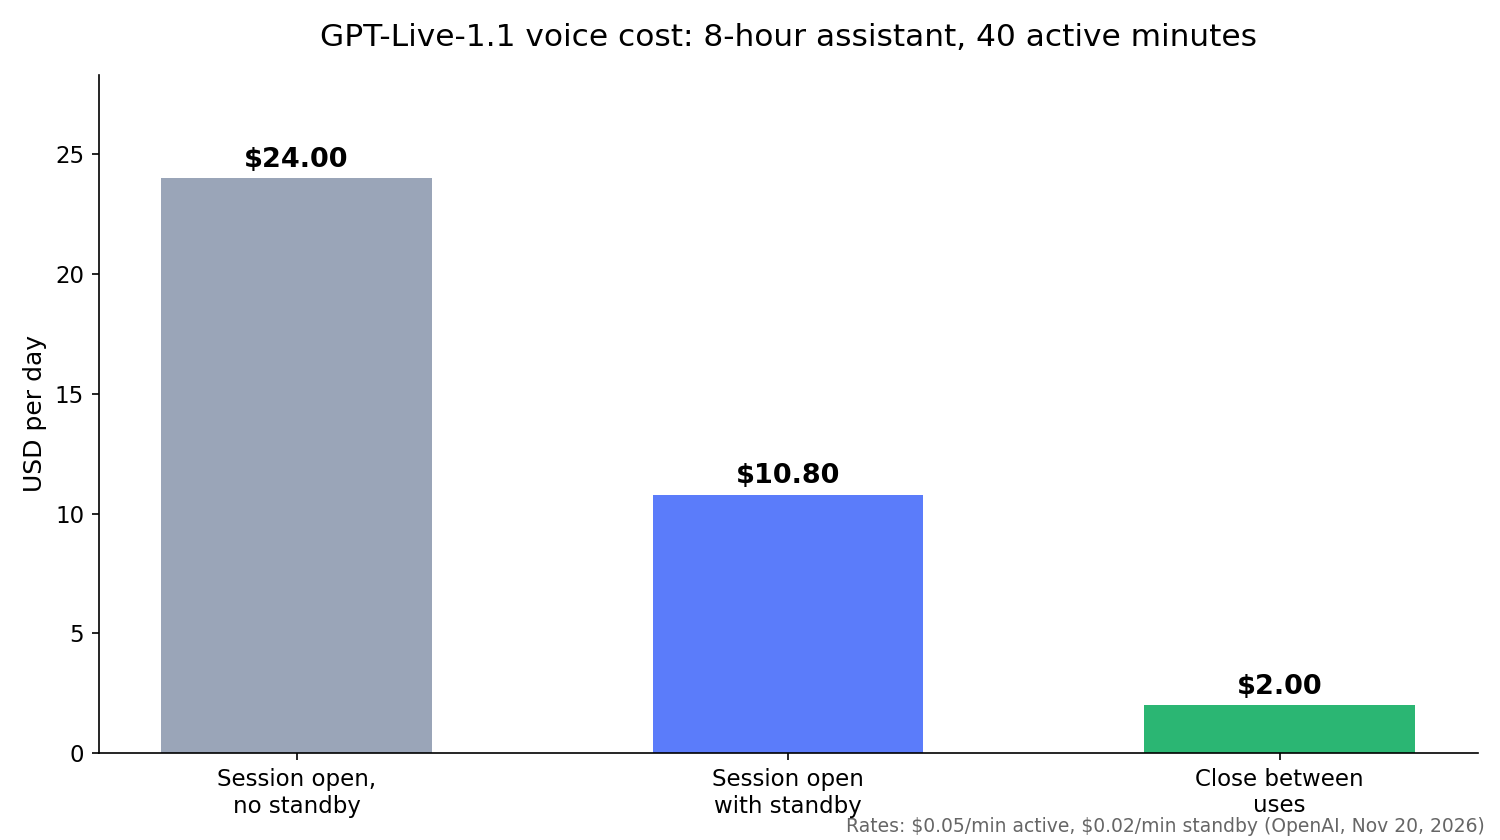
Un assistant reste ouvert pendant une journée de travail de 8 heures, mais l'utilisateur ne lui parle que 40 minutes, par courtes sessions. Ici, la stratégie choisie change la facture de plus d'un facteur 10 :
| Stratégie | Calcul | Par jour | Par mois de 22 jours |
|---|---|---|---|
| Session ouverte, sans veille | 480 min x 0,05 $ | 24,00 $ | 528,00 $ |
| Session ouverte avec veille | 40 x 0,05 $ + 440 x 0,02 $ | 10,80 $ | 237,60 $ |
| Fermeture entre les usages | 40 min x 0,05 $ | 2,00 $ | 44,00 $ |
La veille coûte quand même 1,20 $ par heure d'inactivité. Le guide d'OpenAI recommande de fermer la session pendant les longues interruptions et d'en démarrer une nouvelle, préchargée avec l'historique sauvegardé, au retour de l'utilisateur. Les frais de démarrage de 15 secondes sont crédités une fois la nouvelle session en cours, donc rien qu'en frais vocaux, la fermeture gagne. Vous perdez le réveil instantané : une session fermée n'entend pas l'utilisateur, il vous faut un push-to-talk ou votre propre déclencheur de réveil.
Comment le délai d'inactivité modifie votre facture
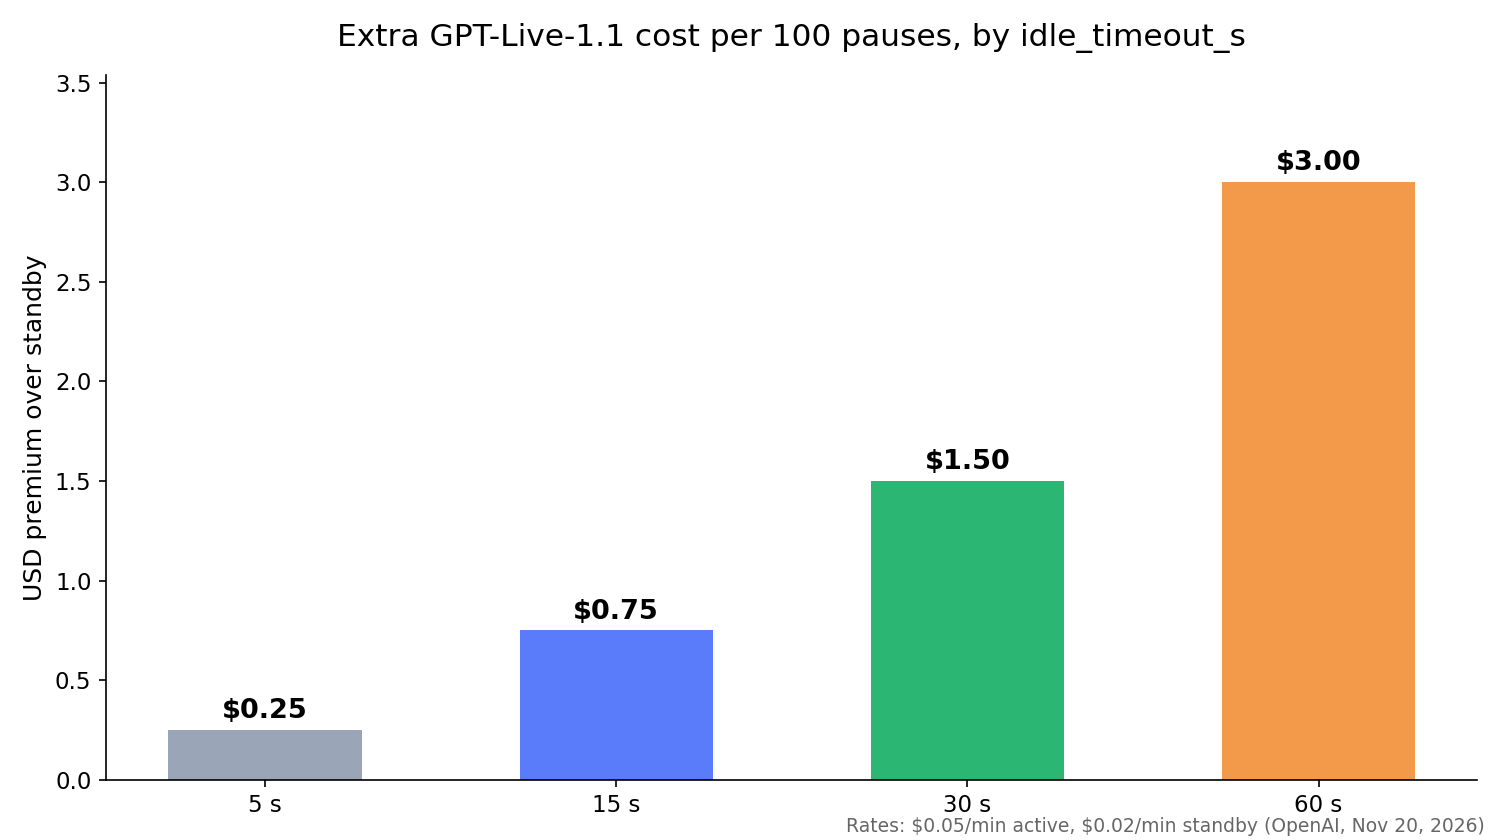
Chaque pause coûte du temps actif jusqu'au déclenchement du délai d'inactivité. Un délai plus court atteint plus vite le tarif de veille, moins cher, au prix de davantage de cycles pause-reprise et d'une première réponse plus lente après chacun.
Le surcoût par pause correspond à la durée du délai facturée à l'écart de 0,03 $ entre les deux tarifs. Sur 100 pauses dans une session ou une journée :
idle_timeout_s |
Secondes actives par pause | Surcoût par rapport à la veille, par 100 pauses |
|---|---|---|
| 5 | 5 | 0,25 $ |
| 15 | 15 | 0,75 $ |
| 30 | 30 | 1,50 $ |
| 60 | 60 | 3,00 $ |
Des montants modestes, et c'est le but : le délai d'inactivité est surtout un réglage d'expérience utilisateur. Choisissez une valeur qui ne coupe pas les utilisateurs en pleine réflexion, puis laissez la veille couvrir les longues interruptions et la fermeture de session les très longues.
Comment la tarification de GPT-Live-1.1 se compare à GPT-Realtime
GPT-Live-1.1 facture à la minute ; les modèles GPT-Realtime facturent au token. La page de tarification OpenAI liste l'audio de gpt-realtime-2.1 à 32,00 $ par million de tokens en entrée et 64,00 $ par million en sortie, et l'audio de gpt-realtime-2.1-mini à 10,00 $ et 20,00 $.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Unité de facturation | Secondes de session | Tokens en entrée et en sortie |
| Tarif vocal | 0,05 $/min actif, 0,02 $/min en veille | 32 $ / 64 $ par million de tokens audio |
| Raisonnement et outils | Modèle backend séparé | Dans le même modèle |
| Courbe de coûts | Fixe par minute | Augmente à chaque tour à mesure que le contexte grossit |
Le guide des coûts d'OpenAI précise qu'une session Realtime envoie l'intégralité de la conversation au modèle à chaque réponse, donc les tours suivants coûtent plus cher. Une minute de GPT-Live coûte le même prix à la minute 2 et à la minute 40, ce qui simplifie les prévisions. Notre guide de l'API GPT-Realtime-2 couvre l'approche basée sur les tokens.
Suivre l'usage et éviter les mauvaises surprises sur la facture
GPT-Live rapporte l'usage vocal cumulé en secondes via les événements session.usage.updated :
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Chaque mise à jour remplace le total précédent, ne les additionnez donc jamais. Envoyez session.close, attendez session.closed et enregistrez le usage.seconds final. Pour distinguer l'actif de la veille, chronométrez les intervalles entre les événements session.paused et session.resumed.
Les bonnes habitudes qui maintiennent les coûts stables :
- Fermez les sessions terminées. Une session ouverte et abandonnée continue d'être facturée.
- Accélérez le backend. L'attente d'une tâche déléguée est du temps actif ; terminer une minute plus tôt économise 0,05 $.
- Fermez pendant les longs traitements. Coupez le vocal pendant que le backend travaille et rouvrez quand le résultat est prêt.
- Anticipez la concurrence. Les limites portent sur les sessions simultanées, et GPT-Live-1.1 a une limite distincte de celle de GPT-Live-1, dont les limites publiées sont 50 (Build), 300 (Launch) et 500 (Grow). L'offre Free n'est pas prise en charge.
Laissez Codex tester votre registre de coûts avec Apidog CLI
Votre registre d'usage est du code dont vous êtes responsable, et un bug fausse le prix de chaque appel. Testez-le à chaque commit sans ouvrir de session vocale, à 0 $ de temps vocal, et laissez votre agent de codage exécuter les tests avec Apidog CLI.
Installez la CLI, connectez-vous et ajoutez la compétence Apidog à votre agent :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Puis donnez à Codex une seule invite :
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
L'agent lit le schéma, valide sa charge utile, crée les cas de test et les exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Remplacez -r cli,json par -r junit et la même exécution s'intègre à votre CI ; voir exécuter Apidog CLI dans un pipeline CI/CD. Le guide Apidog CLI dans Codex détaille la configuration de l'agent. Le plan Free d'Apidog couvre les équipes jusqu'à 4 utilisateurs.
FAQ
Combien coûte GPT-Live-1.1 par minute ? 0,05 $ par minute active et 0,02 $ par minute en veille, facturé à la seconde. L'usage backend s'ajoute en supplément.
GPT-Live-1.1 est-il plus cher que GPT-Live-1 ? Non. OpenAI liste les deux aux mêmes tarifs actif et veille.
La veille fonctionne-t-elle sur les appels téléphoniques ? Non. Le tarif de veille réduit ne s'applique qu'aux sessions WebRTC pendant que l'inférence est en pause. Les sessions WebSocket et SIP facturent le temps connecté au tarif actif.
Les appels au modèle backend sont-ils inclus dans le prix à la minute ? Non. Les appels Responses délégués sont facturés aux tarifs de tokens du modèle choisi, plus les frais d'outils.
Qu'est-il advenu de la question de l'API GPT-Live en juillet ? À l'époque, GPT-Live était une fonctionnalité vocale de ChatGPT sans API, comme le soulignait alors notre explication de l'API GPT-Live. GPT-Live-1.1 est le modèle d'API, servi sur v1/live/sessions.