
L'API GPT-Live-1.1 est le modèle vocal bidirectionnel (full-duplex) d'OpenAI, servi sur v1/live/sessions. Vous ouvrez une session via WebRTC, WebSocket ou SIP, envoyez une configuration session avec le modèle, les instructions et la voix, et laissez la délégation confier le raisonnement et les appels d'outils à un modèle Responses exécuté en backend. Le tarif est de 0,05 $ par minute active et 0,02 $ par minute en veille.
OpenAI a rendu GPT-Live-1.1 disponible dans l'API le 20 novembre 2026, comme l'annonce l'annonce des développeurs OpenAI. Si vous avez lu notre article de juillet, Existe-t-il une API GPT-Live ? répondait « pas encore ». C'est désormais chose faite. Ce guide vous accompagne pas à pas dans l'ouverture d'une session fonctionnelle, une configuration de délégation, un outil de type fonction et la mise en place de tests pour le backend que votre agent vocal appelle.
Qu'est-ce que l'API GPT-Live-1.1 ?
GPT-Live-1.1 est un modèle audio entrant, audio sortant qui écoute pendant qu'il parle. Il fonctionne sur le point d'entrée v1/live/sessions, et non sur v1/realtime ou v1/responses. Son rôle propre est la conversation. Le raisonnement plus lourd et l'utilisation d'outils sont confiés à un modèle backend que vous configurez, de sorte que la voix reste réactive pendant que le travail s'exécute.
Voici ce que la page du modèle GPT-Live-1.1 indique à ce jour :
| Élément | GPT-Live-1.1 |
|---|---|
| ID du modèle | gpt-live-1.1 (une seule version) |
| Entrée / sortie | Audio et texte en entrée, audio et texte en sortie |
| Point d'entrée | v1/live/sessions uniquement |
| Transports | WebRTC (recommandé), WebSocket, SIP |
| Tarif actif | 0,05 $ par minute |
| Tarif en veille | 0,02 $ par minute (WebRTC, inférence en pause) |
| Modèle backend et outils | Facturés séparément à leurs tarifs habituels |
| Concurrence | Limite distincte de celle de GPT-Live-1, par organisation |
Pour le contexte produit, consultez ce qu'est GPT-Live et en quoi il diffère de GPT Realtime.
GPT-Live-1.1 vs GPT-Live-1 : ce qui change
La page du modèle et le guide de prompting listent quatre différences pratiques :
- Transcription : la version 1.1 « transcrit la parole avec plus de précision ».
- Voix : la version 1.1 conserve « un accent et une voix plus cohérents d'une langue à l'autre ».
- Prompt de délégation : la version 1.1 accepte le langage naturel (« Délègue au backend lorsque : »). GPT-Live-1 exige le marqueur
<|SpawnThinking|>dans sa politique. - Formulation de facturation : GPT-Live-1 est facturé à la seconde et n'arrondit jamais à la minute entière. La page de la version 1.1 indique seulement « facturé à la durée ».
Les deux modèles partagent le même point d'entrée, les mêmes tarifs et la même structure de session, donc passer à la 1.1 revient surtout à changer la chaîne du modèle et à utiliser un prompt plus propre.
Comment ouvrir une session GPT-Live-1.1
Le guide de démarrage de GPT-Live recommande WebRTC pour l'audio côté navigateur, mobile et serveur. WebSocket est le chemin le plus simple pour un prototype côté serveur, c'est donc par là qu'on commence :
- Ouvrez
wss://api.openai.com/v1/live/sessionsavecAuthorization: Bearer $OPENAI_API_KEYet sans paramètres de requête. - Envoyez
session.startcomme premier message, avec votre configurationsession. - Attendez
session.startedavant d'envoyer de l'audio. - Diffusez l'audio dans le format choisi. Par défaut : PCM 24 kHz.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
Quelques règles de configuration issues du guide de conversation :
instructionsaccepte jusqu'à 16 384 tokens. Ajoutez-en en cours de session avecsession.instructions.append(500 tokens par ajout).audio.output.voicevaut par défautmarin. Les autres noms d'API incluentquartz,stone,meridianetwillow.- Les formats WebSocket sont
audio/pcmà 24 000 ou 16 000 Hz, etaudio/pcmuouaudio/pcmaà 8 000 Hz pour la téléphonie. storevaut par défautfalse. Changer demodelnécessite une nouvelle session.
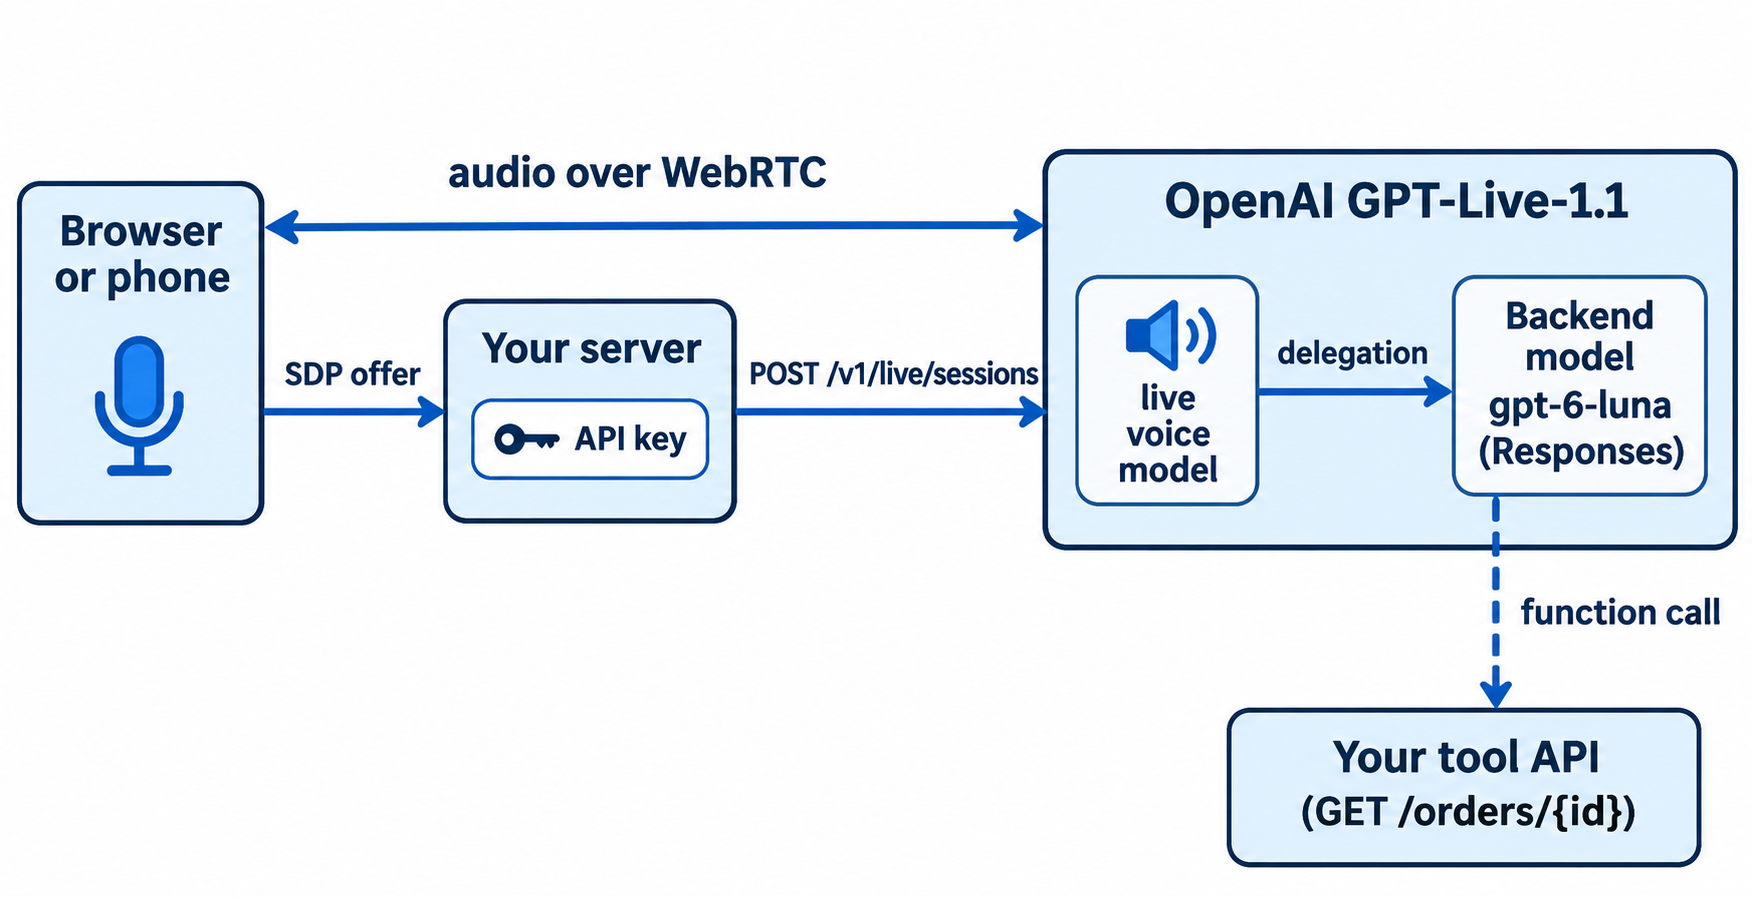
Pour la production dans un navigateur, passez à WebRTC. Votre serveur conserve la clé API et relaie l'offre SDP du navigateur :
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
Omettez audio.format des requêtes WebRTC, et n'envoyez pas session.start sur le canal de données. Notez un détail de facturation : la création d'une session WebRTC facture 15 secondes lors de l'initialisation, créditées une fois la session en cours.
Délégation GPT-Live-1.1 : laissez un modèle backend réfléchir
La délégation est la raison d'être de cette API. Le modèle vocal continue de parler pendant qu'un modèle backend raisonne, recherche ou appelle des outils. Vous choisissez l'un des deux modes à la création de la session, et impossible de changer de mode en cours de session.
| Mode | delegation.type |
Qui exécute le backend | Idéal pour |
|---|---|---|---|
| Responses | "responses" |
OpenAI, avec le modèle et les outils que vous configurez | La plupart des applications ; outils hébergés, appel de fonctions |
| Client | "client" (également la valeur par défaut) |
Votre application | Votre propre boucle d'agent ou un backend non-OpenAI |
Le guide de délégation recommande de commencer avec gpt-6-luna et d'essayer gpt-6-sol pour les tâches backend plus complexes. Si vous hésitez entre les deux, notre présentation de GPT-6 Luna détaille les compromis.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
Le bloc responses accepte aussi max_output_tokens (16 ou plus), service_tier (auto, default, flex ou priority, où priority correspond au mode rapide) ainsi que les paramètres reasoning et text pris en charge par votre modèle backend. Vous pouvez modifier ces champs en cours de session via session.update. La validation est asynchrone : une configuration invalide arrive sous forme d'error avec le code responses_validation_failed, et la session reste ouverte.
Indiquez ensuite au modèle vocal quand déléguer. Avec la 1.1, cela se fait en langage naturel dans instructions :
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
Le guide de prompting met en garde : un « je vérifie cela » prononcé à voix haute ne prouve pas que le travail backend a commencé. Surveillez plutôt session.delegation.created dans vos logs.
Ajouter l'appel de fonctions à une session GPT-Live-1.1
Les outils hébergés comme la recherche web s'exécutent chez OpenAI. Vos propres fonctions s'exécutent dans votre application. Placez un outil de fonction Responses standard dans delegation.responses.tools :
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
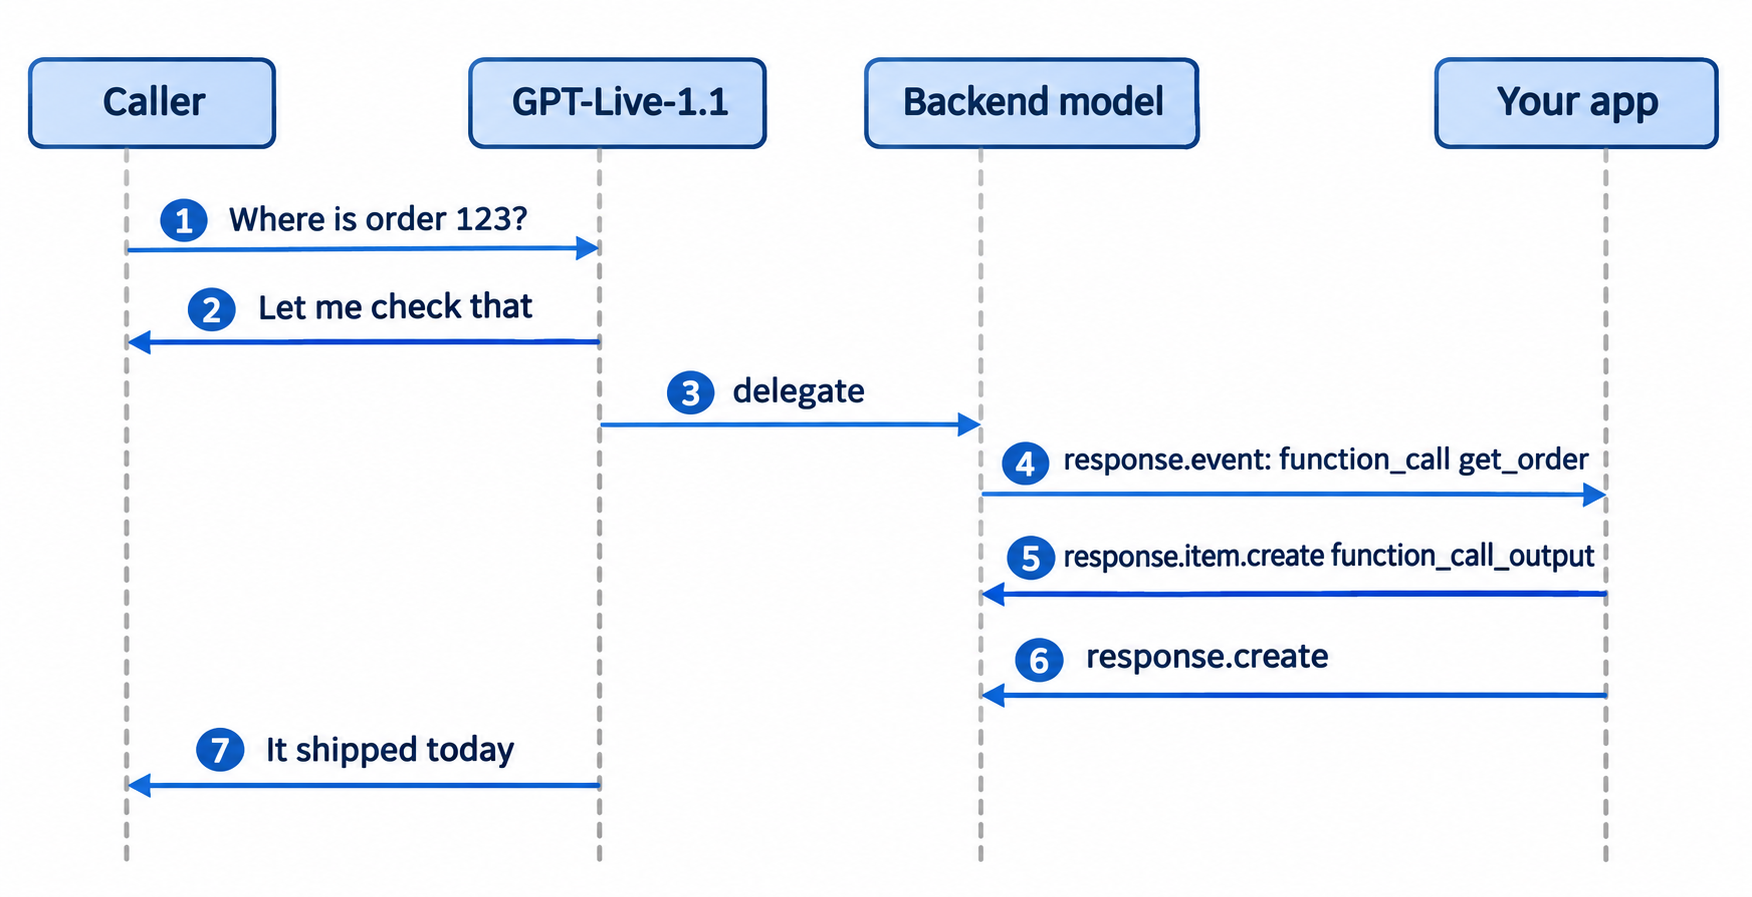
Les événements du backend vous parviennent enveloppés dans une enveloppe response.event qui transporte un delegation_id et un event imbriqué. Un appel de fonction terminé arrive sous forme de response.output_item.done imbriqué, dont l'élément contient call_id, name et arguments. Exécutez la fonction, envoyez un response.item.create avec le résultat, puis envoyez response.create :
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
Trois détails piègent souvent :
- Ajouter uniquement le résultat ne reprend pas le backend. Il faut le
response.create. - Omettez un résultat en attente et vous recevrez
function_call_outputs_required. Lescall_iden double ou incohérents sont rejetés. - Les événements
response.completedtransférés transportent unresponse.outputvide. Lisez les événements individuels des éléments de sortie.
Tarifs et limites de GPT-Live-1.1
Le temps vocal est facile à estimer. Un appel support de 5 minutes restant actif du début à la fin coûte 5 × 0,05 $ = 0,25 $ en temps vocal. Mille appels de ce type coûtent 250 $, plus ce que le modèle backend et les outils facturent à leurs tarifs habituels.
| Ligne de coût | Tarif |
|---|---|
| Voix active | 0,05 $ par minute |
| Voix en veille (WebRTC, inférence en pause) | 0,02 $ par minute |
| Initialisation WebRTC | 15 secondes, créditées une fois la session en cours |
| Modèle backend et outils | Tarification normale du modèle et de l'outil concernés |
Les limites de débit comptent des sessions simultanées, pas des tokens. GPT-Live-1.1 et GPT-Live-1 ont des limites distinctes, applicables à toutes les régions d'inférence. La page de GPT-Live-1 liste 50, 300 et 500 sessions simultanées pour les paliers Build, Launch et Grow, sans accès au palier Free. La page de la 1.1 ne donne aucun chiffre : vérifiez donc la page des limites de votre organisation avant un lancement.
Laissez votre agent de code tester le backend d'outils avec Apidog CLI
Votre agent vocal n'est fiable que si l'API derrière get_order l'est. Une réponse lente ou malformée se traduit par un silence gênant ou une réponse erronée énoncée à voix haute. Testez donc ce backend avant qu'un appelant ne l'entende, et laissez votre agent de code le faire avec Apidog CLI.
Configurez-le une seule fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Puis donnez à Claude Code, Codex ou Cursor un seul prompt :
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
L'agent lit le schéma, valide sa charge utile, crée les cas de test et les exécute :
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Le budget de 800 ms compte pour la voix : l'appelant entend chaque milliseconde que votre outil prend. Intégrez le même apidog run avec -r junit dans votre CI pour qu'une régression fasse échouer le build, comme le montre notre guide CI/CD d'Apidog CLI. Novice du workflow agent ? Commencez avec Apidog CLI dans Claude Code. Le plan Free d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
GPT-Live-1.1 est-il disponible dans l'API ? Oui. Depuis le 20 novembre 2026, vous pouvez appeler gpt-live-1.1 sur v1/live/sessions via WebRTC, WebSocket ou SIP. Il n'est pas servi sur v1/realtime, v1/responses ni sur Chat Completions.
Combien coûte l'API GPT-Live-1.1 ? 0,05 $ par minute active et 0,02 $ par minute en veille. Les appels au modèle backend et les outils sont facturés séparément à leurs propres tarifs.
Quelle est la différence entre GPT-Live-1.1 et GPT Realtime ? GPT-Live fonctionne sur son propre point d'entrée, facture à la durée vocale et confie le raisonnement à un modèle backend via la délégation. GPT Realtime fonctionne sur v1/realtime. Voir notre comparaison GPT-Live vs GPT Realtime.
Quel modèle backend utiliser pour la délégation ? Le guide d'OpenAI recommande gpt-6-luna pour commencer et gpt-6-sol pour les tâches backend plus complexes. Définissez service_tier sur priority si la latence compte plus que le coût.
Puis-je utiliser mon propre agent au lieu d'un modèle Responses ? Oui. Définissez delegation.type sur client. Votre application exécute le travail backend et renvoie les résultats avec session.commentary.append. Vous gérez aussi vous-même les transcriptions.
GPT-Live-1.1 prend-il en charge l'appel de fonctions ? Oui, via la délégation Responses. Définissez les fonctions dans delegation.responses.tools, lisez les appels dans response.event, et renvoyez les résultats avec response.item.create suivi de response.create.