
Utilisez GPT-Image-2.6 Flare pour les brouillons, les gros volumes, les affiches et les visuels produit. Réservez Sunburst aux assets finaux et aux retouches répétées en qualité medium ou high. Dans le duel GPT-Image-2.6 Flare vs Sunburst, les deux modèles coûtent le même prix par token : vous échangez des secondes contre du détail, pas des dollars.
OpenAI a publié les deux modèles le 4 novembre 2026. Cet article les compare sur la vitesse, la qualité, la cohérence des retouches et le coût, puis vous donne notre recommandation pour chaque cas d'usage. Nous n'avons pas exécuté les deux modèles en face à face avec une clé active : chaque chiffre ci-dessous indique donc sa source, et la dernière section montre comment les mesurer sur vos propres prompts.
Pour tout savoir sur cette version, lisez notre article explicatif sur ChatGPT Images 2.6. Pour le duo précédent, consultez notre comparaison Flare vs Sunburst pour la 2.5.
GPT-Image-2.6 Flare vs Sunburst en un coup d'œil
| Élément | Flare | Sunburst |
|---|---|---|
| ID du modèle API | gpt-image-2.6-flare |
gpt-image-2.6-sunburst |
| Le pitch d'OpenAI en une ligne | Itération rapide | Travail visuel détaillé |
| Vitesse publiée | À partir de six secondes en low |
Aucun chiffre |
| Point fort annoncé par OpenAI | Mise en page pour les affiches et les visuels produit | Qualité et cohérence des retouches en medium ou high |
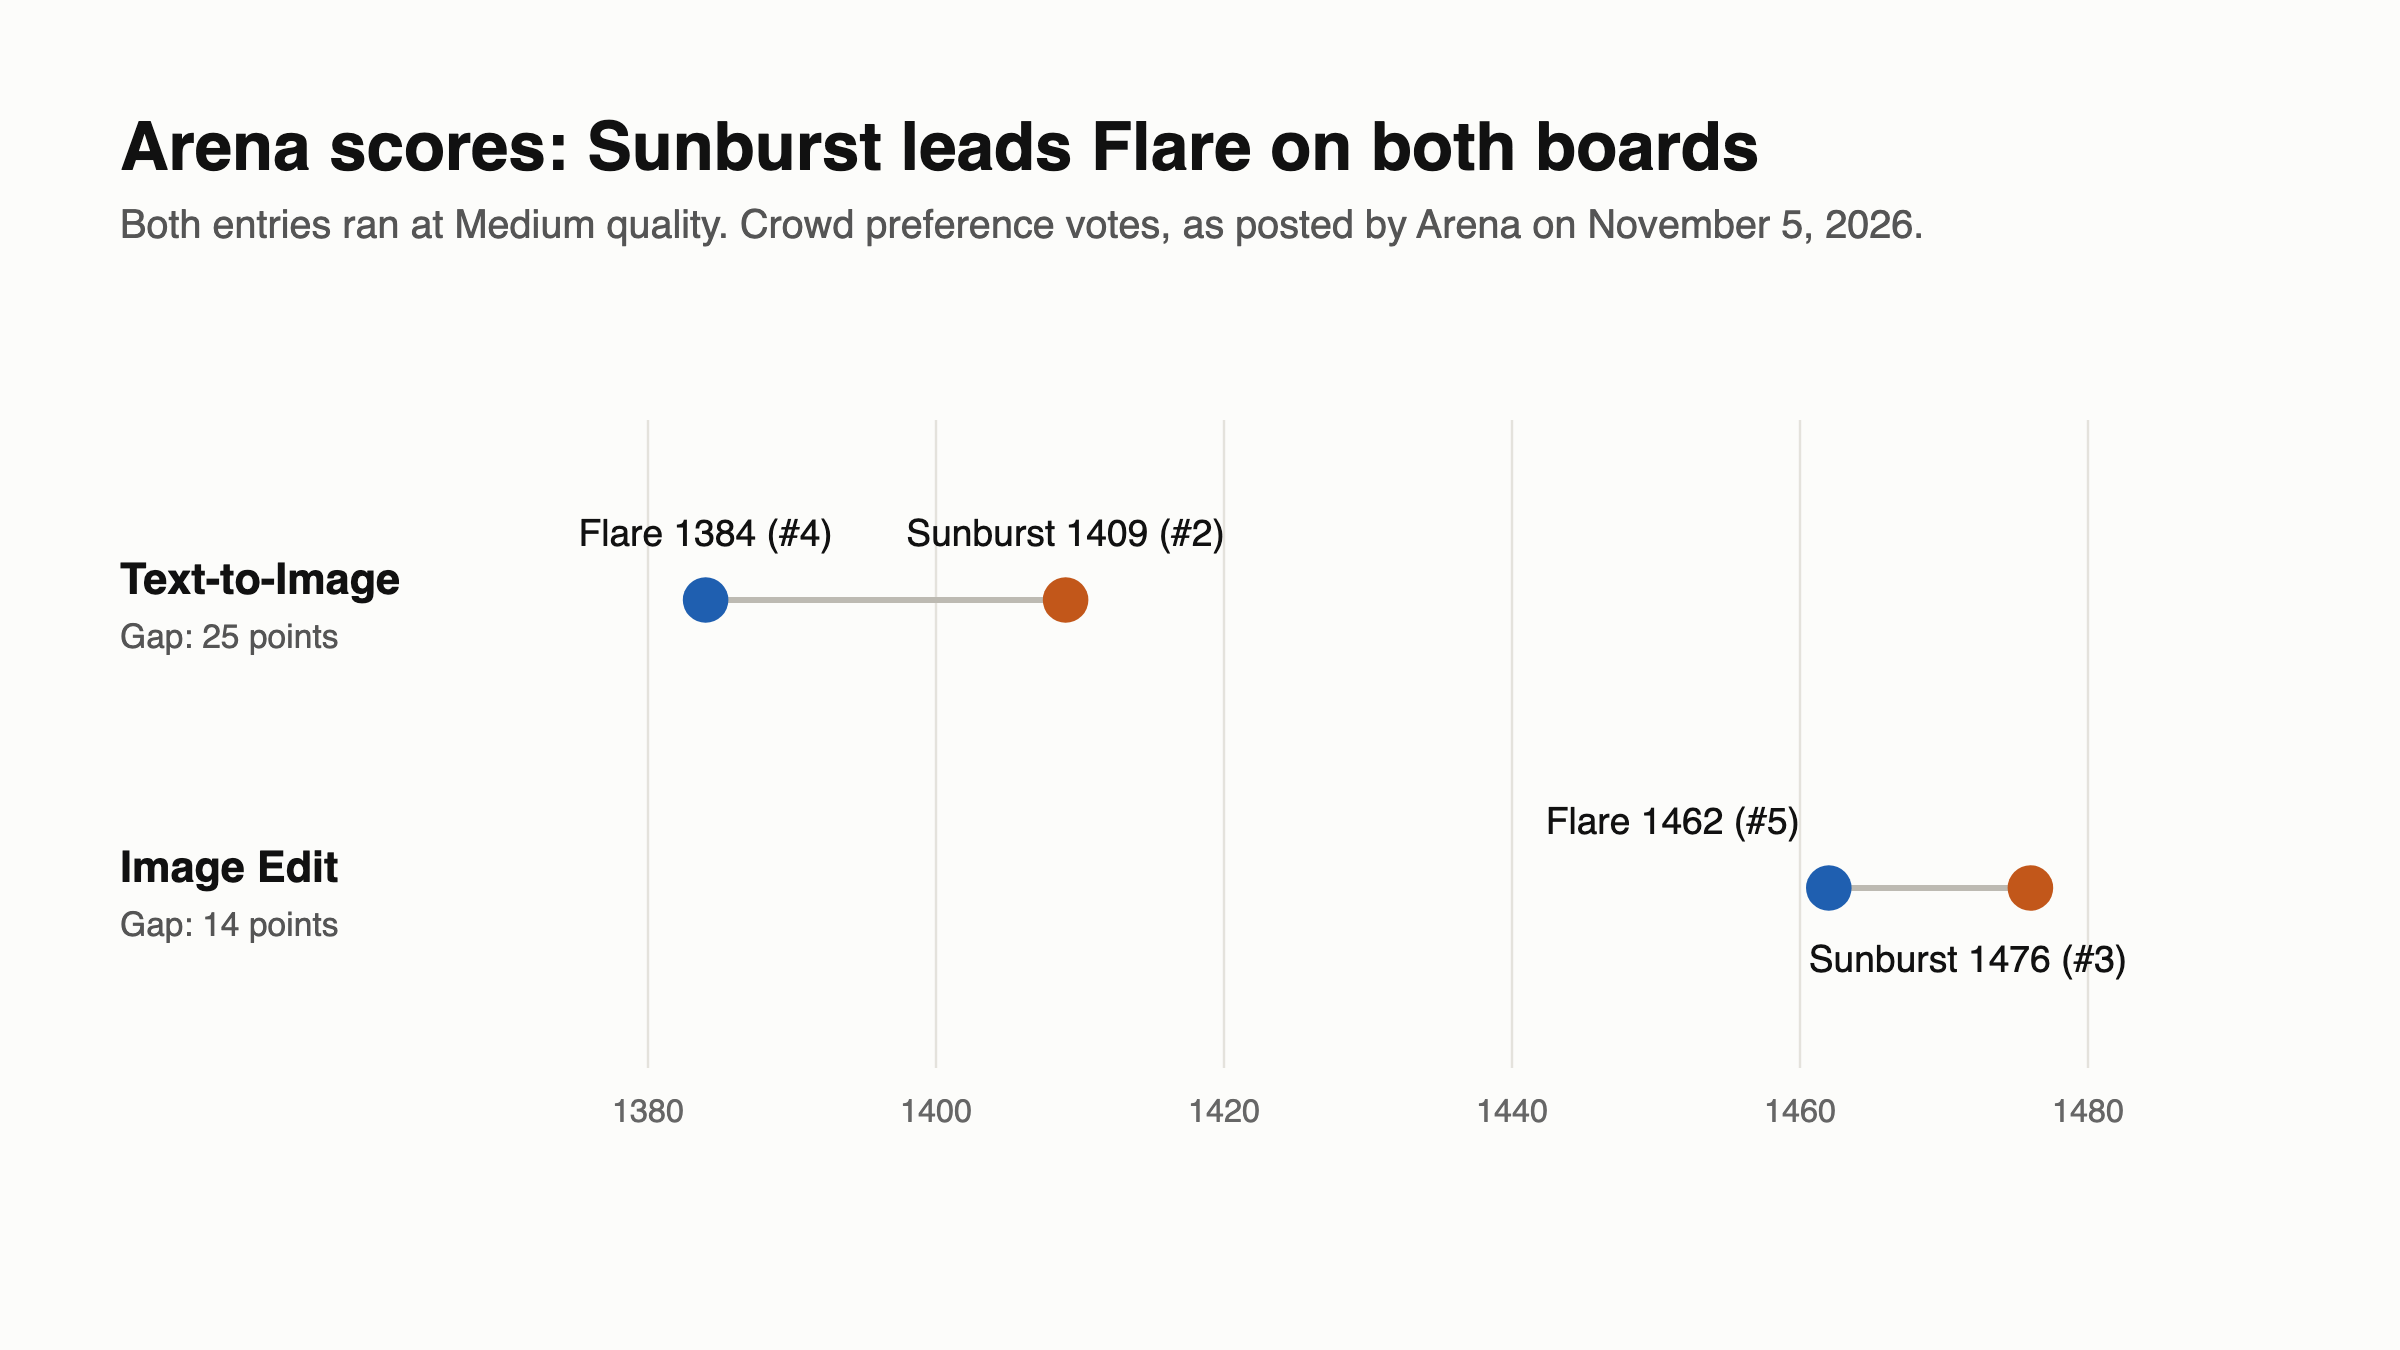
| Text-to-Image Arena (Medium) | #4, 1384 points | #2, 1409 points |
| Image Edit Arena (Medium) | #5, 1462 points | #3, 1476 points |
| Tarif de sortie d'image | 30 $ par million de tokens | 30 $ par million de tokens |
complexity, balisage, SVG, GIF |
Oui | Oui |
Les lignes de fonctionnalités sont identiques. Le guide de génération d'images d'OpenAI indique que les deux modèles prennent en charge le contrôle de la complexité, les retouches guidées par balisage, la sortie SVG et la sortie GIF animé. Vous ne renoncez à aucune capacité, quel que soit le modèle retenu.
Vitesse : Flare l'emporte, mais l'écart n'est pas publié
Flare est le modèle le plus rapide. Le post de lancement d'OpenAI indique qu'il peut générer une image en six secondes seulement en qualité low, et qu'Images 2.6 est 50 % plus rapide qu'auparavant. Aucun temps n'est donné pour Sunburst, et les pages des modèles Flare et Sunburst indiquent toutes deux la vitesse comme « non spécifiée ».
Lisez ce chiffre de six secondes avec attention :
- Il s'agit d'un meilleur cas (« à partir de »), pas d'une moyenne.
- Il ne concerne que la qualité
low. - OpenAI ne précise pas quel réglage
complexityl'a produit, et l'API utilisehighpar défaut.
Nous n'avons trouvé aucun chronométrage indépendant pour la 2.6 à ce jour. Les éléments les plus proches concernent le duo 2.5 : à prendre comme un simple ordre de grandeur.
| Test (modèles 2.5) | Flare | Sunburst | Durée relative de Sunburst |
|---|---|---|---|
| Pixmax, rendu 2048x1152 identique | 19,7 s | 27,7 s | 1,4 fois plus long |
| PoYo, médiane d'un benchmark de 12 requêtes | 30,89 s | 35,06 s | 1,1 fois plus long |
Les deux tests placent Flare en tête, mais ils ne s'accordent pas sur l'ampleur de l'écart. Celui-ci dépend de votre prompt et de vos réglages : un seul benchmark ne suffira donc pas à trancher pour votre charge de travail. Le guide d'OpenAI prévient par ailleurs que les prompts complexes peuvent prendre jusqu'à deux minutes sur les modèles GPT Image ; prévoyez donc un timeout client généreux dans les deux cas.
Qualité : Sunburst devance, de peu
Sunburst obtient un meilleur score dans les deux classements Arena publiés par Arena le 5 novembre, et décroche la première place dans la catégorie Cartoon, Anime et Fantasy. Flare reste malgré tout dans le top 5 des deux classements.
Gardez trois limites à l'esprit en lisant ces scores :
- Ce sont des votes de préférence du public, pas un benchmark d'OpenAI.
- Les deux entrées ont été évaluées en Medium : elles ne disent donc rien des niveaux
lowoumax. - Les scores Arena évoluent au fil des votes. Nous les avons lus dans le post d'Arena, pas sur le tableau en direct.
Une avance de 25 points en Text-to-Image signifie que les votants avaient tendance à préférer les résultats de Sunburst. Cela ne veut pas dire que les images de Flare sont mauvaises. Pour une affiche ou une photo de produit, l'argument d'OpenAI sur la mise en page de Flare peut compter davantage pour vous qu'un score de préférence général : testez donc cette catégorie vous-même.
Cohérence des retouches : l'atout principal de Sunburst
La cohérence des retouches est ce qui justifie le temps d'attente supplémentaire de Sunburst. OpenAI affirme qu'il apporte « une cohérence d'image encore plus grande d'une retouche à l'autre » en qualité medium ou high, un atout précieux lorsqu'un personnage, un produit ou un logo doit rester stable au fil de plusieurs séries de modifications.
Les preuves publiques sont moins nombreuses qu'on pourrait le penser :
- OpenAI ne publie aucune métrique de cohérence.
- La fiche système indique que les deux modèles mis à jour améliorent la cohérence des retouches et la préservation des détails : Flare progresse donc lui aussi.
- L'écart d'Image Edit chez Arena est de 14 points, plus faible que les 25 points d'écart en Text-to-Image. Ce classement note la retouche préférée des votants, pas la stabilité d'un sujet sur cinq tours.
Sunburst est donc le choix par défaut le plus sûr pour les retouches en plusieurs tours, mais seule votre propre chaîne de retouches peut confirmer que le temps supplémentaire en vaut la peine. Pour une modification unique et ciblée, comme remplacer un arrière-plan ou corriger un panneau, essayez d'abord Flare.
Quel que soit le modèle choisi, définissez complexity vous-même. Si vous l'omettez, les deux modèles utilisent high, alors qu'OpenAI recommande low pour la plupart des retouches. Son guide prévient qu'une complexité plus élevée peut ajouter de la latence et introduire des changements non souhaités, soit l'inverse de ce dont un workflow de retouche a besoin.
Coût : le même prix, la qualité est donc le vrai levier
Flare et Sunburst coûtent le même prix. La page de tarification les liste tous les deux à 8 $ par million de tokens d'entrée image, 2 $ en cache et 30 $ en sortie. Le calculateur d'OpenAI les traite d'ailleurs comme une seule entrée, « GPT Image 2.6 (Sunburst and Flare) » : l'estimation de sortie ci-dessous s'applique donc à l'un comme à l'autre.
quality (1024x1024) |
Tokens de sortie | Coût par image | Coût pour 1 000 |
|---|---|---|---|
low |
823 | $0,02469 | $24,69 |
medium |
1 449 | $0,04347 | $43,47 |
high |
1 756 | $0,05268 | $52,68 |
xhigh |
3 122 | $0,09366 | $93,66 |
max |
7 024 | $0,21072 | $210,72 |
Ces chiffres excluent les tokens d'entrée texte et image, et une retouche facture en plus son image de référence. Le calculateur précise que la consommation de tokens peut varier : lisez donc usage.output_tokens dans les réponses réelles.
Deux conclusions découlent de ce tableau :
- Passer de Flare à Sunburst change votre temps, pas votre tarif. Choisir
highplutôt quelowfait à peu près doubler le coût de sortie, sur l'un comme sur l'autre modèle. - Passer de
mediumàhighcoûte environ un centime de plus par image carrée. Comme OpenAI associe les gains de Sunburst à ces deux niveaux, comparez-les avant de vous fixer surmedium.
Le mode Batch est le seul piège côté coût. Le 5 novembre, l'onglet Batch de la page de tarification indiquait la 2.5 à moitié prix, mais aucun des deux modèles 2.6. Si vous lancez des traitements nocturnes sur le duo 2.5, vérifiez cet onglet avant de basculer.
Quel modèle choisir ?
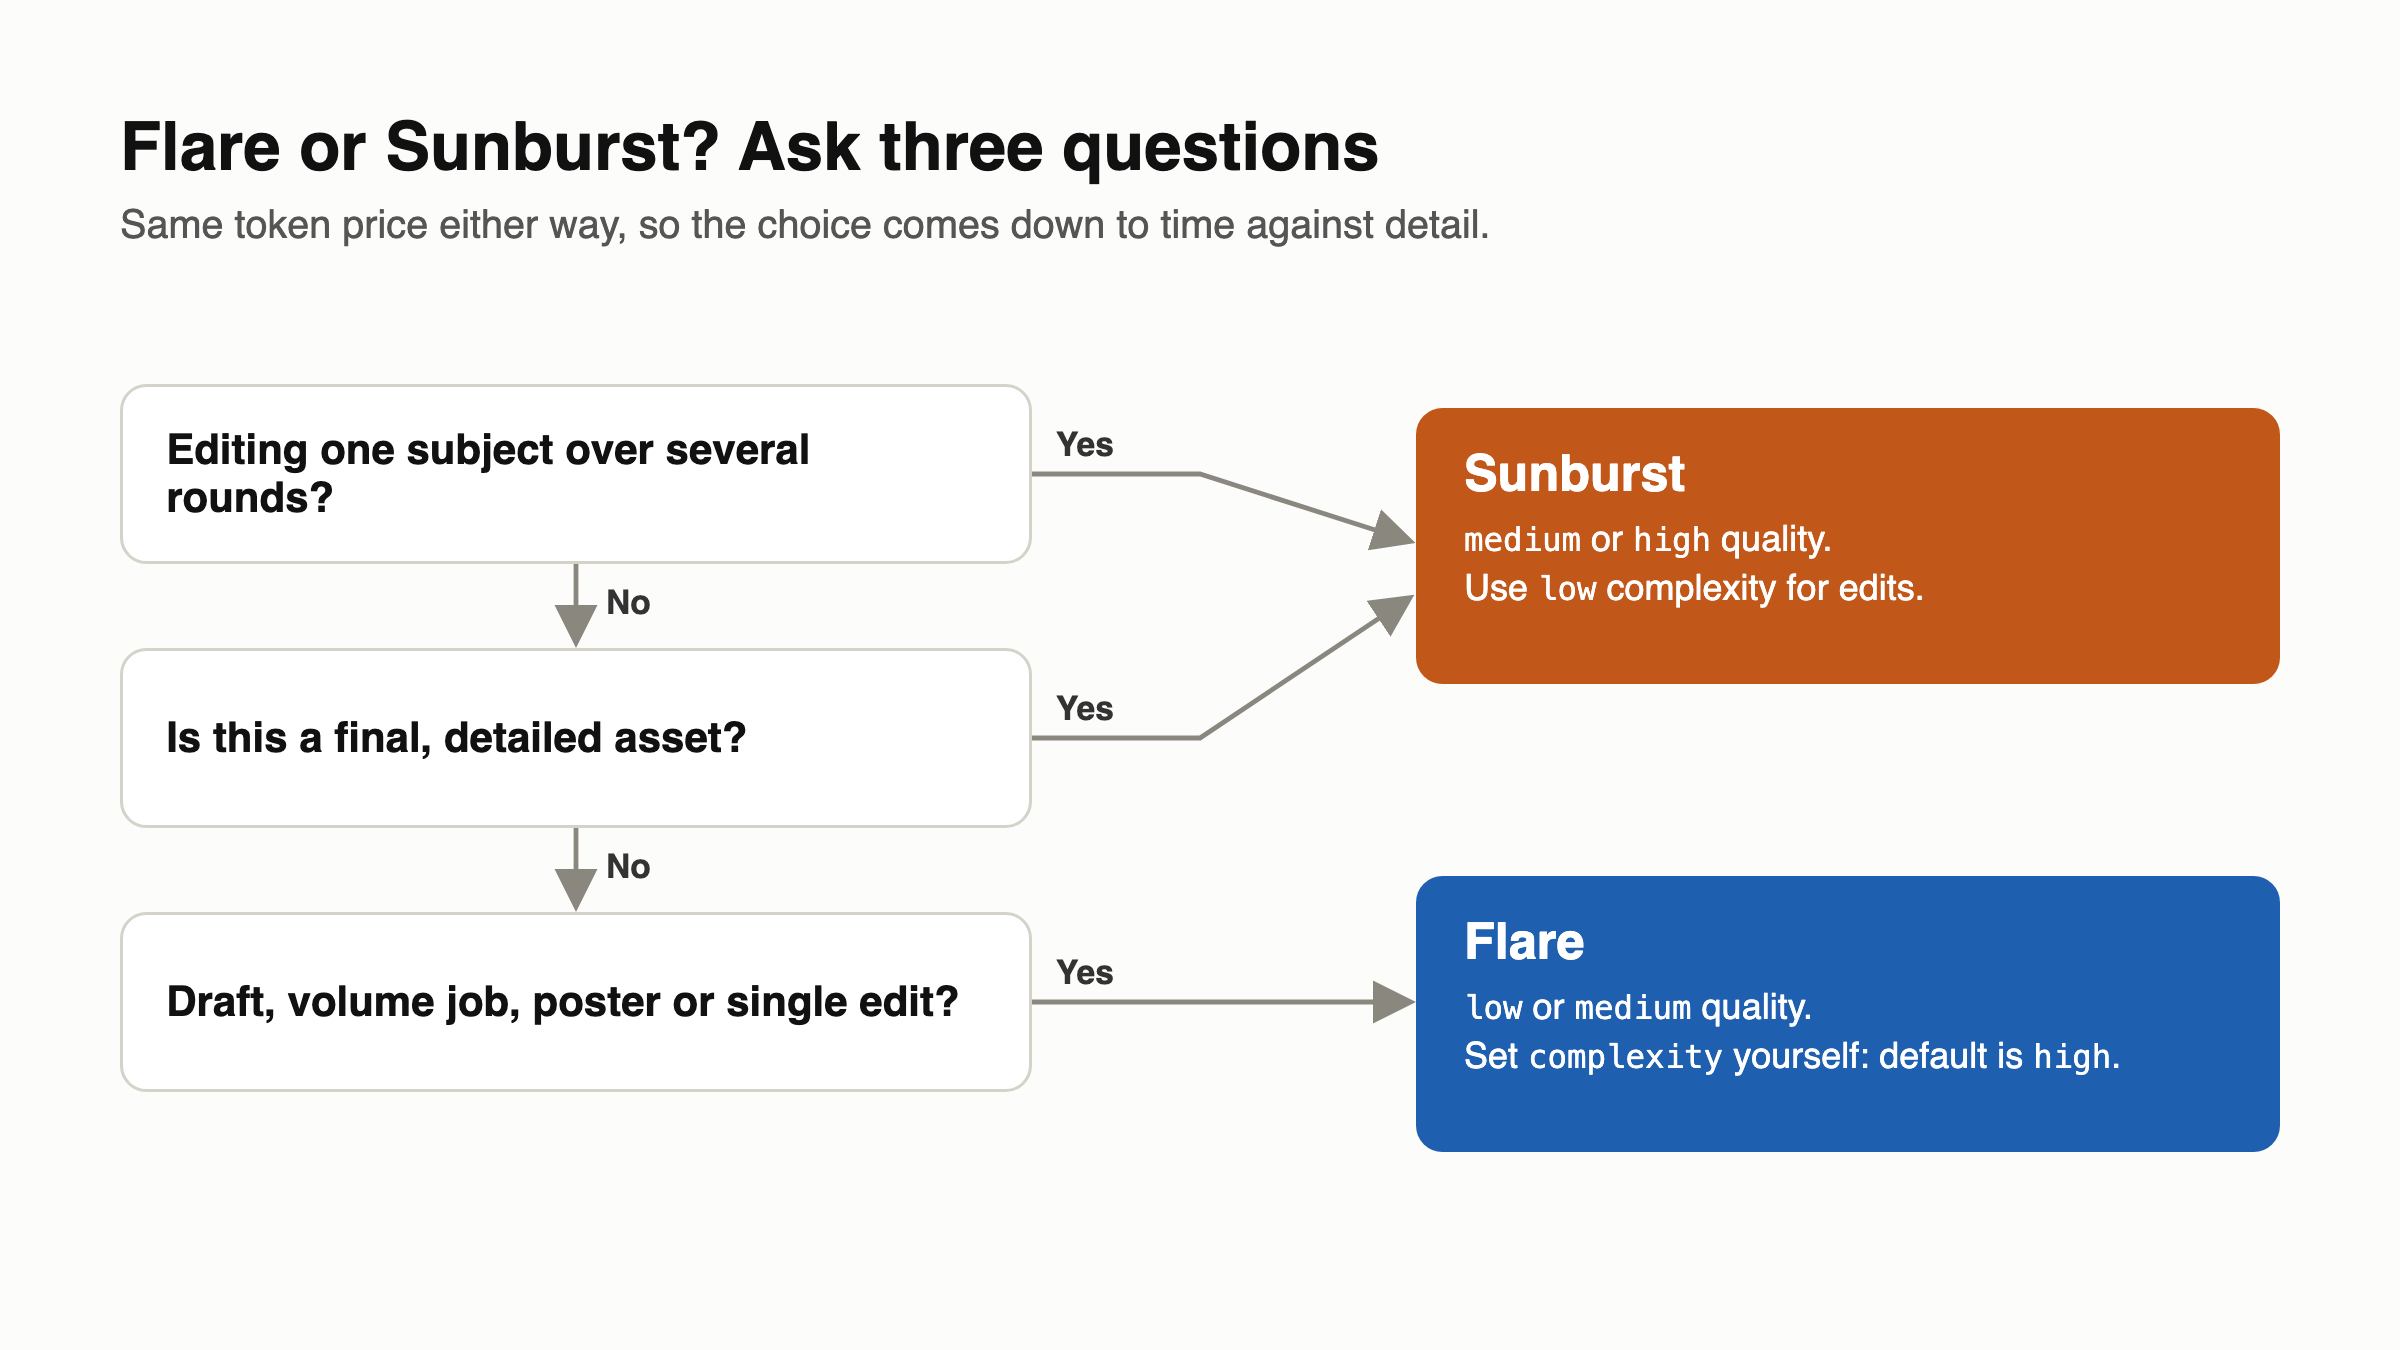
Partez par défaut sur Flare, puis basculez une tâche vers Sunburst dès que la différence est visible. Ces réglages de départ sont nos suggestions, pas celles d'OpenAI : ajustez-les après vos premiers tests.
| Cas d'usage | Choix | quality |
complexity |
|---|---|---|---|
| Brouillons de concept et itération rapide | Flare | low |
low |
| Gros volumes d'images | Flare | low ou medium |
low |
| Affiches et visuels produit | Flare | medium |
medium |
| Une retouche ciblée | Flare | medium |
low |
| Retouches répétées sur un même sujet | Sunburst | medium ou high |
low |
| Images finales hero et de campagne | Sunburst | high |
medium |
| Art cartoon, anime et fantasy | Sunburst | medium |
medium |
| Texte dense, nombreux éléments contraints | Sunburst | high |
high |
Pour le GIF et le SVG, OpenAI ne publie aucune différence de qualité ou de vitesse entre les modèles. Faites vos brouillons sur Flare, puis relancez votre meilleur prompt sur Sunburst et comparez. Vérifiez d'abord deux détails concernant les GIF : le guide d'OpenAI autorise 2 à 64 images, tandis que sa référence API indique 2 à 16 ; et cette référence précise que la sortie GIF nécessite un accès en preview pour le modèle sélectionné.
Si vous épinglez des versions de modèles en production, sachez que les deux pages de modèles n'affichaient que l'alias le 5 novembre, sans snapshot daté. Revérifiez vos prompts validés lorsque OpenAI met à jour un modèle.
Comparez les deux modèles avec Apidog CLI
Les scores publics ne vous diront pas comment chaque modèle se comporte avec vos prompts. Votre agent de codage peut exécuter le même jeu de prompts sur les deux modèles avec Apidog CLI et comparer les temps de réponse. Configuration initiale :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Enregistrez cinq prompts issus de votre charge de travail réelle dans prompts.csv, avec prompt comme en-tête. Donnez ensuite un prompt à Claude Code, Codex ou Cursor :
In Apidog project <id>, add POST https://api.openai.com/v1/images/generations
with a bearer token from ah-96595b54133dd71b741cc9d4907506e2b3a06f289e0016f9de2d7fb43e327968. Create a test case that sends
model {{MODEL}}, prompt {{prompt}}, quality medium, complexity low and size
1024x1024. Assert status 200 and that data[0].b64_json exists.
Run it with prompts.csv once per model, gpt-image-2.6-flare and
gpt-image-2.6-sunburst, then compare the timings in the two JSON reports.
L'agent lit chaque schéma, valide sa charge utile, crée le cas de test, puis l'exécute deux fois :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv \
  --env-var "MODEL=gpt-image-2.6-flare" \
  --env-var "OPENAI_API_KEY=$OPENAI_API_KEY" \
  --timeout-request 180000 --on-error continue -r cli,json --out-file flare
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv \
  --env-var "MODEL=gpt-image-2.6-sunburst" \
  --env-var "OPENAI_API_KEY=$OPENAI_API_KEY" \
  --timeout-request 180000 --on-error continue -r cli,json --out-file sunburst
Chaque rapport JSON stocke les millisecondes sous result.timings, dans responseAverage, responseMin, responseMax et responseSd. Votre agent peut les mettre côte à côte et vous indiquer l'écart réel sur vos prompts. Dix images en medium coûtent environ 0,43 $ en tokens de sortie, plus l'entrée.
Nous avons construit ce flux à partir de apidog --help et des schémas de la CLI, et nous ne l'avons pas exécuté contre OpenAI : vérifiez le premier rapport avant de vous y fier. Apidog mesure la vitesse et la validité des réponses, pas la qualité des images : c'est donc à vous de juger les pixels. Pour continuer à chronométrer le duo après chaque mise à jour de modèle, déplacez l'exécution dans un pipeline CI, et consultez le guide de configuration pour Claude Code pour les détails côté agent.
FAQ
Flare ou Sunburst : lequel est le meilleur ? Aucun ne l'emporte partout. Sunburst est mieux classé dans les tableaux Text-to-Image et Image Edit d'Arena, et OpenAI le destine au travail détaillé. Flare est conçu pour la vitesse. Commencez par Flare et passez à Sunburst dès que le gain est visible.
Sunburst coûte-t-il plus cher que Flare ? Non. Les deux affichent 8 $ en entrée image, 2 $ en cache et 30 $ en sortie par million de tokens, et ils partagent une même entrée dans le calculateur. C'est votre réglage de qualité qui change la facture, pas le choix du modèle.
De combien Flare est-il plus rapide que Sunburst ? OpenAI ne l'a pas précisé. La société ne donne que le meilleur cas de Flare : six secondes en low. Deux tests indépendants sur le duo 2.5 montrent que Sunburst prend environ 1,1 à 1,4 fois plus de temps, mais ces résultats ne sont pas forcément transposables à la 2.6.
Quel modèle est le meilleur pour les retouches ? Utilisez Sunburst pour les retouches répétées sur un même sujet, en qualité medium ou high. Essayez Flare pour une modification ciblée unique. Réglez complexity sur low dans les deux cas, puisque la valeur par défaut est high.
Les deux modèles peuvent-ils produire des GIF et des SVG ? Oui. Le guide d'OpenAI mentionne la sortie GIF et SVG pour les deux modèles sur POST /v1/images/generations. L'endpoint d'édition ne peut renvoyer aucun de ces deux formats.
Faut-il encore utiliser GPT-Image-2.5 ? Vérifiez d'abord le mode Batch. L'onglet Batch indiquait la 2.5 à moitié prix le 5 novembre, mais pas la 2.6. Le calculateur d'OpenAI montre aussi que la 2.6 consomme plus de tokens en low et medium : les gros volumes en low peuvent donc coûter moins cher sur la 2.5.