
OpenAI a lancé ChatGPT Images 2.5 le 8 septembre 2026, avec deux modèles d'API : gpt-image-2.5-flare et gpt-image-2.5-sunburst. Les deux sont facturés aux mêmes tarifs par jeton que gpt-image-2, et les deux partagent une seule entrée dans le calculateur de prix d'OpenAI. Le tableau par jeton ne vous aidera donc pas à choisir. Ce qui a changé, c'est l'échelle de qualité sous-jacente, et le nouveau libellé multiplie le prix d'une image de quality: "high" par environ 4.
Voici la page de décision : tarifs par jeton, estimations par image pour les cinq niveaux de qualité 2.5 à côté des chiffres de gpt-image-2, la nouvelle cartographie des libellés, un budget mensuel de 10 000 images, la rumeur des « tarifs 2x », et une liste de contrôle de migration. Si vous souhaitez d'abord la syntaxe de la requête, lisez comment utiliser l'API gpt-image-2.5. La page de tarification d'OpenAI est la source de tous les tarifs ci-dessous. Chaque chiffre par image est une estimation du calculateur, car OpenAI avertit que la consommation de jetons « peut différer selon le modèle et le réglage de qualité » ; votre facture provient de usage.output_tokens dans la réponse.
Tarifs par jeton : identiques pour les trois
La page de tarification d'OpenAI liste les mêmes tarifs de niveau Standard pour les deux modèles 2.5, et chaque page de modèle indique que ses « tarifs par jeton correspondent à GPT Image 2 ». Voici le tableau complet, y compris la ligne Batch qui a causé de la confusion au lancement.
| Modèle | Entrée d'image | Entrée d'image en cache | Sortie d'image | Entrée de texte | Entrée de texte en cache |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
8,00 $ | 2,00 $ | 30,00 $ | 5,00 $ | 1,25 $ |
gpt-image-2.5-flare |
8,00 $ | 2,00 $ | 30,00 $ | 5,00 $ | 1,25 $ |
gpt-image-2 (Standard) |
8,00 $ | 2,00 $ | 30,00 $ | 5,00 $ | 1,25 $ |
gpt-image-2 (Batch, 50% de réduction) |
4,00 $ | 1,00 $ | 15,00 $ | 2,50 $ | 0,625 $ |
Tous les chiffres sont pour 1 million de jetons. La sortie est uniquement d'image sur chaque modèle ici, donc la sortie de texte n'apparaît jamais sur une facture.
Concernant l'affirmation des « tarifs 2x » dans certaines couvertures initiales : elle provenait de la comparaison de la ligne Standard 2.5 avec la ligne Batch de gpt-image-2, qui représente une réduction de 50 %. Comparez Standard avec Standard sur la page de tarification et chaque tarif reste inchangé.
Ce que coûte chaque image à chaque niveau de qualité
La parité par jeton est la limite de la similarité. Le calculateur d'OpenAI (lu le 09/09/2026) rapporte ces comptes de jetons de sortie d'image sous une entrée partagée unique, « GPT Image 2.5 (Sunburst et Flare) ». Le coût est le nombre de jetons multiplié par 30 $ par million, jetons de sortie uniquement.
| Qualité | Jetons 1024x1024 | Coût 1024x1024 | Jetons 1536x1024 | Coût 1536x1024 |
|---|---|---|---|---|
| low | 196 | 0,00588 $ | 158 | 0,00474 $ |
| medium | 439 | 0,01317 $ | 343 | 0,01029 $ |
| high | 1 756 | 0,05268 $ | 1 372 | 0,04116 $ |
| xhigh | 3 122 | 0,09366 $ | 2 459 | 0,07377 $ |
| max | 7 024 | 0,21072 $ | 5 488 | 0,16464 $ |
Voici le tableau gpt-image-2 de la même page de documentation, pour les mêmes tailles.
| Qualité | 1024x1024 | 1536x1024 (et 1024x1536) |
|---|---|---|
| low | 0,006 $ | 0,005 $ |
| medium | 0,053 $ | 0,041 $ |
| high | 0,211 $ | 0,165 $ |
Deux choses se distinguent. La taille paysage est moins chère que le carré dans chaque ligne, un modèle que la documentation d'OpenAI met en évidence. Et la ligne high de 2.5 est loin de la ligne high de gpt-image-2. C'est le nouveau libellé.
Le texte d'invite et les images de référence sont facturés en plus. Une image de référence envoyée à images/edits coûte des jetons d'entrée d'image à 8 $ par million ; OpenAI ne publie pas le nombre de jetons d'entrée par image, alors lisez-le à partir de usage.input_tokens.
L'échelle de qualité a été renommée
Comparez les budgets de jetons et la correspondance est claire. Sur 2.5, high représente 1 756 jetons de sortie, le budget que gpt-image-2 utilisait pour medium. Sur 2.5, max représente 7 024 jetons, le budget que gpt-image-2 utilisait pour high. low reste inchangé à 196 jetons.
| Libellé 2.5 | Jetons (1024x1024) | Coût 2.5 | Même budget sur gpt-image-2 | Coût gpt-image-2 |
|---|---|---|---|---|
| low | 196 | 0,00588 $ | low | 0,006 $ |
| medium | 439 | 0,01317 $ | aucun (en dessous de l'ancien medium) | n/a |
| high | 1 756 | 0,05268 $ | medium | 0,053 $ |
| xhigh | 3 122 | 0,09366 $ | aucun (entre l'ancien medium et l'ancien high) | n/a |
| max | 7 024 | 0,21072 $ | high | 0,211 $ |
Ainsi, une migration qui conserve quality: "high" devient environ 4 fois moins chère par image et rend au budget de l'ancien medium. Celle qui souhaite l'ancien budget high doit passer à max, pour un prix effectivement identique à l'ancien. xhigh est un nouvel échelon intermédiaire sans équivalent gpt-image-2.
Le calcul mensuel, dérivé des estimations du calculateur d'OpenAI à 1024x1024 :
- 10 000 images en 2.5
high: 10 000 x 0,05268 $ = 526,80 $ - 10 000 images en gpt-image-2
high: 10 000 x 0,211 $ = 2 110 $ - 10 000 images en 2.5
max: 10 000 x 0,21072 $ = 2 107,20 $, effectivement le même prix que l'ancienhigh - Le streaming avec
partial_images: 3ajoute 300 jetons, soit 0,009 $ par image, puisque chaque image partielle coûte 100 jetons de sortie d'image
Flare vs Sunburst : ce que l'offre premium apporte
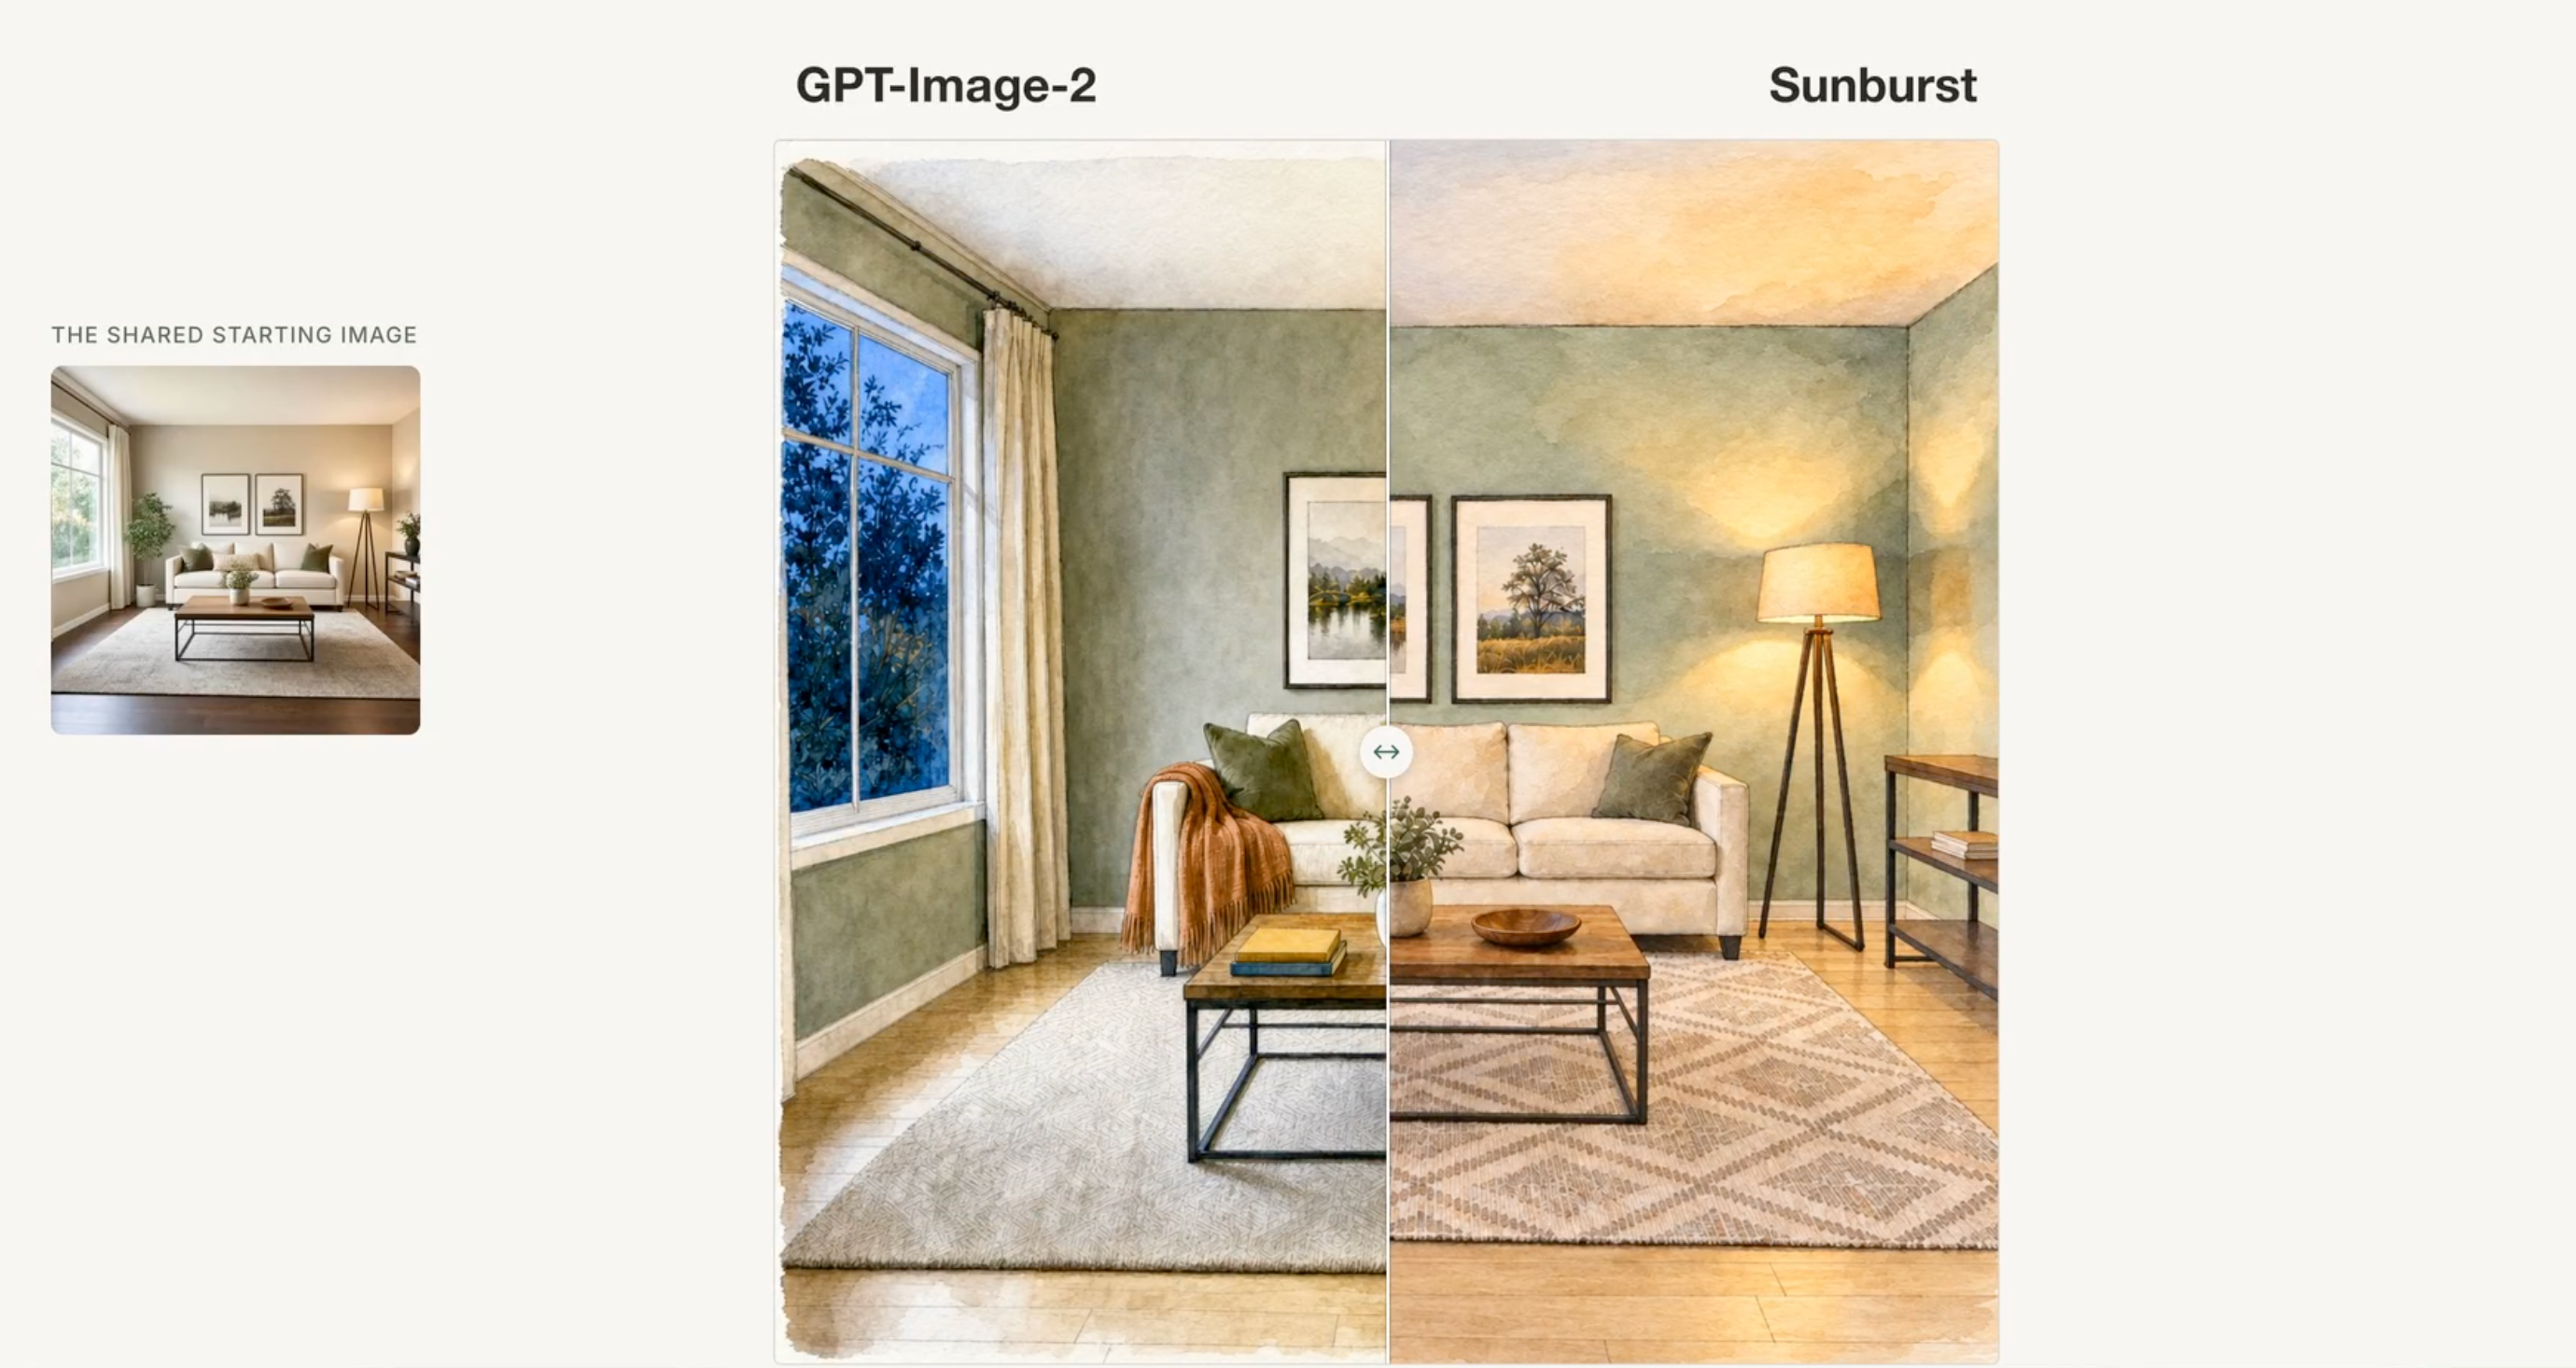
Les deux modèles partagent l'entrée du calculateur, de sorte que les comptes de jetons documentés sont identiques. Sunburst ne coûte pas plus cher par image ; la prime est le temps. Le billet de lancement d'OpenAI cible Flare pour la « génération à grand volume » et Sunburst pour les « flux de travail visuels premium qui bénéficient d'un contrôle plus strict sur les modifications ». La documentation le résume en une ligne : « Choisissez Sunburst pour les flux de travail où la précision de l'édition est primordiale, et Flare pour la génération d'images quotidienne rapide et de haute qualité. »
Signal de la communauté, étiqueté comme tel :
- Dans le fil HN, l'utilisateur jjcm, qui a rapporté environ 50 000 images via gpt-image-2 pour un outil de conception d'interface utilisateur d'IA, a déclaré que la latence moyenne « se maintenait autour de 104s » sur gpt-image-2 et que les images 2.5 « arrivent en environ 35-40s ». Un point de donnée, une charge de travail ; la propre affirmation d'OpenAI est une latence inférieure « jusqu'à 50 % ».
- Le classement texte-vers-image d'Arena (votes de la communauté, mis à jour le 7 septembre 2026) classe Sunburst premier à 1421, Flare deuxième à 1399, gpt-image-2 en medium troisième à 1381, puis mai-image-2.6 de Microsoft à 1331 ; Nano Banana 2 est à 1261. Sur le classement d'édition d'images, l'écart se creuse : Sunburst 1520, Flare 1491, gpt-image-2 1461. Ce sont des scores de préférence du public, pas des benchmarks d'OpenAI.
La règle de décision : par défaut, utilisez Flare. Passez à Sunburst pour les flux de travail d'édition multi-tours où un sujet de référence doit survivre à plusieurs séries d'instructions. L'écart Arena est de 22 points sur le texte-vers-image et de 29 sur les éditions, ce qui étaye l'argument d'OpenAI selon lequel c'est sur les éditions que Sunburst justifie son attente. Si cet écart n'apparaît pas avec vos propres invites, vous payez pour la latence inutilement.
Quand gpt-image-2 reste pertinent
Réductions pour les lots (Batch). L'onglet Batch de la page de tarification ne liste que gpt-image-2, à 15 $ par million de jetons de sortie ; il n'est pas documenté si /v1/batch accepte les identifiants 2.5 au moment de la rédaction. Si votre charge de travail tolère le délai d'exécution de l'API Batch, gpt-image-2 en medium Batch (la moitié de 0,053 $) est plus compétitif que 2.5 high aux tarifs Standard pour le même budget de jetons.
Instantanés épinglés. gpt-image-2-2026-04-21 est livré depuis avril sans avis de dépréciation au 09/09/2026. Si votre pipeline dépend d'une sortie qu'une personne a visuellement examinée, un instantané qui ne change pas est une fonctionnalité ; notre guide de l'API gpt-image-2 couvre ses paramètres. Pour une référence inter-fournisseurs, comparez les tarifs de l'API Nano Banana 2 et l'API FLUX.2 à la même taille de sortie ; 2.5 high à environ cinq cents par image carrée est le chiffre à battre.
Liste de contrôle de migration de gpt-image-2 vers 2.5
- Échangez l'ID du modèle.
gpt-image-2devientgpt-image-2.5-flare(ou-sunburst) ; épinglezgpt-image-2.5-flare-2026-09-08pour une sortie stable. - Re-cartographiez les libellés de qualité. L'ancien
mediumdevient le nouveauhigh, l'ancienhighdevient le nouveaumax,lowrestelow. Faites-le dans la configuration, pas par site d'appel. - Considérez
xhighetmax. Les deux sont nouveaux en 2.5 ;xhighà 3 122 jetons se situe entre les anciens budgets medium et high. - Abandonnez les hypothèses de
thinking. La documentation 2.5 ne décrit pas de paramètrethinking; supprimez-le des modèles au lieu de supposer qu'il est accepté ou ignoré. - Re-mesurez l'utilisation (
usage). Enregistrezusage.output_tokensetusage.input_tokenspendant une semaine de vraies invites ; les chiffres du calculateur sont des estimations. - Vérifiez l'éligibilité Batch. Si vous comptez sur la réduction de 50 % pour les lots (Batch), confirmez que
/v1/batchaccepte les identifiants 2.5 avant de basculer.
Comparez les trois modèles dans Apidog avec une seule requête enregistrée
Apidog est un client API et une plateforme de test. Il envoie la requête images/generations et effectue des assertions sur la réponse ; il ne génère pas d'images ni n'exécute le modèle. Cela en fait l'endroit idéal pour trancher entre Flare, Sunburst et gpt-image-2 avec vos propres invites.
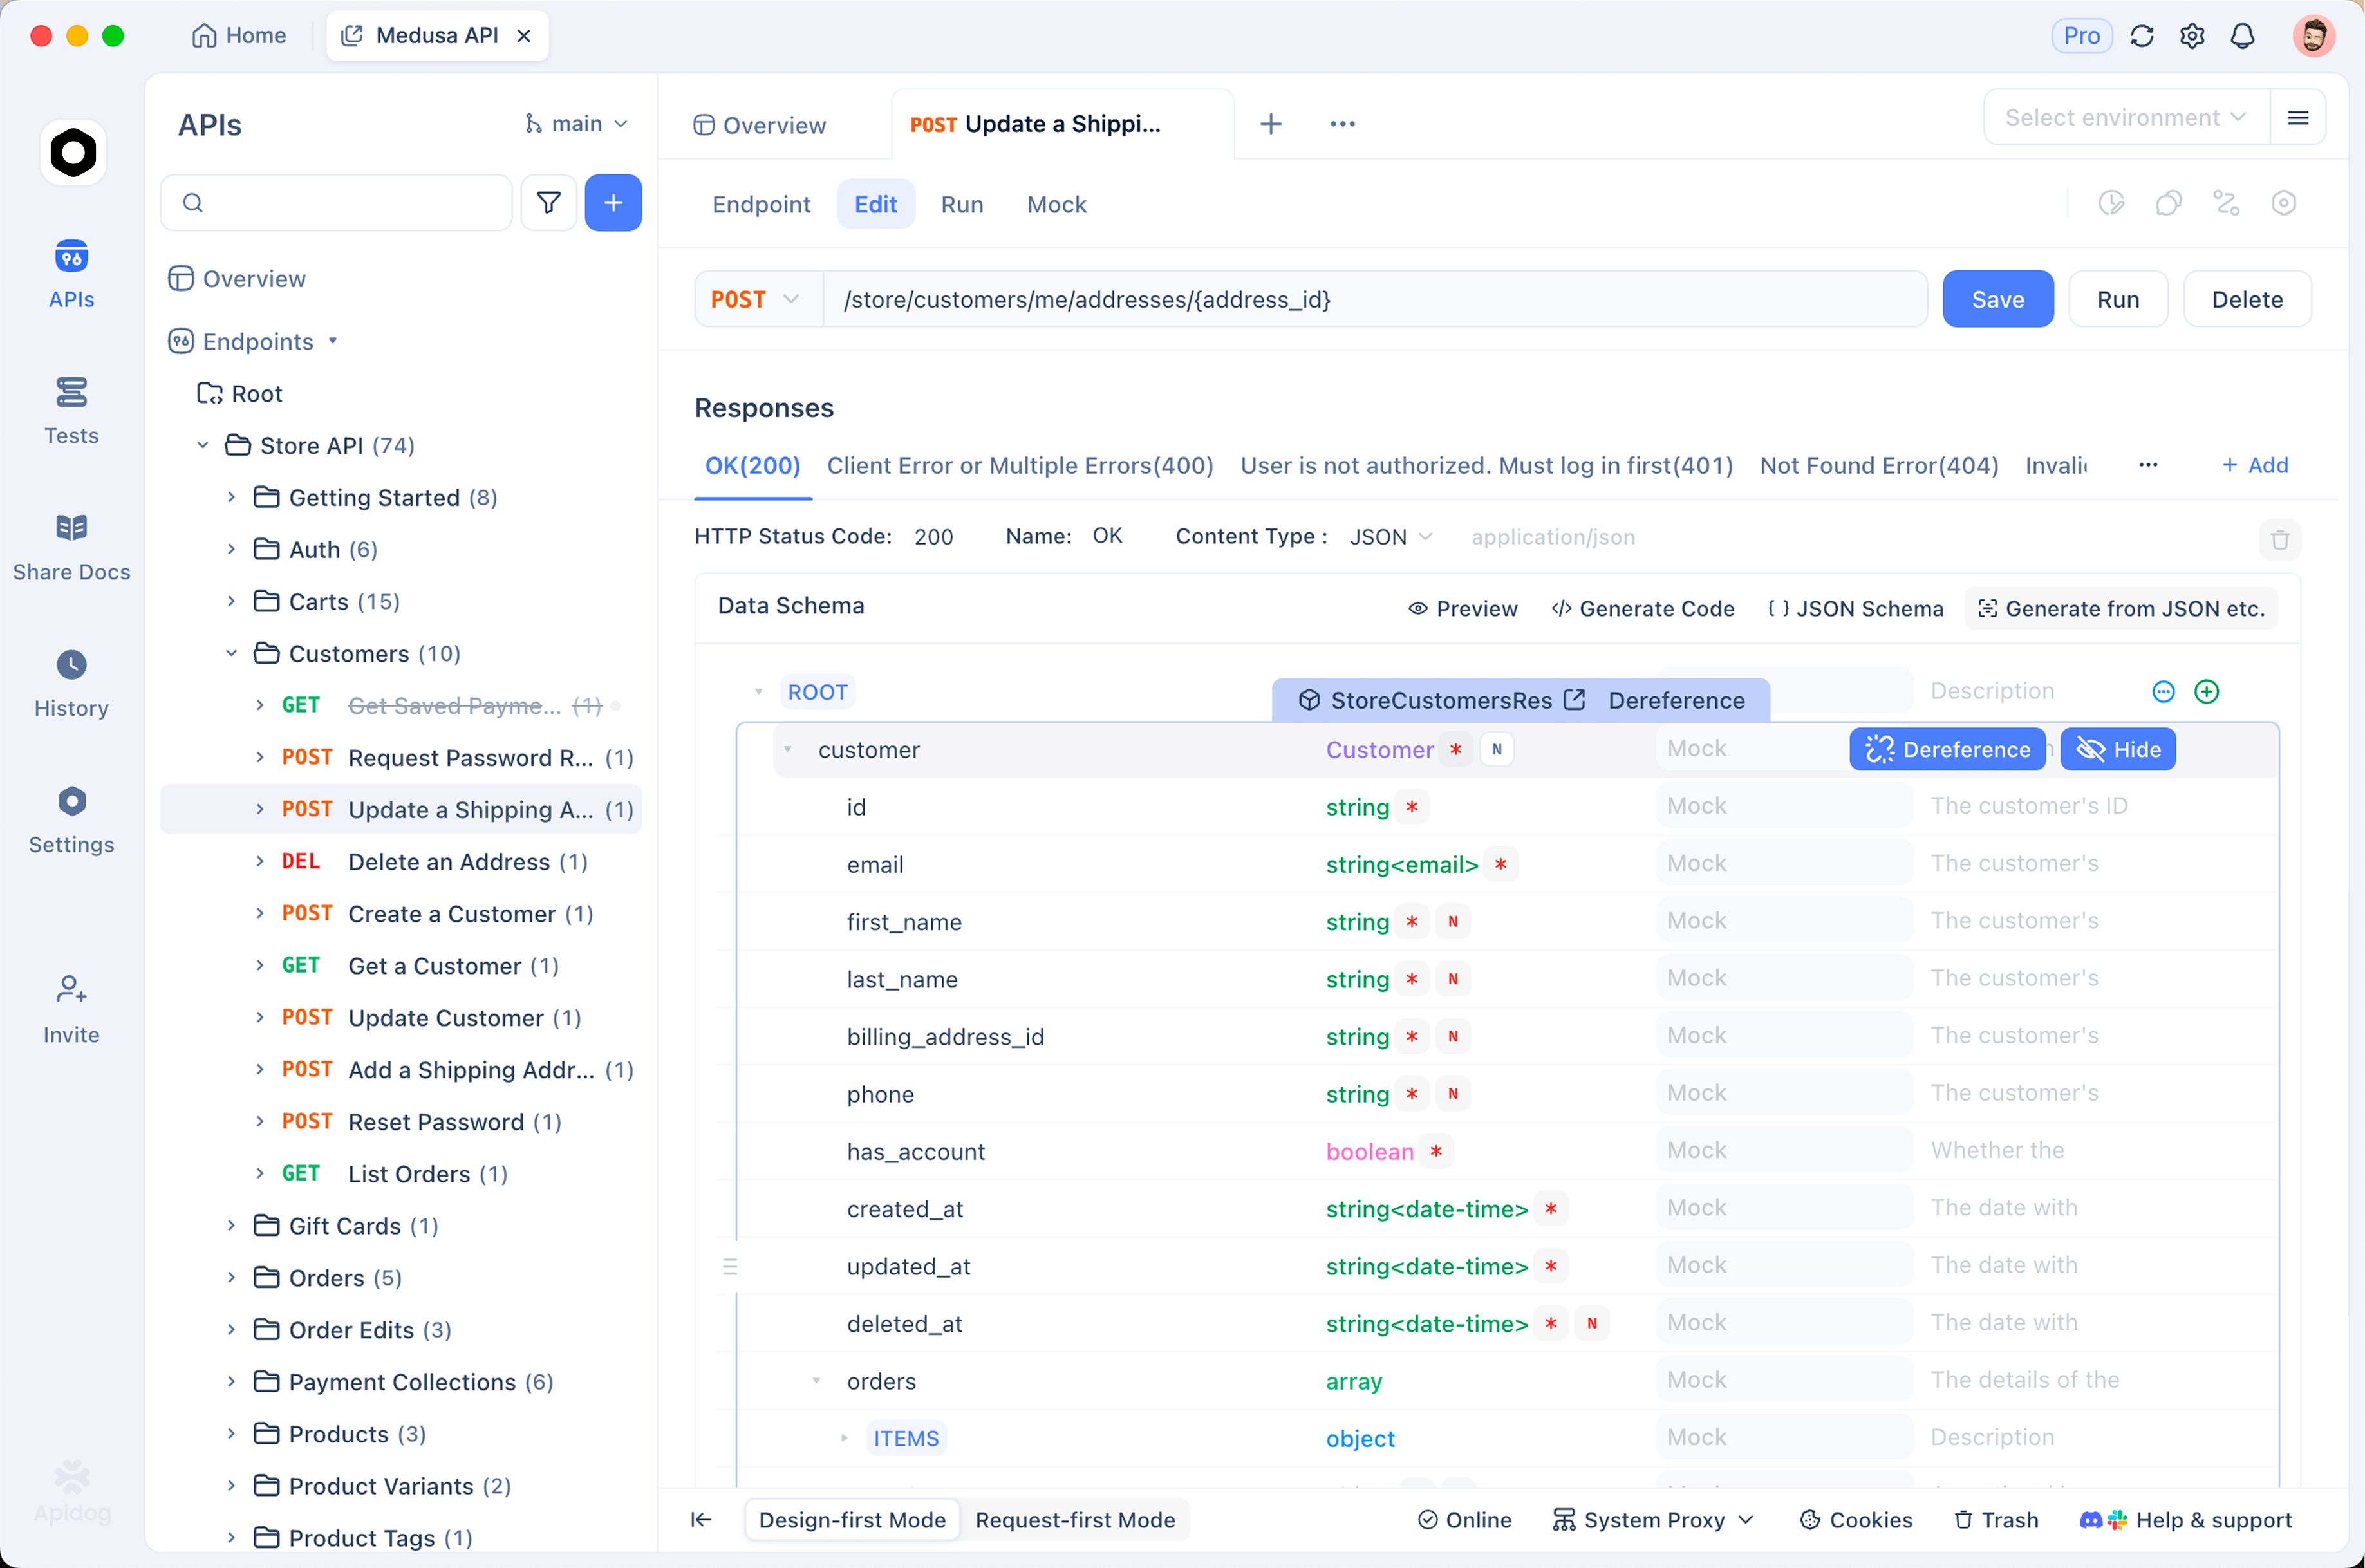
Construisez une requête POST https://api.openai.com/v1/images/generations avec le modèle comme variable, puis créez trois environnements nommés flare, sunburst et gpt-image-2. Chacun définit {{model}} et stocke OPENAI_API_KEY comme variable d'environnement, de sorte que la clé n'apparaisse jamais dans le corps de la requête.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Ajoutez un script de post-traitement qui enregistre les chiffres et fait échouer l'exécution si le budget de jetons est dépassé :
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Exécutez la requête dans chaque environnement. Le temps de réponse d'Apidog est votre nombre de temps réel, last_output_tokens est le nombre mesuré à comparer aux 1 756 du calculateur, et l'écart entre les exécutions Flare et Sunburst est le coût premium de Sunburst pour votre invite. Le même changement d'environnement fonctionne pour l'appel multipart images/edits ; affirmez sur usage.input_tokens pour savoir ce que coûte une photo de référence. Téléchargez Apidog pour effectuer la comparaison avant de modifier le code de production.
FAQ
Est-ce que gpt-image-2.5 est plus cher que gpt-image-2 ? Par jeton, non. Les deux modèles 2.5 et gpt-image-2 Standard sont facturés 30 $ par million de jetons de sortie d'image, 8 $ par million de jetons d'entrée d'image, et 5 $ par million de jetons d'entrée de texte. Par image, une requête 2.5 high coûte environ 0,053 $ en 1024x1024, contre 0,211 $ pour gpt-image-2 high.
Sunburst coûte-t-il plus cher que Flare ? Non. Les deux modèles partagent une seule entrée de calculateur, donc les comptes de jetons documentés sont identiques à chaque niveau de qualité et taille. Le coût premium de Sunburst est un temps de génération plus long, ce qu'OpenAI appelle un « niveau de précision supplémentaire » pour les travaux d'édition intensifs.
Quel paramètre de qualité remplace mon ancien high de gpt-image-2 ? max. Il utilise 7 024 jetons en 1024x1024, le même budget que gpt-image-2 high, et coûte 0,21072 $ selon le calculateur. Laissez high en place et vous obtiendrez l'ancien budget medium à environ un quart du prix. Le billet principal sur ChatGPT Images 2.5 couvre les autres changements.
Existe-t-il un moyen gratuit d'essayer Images 2.5 avant de payer pour l'API ? Oui. Le modèle est disponible sur chaque niveau de ChatGPT avec des plafonds de génération par forfait, abordés dans comment utiliser ChatGPT Images 2.5 gratuitement. L'API n'a pas de niveau gratuit pour les points de terminaison d'image ; la qualité low à environ 0,006 $ par image carrée est le chemin réel le moins cher.
Quel modèle choisir
Flare pour tout ce qui est à grand volume ou sensible à la latence, en high pour la plupart des travaux et en max lorsque l'aspect high de l'ancien gpt-image-2 est une exigence. Sunburst pour les éditions multi-tours où un sujet de référence doit survivre, après une comparaison côte à côte sur vos invites ; gpt-image-2 pour les tâches Batch et les pipelines épinglés que vous n'êtes pas prêt à réviser. Quoi que vous choisissiez, lisez usage.output_tokens des réponses réelles ; trois environnements dans Apidog et une requête enregistrée vous donneront ce chiffre en un après-midi.
button