
Non. GPT-6 Sol n'est gratuit sur aucune surface lancée par OpenAI. La phrase de disponibilité dans l'annonce d'OpenAI est sans ambiguïté : Sol et Luna sont dans ChatGPT Work et Codex pour les utilisateurs Plus, Pro, Business, Enterprise et Edu, et les utilisateurs Free et Go peuvent accéder à GPT-6 Luna dans l'application de bureau. Sol est absent de cette offre gratuite. Aucun des deux modèles n'est encore dans Chat. Sur l'API, gpt-6-sol est facturé à l'utilisation à 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie.
Voici la partie qui vaut votre temps. Il existe un modèle GPT-6 véritablement gratuit, lancé le même jour, et pour une grande partie de ce que les gens recherchent avec Sol, c'est la réponse honnête. GPT-6 Luna fonctionne gratuitement dans l'application de bureau pour les comptes Free et Go, et ce n'est pas un jouet : contexte de 1 million de tokens, et 66,6 % sur DeepSWE 1.1 à effort maximal contre 68,8 % pour Sol. Si vous êtes arrivé ici parce que vous vouliez un travail de pointe sans abonnement, allez-y d'abord. Nous avons détaillé cette voie séparément dans comment utiliser GPT-6 Luna gratuitement.
Cet article couvre les trois choses qui sont réellement vraies : qui obtient Sol et comment, quelles sont les voies gratuites existantes et leurs limites, et à quoi ressemble le chemin payant le moins cher vers gpt-6-sol une fois que vous acceptez de le payer.
Qui obtient GPT-6 Sol, en un coup d'œil
| Surface | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| ChatGPT Free | Non | Oui, application de bureau |
| ChatGPT Go | Non | Oui, application de bureau |
| ChatGPT Plus, Pro, Business, Enterprise, Edu | Oui, dans Work et Codex | Oui, dans Work et Codex |
| Chat | Pas encore | Pas encore |
| API | Paiement à l'usage, gpt-6-sol |
Paiement à l'usage, gpt-6-luna |
Deux détails de ce tableau sont constamment mal interprétés. Premièrement, « dans l'application de bureau » est une réelle limite pour la voie gratuite de Luna, et non un remplissage marketing. Deuxièmement, Work et Codex sont les lieux d'accès payant, donc un abonnement Plus ne place pas Sol dans l'interface de Chat à laquelle vous êtes peut-être habitué.
La voie gratuite qui existe réellement
GPT-6 Luna coûte 0,10 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie sur l'API, et absolument rien dans l'application de bureau pour les comptes Free et Go. Son score à l'Artificial Analysis Intelligence Index est de 37 contre 48 pour Sol, c'est donc un cran en dessous, mais regardez où se situe ce cran. Sur DeepSWE 1.1 à effort maximal, Luna obtient un score de 66,6 %, ce qu'OpenAI décrit comme comparable à Claude Opus 5 et Claude Fable 5 à effort moyen, à 93 % de moins par tâche qu'Opus 5 et 96 % de moins que Fable 5. Sur OSWorld 2.0 hors ligne, Luna au maximum bat GPT-5.6 Sol au moyen pour environ un dixième du coût. En matière de factualité, Luna à effort plus élevé égale GPT-5.6 Sol pour environ un centième du coût.
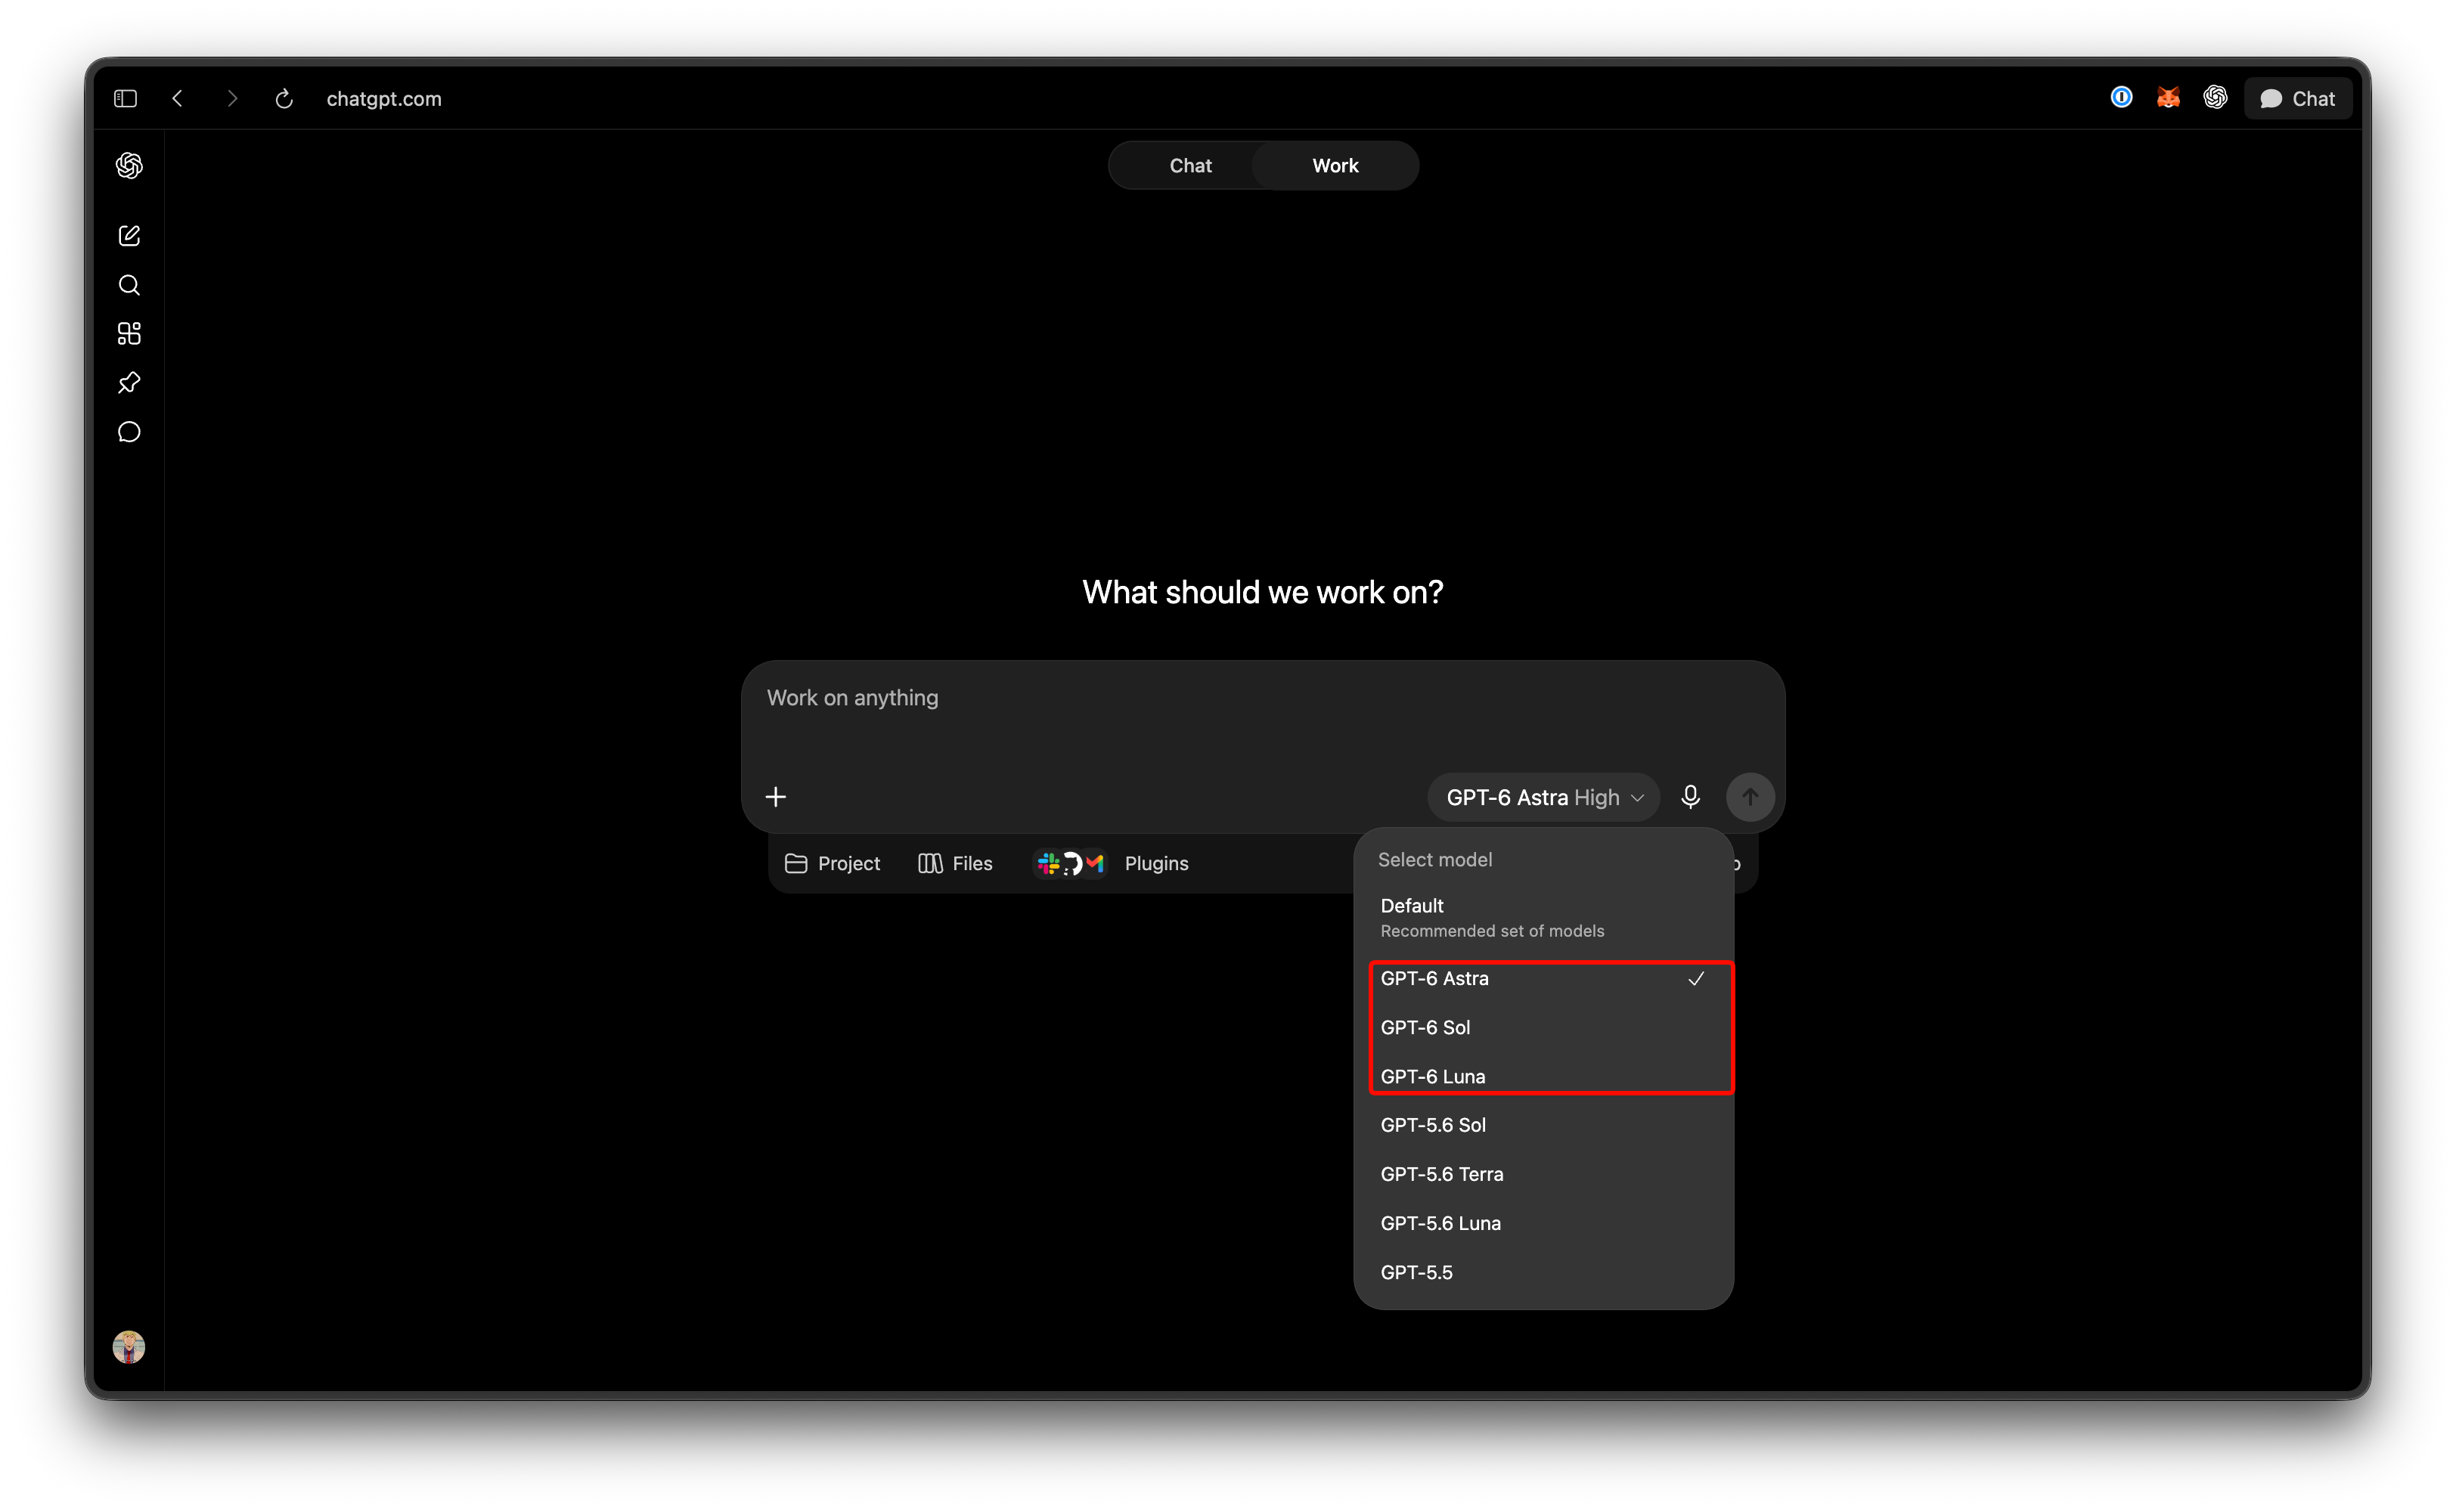
Soyez précis sur ce que couvre la partie gratuite de cette phrase. L'accès Free et Go correspond à l'utilisation interactive de Luna au sein de l'application de bureau ChatGPT. Ce n'est pas une clé API et ne peut pas piloter un script, une tâche de CI ou l'exécution d'un agent automatisé. Tout ce qui est programmatique passe par l'API aux tarifs de Luna de 0,10 $ et 0,50 $, ce qui est bon marché mais pas gratuit.
Lisez ceci comme un guide d'achat plutôt qu'un tableau de score. Si votre travail consiste en des modifications de code, des boucles agentiques sur un dépôt, du traitement de documents, de la classification, ou toute autre tâche que vous auriez auparavant confiée à un modèle de milieu de gamme, Luna n'est pas un compromis dont vous devez vous excuser. Sol justifie son prix pour les tâches plus complexes : 33,2 % sur AutomationBench 1.0.6 à effort très élevé, 56,4 % sur Agents’ Last Exam V1 au maximum, et environ la moitié des erreurs factuelles de son prédécesseur.
Les fiches techniques complètes se trouvent dans qu'est-ce que GPT-6 Sol et qu'est-ce que GPT-6 Luna, et la décision de niveau sur le coût par tâche est dans Luna vs Sol vs Astra.
Crédits promotionnels API et cloud
La deuxième voie gratuite honnête est celle des crédits, avec une propriété que vous devriez intérioriser avant de planifier autour d'elle : un solde de crédits diminue puis s'arrête. C'est un essai, pas un niveau.
- Crédits de nouveau compte API OpenAI. Les nouveaux comptes démarrent généralement avec un petit solde, suffisant pour confirmer le fonctionnement d'une intégration et mesurer le nombre réel de tokens avant d'associer une carte bancaire.
- Crédits promotionnels cloud. Les nouveaux comptes sur les principales plateformes cloud incluent souvent des crédits promotionnels utilisables pour l'utilisation des modèles. Avant de planifier cela, vérifiez si la plateforme que vous utilisez propose
gpt-6-sol: les surfaces de lancement que nous pouvons identifier sont l'API d'OpenAI, ChatGPT Work et Codex, et non un cloud tiers. Lisez également directement les conditions actuelles de chaque plateforme, car les montants et les règles d'éligibilité changent si souvent que tout chiffre imprimé ici serait obsolète en quelques semaines.
Dépensez ces crédits pour la mesure, pas pour le trafic de production. Exécutez vos requêtes réelles, lisez le bloc usage de chaque réponse, et vous connaîtrez votre propre coût par tâche avant d'engager un budget. Cela vaut plus que les crédits eux-mêmes.
Il n'y a pas de voie gratuite illimitée vers gpt-6-sol
Il est bon de le dire clairement, car cette question attire des réponses malhonnêtes. Aucun niveau gratuit de l'API OpenAI ne vous donne des appels gpt-6-sol illimités. Aucun proxy, pool de clés ou revendeur n'accorde légitimement un accès gratuit à un modèle de pointe. Ces stratagèmes enfreignent les conditions du fournisseur, sont révoqués et acheminent vos requêtes via une infrastructure que vous ne contrôlez pas. Une fois les crédits d'essai ou promotionnels dépensés, vous payez par token ou vous arrêtez.
Le chemin payant le moins cher
Le tarif de base est de 2 $ d'entrée et 10 $ de sortie par million de tokens. OpenAI le décrit comme 50 % moins cher que GPT-5.6, et le qualificatif dans leur propre formulation est important : c'est 50 % moins cher que le prix promotionnel de GPT-5.6, et non le prix catalogue. Les leviers ci-dessous réduisent la facture bien plus que le titre ne le suggère.
Levier 1 : la mise en cache, la plus grande réduction unique
GPT-6 a été lancé avec une véritable version de mise en cache des invites. Les lectures d'entrée mises en cache bénéficient d'une réduction de 90 %, ce qui ramène le taux d'entrée effectif de Sol à 0,20 $ par million de tokens sur la partie mise en cache d'une invite. C'est une réduction plus importante que la baisse de prix dont tout le monde a parlé.
Trois choses ont changé avec la réduction, et chacune élimine une raison pour laquelle les caches manquaient auparavant :
- Les taux de succès sont plus élevés par défaut.
- Le changement d'effort de raisonnement ou de disponibilité des outils n'invalide plus le cache, de sorte qu'un agent qui change d'effort en cours d'exécution conserve son préfixe.
- Les points d'arrêt explicites vous permettent de choisir où un préfixe mis en cache se termine, au lieu d'espérer que le fournisseur choisira la même limite que vous.
Il existe également un tableau de bord de mise en cache et un outil de diagnostic, de sorte que le taux de succès est désormais quelque chose que vous observez plutôt que d'inférer. GitHub rapporte plus de 50 % de tokens d'invite en moins nécessitant un traitement frais sur des milliards de requêtes. Une lacune à respecter : nos sources n'indiquent pas de taux d'écriture du cache pour GPT-6, ne modélisez donc pas les écritures comme gratuites. Les mécanismes sont décrits dans la mise en cache des invites de GPT-6.
Levier 2 : l'effort de raisonnement, le véritable axe de coût
Chaque ligne de référence publiée par OpenAI associe un score à un niveau d'effort, et ce n'est pas une décoration. L'effort échange des tokens contre de la précision, et les tokens représentent la facture. Sol à xhigh obtient 33,2 % sur AutomationBench à 0,27 $ par tâche ; le même modèle à un effort inférieur coûte moins cher et obtient un score inférieur. Un réglage moins cher qui nécessite trois tentatives n'est pas moins cher, donc la seule façon de choisir correctement est d'exécuter votre propre évaluation à deux réglages et de comparer le coût par tâche accomplie, et non le coût par appel.
Levier 3 : les tokens de sortie, facturés cinq fois plus que les tokens d'entrée
À 2 $ d'entrée et 10 $ de sortie, une réponse vaut cinq tokens d'entrée par token de sortie. Les réponses longues et bavardes transforment les petites factures en grandes. Demandez la forme que vous souhaitez, limitez la réponse là où la tâche le permet, et préférez une sortie structurée à de la prose lorsqu'une machine lit le résultat.
Ce qu'un petit solde de crédits achète réellement
Voici l'arithmétique, effectuée sur les tarifs ci-dessus plutôt que sur ce qu'OpenAI a imprimé. Prenons une étape d'agent ordinaire : une invite de 40 000 tokens et une complétion de 2 000 tokens.
| Configuration | Coût par appel | Appels pour 5 $ de crédit |
|---|---|---|
| GPT-6 Sol, sans cache | $0.100 | 50 |
| GPT-6 Sol, 32k de l'invite mise en cache | $0.042 | 118 |
| GPT-6 Luna, sans cache | $0.005 | 1 000 |
| GPT-6 Luna, 32k de l'invite mise en cache | $0.0021 | 2 358 |
La ligne Sol mise en cache correspond à 32 000 tokens à 0,20 $ par million plus 8 000 à 2,00 $ plus 2 000 tokens de sortie à 10,00 $. La mise en cache fait plus que doubler ce qu'un solde fixe peut acheter, et le déplacement de la même charge de travail vers Luna la multiplie par vingt.
Pour le travail d'agent, l'unité est encore différente. Sol à effort très élevé coûte 0,27 $ par tâche sur le banc de test AutomationBench d'OpenAI, donc un solde de 5 $ correspond à environ dix-huit tâches de cette forme avant qu'il ne s'épuise. C'est suffisant pour mesurer, mais loin d'être suffisant pour fonctionner en production, ce qui est précisément l'intérêt d'un solde d'essai.
Pour le contexte d'échelle, OpenAI a révélé que son chercheur interne médian dépense plus de 600 $ par jour pour des agents de codage, le 90e centile atteignant 7 000 $ par jour. Ces tarifs ont été conçus pour ce type d'utilisation, et non pour un niveau gratuit.
Le chemin bon marché n'est pas le chemin rapide
Un compromis sous-tend tout cela. Artificial Analysis, un tiers plutôt que le fournisseur, mesure la variante de raisonnement maximale de GPT-6 Sol à 115,2 tokens de sortie par seconde avec un temps de première token de 102,15 secondes, et la variante maximale de Luna à 153,9 tokens par seconde avec 124,23 secondes pour la première token. [VÉRIFIER] Un effort élevé signifie une longue pause silencieuse avant que quoi que ce soit n'arrive. Si un utilisateur attend, ou si un élément en aval a un délai d'attente, réduisez le niveau d'effort ou choisissez un niveau différent. Nous détaillons cela dans la latence de GPT-6 Sol.
Mesurez-le avant de le budgétiser
Les tableaux de coûts des fournisseurs sont mesurés sur des bancs d'essai de fournisseurs par rapport à des charges de travail de fournisseurs, et les vôtres différeront. Quatre vérifications méritent d'être effectuées avant que tout cela ne devienne un chiffre dans un tableur :
- Envoyez de véritables invites de production et lisez la section
usagede la réponse plutôt que d'estimer à partir du nombre de caractères. - Exécutez la même invite avec
gpt-6-soletgpt-6-lunaet comparez le coût par tâche accomplie, et non par appel. La ligne Luna ci-dessus n'est une économie que si la réponse est suffisamment bonne. - Exécutez deux niveaux d'effort et enregistrez les tokens et le temps réel pour les deux.
- Mesurez séparément les cas avec et sans cache. Une réduction de 90 % sur la mauvaise moitié d'une invite a très peu de valeur.
C'est un test de requête HTTP ordinaire. Construisez les appels, enregistrez les variantes Sol et Luna comme des requêtes séparées, vérifiez la forme de la réponse et observez les temps dans Apidog plutôt que dans un script de brouillon que vous jetterez. Conservée comme une collection enregistrée, la comparaison se réexécutera d'elle-même la prochaine fois qu'un prix changera, ce qui, d'après les preuves actuelles, sera bientôt.
La version courte
GPT-6 Sol n'est pas gratuit, et aucun article honnête ne peut vous dire le contraire. Les comptes Free et Go bénéficient de GPT-6 Luna dans l'application de bureau, ce qui est la vraie réponse pour la plupart des gens qui sont venus ici en chercher une. Les crédits d'essai et promotionnels cloud vous permettront de mesurer, pas de produire. Et si vous payez, la réduction de 90 % sur les lectures mises en cache et un niveau d'effort correctement choisi feront plus pour votre facture que la baisse de prix au lancement.
La place de ceci dans une semaine qui a également apporté Claude Opus 5.5 est couverte dans la guerre des prix des modèles IA de septembre 2026, et la répartition complète des tarifs est dans la tarification de GPT-6 Sol.