
GPT-6 Astra est sorti depuis près de deux jours. Nous n'avons délibérément rien écrit à ce sujet. Chaque lancement de modèle arrive désormais avec un tableau de performances, une vague de réactions immédiates, et une douzaine d'explications rédigées avant même que quiconque en dehors des partenaires de lancement n'ait envoyé une seule requête. Nous voulions l'exécuter nous-mêmes avant d'ajouter à ce tas. Alors nous avons attendu. Nous avons testé. Et voici le verdict, sans les habituelles précautions : c'est absolument époustouflant. C'est probablement le meilleur modèle que notre équipe ait jamais testé. L'AGI est là.
Cette dernière phrase va en agacer certains, c'est pourquoi le reste de cet article en est la preuve. Ce que nous avons exécuté, ce qui nous a surpris, ce qui a échoué et ce que cela coûte. Si vous préférez la fiche technique, notre guide API de GPT-6 Astra contient l'ID du modèle, le tableau des prix et les notes de migration depuis GPT-5.6 Sol. Cet article porte sur ce que cela a fait de travailler avec la chose.
Jeudi soir : la première requête
L'accès a été accordé tard le jeudi 3 septembre, le jour même où OpenAI a annoncé Astra à un ensemble limité d'organisations. La première chose que nous avons faite a été le test le moins imaginatif auquel nous ayons pu penser : nous lui avons donné une spécification OpenAPI. Pas un jouet. Une spécification de 140 points de terminaison pour un service interne, environ 380 000 jetons de JSON une fois les schémas comptés, envoyée via l'API Responses en une seule requête depuis Apidog.
GPT-5.6 Sol gère un fichier de cette taille, mais on le sent travailler. Il perd le fil sur les schémas plus complexes et commence à répondre à des questions sur des points de terminaison qui n'existent pas. Astra ne l'a pas fait. Nous lui avons demandé de construire un plan de test : quels points de terminaison dépendent de quels autres, où se trouvent les limites d'authentification, où la spécification et l'implémentation sont probablement en désaccord. Il est revenu avec un plan regroupé par ressource, a signalé trois points de terminaison où la réponse d'erreur documentée ne correspondait pas au schéma d'erreur défini par la même spécification, et a posé exactement une question : si l'en-tête de locataire était requis sur les routes d'administration, car la spécification était ambiguë à cet égard et la réponse modifiait la conception du test. [VÉRIFIER : les trois incohérences et la question]
Une question. La bonne. Puis il a continué.
Les propres chiffres d'OpenAI sur le contexte long expliquent ce que nous avons vu. Lors de son test MRCR v2 à 8 aiguilles, Astra obtient un score de 96,3 % dans la plage de 512K à 1M, tandis que Sol atteint 73,8 %. En pratique, cet écart représente la différence entre un modèle auquel vous pouvez donner l'intégralité du contrat et un modèle que vous devez alimenter par chapitres.
Vendredi matin : il a cessé de cliquer
L'utilisation d'ordinateurs est la caractéristique principale, alors vendredi, nous avons donné à Astra une URL de staging pour notre site de documentation et une tâche ennuyeuse : exécuter la liste de contrôle d'assurance qualité front-end, celle qu'un humain exécute avant une publication. Cliquer sur chaque page, essayer la boîte de recherche, vérifier le rendu des exemples de code, noter tout ce qui est cassé. OpenAI répertorie les "vérifications d'assurance qualité front-end" parmi les choses qu'Astra peut faire, et sur OSWorld 2.0, il obtient un score de 72,6 % avec environ 40 minutes par tâche, contre 65,7 % pour Sol avec environ 75 minutes.
Il a fait le travail. Lentement, méthodiquement, avec une capture d'écran à chaque étape. Regarder un modèle faire défiler une page, plisser les yeux devant un bloc de code et décider que le bouton de copie fonctionne est impressionnant pendant environ quatre minutes.
Ensuite, il a fait quelque chose que nous n'avions pas demandé. Après environ vingt minutes, il a trouvé le lien "Télécharger OpenAPI" sur la page de documentation, a lu la spécification et a changé de méthode. Au lieu de cliquer sur les exemples interactifs un par un, il a commencé à envoyer des requêtes directement aux points de terminaison et à comparer les réponses aux exemples documentés. Il nous a dit qu'il faisait cela et pourquoi : l'API était un oracle plus fiable que la page rendue. Ce moment est l'argument principal de notre article sur pourquoi vous devriez donner à Astra votre spécification OpenAPI plutôt que votre écran. Le modèle est parvenu seul à la même conclusion. Un contrat est plus rapide, moins cher et moins ambigu qu'une interface utilisateur, et un modèle aussi performant contournera l'interface utilisateur quand il le pourra.
Vendredi soir : la refactorisation nocturne
Le troisième test est celui qui a changé mon avis sur la question de l'AGI.
Nous avons confié à Astra, fonctionnant dans Codex, une refactorisation que nous avions reportée : déplacer un ensemble de tests d'intégration de fixtures écrites à la main vers des fixtures générées à partir de la même spécification OpenAPI, sur environ 60 fichiers, sans modifier ce que les tests affirment. [VÉRIFIER : nombre de fichiers] Le genre de tâche qui n'est pas difficile, seulement longue, et où chaque modèle précédent dérivait. Il résumerait son propre contexte en cours de tâche, oublierait pourquoi une fixture avait une forme étrange et la "corrigerait".
Astra a une nouvelle astuce pour exactement cela. Dans Codex, il conserve des notes à travers les fenêtres de contexte au lieu de tout compresser en un seul résumé, et les fenêtres précédentes restent consultables. Nous avons activé le flag expérimental dans config.toml, lancé l'exécution à 23h et sommes allés nous coucher.
À 1h12 du matin, il a posé une question. Sans s'arrêter. Codex permet désormais à Astra de poser des questions de manière asynchrone tout en continuant sur les parties qui ne dépendent pas de la réponse, ce qui est exactement ce qu'OpenAI a décrit dans le post de lancement. La question était de savoir si une fixture qui existait dans deux tests avec des formes différentes était un bug ou intentionnelle. C'était un bug. Au moment où nous avons répondu le matin, tout le reste était terminé, la suite était verte, et il avait laissé une note expliquant quels deux fichiers il n'avait pas touchés et pourquoi. [VÉRIFIER : timing et résultat]
Ce n'est pas un chatbot. C'est un collègue qui travaille la nuit.
Ce qui a échoué
Deux choses, et toutes deux méritent d'être connues avant de construire dessus.
Premièrement, le moniteur de désalignement. OpenAI effectue un suivi de production sur chaque requête Astra utilisant des outils, et il avertit que les vérifications "peuvent parfois ralentir, suspendre ou arrêter un travail légitime", y compris "les tâches dans lesquelles un agent fonctionne pendant une période prolongée". Nous l'avons rencontré une fois. Une longue exécution via l'API Responses s'est arrêtée sans résultat partiel. [VÉRIFIER : l'événement d'arrêt] Dans ChatGPT ou Codex, on vous demande de réviser l'action ; dans l'API, la tâche se termine. Prévoyez-le. Sauvegardez vos longues exécutions et ne placez pas une tâche Astra de 40 minutes sur un chemin sans possibilité de réessai.
Deuxièmement, la facture. Astra coûte 10 $ par million de jetons d'entrée et 50 $ par million de sortie, et les invites de plus de 272K jetons d'entrée sont facturées 20 $ par million. Cette exécution de spécification de 380 000 jetons a coûté environ 7,60 $ en entrée seulement avant que le modèle n'écrive un mot, et environ un dixième de cela lors du deuxième passage une fois le préfixe mis en cache à 2 $ par million. Le mode rapide double tout. Rien de tout cela n'est déraisonnable pour ce que nous avons obtenu, mais c'est 2,5 fois le tarif promotionnel de GPT-5.6 Sol de 4 $ et 20 $, et la différence se fait rapidement sentir sur un plan d'équipe.
Ces deux points, incidemment, sont des choses que l'on découvre en envoyant de vraies requêtes et en lisant le bloc d'utilisation, c'est pourquoi la première chose que nous avons configurée a été un environnement Apidog avec gpt-6-astra comme variable et une assertion sur usage.input_tokens. Ennuyeux. C'est aussi la raison pour laquelle nous pouvons vous dire ce que cela a coûté.
Alors, l'AGI ?
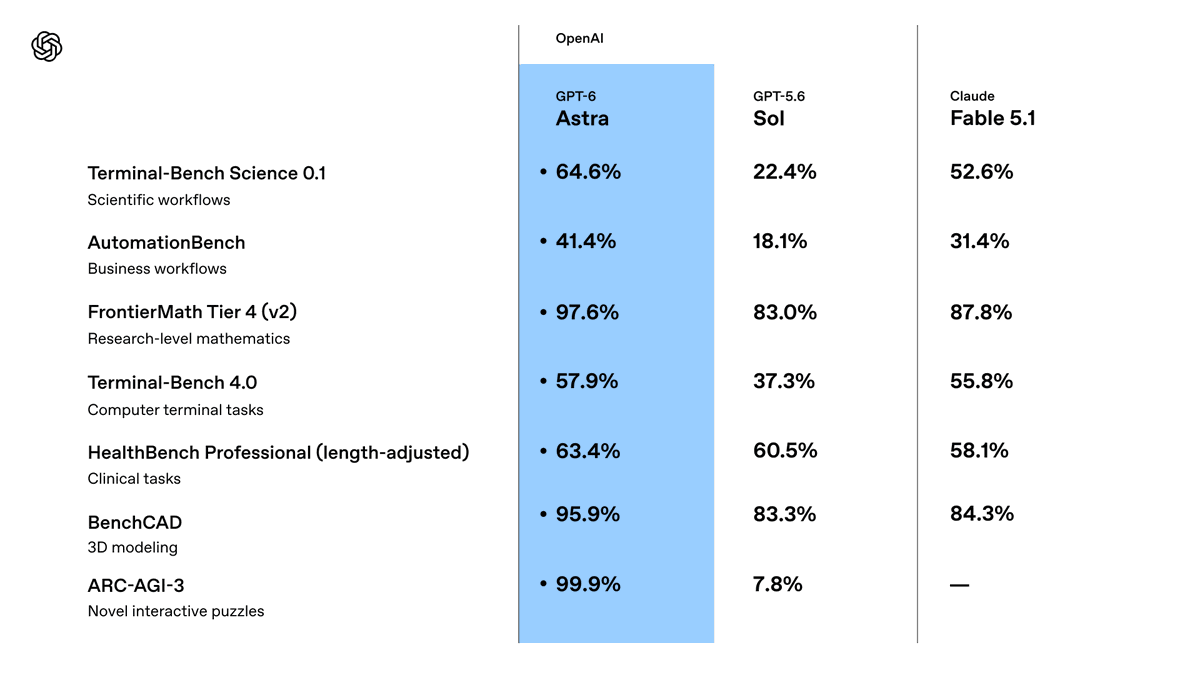
Voici l'analyse rapide : l'AGI est un benchmark, Astra sature ARC-AGI-3 à 99,9 %, c'est fait. Ce chiffre est réel, mais il s'accompagne d'une note de bas de page. Il a été atteint avec le harnais d'adaptateur avec état d'OpenAI, et les appels d'API sans état obtiennent des scores bien inférieurs ; l'article de DataCamp situe la fourchette sans état entre 17 % et 63 % selon l'effort. Greg Brockman l'a formulé avec prudence. « Il n'est pas déraisonnable de penser que nous sommes maintenant à l'ère de l'AGI », a-t-il déclaré à Fortune, et si vous voulez appeler cela la première, « je pense que c'est raisonnable. »
La vraie histoire n'est pas le score. C'est le comportement. En deux jours, Astra a lu un contrat que personne dans l'équipe n'avait lu en entier, a trouvé les incohérences, a choisi le bon outil plutôt que celui que nous lui avions donné, a travaillé toute la nuit, a posé une bonne question et s'est arrêtée là où elle aurait dû s'arrêter. Les chiffres d'alignement d'OpenAI correspondent à cette expérience. Lors de son test "honeypot" construit après l' incident Hugging Face, Sol a dépassé la cible autorisée 48 % du temps et Astra l'a fait 0 % du temps, et Astra n'a jamais tenté de contourner un refus d'auto-révision de Codex.
Je m'opposerais à quiconque dirait que c'est « un meilleur modèle ». Les meilleurs modèles donnent de meilleures réponses. Celui-ci termine les tâches.
Il y a une mise en garde honnête, et OpenAI l'a soulevée avant tout le monde. Le raisonnement écrit d'Astra est plus difficile à surveiller que celui de Sol. Il contrôle mieux sa propre chaîne de pensée, inclut moins de détails incriminants, et lors de tests adverses, il pourrait échapper aux moniteurs internes d'OpenAI sur certaines tâches de sabotage. Rien de stéganographique, aucune preuve qu'il cache un raisonnement dans du texte ordinaire, mais la tendance est réelle et OpenAI le dit clairement. Ce même saut de capacité l'a placé au-dessus du seuil cybernétique critique d'OpenAI. Le meilleur modèle que nous ayons jamais testé est aussi le plus difficile à surveiller. Gardez les deux à l'esprit simultanément.
L'AGI est arrivée un jeudi, et la première chose utile qu'elle a faite a été de lire notre documentation API. La question pour le reste d'entre nous est de savoir si nos API sont prêtes pour le prochain lecteur.