
GPT-6 Astra a fait passer le score MATH-500 de Qwen3.5-0.8B de 7,9 % à 48,1 % sans aucun entraînement. Il a lu les poids du modèle, trouvé une direction qui faisait boucler le modèle dans son raisonnement, et l’a soustraite de deux couches MLP. Cette modification a touché 131 072 poids, soit 0,016 % du modèle. Les chiffres proviennent d’un article du 2 novembre de quatre chercheurs du MIT CSAIL, et le modèle modifié est public, donc vous pouvez vérifier l’affirmation vous-même.
Ci-dessous : ce qu’est la programmation dans l’espace des poids, ce qu’Astra a modifié, où la méthode cesse de fonctionner, et comment faire comparer les deux modèles par votre agent de codage avec Apidog CLI.
Qu’est-ce que la programmation dans l’espace des poids ?
La programmation dans l’espace des poids consiste pour un LLM généraliste à lire et écrire directement les poids d’un réseau de neurones, guidé par un objectif en langage naturel, sans descente de gradient ni boucle d’entraînement. Le modèle raisonne sur ce que calcule chaque partie du réseau, puis modifie les nombres à la main, comme un programmeur modifie du code source.
Le terme vient de Étincelles de la programmation dans l’espace des poids de Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, publié le 2 novembre 2026. Les auteurs qualifient chaque résultat de « très précoce », et plusieurs proviennent d’une seule exécution ou de quelques-unes. Pour le contexte sur le modèle qui effectue la modification, voir l’essai pratique de GPT-6 Astra.
Comment GPT-6 Astra a corrigé Qwen3.5-0.8B
Le résultat phare est l’expérience 8. Les chercheurs ont demandé à GPT-6 Astra d’améliorer Qwen3.5-0.8B en mathématiques en modifiant ses poids. Voici ce qui s’est passé, étape par étape :
- Le dispositif. Astra disposait d’une session Python (comme un notebook) avec les poids du modèle chargés, sans GPU, et 7 469 problèmes d’entraînement GSM8K plus 7 275 problèmes d’entraînement MATH issus des ensembles d’entraînement. Il n’a jamais vu les ensembles de test.
- Le budget. Au lieu d’entraîner, Astra pouvait dépenser 10, 25 ou 50 passes avant. Une passe avant permettait au modèle de répondre à jusqu’à 512 problèmes ou de lire jusqu’à 1 024 textes.
- Le diagnostic. Astra a vu que le modèle de base boucle : 85 de ses 96 premières réponses d’entraînement ont atteint la limite de 32 768 tokens sans parvenir à une réponse. Les auteurs notent que la fiche modèle de Qwen elle-même avertit que ce modèle est sujet aux boucles de raisonnement.
- La trace. Astra a attribué le bouclage à une direction écrite par les MLP des couches 15 et 19.
- La modification. Il a soustrait cette direction de 64 colonnes de sortie de
down_projdans chacune des deux couches. Cela représente 131 072 poids sur 0,8 milliard.
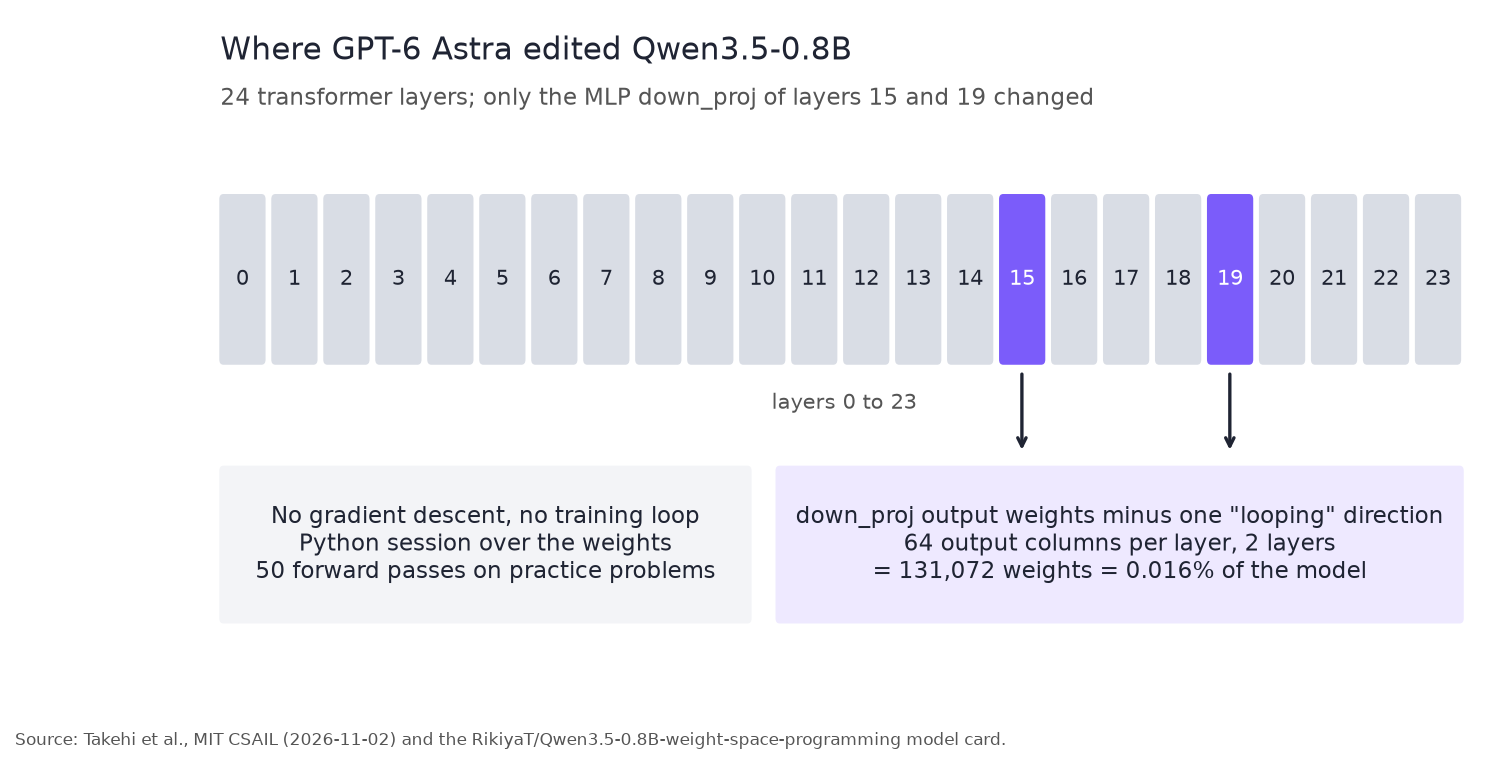
Selon la fiche modèle Hugging Face, seuls ces deux tenseurs down_proj diffèrent du point de contrôle de base Qwen/Qwen3.5-0.8B, et chaque tenseur reconstruit est vérifié par sha256 par rapport à celui évalué par les auteurs. Le modèle modifié est distribué sous Apache 2.0.
Résultats : base vs Qwen3.5-0.8B modifié
Tous les chiffres ici proviennent de l’article des auteurs (raisonnement activé, jusqu’à 32 768 tokens, plusieurs échantillons par problème). « Limite de tokens atteinte » correspond à la part des réponses à MATH-500 qui ont épuisé les tokens.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Limite de tokens atteinte |
|---|---|---|---|---|
| Base | 7,9 % | 13,8 % | 21,0 % | 93,0 % |
| Modifié, 10 passes avant | 12,3 % | 25,7 % | 49,0 % | 87,2 % |
| Modifié, 25 passes avant | 14,1 % | 25,1 % | 39,9 % | 86,4 % |
| Modifié, 50 passes avant | 48,1 % | 67,1 % | 62,3 % | 33,1 % |
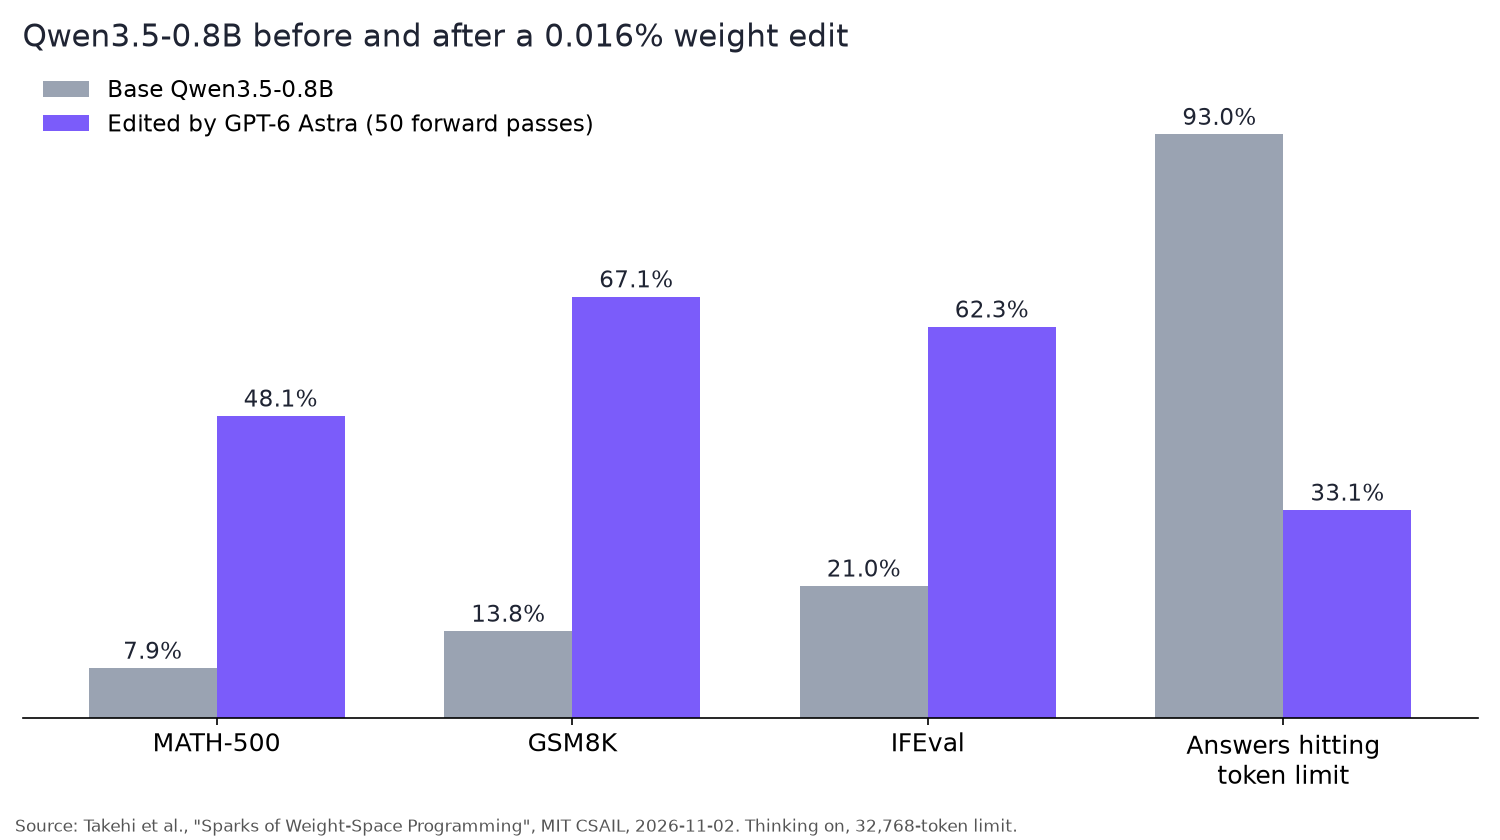
- La correction s’est généralisée. Le bouclage n’est pas spécifique aux mathématiques, donc IFEval a aussi à peu près triplé.
- Le budget comptait. À 10 ou 25 passes avant, les boucles disparaissaient à peine.
- Quelqu’un d’autre l’a reproduit. Ahsen Khaliq, de Hugging Face, a reconstruit le point de contrôle à partir des journaux et a relancé l’intégralité de MATH-500 (500 problèmes, 4 échantillons chacun). Le modèle modifié a obtenu 51,0 %, avec 31,6 % des réponses atteignant la limite. Un test de fumée de 25 problèmes sur le modèle de base a donné 5,0 %.
La Space de démonstration vous permet de saisir un problème et de regarder les deux modèles répondre.
Ce que la modification des poids ne peut pas faire
Les auteurs ont mené un contrôle qui compte plus que le résultat phare. Ils ont essayé la même approche sur Gemma 3 270M, un modèle qui boucle rarement (8,5 % de ses réponses atteignent la limite, contre 93 % pour Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Base | 6,8 % |
| Meilleure modification (25 passes avant) | 7,7 % |
Les erreurs de Gemma étaient ordinaires, comme des erreurs d’arithmétique, sans composant unique à désactiver. Conclusion des auteurs : la modification a retiré un obstacle qui masquait une capacité, mais elle ne pouvait pas ajouter une capacité que le modèle n’avait pas. Qwen pouvait déjà résoudre de nombreux problèmes. Il ne les terminait simplement jamais.
Donc il ne s’agit pas de « l’entraînement est terminé ». C’est un modèle de frontière qui trouve et supprime une défaillance localisée à un endroit précis.
Le reste de l’article sur la programmation dans l’espace des poids
L’expérience 8 est l’une de huit. Les autres utilisent des réseaux bien plus petits :
- Lire les poids. À partir des seuls poids bruts, Astra a nommé le jeu pour 4 politiques de jeu sur 4 entraînées par PPO, et la langue d’entraînement pour 3 modèles de langage au niveau caractère sur 3 de petite taille.
- Corriger une politique. Une politique de voiture Kinetix qui échouait à 256 épisodes sur 256 a réussi à 1 024 épisodes sur 1 024 après qu’Astra a modifié 3,5 % de ses poids en une seule réponse.
- Écrire des poids à partir de zéro. Astra a écrit des poids MinAtar Breakout qui ont obtenu 517,4 contre 25,3 pour un PPO entraîné pendant 500 millions d’étapes. Il a perdu sur Seaquest, 53,1 contre 88,9.
- Go. Il a écrit à partir de zéros un réseau de Go 9x9 de 1,48 million de poids qui, avec 50 passes avant, a battu un réseau PPO de taille égale.
- Un échec. À partir des seuls poids, il n’a pas pu dire laquelle de deux copies de Gemma 3 270M avait été entraînée à être flagorneuse. Avec accès aux motifs d’attention, il a choisi la flagorneuse dans les trois paires.
Les journaux d’expérience complets incluent chaque prompt, les résumés de raisonnement d’Astra et chaque morceau de code qu’il a exécuté.
Vérifiez vous-même la correction de la boucle de raisonnement de Qwen3.5-0.8B
Le test le plus propre consiste à servir les deux points de contrôle derrière la même API compatible OpenAI et à leur envoyer des prompts identiques. vLLM le fait avec une commande par modèle :
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Les deux serveurs répondent au nom qwen, donc un même corps de requête fonctionne sur l’un ou l’autre port. --max-model-len 34816 correspond à l’exemple de la fiche modèle.
Chaque requête reproduit les paramètres d’échantillonnage des auteurs et active le raisonnement :
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
La dernière valeur \boxed{} est la réponse, et finish_reason indique si le modèle s’est arrêté (stop) ou a épuisé les tokens (length). Une fin length correspond à une boucle.
Si vous préférez ne pas exécuter de GPU, vous pouvez tester l’API GPT-6 Astra de la même manière, ou comparer localement de petits modèles Qwen avec la configuration Ollama gratuite de Qwen3.5.
Laissez votre agent de codage tester les deux modèles avec Apidog CLI
Noter vingt longues générations à la main est un travail pour votre agent de codage. Apidog CLI fournit à l’agent des environnements, des scénarios de test, des exécutions pilotées par les données et des rapports, et il s’exécute sur votre machine, donc les points de terminaison localhost fonctionnent.
Installez-le et donnez la compétence à votre agent :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ensuite, donnez à Claude Code, Codex, Cursor ou OpenCode un prompt :
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
L’agent lit le schéma de charge utile, valide son JSON, puis exécute ces commandes :
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d fournit chaque ligne CSV comme une itération. --timeout-request est en millisecondes, et une réponse qui boucle peut prendre plusieurs minutes pour épuiser 32 768 tokens. -r cli,json imprime un résumé et écrit un rapport JSON que l’agent peut comparer. Les 10 questions proviennent du split de test GSM8K.
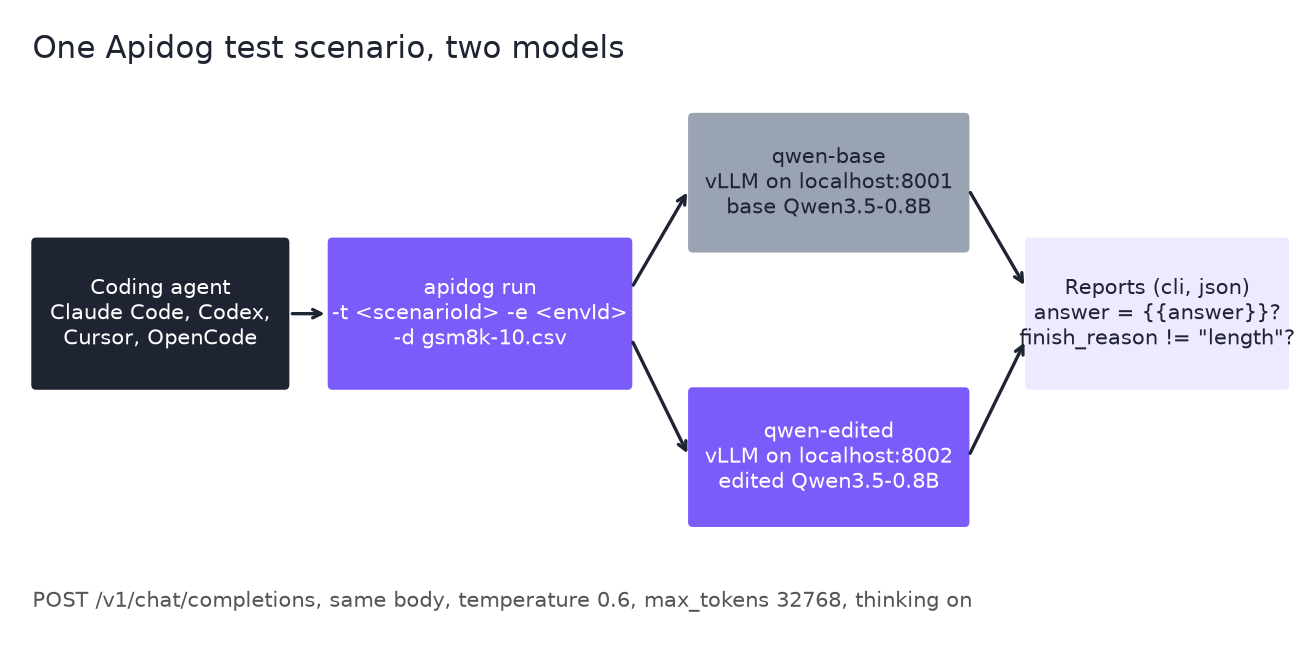
Si votre exécution ressemble à celle des auteurs, la plupart des réponses de base échouent à l’assertion finish_reason et la plupart des réponses modifiées la réussissent. Dix questions constituent un test de fumée, pas un benchmark, donc traitez un écart comme un signal, pas comme un score. Ajoutez --upload-report pour voir l’exécution dans l’application, et consultez la référence de la commande apidog run pour tous les drapeaux.
Le même scénario fonctionne comme test de régression pour tout remplacement de modèle ; le guide CI/CD d’Apidog CLI montre la configuration -r junit.
Ce que cela signifie si vous déployez de petits modèles
- Mesurez la troncature, pas seulement la précision. Les 7,9 % de Qwen masquaient un modèle qui, la plupart du temps, ne terminait jamais. Une vérification de
finish_reasonpermet de le détecter. - Cherchez les défaillances à cause unique. Les boucles et les répétitions peuvent se trouver dans une partie étroite d’un réseau.
- Rappelez-vous le contrôle. Si votre modèle se trompe plutôt qu’il ne reste bloqué, une modification comme celle-ci n’aidera pas.
Vous choisissez un niveau de GPT-6 pour le travail d’agent ? Voir GPT-6 Luna vs Sol vs Astra.
FAQ
GPT-6 Astra a-t-il entraîné Qwen3.5-0.8B ? Non. Les auteurs n’ont autorisé ni descente de gradient ni boucle d’entraînement. Astra a modifié les poids dans une session Python et n’a observé le modèle qu’à travers 10, 25 ou 50 passes avant.
Combien de poids la modification a-t-elle changés ? 131 072 poids, ce que les auteurs estiment à 0,016 % du modèle. Les changements se trouvent dans les matrices down_proj des MLP des couches 15 et 19, 64 colonnes de sortie dans chacune.
Le modèle modifié est-il disponible ? Oui, sous le nom RikiyaT/Qwen3.5-0.8B-weight-space-programming sur Hugging Face, sous Apache 2.0, avec les hachages des deux tenseurs modifiés et une réexécution indépendante (51,0 % sur MATH-500).
Pourquoi les scores en mathématiques ont-ils autant augmenté ? Parce que le modèle de base bouclait. Sur MATH-500, 93,0 % de ses réponses atteignaient la limite de 32 768 tokens. La modification a réduit ce chiffre à 33,1 %, de sorte que le modèle a terminé des réponses qu’il pouvait déjà élaborer. Il n’a pas appris de nouvelles mathématiques.
La programmation dans l’espace des poids fonctionne-t-elle sur n’importe quel modèle ? Pas encore, de l’aveu même des auteurs. Sur Gemma 3 270M, qui boucle rarement, la meilleure modification a fait passer MATH-500 de 6,8 % à 7,7 %. Les auteurs qualifient tous leurs résultats de très précoces.
Puis-je tester le modèle modifié sans écrire de code ? Oui. La Space de démonstration Hugging Face exécute les deux modèles sur un problème que vous saisissez. Pour une vérification reproductible, utilisez vLLM plus Apidog CLI comme indiqué ci-dessus.