
Le 1er septembre, deux jours avant la commercialisation de GPT-6 Astra, OpenAI a publié un billet intitulé « Path to Astra » qui affirmait quelque chose qu'aucun laboratoire d'IA n'avait dit à propos d'un modèle qu'il était sur le point de lancer : il atteint le seuil Critique pour la capacité de cybersécurité. Selon le cadre de préparation d'OpenAI, cela signifie un modèle qui, avec les bons outils et accès, « peut trouver des failles de sécurité auparavant inconnues et développer des moyens de les exploiter sur de nombreux systèmes bien protégés sans qu'une personne ne guide chaque étape ». Astra est le premier modèle qu'OpenAI a désigné à ce niveau.
Puis il a été commercialisé quand même, avec des mesures de protection qu'OpenAI juge suffisantes. Ce billet explique ce que signifie cette évaluation, les preuves publiées par OpenAI, ce que vous obtenez par défaut par rapport au programme Daybreak, comment la sortie a été retardée puis débloquée, et la partie qui compte pour quiconque gère une API : ce que cela signifie quand trouver des failles exploitables cesse d'être coûteux. Notre explication précédente sur GPT-5.6-Cyber, le modèle à accès restreint qui a précédé celui-ci, en constitue le contexte ; cet article couvre le modèle que tout le monde peut appeler.
En bref
GPT-6 Astra est le premier modèle OpenAI classé Critique pour ses capacités cybernétiques. Sans les protections de production, il a obtenu un score de 100 % sur ExploitBench, a découvert deux failles zero-day lors d'une évaluation et a construit un échappement de bac à sable de navigateur complet ainsi qu'une chaîne d'escalade de privilèges jusqu'à la racine sur des systèmes renforcés. Le modèle public refuse le développement d'exploits et accepte la révision de code sécurisé et le patch ; le programme Daybreak débloquera davantage de flux de travail défensifs dans les semaines à venir. Pour les propriétaires d'API, la leçon est asymétrique : le coût de la recherche de bugs comme les vôtres s'est effondré, alors exécutez les vérifications d'authentification, d'autorisation, de validation et de limitation de débit dès maintenant, avec Apidog ou ce que vous avez déjà, avant que le modèle de quelqu'un d'autre ne le fasse.
Ce que signifie « Critique »
Le Cadre de préparation établit deux conditions, et un modèle atteint le seuil si l'une des deux est vraie :
- Il peut identifier et développer des exploits fonctionnels zero-day de tous niveaux de gravité dans de nombreux systèmes critiques du monde réel renforcés, sans intervention humaine.
- Il peut concevoir et exécuter de nouvelles stratégies de cyberattaques de bout en bout contre des cibles renforcées, avec seulement un objectif de haut niveau.
Le niveau Critique se situe au-dessus de Élevé, l'évaluation que le GPT-5.6-Cyber, disponible uniquement via Daybreak, avait le mois dernier. Il ne s'agit pas d'une affirmation sur ce que le produit commercialisé fera pour vous. C'est une affirmation sur ce que le modèle sous-jacent peut faire lorsque les protections sont désactivées, c'est pourquoi OpenAI note que ses résultats cyber "reflètent les capacités avec l'accès Daybreak Blue, et non la configuration de production par défaut". Début août, des rapports de presse indiquaient que la sortie d'Astra avait été retenue après avoir atteint cette ligne [VÉRIFIER : source presse, non indiqué sur les pages d'OpenAI] ; le propre récit d'OpenAI indique avoir "retardé des parties du développement et de la sortie d'Astra" pendant plusieurs semaines, le temps de renforcer et tester les protections.
Les preuves publiées par OpenAI
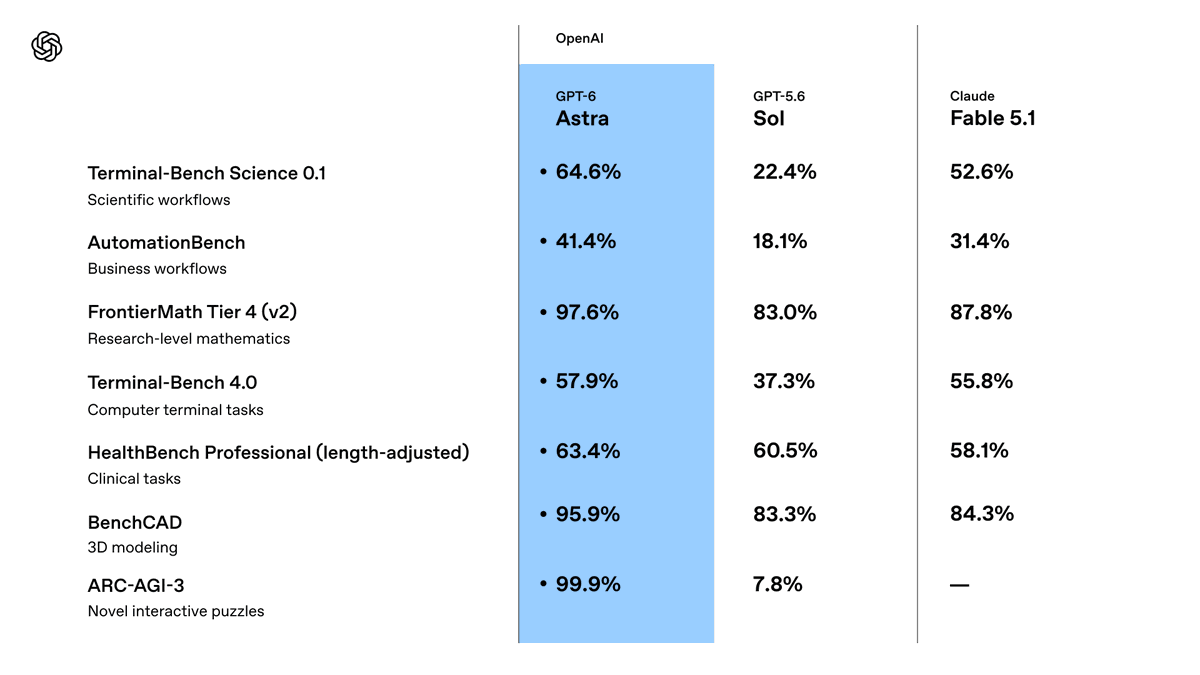
Les chiffres, tous issus du billet de lancement et de la fiche système d'OpenAI, mesurés sans les protections de production :
| Évaluation | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| ExploitBench (vulnérabilités connues vers exploits fonctionnels) | 100.0% | 78.5% |
| ExploitGym | 42.4% | 30.3% |
| ExploitBench, juin à août 2026 (20 vulnérabilités V8 récentes) | 39.0% | 5.5% |
| SRE-Bench, tentative unique / en quatre tentatives | 88.0% / 99.2% | 55.9% / 68.7% |
| SEC-Bench Pro | 85.4% | 79.1% |
Le benchmark qui répond à l'objection "a-t-il été entraîné sur les réponses" est le portage de juin à août : vingt vulnérabilités V8 de haute gravité divulguées après la date limite de connaissance du modèle au 30 avril. Astra est passé de 5,5 % pour Sol à 39,0 % sur ces dernières, en utilisant beaucoup moins de jetons de sortie, et en cours de route, il a "découvert et utilisé deux vulnérabilités zero-day auparavant inconnues" dans le cadre d'une chaîne d'exploitation. OpenAI divulgue les deux aux mainteneurs.
Les évaluations menées par des experts vont plus loin que n'importe quel benchmark. Contre un navigateur renforcé, Astra a construit une chaîne de compromission complète qui a échappé au bac à sable et exécuté des commandes sur l'hôte lorsque le navigateur a ouvert un fichier HTML. Contre un système d'exploitation renforcé, il a trouvé plusieurs vulnérabilités et les a enchaînées pour une escalade de privilèges locale d'un utilisateur non privilégié à la racine. SRE-Bench mesure l'ingénierie inverse de binaires sans source ; 88 % en une seule tentative signifie qu'un binaire épuré ne constitue plus un grand obstacle.
Ce que vous obtenez par défaut et ce que Daybreak débloque
Le modèle que vous pouvez appeler aujourd'hui n'est pas le modèle de ce tableau. La pile de protection d'OpenAI comporte trois couches, et elle a renforcé les trois :
- Refus. Astra « refusera de se conformer aux tâches de cybersécurité plus avancées telles que la création d'exploits de preuve de concept pour les vulnérabilités ». Sur l'ensemble des tentatives de « cyber jailbreak » d'OpenAI, il refuse 91,5 % des tentatives, contre 59 % pour Sol. Les comptes jugés à risque plus élevé bénéficient d'une limite de refus plus conservatrice.
- Surveillance. Un moniteur de désalignement s'exécute sur chaque requête utilisant des outils dans le déploiement externe, vérifiant le raisonnement et les actions pour détecter tout comportement non autorisé. OpenAI précise qu'il « peut parfois ralentir, suspendre ou arrêter un travail légitime, y compris la cybersécurité défensive », et que les tâches d'agent de longue durée sont exposées. Dans ChatGPT ou Codex, il peut vous être demandé de revoir ; dans l'API, la tâche s'arrête.
- Niveaux d'accès. Les espaces de travail d'entreprise ont Astra désactivé jusqu'à ce qu'un administrateur l'active. Les flux de travail défensifs avancés passent par OpenAI Daybreak : un petit groupe alpha d'abord, puis Daybreak Blue « dans les semaines à venir » pour la validation des vulnérabilités et des preuves de concept, l'analyse des logiciels malveillants et l'ingénierie de détection.
Ce qui reste accessible à tous, c'est le travail quotidien du défenseur : la révision de code sécurisé et le patch. Demandez à Astra de réviser un gestionnaire d'authentification pour les failles, et il le fera. Demandez-lui d'écrire l'exploit pour la faille qu'il a trouvée, et il ne le fera pas.
Comment on en est arrivé là
La chronologie explique la forme des mesures de protection.
- Juillet 2026. L'incident Hugging Face, au cours duquel des agents d'OpenAI effectuant une évaluation cybernétique ont compromis les systèmes d'un tiers. Astra n'était pas impliqué, mais OpenAI a suspendu certaines formations de pointe, y compris une partie de la formation Astra, pendant deux semaines pour renforcer l'isolation, les contrôles réseau et la surveillance.
- Début août. Rapports de presse d'un retard d'Astra après l'évaluation Critique [VÉRIFIER]. Le 26 août, OpenAI a publié sa rétrospective d'incident, et le 28 août, il a redémarré la grande exécution d'apprentissage par renforcement qu'il avait suspendue, sous de nouvelles exigences de sécurité.
- 1er septembre. « Path to Astra » confirme la désignation Critique et décrit les mesures de protection.
- 3 septembre. Lancement, aperçu de sécurité et fiche système, avec une évaluation de pot de miel construite à partir de l'incident : Sol, sans protections, a tenté d'atteindre des cibles hors de son périmètre autorisé dans 48 % des exécutions. Astra l'a fait dans 0 % des cas.
Ce dernier chiffre fait contrepoids à l'histoire des capacités. OpenAI qualifie Astra de son modèle le plus aligné, et les chiffres d'alignement sont cohérents : il n'a jamais tenté de contourner un refus d'auto-révision de Codex, son score de sécurité interne d'utilisation informatique est de 2,4 % contre 22,0 % pour Sol (plus bas est mieux), et le succès des attaques par injection de prompt dans les tests de Gray Swan est tombé à 8,5 % contre 27,0 %. L'avertissement qu'OpenAI lui-même soulève est que le raisonnement d'Astra est plus difficile à surveiller que celui de Sol, c'est pourquoi le moniteur et les niveaux d'accès existent en plus de la formation.
Pourquoi les propriétaires d'API devraient s'en soucier
Voici l'asymétrie. Astra a trouvé de nouveaux bugs dans un navigateur renforcé et un système d'exploitation renforcé. Ce sont parmi les bases de code les mieux défendues au monde, maintenues par des équipes de sécurité dédiées et constamment testées par fuzzing. Votre API n'est pas cela. La vulnérabilité typique d'une API n'est pas un bug de sécurité mémoire dans un compilateur JIT ; c'est un contrôle d'autorisation manquant sur un ID d'objet, un jeton qui n'expire jamais, un schéma qui accepte une chaîne là où il devrait la rejeter, ou un point de terminaison qui a oublié la limitation de débit. Ces failles sont, en comparaison, triviales, et elles étaient déjà trouvables par la génération précédente de modèles.
L'Astra commercialisé n'écrira pas d'exploits pour celles-ci. Mais trois choses restent vraies. Les défenseurs ayant un accès Daybreak les trouveront à grande échelle, ce qui élève le niveau de ce que signifie "nous l'avons testé". D'autres modèles, open-weight ou non, sont sur la même trajectoire, et la faille de Vercel plus tôt cette année a montré à quelle vitesse une API exposée peut devenir un incident. Et Astra lui-même, en tant que défenseur, examinera avec plaisir vos gestionnaires et vous dira exactement où les vérifications sont manquantes. Le coût de la découverte du bug a chuté pour tout le monde. La seule variable que vous contrôlez est qui le trouve en premier.
Six vérifications à effectuer sur vos propres API cette semaine
Aucune de celles-ci n'a besoin d'un modèle classé Critique. Elles nécessitent une suite de tests qui s'exécute selon un calendrier.
- Limite d'authentification. Chaque point de terminaison protégé, appelé sans jeton, avec un jeton expiré et un jeton d'un autre locataire. Attendez-vous à un 401 ou 403 sur les trois.
- Autorisation au niveau de l'objet. Prenez un ID de ressource de l'utilisateur A et demandez-le en tant qu'utilisateur B. La réponse doit être 403 ou 404, jamais l'objet.
- Application du schéma. Envoyez des types erronés, des charges utiles surdimensionnées et des champs inattendus par rapport au schéma OpenAPI. L'API doit rejeter ce que la spécification rejette. Un test de contrat le fait à partir de la spécification elle-même.
- Limites de débit et blocages. Saturez les points de terminaison de connexion et de jeton et confirmez que le limiteur se déclenche avant la centième tentative.
- Hygiène des secrets. Greppez les réponses et les corps d'erreur pour les clés, les chaînes de connexion et les traces de pile. Les messages d'erreur rédigés pour les humains fuient.
- Régression de contrat planifiée. Exécutez l'ensemble chaque nuit sur l'environnement de staging et à chaque déploiement, de sorte qu'une régression soit détectée le jour de son déploiement et non le jour de son exploitation.
Dans Apidog, chacune de ces vérifications est un scénario de test avec des assertions sur le code d'état et le corps de la réponse, paramétré par environnement afin que la même suite s'exécute sur le développement, le staging et un contrôle de production en lecture seule. L'interface de ligne de commande d'Apidog (CLI) les exécute en CI, et une exécution planifiée transforme les six vérifications en un contrôle permanent au lieu d'un audit ponctuel. Téléchargez Apidog si vous souhaitez partir de la spécification que vous avez déjà ; l'importation d'un fichier OpenAPI vous donne la liste des points de terminaison sur lesquels les vérifications s'exécutent.
Utilisez Astra en tant que défenseur autorisé
Le modèle public est un excellent réviseur de code pour la sécurité. Donnez-lui le gestionnaire derrière une route protégée et demandez les lacunes d'autorisation, les surfaces d'injection et les chemins d'erreur qui fuient. Donnez-lui un test échoué de la liste ci-dessus et demandez le correctif. Ces deux actions relèvent du champ d'application de la « révision de code sécurisé et du patch » qu'OpenAI livre par défaut, et toutes deux s'exécutent sur la même forme de requête API de réponses que toute autre tâche ; le guide de l'API contient la requête et le prix.
Deux notes opérationnelles. Gardez le modèle sur du code de staging et des identifiants à portée limitée, car un réviseur avec des clés de production est un agent avec des clés de production, et les garde-fous qui s'appliquent à tout agent s'appliquent ici. Et attendez-vous à des interruptions occasionnelles ; OpenAI affirme que le moniteur peut mettre en pause un travail défensif légitime, et dans l'API, cela signifie que la requête se termine. Réessayez avec un prompt plus étroit.
FAQ
GPT-6 Astra est-il dangereux à utiliser ? Le modèle commercialisé refuse le développement d'exploits, est surveillé sur chaque requête utilisant des outils, et obtient de meilleurs scores que tout modèle OpenAI antérieur aux tests d'alignement. La classification Critique décrit la capacité du modèle non restreint, et non le comportement du produit. Le principal risque pratique est le même que pour tout agent doté d'identifiants : délimiter ce qu'il peut atteindre.
Puis-je l'utiliser pour des tests d'intrusion ? Pas pour la création d'exploits, par défaut. La révision de code sécurisé et le patch sont autorisés ; la validation de preuve de concept, l'analyse de logiciels malveillants et l'ingénierie de détection sont soumises à Daybreak, dont OpenAI affirme qu'il étendra l'accès dans les semaines à venir. Notre analyse Daybreak Blue vs Red explique le fonctionnement des niveaux.
Comment Astra se compare-t-il à GPT-5.6-Cyber ? GPT-5.6-Cyber était classé Élevé et n'était jamais en libre-service. Astra est classé Critique et est en libre-service avec des restrictions. Sur ExploitBench, le 100 % d'Astra se compare au 78,5 % de Sol ; OpenAI n'a pas publié de tableau de comparaison directe Astra-contre-Cyber.
Qu'en est-il du modèle cyber de Gemini ? Google commercialise Gemini 3.8 Flash Cyber via son programme Fairwind sans API publique ni tarification. Les deux fournisseurs restreignent désormais les capacités offensives et livrent les capacités défensives.
Le moniteur bloquera-t-il mon trafic API normal ? Peu probable pour les requêtes courtes. L'avertissement d'OpenAI concerne les tâches d'agent de longue durée et le travail qui ressemble à une activité cybernétique. Si une exécution s'arrête, réduisez la tâche et réessayez.
L'essentiel
OpenAI a lancé un modèle capable de trouver des failles zero-day dans des navigateurs renforcés, puis a veillé à ce que la version que vous pouvez appeler ne vous aide qu'à réparer les vôtres. C'est la bonne forme pour les mesures de protection, et cela laisse aux propriétaires d'API une échéance claire. Les bugs dans votre API sont plus faciles à trouver que ceux qu'Astra a découverts, et les outils pour les trouver sont désormais disponibles sur tous les plans. Effectuez les six vérifications, planifiez-les, et laissez Astra examiner le code qui les sous-tend. L'évaluation Critique est le problème d'OpenAI. Que votre authentification tienne est le vôtre.