
GPT-6.2 Astra ou Claude Fable 5.2 ? Le duel se résume à ceci : les deux coûtent 8 $ par million de tokens en entrée et 40 $ par million en sortie, offrent environ un million de tokens de contexte et 128K en sortie, et visent tous deux le travail de codage agentique de longue durée. Les différences qui détermineront votre choix sont la tarification du cache, la facturation des longs contextes, les particularités d'API que votre harness d'agent doit gérer, et le comportement de chaque modèle sur vos propres tâches.
OpenAI a publié GPT-6.2 Astra le 17 novembre 2026, huit jours après la sortie de Claude Fable 5.2 par Anthropic. Ce guide couvre les spécifications, le coût d'une véritable session d'agent, les erreurs de requête qui font planter un harness conçu pour l'autre modèle, et comment tester les deux avec Apidog CLI.
GPT-6.2 Astra vs Claude Fable 5.2 : le verdict rapide
Choisissez Claude Fable 5.2 si votre agent envoie de longues requêtes et relit un vaste contexte en cache, car ses lectures de cache coûtent deux fois moins cher et l'intégralité de sa fenêtre d'1M est facturée au tarif standard. Choisissez GPT-6.2 Astra si votre stack repose déjà sur l'API Responses d'OpenAI et que vous souhaitez ses outils hébergés, comme apply_patch, le shell hébergé et les sous-agents multi-agents. Dans tous les autres cas, testez les deux sur vos propres tâches avant de vous engager.
Les premières critiques penchent en faveur de Fable sur les capacités brutes. Simon Willison écrivait le jour du lancement qu'Astra « ne fait pas tout à fait aussi bien que Fable 5.2 sur divers benchmarks » et que certains testeurs trouvent son style de communication déroutant. Considérez cela comme un signal d'invitation à tester, non comme un verdict.
Comment se comparent GPT-6.2 Astra et Claude Fable 5.2 en termes de spécifications et de prix ?
Les deux modèles affichent le même prix de base : la comparaison se joue donc dans les détails. Tous les chiffres ci-dessous proviennent de la page du modèle GPT-6.2 Astra et de la présentation de Claude Fable 5.2, vérifiés le 18 novembre 2026.
| Spécification | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| ID du modèle (API) | gpt-6.2-astra |
claude-fable-5-2 |
| Date de sortie | 17 nov. 2026 | 9 nov. 2026 |
| Entrée / sortie par million de tokens | 8 $ / 40 $ | 8 $ / 40 $ |
| Entrée en cache (lecture du cache) | 0,40 $ | 0,20 $ |
| Écriture du cache | 10 $ (30 min), 20 $ (12 h) | 10 $ (5 min), 16 $ (1 h) |
| Fenêtre de contexte | 1 050 000 (922 000 max en entrée) | 1M |
| Sortie maximale | 128 000 | 128K |
| Longues requêtes | Au-delà de 272K en entrée : entrée x2, sortie x1,5 | 1M complet au tarif standard |
| Batch | 50 % de remise | 50 % de remise |
| Date limite des connaissances | 18 mai 2026 | Juin 2026 |
| Contrôle du raisonnement | reasoning.effort (none rejeté) |
effort, défaut high, réflexion toujours activée |
Les deux prix ont baissé de 20 % par rapport à la génération précédente. GPT-6 Astra et Claude Fable 5 étaient tous deux à 10 $ / 50 $, comme le rappelle Willison. Si vous utilisez encore l'ancien modèle, le guide de l'API GPT-6 Astra et le détaillage des tarifs de Claude Fable 5.2 expliquent ce qui a changé.
Combien coûte réellement une session d'agent de codage ?
Un agent de codage envoie rarement une seule requête courte. Il recharge le contexte du dépôt, les définitions d'outils et l'historique de conversation à chaque tour : les lectures de cache et les règles applicables aux longues requêtes comptent donc plus que le prix affiché.
Voici deux charges de travail types, tarifées d'après les barèmes officiels, en traitement Standard.
| Charge de travail | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Session d'agent : 150K tokens écrits dans le cache, 1,35M lectures du cache, 150K en sortie (chaque requête sous 272K) | 1,50 $ + 0,54 $ + 6,00 $ = 8,04 $ | 1,50 $ + 0,27 $ + 6,00 $ = 7,77 $ |
| Une seule longue requête : 400K en entrée, 8K en sortie, sans cache | 6,40 $ + 0,48 $ = 6,88 $ | 3,20 $ + 0,32 $ = 3,52 $ |
Le coût de session est proche car la sortie en constitue l'essentiel : 150K tokens en sortie coûtent 6,00 $ sur l'un ou l'autre modèle. L'écart sur les lectures de cache économise ici 27 cents, un avantage qui croît avec la durée des sessions.
C'est la requête longue unique qui fait diverger les factures. Dès qu'une requête Astra dépasse 272K tokens en entrée, OpenAI double le tarif d'entrée à 16 $ et porte la sortie à 60 $ pour l'ensemble de la requête. Fable 5.2 facture une requête de 400K au même tarif de 8 $ qu'une requête de 4K.
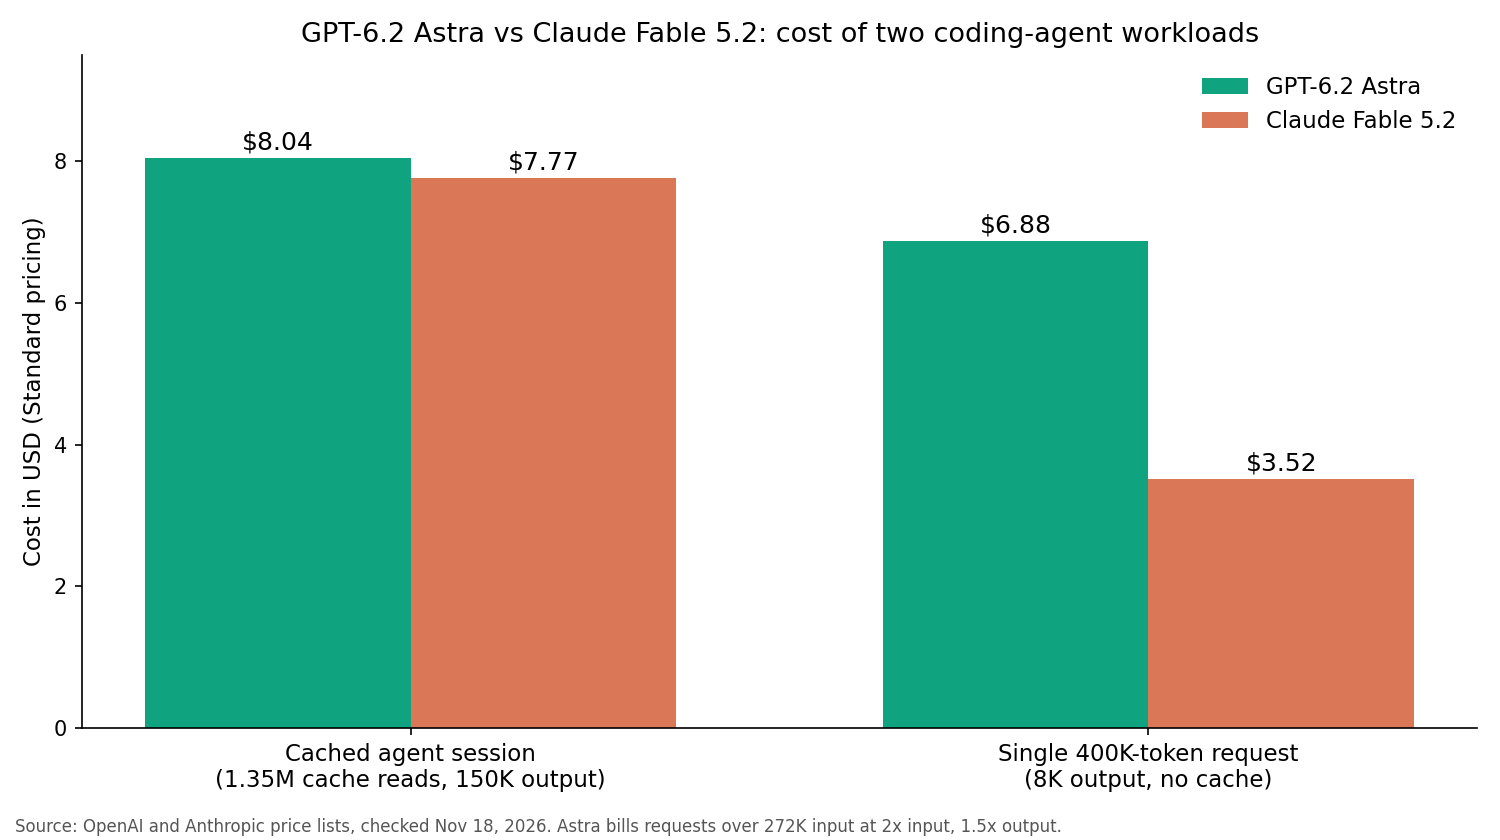
Si votre agent empile un monorepo volumineux ou de longs journaux dans une seule requête, gardez-la sous 272K sur Astra, sinon attendez-vous à payer près du double.
Quelles particularités d'API feront planter un harness conçu pour l'autre modèle ?
Changer de modèle va bien au-delà de la modification de la chaîne du modèle. Chaque API rejette des paramètres que l'autre accepte, et les deux échecs reviennent sous forme d'erreurs HTTP 400.
Claude Fable 5.2 rejette :
- Le forçage de l'utilisation d'outils. Définir
tool_choicesuranyoutoolrenvoie une erreur 400, selon les notes sur Fable 5.2 d'Anthropic. - Les paramètres d'échantillonnage. Omettez
temperature,top_pettop_k; les valeurs listées par Anthropic renvoient une erreur 400. - La désactivation de la réflexion. La réflexion adaptative est toujours active : le paramètre effort est donc votre seul levier pour ajuster profondeur, latence et coût.
GPT-6.2 Astra rejette :
reasoning.effortdéfini surnone(API Responses) oureasoning_effort: "none"(Chat Completions), selon le guide sur le raisonnement d'OpenAI.- Les points de terminaison Realtime, Assistants et fine-tuning, que la page du modèle indique comme non pris en charge.
Si votre harness force un appel d'outil pour obtenir une sortie structurée, cela fonctionne sur Astra mais échoue sur Fable : déplacez la structure dans le prompt ou dans le schéma de l'outil. S'il définit temperature: 0, supprimez ce paramètre pour Fable.
La gestion des données diffère également. Anthropic précise que Fable 5.2 exige une conservation des données de 30 jours et n'est pas disponible en conservation zéro des données, sauf autorisation expresse d'Anthropic. Vérifiez ce point face à votre politique de sécurité avant d'y acheminer du code en production.
Où GPT-6.2 Astra a-t-il l'avantage ?
La force d'Astra réside dans sa boîte à outils. Dans l'API Responses, OpenAI liste apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills et tool_search comme outils pris en charge. Une version bêta multi-agents permet à Astra de déléguer du travail à des sous-agents.
Cela compte si vous préférez ne pas développer vous-même votre applier de patchs et votre exécuteur de shell.
Les retours pré-lancement de Theo Browne, cités par Willison, indiquent qu'Astra « peut mobiliser de nombreux sous-agents et les gérer assez bien » sur des tâches longues, mais qu'il s'arrête parfois pour poser des questions sur des détails internes auxquels un utilisateur ne peut répondre. Donnez-lui des conditions d'arrêt claires.
Astra propose également plus de paliers tarifaires : Batch avec 50 % de remise, mode Fast à 2x le tarif Standard, et des fenêtres d'arrière-plan à 30 % en dessous du tarif Standard pour une exécution en 2 heures, et 40 % en dessous pour une exécution en 8 heures. La génération de tests nocturnes peut s'exécuter à ces tarifs pour moins cher.
Où Claude Fable 5.2 a-t-il l'avantage ?
Fable l'emporte sur les contextes longs et gourmands en cache. Ses lectures de cache coûtent 0,20 $ par million de tokens, soit 2,5 % du prix d'entrée, et l'intégralité de sa fenêtre d'1M est facturée au tarif standard, sans multiplicateur pour les longues requêtes.
Anthropic positionne Fable 5.2 pour des sessions d'agent qui s'exécutent pendant des heures. Son contrôle d'effort va de low à max ; Anthropic conseille de démarrer à high, la valeur par défaut, et de passer à xhigh uniquement là où vous avez mesuré un gain.
Il bénéficie aussi du meilleur accueil précoce sur le codage créatif exigeant. Dans le test de lancement de Willison — un prompt d'animation Three.js exécuté sur les deux nouveaux modèles OpenAI à l'effort Ultra dans Codex CLI — aucun n'a égalé le résultat obtenu avec Fable 5.2.
Fable fonctionne également sur Amazon Bedrock, Google Cloud et Microsoft Foundry, et son mode Fast offre une vitesse de sortie jusqu'à 2,5 fois supérieure à 16 $ / 80 $ par million de tokens. Pour des exemples de requêtes, consultez le guide de l'API Claude Fable 5.2.
Comment tester GPT-6.2 Astra et Claude Fable 5.2 sur votre propre charge de travail API ?
Les benchmarks mesurent les tâches des autres. Exécutez plutôt les mêmes prompts à travers les deux API :
- Choisissez 5 à 10 prompts réels issus de l'historique de votre agent, par exemple une correction de bug, un refactoring et une tâche d'écriture de tests.
- Écrivez une requête par modèle avec un contenu identique, au format propre à chaque API.
- Vérifiez un statut 200, une réponse non vide et la structure que votre agent analyse.
- Exécutez chaque requête plusieurs fois et comparez les tokens, la latence et le taux de réussite.
Les deux appels sont de simples requêtes HTTP. Voici la requête Astra sur l'API Responses :
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 passe par l'API Messages d'Anthropic avec claude-fable-5-2 comme modèle et sans champ temperature.
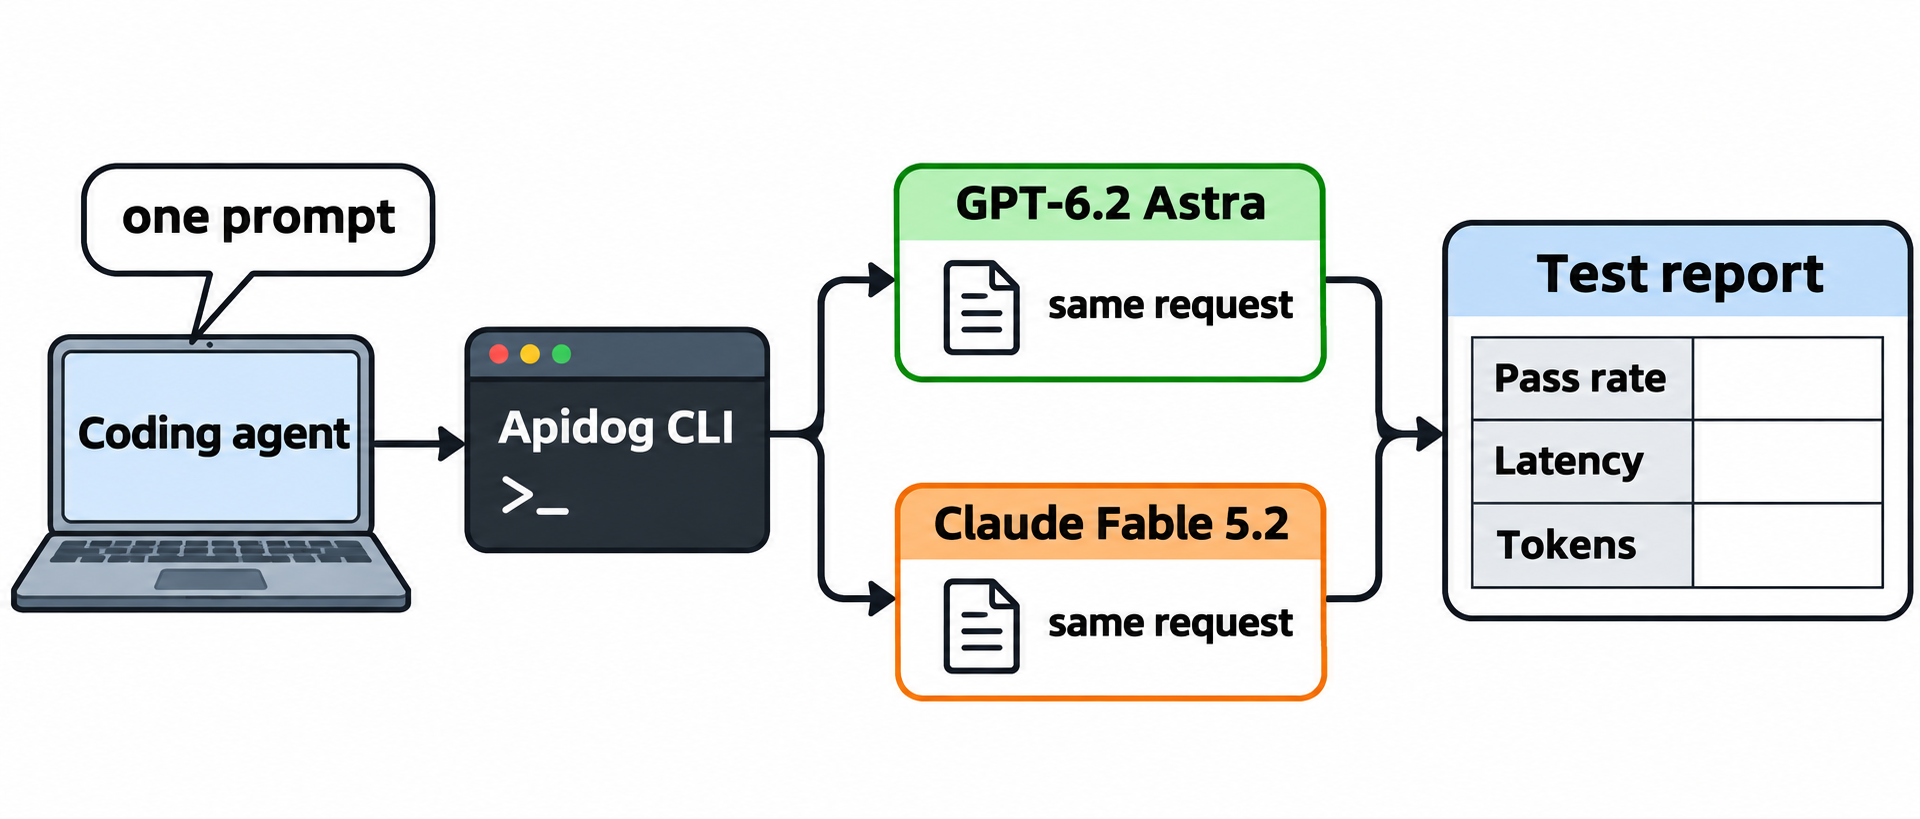
Laissez votre agent de codage exécuter le test A/B avec Apidog CLI
Exécuter des paires de requêtes à la main devient vite pénible. Laissez plutôt Claude Code, Codex ou Cursor piloter Apidog CLI. La configuration prend trois commandes :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite à votre agent un seul prompt :
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
L'agent vérifie le schéma des payloads, écrit les cas et les exécute. Les indicateurs ci-dessous proviennent de apidog run --help sur la CLI 2.2.12 :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 répète chaque cas cinq fois, afin qu'une réponse lente ne décide pas du résultat. Ajoutez --upload-report pour consulter les exécutions dans l'application Apidog. Il s'agit d'un modèle de workflow ; nous ne l'avons pas exécuté sur Astra depuis cette machine.
Vous pouvez aussi transformer la section sur les particularités en tests. Demandez à l'agent un cas négatif qui envoie tool_choice: any à Fable et attend une erreur 400, et un autre qui envoie effort: none à Astra et attend une erreur 400. Si l'un des fournisseurs modifie la règle, votre suite vous le signale avant votre agent. Le guide Apidog CLI dans Claude Code et le guide Apidog CLI dans Codex couvrent la configuration de l'agent.
Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs, ce qui suffit pour réaliser cette comparaison.
FAQ
GPT-6.2 Astra est-il moins cher que Claude Fable 5.2 ? Le prix de base est identique : 8 $ en entrée et 40 $ en sortie par million de tokens. Fable est moins cher sur les lectures de cache (0,20 $ contre 0,40 $) et sur toute requête dépassant 272K tokens en entrée, où Astra double son tarif d'entrée.
Quel modèle offre la plus grande fenêtre de contexte ? Astra affiche 1 050 000 tokens de contexte avec un plafond de 922 000 tokens en entrée. Fable 5.2 affiche 1M tokens. Les deux plafonnent la sortie à 128K tokens par requête.
Puis-je forcer les appels d'outils avec Claude Fable 5.2 ? Non. Un tool_choice défini sur any ou tool renvoie une erreur 400. Laissez le modèle choisir les outils lui-même et décrivez la structure attendue dans le prompt ou dans le schéma de l'outil.
Puis-je désactiver le raisonnement sur GPT-6.2 Astra ? Non. L'API rejette reasoning.effort défini sur none avec une erreur 400. Choisissez plutôt un niveau d'effort pris en charge plus bas pour des appels rapides et économiques.
Sur quel modèle exécuter mon agent de codage ? Partez de votre charge de travail. Les prompts longs et gourmands en cache favorisent Fable 5.2, tandis que les stacks natifs OpenAI qui veulent des outils hébergés de patch, de shell et de sous-agents favorisent Astra. Testez les deux sur 5 à 10 prompts réels avant de basculer.