
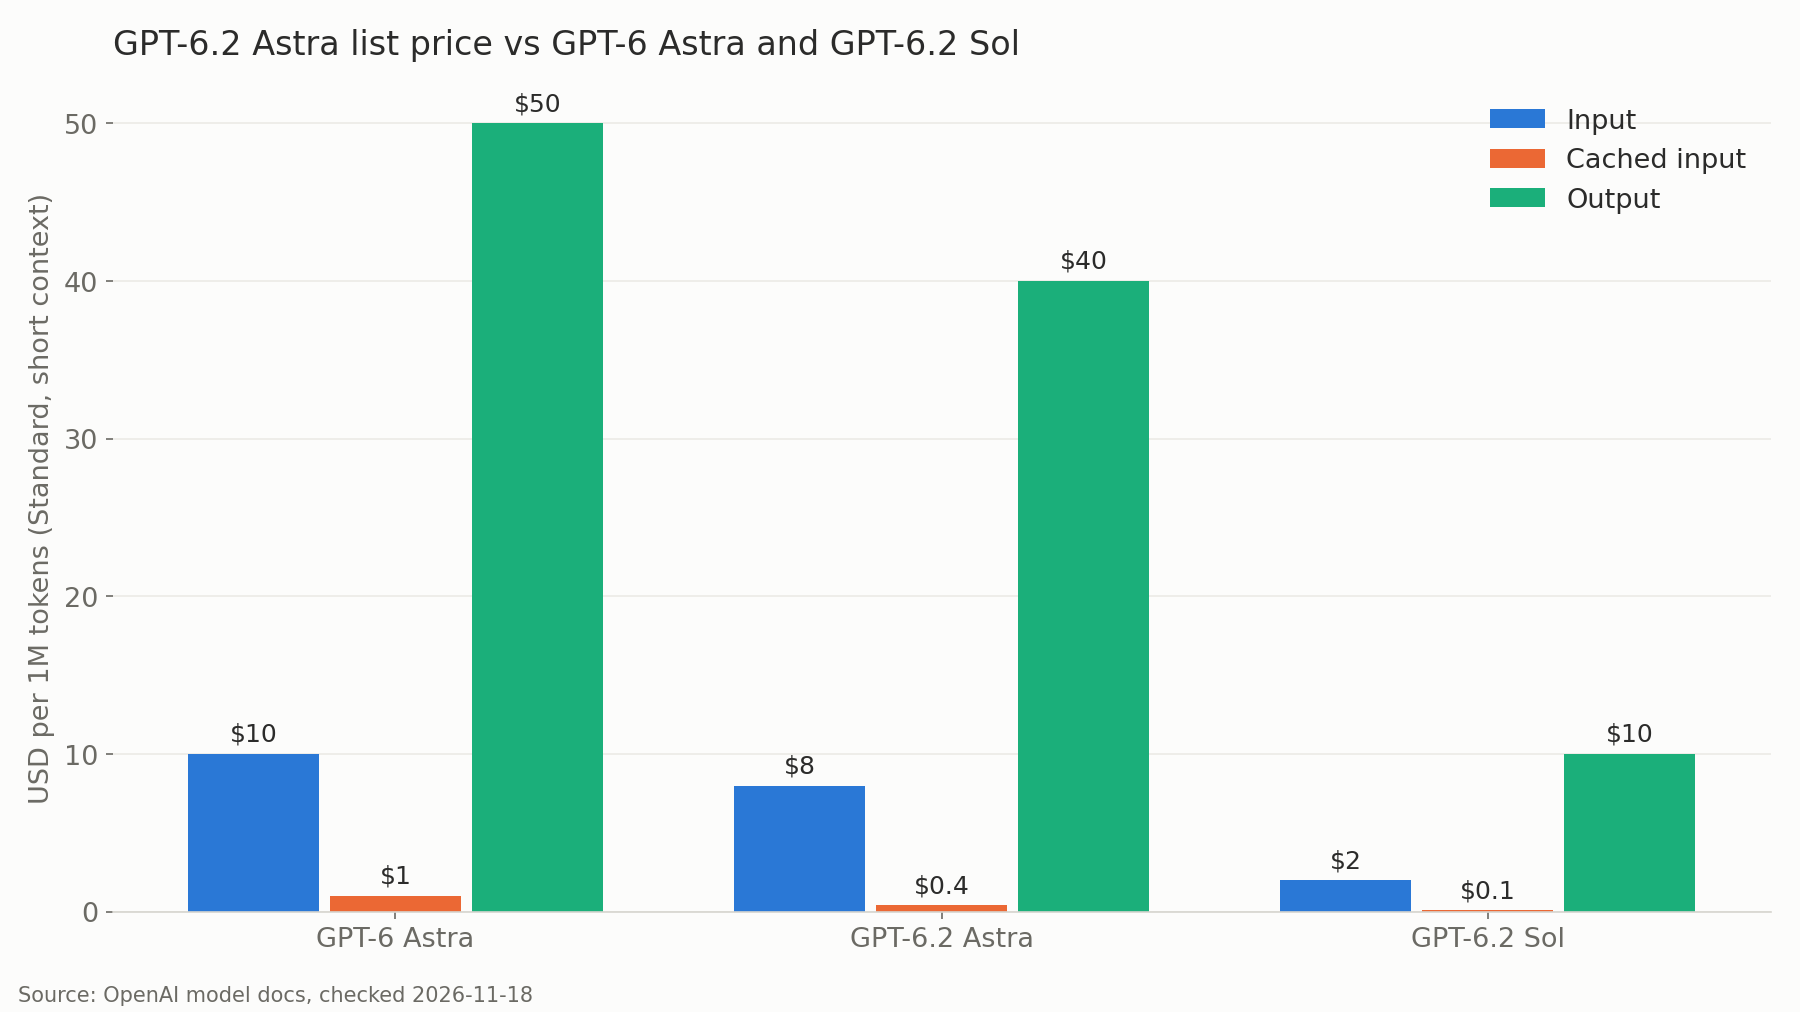
La tarification de GPT-6.2 Astra est de 8 $ par million de tokens d'entrée et de 40 $ par million de tokens de sortie sur le palier Standard d'OpenAI, avec une entrée en cache à 0,40 $ par million. C'est 20 % en dessous de GPT-6 Astra (10 $/50 $), et le tarif de lecture du cache a baissé de 60 %. Son modèle jumeau, GPT-6.2 Sol, coûte 2 $ en entrée et 10 $ en sortie par million de tokens.
OpenAI a publié les deux modèles le 17 novembre 2026 sous les identifiants gpt-6.2-astra et gpt-6.2-sol.
La tarification de GPT-6.2 Astra en un coup d'œil
GPT-6.2 Astra est le modèle de pointe d'OpenAI pour les projets longs et complexes : codage, utilisation de l'ordinateur et traitement de documents, avec une fenêtre de contexte de 1 050 000 tokens et jusqu'à 128 000 tokens de sortie. Sur le palier Standard, il est facturé 8 $ par million de tokens d'entrée, 0,40 $ par million de tokens d'entrée en cache et 40 $ par million de tokens de sortie, pour des prompts allant jusqu'à 272 000 tokens.
| Tarif (par million de tokens, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Entrée | 8,00 $ | 2,00 $ | 10,00 $ |
| Entrée en cache | 0,40 $ | 0,10 $ | 1,00 $ |
| Écriture en cache (30 minutes) | 10,00 $ | 2,50 $ | 12,50 $ |
| Écriture en cache (12 heures) | 20,00 $ | 5,00 $ | 25,00 $ |
| Sortie | 40,00 $ | 10,00 $ | 50,00 $ |
Les tokens de raisonnement sont facturés comme des tokens de sortie. Cela compte pour Astra, car le modèle refuse les requêtes qui définissent l'effort de raisonnement sur none : chaque appel entraîne donc un coût de raisonnement en plus de la réponse visible.
Coût API de GPT-6.2 Astra par token
Un token d'entrée coûte 0,000008 $ et un token de sortie coûte 0,00004 $. La sortie est 5 fois plus chère que l'entrée : ce que le modèle écrit, raisonnement caché compris, constitue donc l'essentiel de votre facture.
Une requête de chat typique avec 3 000 tokens d'entrée et 800 tokens de sortie coûte :
- GPT-6.2 Astra : 0,024 $ d'entrée + 0,032 $ de sortie = 0,056 $
- GPT-6.2 Sol : 0,006 $ + 0,008 $ = 0,014 $
- GPT-6 Astra : 0,030 $ + 0,040 $ = 0,070 $
Transposez cela à une application servant 20 000 requêtes de ce type par jour. Sur 30 jours, cela représente 600 000 requêtes : environ 33 600 $ sur GPT-6.2 Astra, 8 400 $ sur GPT-6.2 Sol et 42 000 $ sur GPT-6 Astra. Sol conserve le même tarif public de 2 $/10 $ que GPT-6 Sol et GPT-6.1 Sol : si votre budget est déjà calé sur Sol, rien ne change.
La tarification du cache de GPT-6.2 Astra : le plus grand changement
La baisse phare est de 20 %, mais celle du cache est plus importante. Les lectures en cache sur GPT-6.2 Astra coûtent 0,40 $ par million, soit 0,05x le tarif d'entrée. GPT-6 Astra facturait 1,00 $, soit 0,1x. Le guide du prompt caching d'OpenAI confirme que le tarif de lecture à 0,05x s'applique à GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol et GPT-6.1 Terra.
Trois règles déterminent ce que vous payez :
- Les écritures remplacent l'entrée, elles ne s'additionnent pas. Un token écrit dans le cache est facturé au tarif d'écriture au lieu du tarif d'entrée, jamais les deux. Une écriture de 30 minutes coûte 1,25x le tarif d'entrée (10 $ sur Astra) ; une écriture de 12 heures coûte 2,5x (20 $).
- Le préfixe minimum est de 1 024 tokens. Les prompts plus courts ne sont jamais mis en cache.
- Les lectures coûtent le même prix pour les deux durées de vie. Ne choisissez les écritures de 12 heures que pour des prompts système stables et des documents de référence réutilisés sur de longs intervalles.
À ces tarifs, le cache est rentable dès la première réutilisation. Une écriture de 30 minutes plus une lecture coûtent 1,30x le prix d'un préfixe non mis en cache, contre 2x pour l'envoyer deux fois. Sur dix requêtes, c'est 1,70x contre 10x.
Simon Willison a qualifié ce tarif en cache de « excellente nouvelle pour les sessions agentiques de longue durée » dans son article du jour du lancement. Pour les tactiques, consultez notre guide du prompt caching avec GPT-6.
Le coût d'une session agent de 50 tours
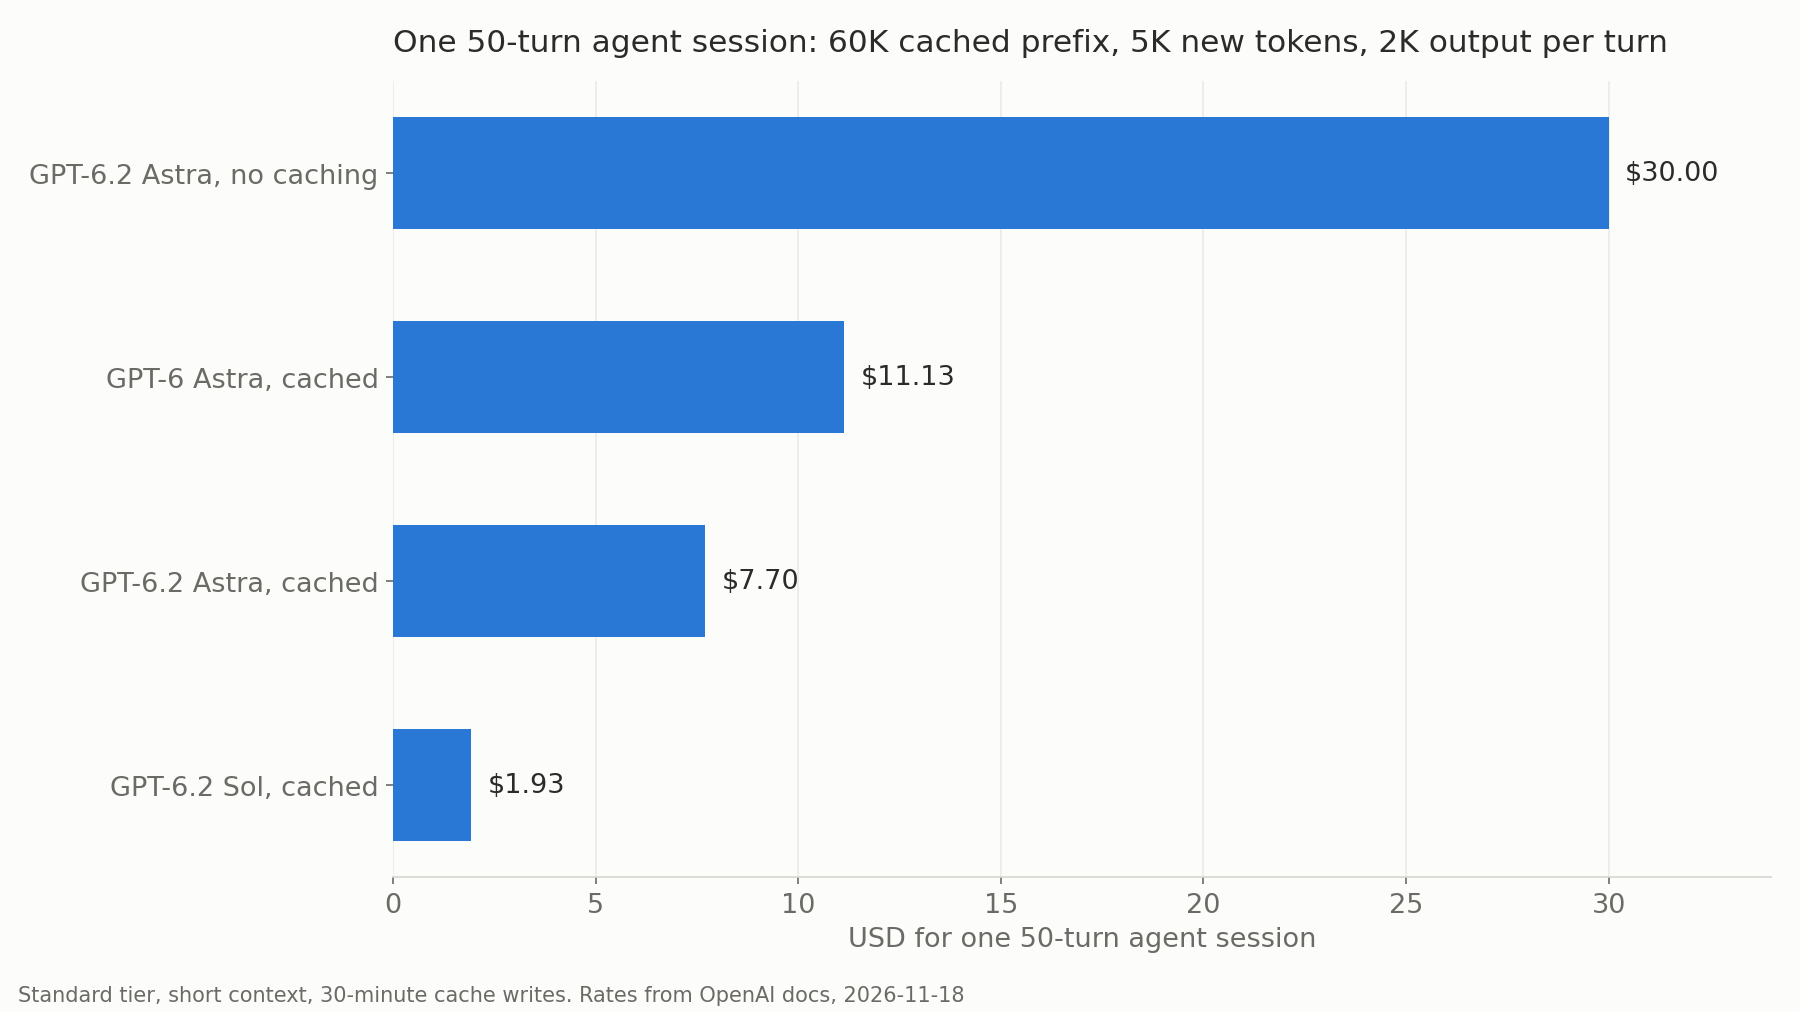
Prenons un agent de codage qui exécute 50 tours. À chaque tour, il relit un préfixe de 60 000 tokens depuis le cache, écrit 5 000 nouveaux tokens dans un cache de 30 minutes et produit 2 000 tokens de sortie.
| Modèle et configuration | Coût par tour | Coût par session |
|---|---|---|
| GPT-6.2 Astra, sans cache | 0,600 $ | 30,00 $ |
| GPT-6 Astra, avec cache | 0,223 $ | 11,13 $ |
| GPT-6.2 Astra, avec cache | 0,154 $ | 7,70 $ |
| GPT-6.2 Sol, avec cache | 0,039 $ | 1,93 $ |
Le cache réduit la session GPT-6.2 Astra de 74 %. Face à GPT-6 Astra avec le même cache, le nouveau modèle est 31 % moins cher par session, soit plus que la baisse de 20 % du tarif public, car le préfixe en cache représente la plus grande part de l'entrée.
Tarification long contexte au-delà de 272 000 tokens
GPT-6.2 Astra accepte jusqu'à 922 000 tokens d'entrée, mais le prix change à partir de 272 000. Dès que l'entrée d'une requête dépasse 272 000 tokens, les tarifs d'entrée et de cache doublent et la sortie passe à 1,5x, pour toute la requête, et pas seulement pour le dépassement.
| Tarif (par million de tokens) | Jusqu'à 272 000 tokens d'entrée | Plus de 272 000 tokens d'entrée |
|---|---|---|
| Entrée | 8,00 $ | 16,00 $ |
| Entrée en cache | 0,40 $ | 0,80 $ |
| Écriture en cache (30 minutes) | 10,00 $ | 20,00 $ |
| Sortie | 40,00 $ | 60,00 $ |
Une revue unique d'une base de code de 400 000 tokens avec 4 000 tokens de sortie coûte 6,40 $ + 0,24 $ = 6,64 $. Ramenez la même revue à 250 000 tokens et elle tombe à 2,00 $ + 0,16 $ = 2,16 $. Si vous exécutez la revue de 400 000 tokens de façon répétée avec 380 000 tokens servis depuis le cache et 20 000 nouveaux tokens écrits, elle coûte environ 0,94 $ par exécution.
La récupération (retrieval) et le raccourcissement de prompts portent leurs fruits quand un prompt se situe juste au-dessus de 272 000 tokens.
Batch, fenêtres en arrière-plan, Fast et Ultrafast
La page de tarification d'OpenAI liste GPT-6.2 Astra sous quatre paliers de traitement, auxquels s'ajoutent des fenêtres en arrière-plan à tarif réduit. GPT-6.2 n'apparaît pas dans le tableau Flex : les fenêtres en arrière-plan jouent donc ce rôle pour les tâches qui peuvent attendre.
| Palier (contexte court) | Astra entrée / sortie | Sol entrée / sortie |
|---|---|---|
| Standard | 8 $ / 40 $ | 2 $ / 10 $ |
| Batch (−50 %) | 4 $ / 20 $ | 1 $ / 5 $ |
| Arrière-plan, fenêtre 8 heures (−40 %) | 4,80 $ / 24 $ | 1,20 $ / 6 $ |
| Arrière-plan, fenêtre 2 heures (−30 %) | 5,60 $ / 28 $ | 1,40 $ / 7 $ |
| Fast (2x) | 16 $ / 80 $ | 4 $ / 20 $ |
| Ultrafast, jusqu'au 28 février 2027 (3x) | 24 $ / 120 $ | 6 $ / 30 $ |
| Ultrafast, à partir du 1er mars 2027 (6x) | 48 $ / 240 $ | 12 $ / 60 $ |
Les fenêtres en arrière-plan sont en bêta publique sur l'API Responses. Vous définissez background sur true et background_options.completion_window sur 2h ou 8h, et laissez le streaming désactivé. Le guide du mode arrière-plan signale deux pièges : ces requêtes partagent la limite de débit de Batch, et les requêtes Standard ne peuvent pas réutiliser les entrées de cache créées par des requêtes 2h ou 8h.
Voici un job nocturne qui résume 10 000 documents, chacun avec 4 000 tokens d'entrée et 500 tokens de sortie :
| Palier | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | 520 $ | 130 $ |
| Arrière-plan, 2 heures | 364 $ | 91 $ |
| Arrière-plan, 8 heures | 312 $ | 78 $ |
| Batch | 260 $ | 65 $ |
Le tarif 3x d'Ultrafast est une promotion ; le 1er mars 2027, il double à 6x : ne bâtissez pas votre budget dessus.
GPT-6.2 Astra face à GPT-6.2 Sol et aux modèles phares concurrents
Astra coûte exactement 4 fois le prix de Sol sur chaque ligne. La page du modèle Sol liste le même contexte de 1 050 000 tokens, le même plafond de sortie de 128 000 tokens, les mêmes outils et les mêmes limites de débit. Le choix se résume donc à la qualité par tâche, pas aux fonctionnalités.
| Modèle (par million de tokens) | Entrée | Lecture en cache | Sortie |
|---|---|---|---|
| GPT-6.2 Astra | 8,00 $ | 0,40 $ | 40,00 $ |
| Claude Fable 5.2 | 8,00 $ | 0,20 $ | 40,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
| GPT-6.2 Sol | 2,00 $ | 0,10 $ | 10,00 $ |
Les tarifs de Claude proviennent de la page de tarification d'Anthropic, vérifiée le 18 novembre 2026. GPT-6.2 Astra et Claude Fable 5.2 partagent le même tarif public de 8 $/40 $ ; les accès au cache de Fable 5.2 coûtent 0,20 $ et ses tarifs d'écriture suivent les durées de vie de 5 minutes et 1 heure d'Anthropic, et non celles de 30 minutes et 12 heures d'OpenAI : comparez donc le coût réel sur votre propre trafic.
Les premières critiques sont mitigées sur la qualité. Willison note que GPT-6.2 Astra « n'obtient pas des scores aussi élevés que Fable 5.2 sur divers benchmarks » : lancez donc votre propre évaluation avant de vous engager. Si vous venez de la génération précédente, notre guide de l'API GPT-6 Astra couvre la structure des requêtes, et la migration de GPT-6 Astra vers Sol explique quand le modèle moins cher suffit.
Les deux modèles partagent les mêmes limites de débit Standard : 5 000 requêtes et 1 million de tokens par minute sur le palier Build, jusqu'à 15 000 requêtes et 40 millions de tokens par minute sur Grow.
Laissez Codex vérifier vos coûts GPT-6.2 Astra avec Apidog CLI
Les tableaux de tarifs ne servent que si vos requêtes exploitent réellement le cache et restent sous 272 000 tokens. Votre agent de codage peut le vérifier à chaque build avec Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite une seule instruction à votre agent :
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
L'agent lit le schéma, valide sa charge utile, crée le cas de test et l'exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Si une modification de prompt casse le cache ou pousse une requête au-delà de 272 000 tokens, l'exécution échoue avant l'arrivée de la facture. Le même apidog run avec -r junit s'intègre au CI ; notre guide sur le pipeline CI/CD avec Apidog CLI propose une configuration prête à copier-coller, et Apidog CLI dans Codex couvre le côté agent. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Combien coûte GPT-6.2 Astra par million de tokens ? 8 $ par million de tokens d'entrée, 0,40 $ par million de tokens d'entrée en cache et 40 $ par million de tokens de sortie sur le palier Standard, pour des requêtes allant jusqu'à 272 000 tokens d'entrée.
GPT-6.2 Astra est-il moins cher que GPT-6 Astra ? Oui. L'entrée et la sortie sont 20 % moins chères (8 $/40 $ contre 10 $/50 $) et les lectures en cache 60 % moins chères (0,40 $ contre 1,00 $). Notre session agent avec cache s'est révélée 31 % moins chère.
Combien coûte GPT-6.2 Sol ? 2 $ par million de tokens d'entrée, 0,10 $ en cache et 10 $ en sortie, soit le même tarif public que GPT-6.1 Sol et GPT-6 Sol. C'est le quart du prix d'Astra sur chaque ligne.
GPT-6.2 Astra facture-t-il plus pour les longs prompts ? Oui. Au-delà de 272 000 tokens d'entrée, les tarifs d'entrée et de cache doublent et la sortie passe à 1,5x pour toute la requête : 16 $ d'entrée, 0,80 $ en cache et 60 $ de sortie par million de tokens.
Puis-je obtenir une réduction sur GPT-6.2 Astra ? Batch coûte 50 % du tarif Standard. Les requêtes en arrière-plan sur l'API Responses bénéficient de 30 % de réduction avec une fenêtre de 2 heures ou de 40 % avec une fenêtre de 8 heures (bêta publique). Le cache réduit les préfixes répétés à 0,05x le tarif d'entrée.
Les tokens de raisonnement comptent-ils dans la facture de GPT-6.2 Astra ? Oui. Les tokens de raisonnement sont facturés au tarif de sortie de 40 $ par million, et le modèle refuse un effort de raisonnement none : prévoyez donc un budget de raisonnement à chaque appel.