
GPT-6.1 Terra coûte 1 $ par million de tokens d'entrée, 0,05 $ par million de tokens d'entrée mis en cache et 5 $ par million de tokens de sortie sur l'API d'OpenAI. Batch et Flex réduisent ces tarifs de moitié, le mode Fast les double, et les prompts dépassant 272K tokens d'entrée coûtent plus cher. OpenAI affirme que c'est « 50 % moins cher » que GPT-5.6 Terra. Pour la sortie, la ligne qui domine généralement la facture d'un agent, la baisse réelle est de 58 %, et par rapport au prix de lancement de GPT-5.6 Terra, elle est de 67 %.
Ce guide détaille chaque tarif, l'historique des prix, le coût d'un appel typique sur Terra et ses voisins, et comment réduire encore la facture. Pour en savoir plus sur le modèle lui-même, voir ce qu'est GPT-6.1 Terra.
La grille tarifaire complète de GPT-6.1 Terra
Par million de tokens, pour des prompts allant jusqu'à 272K tokens d'entrée :
| Palier | Entrée | Entrée mise en cache | Écriture de cache (30 min) | Écriture de cache (12 h) | Sortie |
|---|---|---|---|---|---|
| Standard | 1,00 $ | 0,05 $ | 1,25 $ | 2,50 $ | 5,00 $ |
| Batch / Flex | 0,50 $ | 0,025 $ | n/a | n/a | 2,50 $ |
| Mode Fast (2x) | 2,00 $ | 0,10 $ | n/a | n/a | 10,00 $ |
Les règles qui modifient la facture, toutes issues de la page du modèle GPT-6.1 Terra et de la page de tarification d'OpenAI :
- Au-delà de 272K tokens d'entrée : la totalité de la requête est facturée au double des tarifs d'entrée et de cache et à 1,5 fois la sortie. En Standard, cela donne 2 $ en entrée, 0,10 $ en cache et 7,50 $ en sortie.
- Traitement régional : une majoration de 10 % là où la résidence des données est disponible.
- Les tokens de raisonnement sont facturés comme de la sortie, donc le réglage de l'effort fait bouger votre ligne de sortie.
- Batch et Flex bénéficient de 50 % de remise par rapport au Standard. Batch est asynchrone ; Flex exécute les requêtes normales plus lentement et peut renvoyer des 429.
Les points de terminaison openai/gpt-6.1-terra d'OpenRouter appliquent ces mêmes tarifs : flex 0,50 $/2,50 $, standard 1 $/5 $ et fast 2 $/10 $, avec les mêmes tarifs majorés au-delà de 272K. Il n'existe pas de point de terminaison gratuit ni de niveau d'API gratuit. Notre guide sur la gratuité de GPT-6.1 Terra couvre les différentes formules.
La vraie baisse par rapport à GPT-5.6 Terra
L'annonce d'OpenAI qualifie Terra de « nette progression par rapport à GPT-5.6 Terra, avec des prix d'API standard 50 % moins élevés ». Voici la généalogie qui sous-tend cette phrase :
| Entrée | Entrée mise en cache | Sortie | |
|---|---|---|---|
| GPT-5.6 Terra au lancement (juillet 2026) | 2,50 $ | n/a | 15,00 $ |
| GPT-5.6 Terra aujourd'hui | 2,00 $ | 0,20 $ | 12,00 $ |
| GPT-6.1 Terra | 1,00 $ | 0,05 $ | 5,00 $ |
| Baisse par rapport au prix actuel | 50 % | 75 % | 58 % |
| Baisse par rapport au prix de lancement | 60 % | n/a | 67 % |
L'entrée est exactement divisée par deux. Tout le reste a baissé davantage. Un agent qui réutilise un gros préfixe mis en cache et génère beaucoup de sortie paie bien moins de la moitié de ce qu'il payait sur GPT-5.6 Terra. Notre article sur le lancement de GPT-5.6 Terra contient les tarifs d'origine.
Terra face au reste du marché
| Modèle | Entrée | Entrée mise en cache | Sortie |
|---|---|---|---|
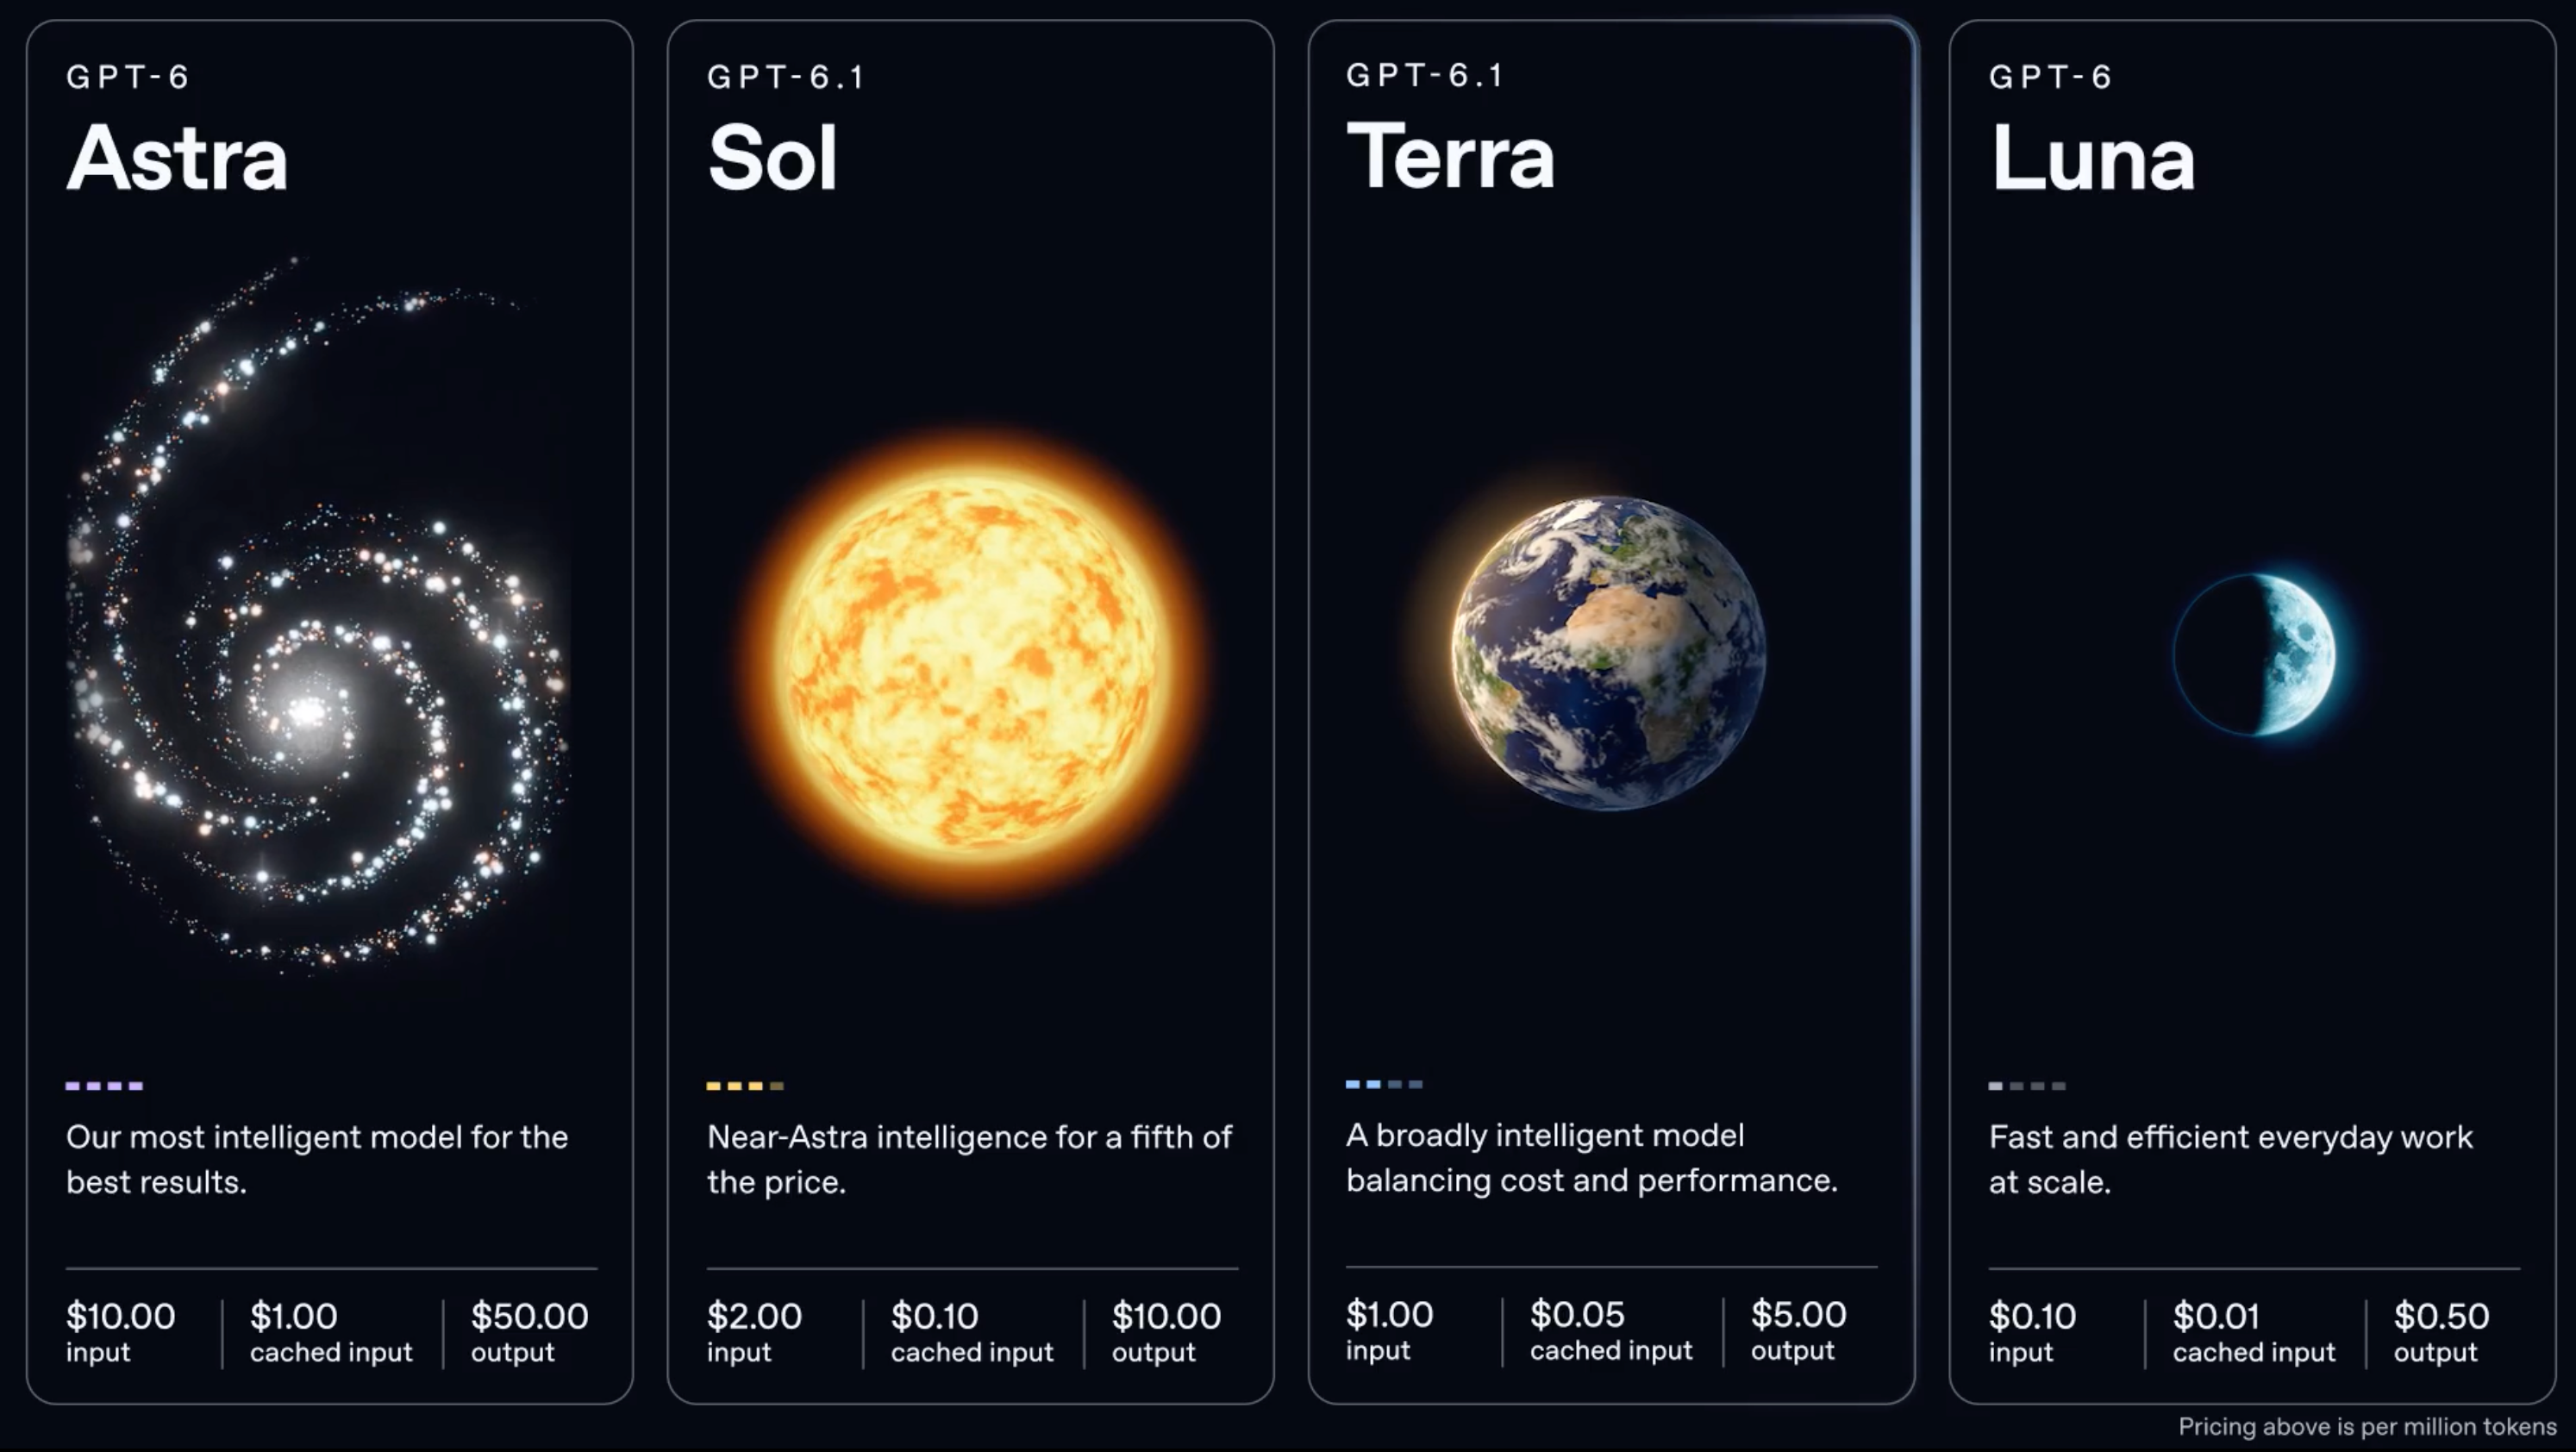
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ |
| GPT-6.1 Sol | 2,00 $ | 0,10 $ | 10,00 $ |
| Claude Sonnet 5.5 | 2,00 $ | 0,10 $ | 10,00 $ |
| GPT-6.1 Terra | 1,00 $ | 0,05 $ | 5,00 $ |
| GPT-6 Luna | 0,10 $ | 0,01 $ | 0,50 $ |
| Claude Haiku 5.5 (jusqu'à 100K) | 0,10 $ | 0,01 $ | 0,50 $ |
Terra est à la moitié de GPT-6.1 Sol et de Claude Sonnet 5.5 sur chaque ligne, et dix fois GPT-6 Luna et Claude Haiku 5.5. Aucun autre modèle de ce tableau ne se situe au point 1 $/5 $. Sa concurrence, c'est la décision de descendre vers un modèle économique ou de monter vers un modèle à 2 $/10 $.
Notez les règles différentes pour les prompts longs : Terra et Luna deviennent plus chers au-delà de 272K tokens d'entrée, tandis que Haiku 5.5 passe à 0,50 $/2,50 $ au-delà de 100K.
Combien coûte un appel typique
Prenons une étape d'agent : un préfixe de 100 000 tokens mis en cache (prompt système, schémas d'outils, contexte du dépôt), 8 000 nouveaux tokens d'entrée et 2 000 tokens de sortie, raisonnement inclus.
Sur GPT-6.1 Terra en Standard :
- Entrée mise en cache : 100 000 x 0,05 $ / 1 000 000 = 0,0050 $
- Nouvelle entrée : 8 000 x 1,00 $ / 1 000 000 = 0,0080 $
- Sortie : 2 000 x 5,00 $ / 1 000 000 = 0,0100 $
- Total : 0,0230 $
Le même appel selon les modèles et les paliers :
| Modèle et palier | Par appel | Pour 10 000 appels |
|---|---|---|
| GPT-6 Luna, Standard | 0,0028 $ | 28 $ |
| GPT-6.1 Terra, Batch / Flex | 0,0115 $ | 115 $ |
| GPT-6.1 Terra, Standard | 0,0230 $ | 230 $ |
| GPT-6.1 Sol, Standard | 0,0460 $ | 460 $ |
| GPT-5.6 Terra, Standard (prix actuel) | 0,0600 $ | 600 $ |
| GPT-6.1 Terra, mode Fast | 0,0460 $ | 460 $ |
| GPT-6 Astra, Standard | 0,2800 $ | 2 800 $ |
Sur GPT-5.6 Terra, l'appel coûte 0,020 $ en cache + 0,016 $ de nouvelle entrée + 0,024 $ de sortie = 0,060 $, donc passer à 6.1 Terra permet d'économiser 62 % sur cette charge de travail. Le mode Fast sur Terra coûte autant que le Standard sur Sol, ce qui pose une question légitime : voulez-vous Terra plus rapide ou Sol plus intelligent ?
Le tableau suppose les mêmes nombres de tokens pour chaque modèle. En pratique, ils diffèrent : un modèle qui raisonne plus longtemps ou écrit davantage consomme plus de tokens de sortie. Artificial Analysis a mesuré Terra à 0,40 $ par tâche en effort maximal sur sa suite de benchmarks, contre 1,40 $ pour GPT-5.6 Terra, ce qui capture à la fois l'usage de tokens et le prix.
Les deux leviers qui comptent le plus
Votre taux de succès du cache. Sans aucun cache, l'appel ci-dessus facture les 108 000 tokens d'entrée à 1 $ : 0,108 $ plus 0,010 $ de sortie, soit 0,118 $ au total. C'est cinq fois le coût avec cache. La mise en cache est automatique pour les prompts d'au moins 1 024 tokens, mais seul un préfixe stable est réutilisé. Placez le prompt système et les schémas d'outils en premier, et le contenu propre à chaque requête en dernier. Notre guide de mise en cache des prompts GPT-6 va plus loin.
Rester sous 272K. À 280 000 tokens d'entrée, toute la requête bascule vers les tarifs de contexte long. Un appel avec 280K de nouvelle entrée et 2K de sortie coûte 0,56 $ + 0,015 $ = 0,575 $ au lieu des 0,29 $ que laisseraient supposer les tarifs de base. Si la récupération vous rapproche de la limite, réduisez les segments avant de la franchir.
Ensuite, utilisez Batch ou Flex pour tout ce qui peut attendre (évaluations, rattrapages, résumés nocturnes) afin de réduire le reste de moitié. Le guide de l'API Batch d'OpenAI détaille la marche à suivre.
Tarification des offres ChatGPT
Dans ChatGPT, Terra n'est pas facturé au token. Il est inclus pour les utilisateurs Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex, et OpenAI indique que votre quota d'utilisation « va plus loin » avec Terra qu'avec GPT-5.6 Terra, et bien plus loin qu'avec GPT-6.1 Sol ou GPT-6 Astra. Les utilisateurs Free et Go disposent quant à eux de GPT-6 Luna dans l'application de bureau. Aucune de ces offres n'est fournie avec une clé API.
Laissez votre agent de codage suivre le coût réel avec Apidog CLI
Les calculs ci-dessus utilisent des nombres de tokens donnés en exemple. Ce sont vos prompts qui déterminent la facture réelle, et votre agent de codage peut les mesurer à chaque modification avec Apidog CLI.
Configuration initiale :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Ensuite, donnez à votre agent un seul prompt :
In Apidog project <id>, create a test case for POST https://api.openai.com/v1/responses
using model gpt-6.1-terra and the prompt in prompts/agent-step.txt. Assert status 200,
usage.input_tokens under 272000, and usage.input_tokens_details.cached_tokens greater
than 0 on the second iteration. Run 2 iterations against the <env> environment and
report the cost per call at $1 input, $0.05 cached and $5 output per million tokens.
L'agent vérifie le schéma, crée le cas de test et l'exécute :
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -n 2 -r cli,json
Les deux assertions protègent les deux leviers : un prompt qui dépasse 272K ou qui cesse de toucher le cache fait échouer le test. Ajoutez l'exécution à votre CI avec -r junit (voir notre guide CI/CD d'Apidog CLI) et une modification coûteuse de prompt apparaîtra dans la pull request, pas sur la facture. Pour une configuration dans un agent spécifique, lisez Apidog CLI dans Claude Code.
FAQ
Combien coûte GPT-6.1 Terra ? 1 $ par million de tokens d'entrée, 0,05 $ pour l'entrée mise en cache et 5 $ pour la sortie en Standard, pour des prompts allant jusqu'à 272K tokens d'entrée.
GPT-6.1 Terra est-il moins cher que GPT-5.6 Terra ? Oui. L'entrée est 50 % moins chère (1 $ contre 2 $), l'entrée mise en cache 75 % moins chère (0,05 $ contre 0,20 $) et la sortie 58 % moins chère (5 $ contre 12 $) que le prix actuel de GPT-5.6 Terra.
Comment le prix de Terra se compare-t-il à celui de GPT-6.1 Sol ? Exactement la moitié sur chaque ligne. Sol est à 2 $ en entrée, 0,10 $ en cache et 10 $ en sortie.
Combien coûte le mode Fast ? Le double du Standard : 2 $ en entrée et 10 $ en sortie par million de tokens.
Que se passe-t-il au-delà de 272K tokens d'entrée ? La totalité de la requête est facturée au double des tarifs d'entrée et de cache et à 1,5 fois la sortie : 2 $, 0,10 $ et 7,50 $ par million en Standard.
En résumé
GPT-6.1 Terra est le modèle performant le moins cher vendu par OpenAI : la moitié de Sol et de Sonnet 5.5, et moins de la moitié du Terra qu'il remplace une fois la sortie et la mise en cache prises en compte. Les deux facteurs qui influent le plus sur votre facture sont le taux de succès du cache et la limite des 272K, alors surveillez les deux avec un test. Commencez par le guide de l'API GPT-6.1 Terra, et si vous hésitez entre les paliers, lisez GPT-6.1 Terra vs GPT-6.1 Sol.