
OpenAI a rendu GPT-5.6 généralement disponible le 9 juillet 2026, et la première décision qu'il impose n'a rien à voir avec la mise à niveau. C'est un choix de menu. La version est livrée sous la forme de trois modèles, gpt-5.6-sol, gpt-5.6-terra et gpt-5.6-luna, situés à trois points de la courbe coût-capacité. Choisissez trop haut et vous payez les tarifs de Sol pour un travail que Terra gère très bien. Choisissez trop bas et votre agent se bloque sur des tâches pour lesquelles Luna n'a jamais été conçu.
Les noms suivent un système : le chiffre marque la génération, tandis que Sol, Terra et Luna sont des niveaux durables qui évoluent selon leur propre cadence. Notre explication des noms GPT-5.6 couvre cette structure en profondeur, donc ce guide ignore l'historique. Ce que vous trouverez ici est la décision d'achat : ce que chaque niveau fait bien, où se cache le piège tarifaire, et comment régler le choix avec vos propres invites au lieu des tableaux du jour de lancement.
La réponse en 30 secondes
| Modèle | Prix par 1 million de jetons | Choisissez-le quand |
|---|---|---|
gpt-5.6-sol |
5 $ en entrée / 30 $ en sortie | La tâche est vraiment difficile : codage agentique, orchestration d'outils multi-étapes, recherche approfondie |
gpt-5.6-terra |
2,50 $ en entrée / 15 $ en sortie | Presque tout le reste. Le choix par défaut pour le travail en production |
gpt-5.6-luna |
1 $ en entrée / 6 $ en sortie | Le volume et la latence priment : classification, extraction, routage, premières ébauches |
Terra est le choix par défaut judicieux. OpenAI le positionne comme compétitif par rapport à GPT-5.5 à environ la moitié du prix, ce qui signifie que la classe de modèles sur laquelle la plupart des applications de production fonctionnaient le mois dernier coûte maintenant deux fois moins cher. Sol ne justifie sa prime que lorsque la tâche est suffisamment difficile pour montrer un écart mesurable. Luna l'emporte chaque fois que vous multipliez les prix par jeton par des millions de requêtes.
Si vous préférez tester plutôt que faire confiance, c'est un bon instinct. Les trois modèles acceptent les mêmes appels d'API Responses, vous pouvez donc exécuter un ensemble d'invites pour chaque niveau dans Apidog et laisser les résultats trancher. La configuration prend dix minutes ; plus de détails ci-dessous.
À quoi chaque niveau est-il destiné ?
Les trois modèles sont disponibles via l'API pour n'importe quel compte. L'accès est en libre-service sans restriction de plan, et les ID de modèle ci-dessus proviennent directement de la documentation développeur d'OpenAI. La couverture de la documentation initiale fait état d'une fenêtre de contexte de 1 million de jetons, d'une sortie maximale de 128 000 jetons et d'une coupure de connaissances au 16 février 2026 pour toute la famille ; traitez-les comme des chiffres rapportés jusqu'à ce que la page de modèle d'OpenAI les confirme pour votre compte.
Sol : le fleuron pour les problèmes difficiles
Sol est le niveau de raisonnement approfondi, et les benchmarks de lancement concentrent ses gains exactement là où on les attend : travail à long terme et agentique. Selon OpenAI, Sol obtient environ 53 au test « Agents’ Last Exam » contre 46,9 pour GPT-5.5, atteint 88,8 % sur Terminal-Bench 2.1 et passe de 47,5 à 62,6 sur OSWorld 2.0. Ce sont des affirmations du jour du lancement, il faut donc les prendre avec des pincettes. Mais le schéma est cohérent : la planification, l'utilisation d'outils et la récupération d'erreurs se sont beaucoup plus améliorées que la qualité de texte de routine.
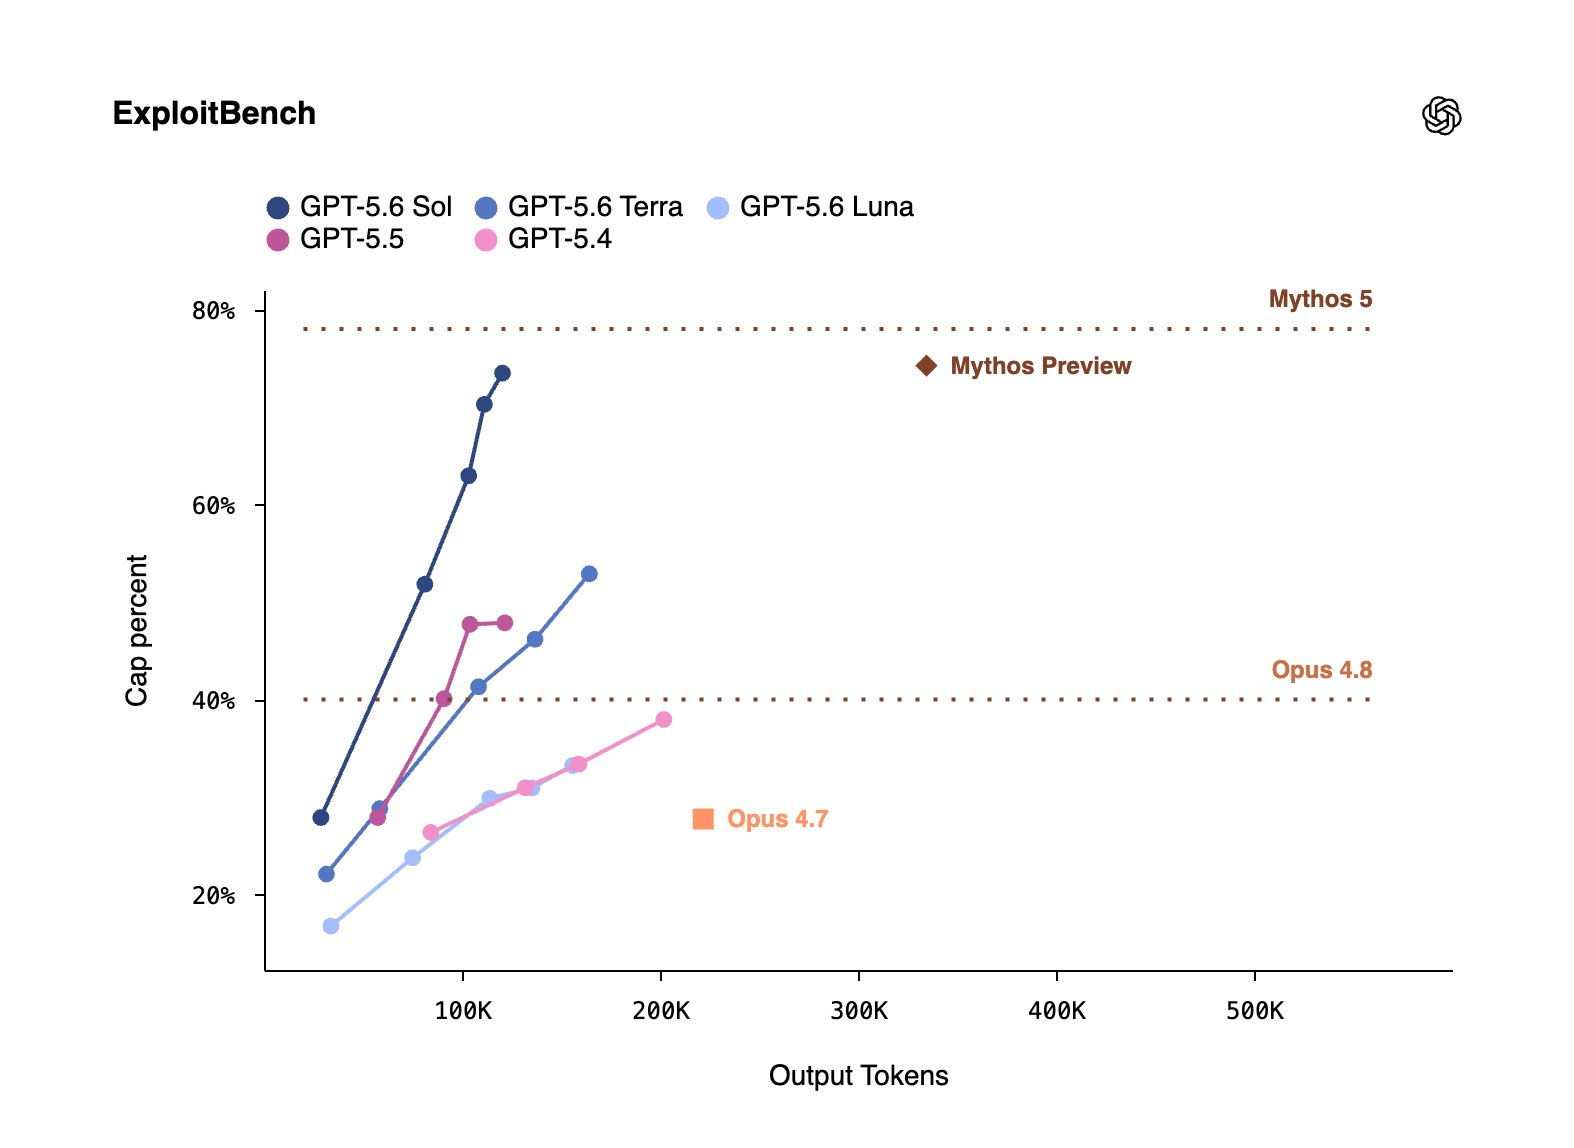
Ce n'est pas un raz-de-marée. Sur SWE-Bench Pro, Claude Fable 5 domine avec 80,3 % contre 64,6 % pour Sol, donc « fleuron » ne signifie pas « le meilleur en tout ». Nous détaillons les points forts et faibles des chiffres dans notre analyse des benchmarks GPT-5.6 Sol.
Terra : le choix par défaut pour le travail en production
La proposition de Terra est économique plutôt qu'héroïque. OpenAI le positionne comme compétitif par rapport à GPT-5.5 à environ deux fois moins cher, et ce cadrage décide à lui seul de la plupart des charges de travail réelles. Si votre produit fonctionnait bien sur GPT-5.5, Terra vous offre la même catégorie de capacités pour la moitié des dépenses. Assistants de discussion, résumé, pipelines de contenu, la plupart des configurations RAG : c'est le niveau par lequel commencer, et celui dont vous devriez avoir à justifier de vous en passer.
Luna : économie unitaire et rapidité
Luna gère le travail où personne ne lit le raisonnement : classification, extraction d'entités, routage des requêtes, premières ébauches qu'un humain ou un modèle plus grand révise. À 1 $ en entrée / 6 $ en sortie, il coûte un cinquième de Sol des deux côtés du compteur, et c'est le plus rapide des trois. L'erreur courante est émotionnelle, pas technique : les équipes ignorent Luna parce que « le moins cher » semble signifier « le pire », puis paient les tarifs de Terra pour des tâches avec des sorties d'un seul mot.
Le piège du réglage par défaut
Voici le détail qui gonfle discrètement les factures : l'alias nu gpt-5.6 redirige vers Sol. Si vous utilisez la chaîne de modèle évidente, vous avez choisi le niveau le plus cher sans jamais avoir l'intention de le faire.
Spécifiez explicitement le niveau dans chaque appel :
{
  "model": "gpt-5.6-terra",
  "input": "Classify this support ticket by urgency and product area.",
  "reasoning": { "effort": "medium" }
}
La différence s'accumule rapidement. Un service traitant 50 millions de jetons en entrée et 10 millions en sortie par mois paie environ 275 $ avec Terra, 550 $ avec Sol et 110 $ avec Luna. Même trafic, un écart de 5x, décidé par une seule chaîne. Pour la grille tarifaire complète, remises de mise en cache incluses, consultez notre répartition des prix GPT-5.6. L'article de lancement de Simon Willison vaut également la peine d'être lu comme une première analyse de la version par un développeur indépendant.
Adaptez le modèle à votre charge de travail
Trois scénarios couvrent la majeure partie de l'espace de décision.
Un pipeline de codage agentique. Choisissez Sol. Les gains de benchmark se situent ici, tout comme les fonctionnalités GA : l'appel d'outils programmatique permet au modèle d'écrire du JavaScript qui orchestre vos appels d'outils, exécuté dans un runtime V8 isolé sans accès réseau, et le raisonnement persistant transporte le contexte d'un tour à l'autre. Lorsqu'une exécution prend 40 étapes et qu'une mauvaise décision à l'étape 12 gâche les 28 suivantes, la qualité du modèle est l'élément le moins cher du pipeline. Le profil complet de Sol couvre les autres changements apportés par le fleuron.
Un assistant de discussion en production. Choisissez Terra. Les utilisateurs jugent la latence et l'utilité, pas les deltas des benchmarks, et sur les questions de routine, ils ne peuvent pas distinguer Sol de Terra. Dirigez la rare requête difficile vers Sol derrière une heuristique si vos logs prouvent que vous en avez besoin ; ne payez pas les tarifs phares pour « comment réinitialiser mon mot de passe ».
Un pipeline de documents à grand volume. Choisissez Luna, puis ajoutez la mise en cache par-dessus. GPT-5.6 prend en charge les points d'arrêt de cache explicites (prompt_cache_options.mode: "explicit" avec un champ ttl) ; les lectures du cache bénéficient d'une remise de 90 %, les écritures sont facturées à 1,25 fois le taux d'entrée, et le contenu mis en cache dure au moins 30 minutes. Pour les tâches d'extraction qui réutilisent une longue invite système sur des milliers de documents, Luna plus la mise en cache explicite se situe dans une classe de coût différente de celle de ses pairs. Les nouveaux paramètres de détail de vision (original et auto) préservent également les dimensions des images sources, ce qui est important lorsque vous extrayez des champs à partir de numérisations.
Les niveaux d'effort changent l'équation
Le niveau n'est que la moitié de l'équation. GPT-5.6 expose six niveaux d'effort de raisonnement sur chaque niveau : none, low, medium, high, xhigh et max. Cela transforme trois modèles en une grille, et la comparaison de cellules la plus intéressante n'est pas Sol contre Terra avec le même réglage. C'est Terra en high contre Sol en medium. Terra, avec plus de temps de réflexion, peut réduire une grande partie de l'écart de qualité pour la moitié du prix du jeton, et savoir si cela est suffisant pour vos tâches est une question empirique, non une question de fiche technique.
Les propres conseils de migration d'OpenAI vont dans le même sens : traitez le passage comme un réglage, pas comme un simple remplacement de slug de modèle. Évaluez d'abord des tâches représentatives et testez votre niveau d'effort actuel parallèlement à un niveau inférieur. Une autre note importante des documents concernant les invites : GPT-5.6 écrit des réponses nettement plus courtes avec moins d'introductions génériques, alors retirez le texte générique « soyez concis » des invites que vous transférez, sinon vous obtiendrez des réponses laconiques au point d'être inutiles.
Pour un travail axé sur la qualité où vous préférez attendre plutôt que de relancer, le mode professionnel (reasoning.mode: "pro") est disponible sur les trois modèles. C'est un réglage, pas un modèle séparé, vous pouvez donc l'activer sur Terra aussi facilement que sur Sol.
Testez les trois avant de vous engager
La réponse honnête à « quel modèle devriez-vous utiliser » est : celui qui réussit le mieux avec vos invites. Les benchmarks sont les tâches d'OpenAI ; votre trafic de production ne l'est pas.
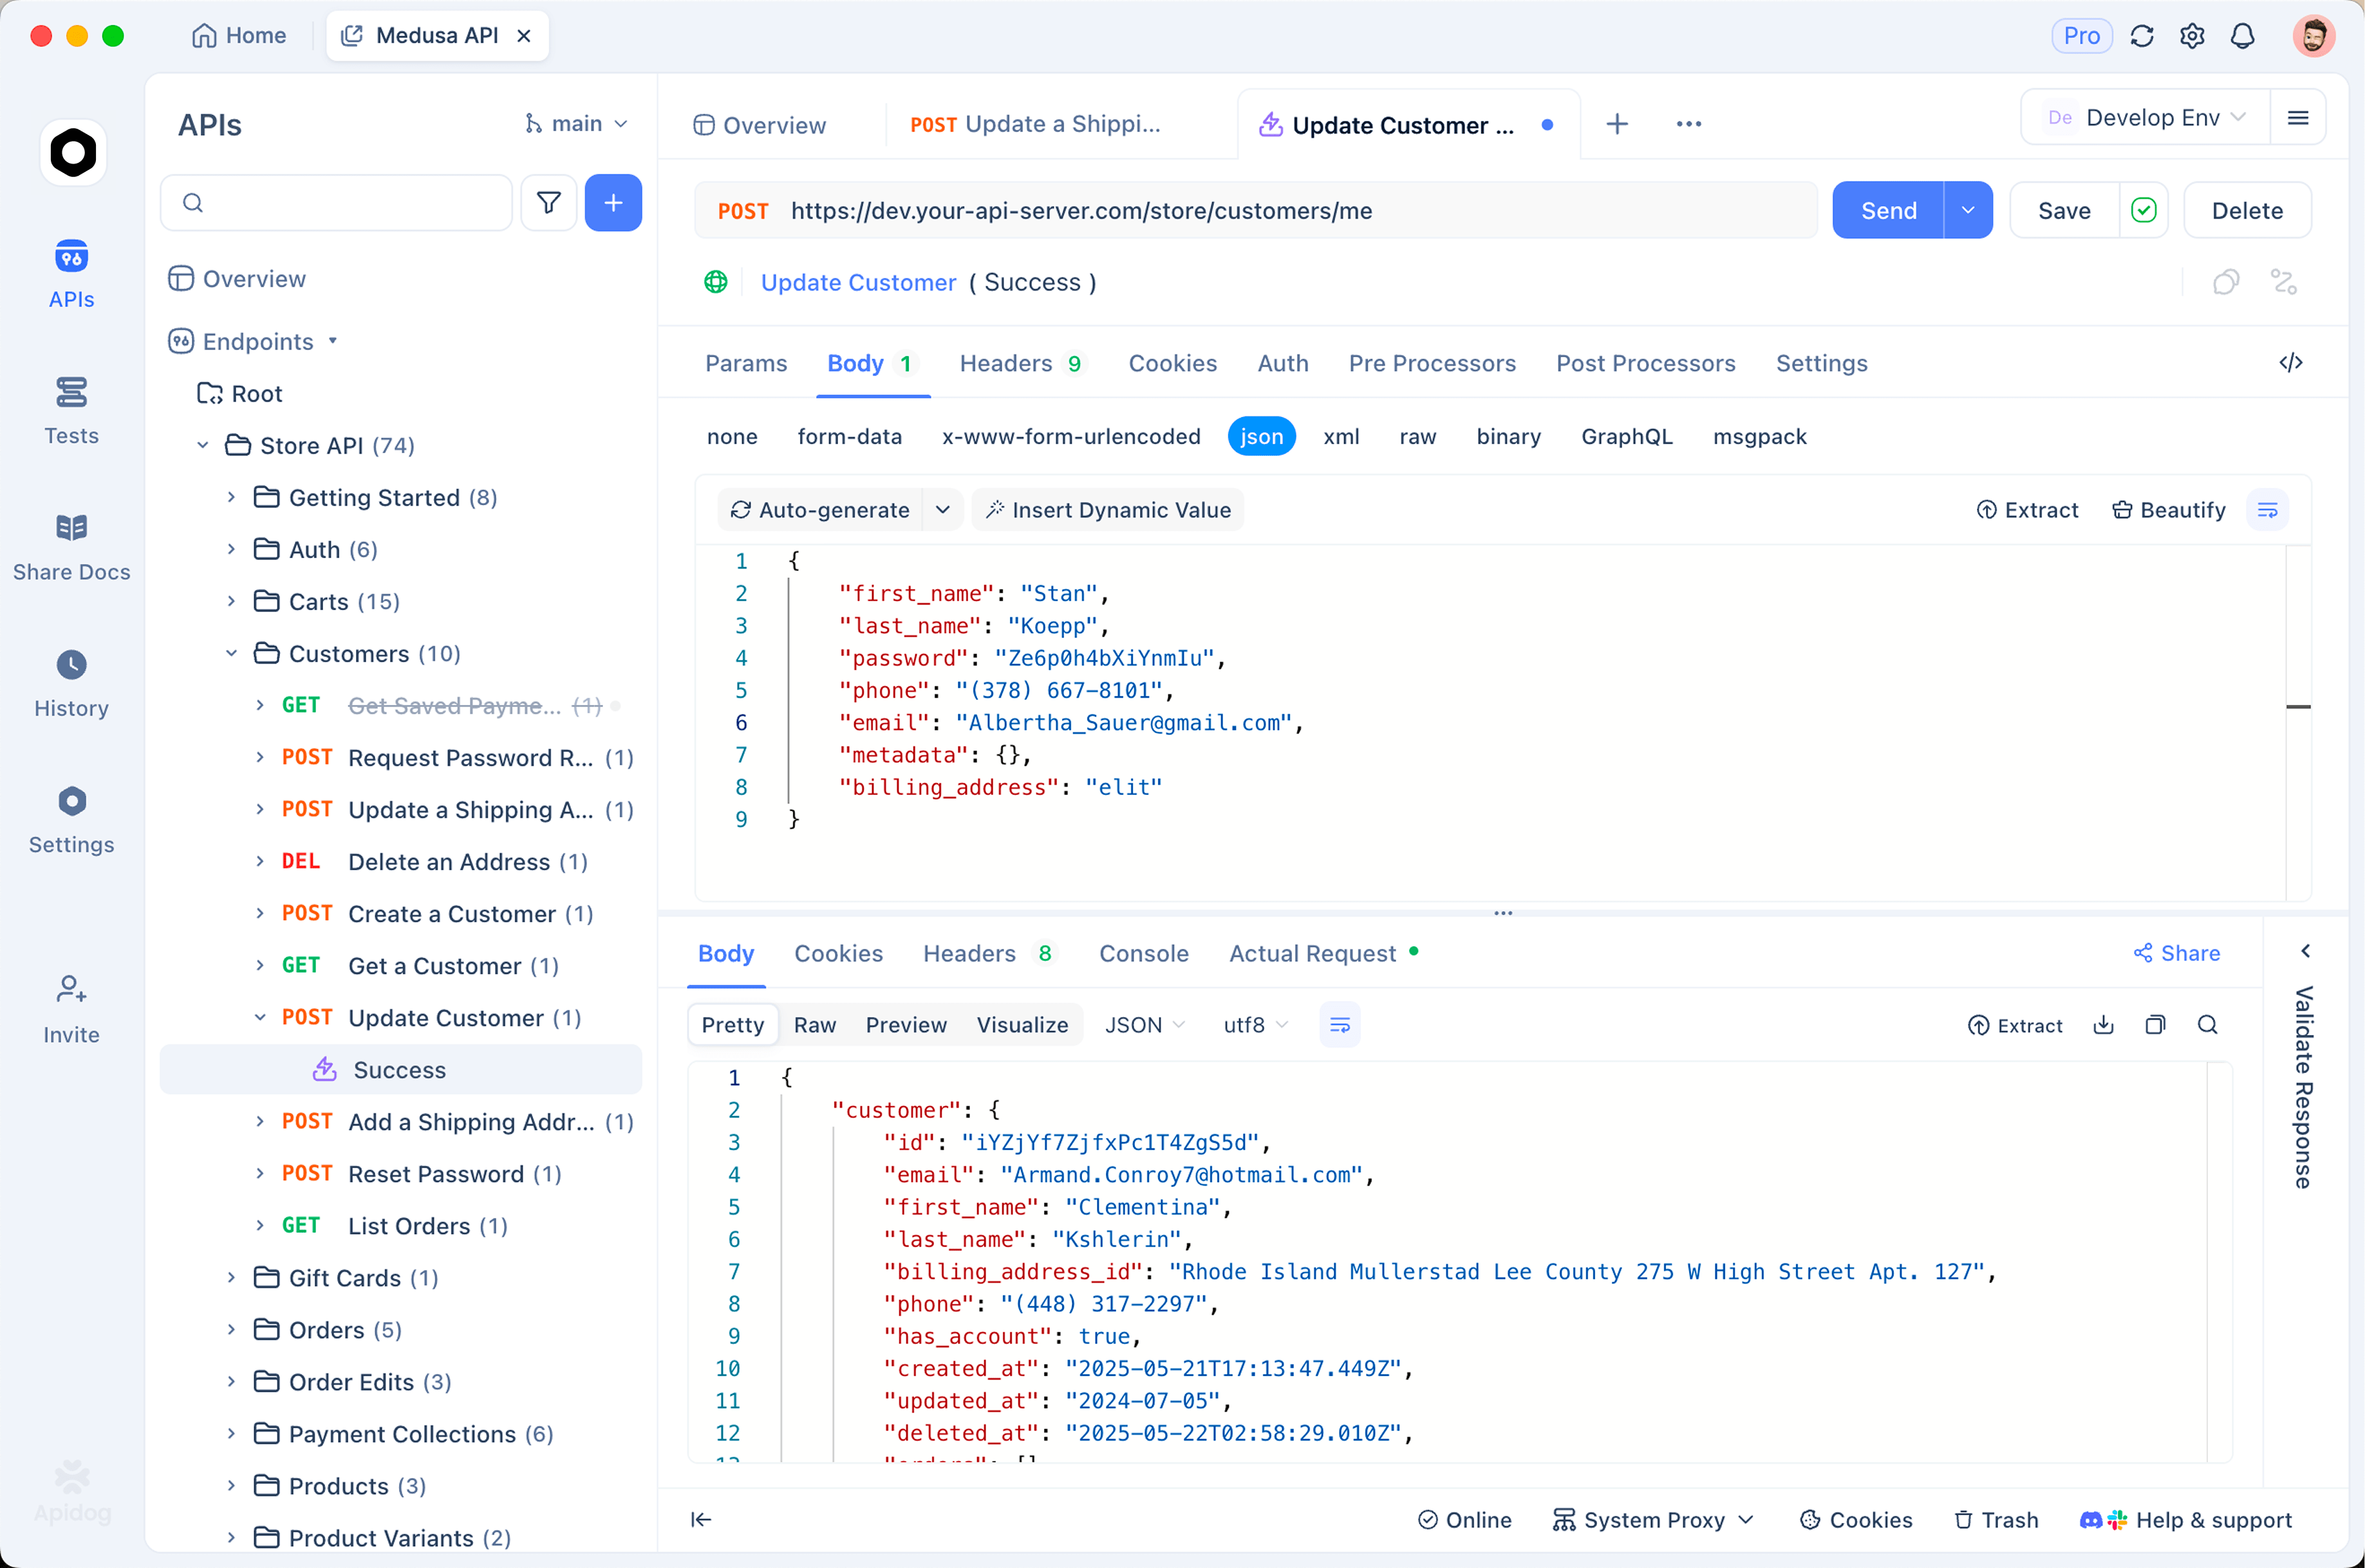
Le test est peu coûteux à exécuter. Collectez 10 à 20 tâches réelles de vos journaux, y compris les plus complexes. Téléchargez Apidog, enregistrez l'URL de base et la clé API d'OpenAI une seule fois, puis placez l'ID du modèle dans une variable d'environnement afin qu'une seule définition de requête couvre les trois niveaux. Basculez {{model}} entre gpt-5.6-sol, gpt-5.6-terra et gpt-5.6-luna, exécutez le même ensemble d'invites et comparez deux choses côte à côte : la qualité de la sortie par rapport à vos propres exigences, et le nombre de jetons d'utilisation dans chaque réponse. Multipliez ces nombres par la grille tarifaire et le tableau des coûts par tâche se générera lui-même.
Deux constats ressortent de la plupart de ces tests comparatifs. Terra égale Sol sur une plus grande proportion de tâches que ne le suggère l'écart de prix. Et Luna réussit les travaux de sortie structurée, la voie de classification et d'extraction, bien plus souvent que son prix ne le laisse entendre. Vous ne découvrirez où votre charge de travail rompt ce modèle qu'en l'exécutant.
Où s'inscrit Ultra
Ultra est la seule option de cette gamme qui n'est pas un ID de modèle API. C'est un paramètre multi-agents qui exécute par défaut quatre agents en parallèle, dépensant délibérément plus de jetons en échange de résultats plus rapides en temps réel sur les problèmes difficiles. Selon OpenAI, Ultra fait passer le score de Sol sur Terminal-Bench 2.1 de 88,8 % à 91,9 %.
La disponibilité est soumise à des plans côté produit : Ultra est disponible dans ChatGPT Work sur les plans Pro et Entreprise, et dans Codex à partir du plan Plus. Le produit de discussion a sa propre carte de niveaux, selon le centre d'aide d'OpenAI :
| Plan ChatGPT | Accès GPT-5.6 |
|---|---|
| Gratuit / Go | Terra |
| Plus | Sol, Terra et Luna avec contrôle de l'effort par modèle (Sol à partir d'un effort moyen) |
| Pro / Business / Entreprise | Tout ce qui précède, plus Sol Pro |
| ChatGPT Work (Pro / Entreprise), Codex (Plus et supérieur) | Ultra |
Si votre charge de travail d'agents parallèles se trouve dans le code plutôt que dans le chat, surveillez la version bêta multi-agents de l'API Responses ; c'est le pendant côté API de la même idée.
FAQ
gpt-5.6-terra est-il suffisamment bon pour remplacer GPT-5.5 en production ?
Pour la plupart des charges de travail, oui. OpenAI positionne Terra comme compétitif par rapport à GPT-5.5 à environ la moitié du prix, et la même surface d'API Responses signifie que le changement présente un faible risque. Exécutez vos évaluations avant de basculer, et surveillez la longueur des sorties, car les réponses de GPT-5.6 sont par conception plus courtes.
Que se passe-t-il si j'appelle l'alias nu gpt-5.6 ?
Votre requête est acheminée vers Sol et facturée aux tarifs de Sol, 5 $ par million de jetons en entrée et 30 $ par million de jetons en sortie. Rien ne se casse, ce qui est le problème ; le coût apparaît plus tard sur la facture. Spécifiez gpt-5.6-terra ou gpt-5.6-luna explicitement partout où un niveau moins cher fait le travail.
Puis-je changer de niveau sans modifier mon intégration ?
Oui. Sol, Terra et Luna partagent la même surface d'API Responses, donc passer de l'un à l'autre est un changement d'une seule ligne de la chaîne du modèle. Les niveaux d'effort et le mode professionnel fonctionnent également sur les trois. Notre guide sur comment utiliser l'API GPT-5.6 explique la forme de la requête de bout en bout.
Ai-je besoin d'un plan ChatGPT spécifique pour utiliser ces modèles dans l'API ?
Non. L'accès à l'API est en libre-service pour tout compte API, sans restriction de plan sur aucun des trois modèles. Les niveaux de plan ChatGPT ne contrôlent que le produit de discussion, et Ultra est la seule capacité qui reste côté produit (ChatGPT Work et Codex) plutôt que d'être livrée en tant que modèle API.
Votre première heure avec les niveaux
Commencez par Terra et laissez les autres niveaux faire leurs preuves. N'optez pour Sol que si vos propres évaluations montrent un écart qui justifie de payer le double, ce qui signifie généralement un travail agentique et à long terme. Passez à Luna partout où les sorties sont courtes et le volume élevé. Spécifiez explicitement les ID de modèle partout afin que l'alias Sol par défaut ne choisisse jamais pour vous, et ajustez les niveaux d'effort avant de changer de niveau, car Terra en high est la mise à niveau de qualité la moins chère de la gamme.
Ensuite, arrêtez de lire et mesurez. Chargez vos dix invites de production les plus complexes dans Apidog, dirigez une requête vers les trois ID de modèle avec une variable d'environnement, et laissez vos propres décomptes de jetons et vos sorties prendre la décision. L'ensemble de l'exercice coûte moins d'un dollar en dépenses API et règle une décision qui se répercute chaque mois.