
À quelques semaines d'intervalle, au cours de l'été 2026, OpenAI et Google ont tous deux lancé un modèle spécialisé en sécurité que la plupart des développeurs ne peuvent pas toucher. Le GPT-5.6-Cyber d'OpenAI a été lancé le 10 août. Le Gemini 3.5 Flash Cyber de Google est arrivé le 21 juillet. Tous deux trouvent des vulnérabilités logicielles. Tous deux sont soumis à approbation pour l'accès. Et tous deux refusent de vous fournir une clé API standard.
Ce ne sont cependant pas les mêmes types d'outils. L'un est orienté défense, l'autre est orienté attaque, et ils se situent à des niveaux de modèle très différents. Si vous essayez de comprendre les deux, voici comment ils se comparent réellement, et pourquoi une comparaison directe de leurs performances n'est pas possible.
Comparaison
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| Fournisseur | OpenAI | |
| Lancé | 10 août 2026 | 21 juillet 2026 |
| Basé sur | GPT-5.6 Sol (catégorie phare) | Gemini Flash (catégorie rapide et économique) |
| Orienté | Attaque : chaînes d'exploitation, découverte de failles zero-day | Défense : trouver et corriger les vulnérabilités |
| Accès | Daybreak Red (équipes de sécurité vérifiées) | Programme pilote limité (gouvernements, partenaires de confiance) |
| API publique | Non | Non |
| Tarification publique | Non | Non |
| Programme | OpenAI Daybreak | Google CodeMender |
Le point à retenir en une phrase : GPT-5.6-Cyber est un modèle de recherche offensive de pointe, et Gemini 3.5 Flash Cyber est un modèle de correction défensive de niveau plus léger. Cette différence d'orientation explique presque tout le reste.
Différentes catégories de modèles
La distinction technique la plus claire est le modèle de base. GPT-5.6-Cyber est basé sur GPT-5.6 Sol, le modèle de raisonnement le plus performant d'OpenAI. La recherche de vulnérabilités dans le monde réel nécessite un raisonnement soutenu sur de vastes bases de code inconnues, et OpenAI a mis son modèle de premier ordre sous Cyber pour y parvenir.
Gemini 3.5 Flash Cyber est basé sur la catégorie Flash, le modèle rapide et économique de Google, plutôt que son modèle phare Pro. C'est un choix délibéré adapté à sa tâche. CodeMender, le programme Google qui le soutient, vise à analyser le code pour trouver et corriger les failles à grande échelle, ce qui privilégie la vitesse et la rentabilité par rapport à une profondeur de raisonnement maximale en un seul coup. Notez également la particularité de la version : le modèle Flash général est passé à 3.6, mais Cyber est resté à 3.5, car les deux suivent des cycles de publication différents.
Orientation différente : attaque vs défense
C'est la vraie distinction. En lisant la présentation de chaque fournisseur, la différence est évidente.
OpenAI a entraîné GPT-5.6-Cyber à réduire les refus sur les tâches à double usage à risque élevé et à s'améliorer dans la découverte de failles zero-day et la construction de chaînes d'exploitation, selon son annonce d'expansion Daybreak. Il est fourni via Daybreak Red, la catégorie explicitement dédiée à la « recherche de vulnérabilités autorisée, la validation d'exploits et les tests de sécurité ». Les preuves de son lancement étaient offensives : deux vulnérabilités V8 chaînées dans Chrome, affectées à la CVE-2026-15903, ainsi que des découvertes signalées sur un OS mobile, une base de données et un noyau de système d'exploitation.
Google a présenté Gemini 3.5 Flash Cyber autour de la découverte et de la correction. Annoncé dans sa mise à jour des modèles Gemini, il fait partie de CodeMender, un effort visant à détecter les failles de sécurité dans le code et à proposer des correctifs. L'accent est mis sur la remédiation, la fermeture des brèches, et non leur militarisation.
Cela ne rend pas l'un « sûr » et l'autre « dangereux ». Un détecteur de vulnérabilités puissant est à double usage, quelle que soit la manière dont il est présenté, ce qui explique précisément pourquoi les deux sont à accès contrôlé. Mais si vous cartographiez le domaine, OpenAI a davantage poussé vers la recherche offensive, et Google est resté plus proche de la correction défensive.
Transparence différente
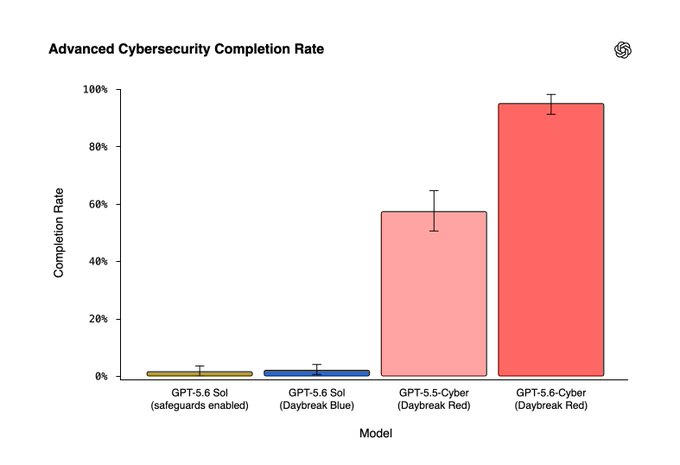
OpenAI a publié plus de chiffres. Il a divulgué une métrique interne de taux de réussite (GPT-5.6-Cyber répond à 95,0 % des invites cyber avancées contre 1,5 % pour le modèle de base Sol), a nommé des références comme ExploitGym, a signalé un vrai CVE attribué, et a déclaré une évaluation du Cadre de Préparation comme « Élevé » mais inférieure à « Critique ». Pour une ventilation complète de qui a accès à quoi, voir Daybreak Blue vs Red.
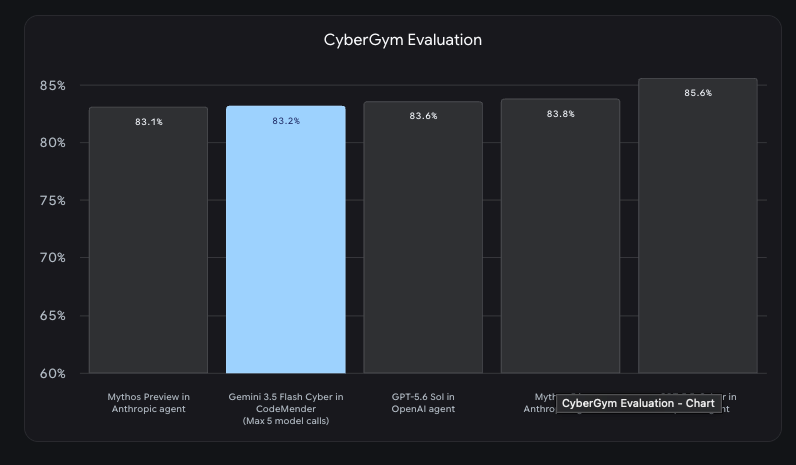
Google a été plus vague lors du lancement. Il a confirmé l'existence du modèle, son objectif défensif et son statut d'accès restreint, sans publier de taux de réussite par tâche comparables ni de tableaux de référence. Ainsi, bien que vous puissiez décrire les deux modèles, vous ne pouvez pas les placer sur le même graphique. Il n'existe pas de référence commune que l'un ou l'autre fournisseur ait comparée directement, et leurs tâches cibles (développement d'exploits vs génération de correctifs) se chevauchent à peine.
Ce qu'ils partagent
Au-delà des différences, les deux modèles racontent la même histoire sur la direction que prennent les outils de sécurité IA :
- Accès contrôlé, pas d'API ouverte. Aucun n'est en libre-service. Les deux nécessitent une approbation, et l'accès est réservé aux organisations vérifiées.
- Pas de tarification publique. Parce qu'il n'y a pas d'accès ouvert, il n'y a pas de tarif par jeton publié pour l'un ou l'autre. Tout tableau de prix que vous trouvez en circulation n'est pas vérifié.
- La même logique de double usage. Les deux fournisseurs raisonnent qu'un modèle performant pour trouver des vulnérabilités est intrinsèquement bon pour trouver des vulnérabilités, ils commencent donc de manière restreinte avec des partenaires de confiance et observent avant d'élargir l'accès.
- Une histoire de version confuse. Le modèle d'OpenAI relève de la nomenclature Sol/Terra/Luna ; celui de Google est resté à 3.5 tandis que son jumeau est passé à 3.6.
Si vous êtes venu chercher une clé API pour l'un ou l'autre, la réponse est la même : pas aujourd'hui, et peut-être pas sous la forme que vous attendez.
Lequel vous concerne ? Probablement aucun des deux, pour l'instant.
Voici la conclusion pratique. À moins que vous ne soyez un fournisseur de sécurité agréé ou un partenaire gouvernemental, vous ne pouvez utiliser aucun des deux modèles pour le moment. Les observer est utile pour comprendre le sens de l'évolution, mais aucun des deux ne devrait faire partie de votre pile technologique ce trimestre.
Ce qui doit faire partie de votre pile, c'est le test de la sécurité des API que vous possédez réellement. Ces deux modèles existent parce que les vulnérabilités sont coûteuses ; les moins chères à prévenir sont les bogues de limite ennuyeux dans vos propres services. Vous n'avez pas besoin d'un modèle cybernétique de pointe pour les détecter.
Avec un client API comme Apidog, vous pouvez effectuer les vérifications qui détectent le plus de problèmes avec le moins d'effort :
- Limites d'authentification. Envoyez des requêtes avec des jetons manquants, expirés et valides et assurez-vous que chacun renvoie le bon statut. La même discipline du moindre privilège s'applique à vos agents ; voir ce que la clé API de votre agent IA peut réellement faire.
- Sécurité du transport. Vérifiez que les certificats clients et mTLS fonctionnent correctement, et que les requêtes non chiffrées sont refusées.
C'est un travail que vous pouvez commencer aujourd'hui, avec des outils auxquels vous pouvez réellement accéder. Téléchargez Apidog et commencez par les cas d'authentification.
Questions fréquemment posées
Lequel est le meilleur, GPT-5.6-Cyber ou Gemini 3.5 Flash Cyber ? Ils sont conçus pour des tâches différentes, donc le « meilleur » dépend de la tâche. GPT-5.6-Cyber est un modèle de pointe optimisé pour la recherche offensive (développement d'exploits, découverte de failles zero-day). Gemini 3.5 Flash Cyber est un modèle de niveau plus léger optimisé pour la correction défensive. Aucun fournisseur n'a publié de comparaison directe de performances, donc une comparaison directe des scores n'est pas disponible.
Puis-je utiliser l'un ou l'autre via une API ? Non. Les deux sont à accès contrôlé. GPT-5.6-Cyber nécessite l'approbation Daybreak Red ; Gemini 3.5 Flash Cyber est un programme pilote limité pour les gouvernements et les partenaires de confiance. Aucun des deux n'offre d'ID de modèle API en libre-service.
Pourquoi les deux modèles sont-ils restreints ? Double usage. Un modèle performant pour trouver des vulnérabilités aide les défenseurs à corriger et aide les attaquants à exploiter. Les deux fournisseurs limitent l'accès aux partenaires vérifiés pendant qu'ils surveillent l'utilisation réelle.
Quelle est la différence entre les modèles de base ? GPT-5.6-Cyber est basé sur GPT-5.6 Sol, la catégorie de raisonnement phare d'OpenAI. Gemini 3.5 Flash Cyber est basé sur la catégorie Flash de Google, plus rapide et moins chère, ce qui correspond à son objectif d'analyse et de correction.
Que devrais-je utiliser à la place ? Pour sécuriser vos propres API, effectuez des tests d'authentification, de transport et de contrat avec un client comme Apidog. Aucun modèle à accès contrôlé n'est requis.