
Z.ai vend désormais deux modèles avec des noms presque identiques, la même fenêtre contextuelle de 1M de jetons, et un écart de prix de neuf fois entre eux. La nomenclature ne vous aide pas à choisir. "Flash" implique une variante plus petite, plus rapide et plus faible, et seul l'un de ces trois mots est exact.
Voici la version courte : GLM-5.3-Flash est moins cher, gère les images nativement et offre aux utilisateurs de forfaits de codage trois fois le quota. GLM-5.3 est un peu plus intelligent et génère presque deux fois plus vite. Pour la plupart des charges de travail, Flash est le choix par défaut correct et la charge de la preuve incombe à ceux qui choisissent le plus cher.
Cet article examine les cas où cette règle ne s'applique pas.
Le tableau comparatif
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Indice d'intelligence (Analyse Artificielle) | 57 | 60 |
| Prix moyen par 1M de jetons | $0.10 | $0.90 |
| Prix catalogue entrée / sortie par 1M | $0.15 / $0.50 | $1.40 / $4.40 |
| Vitesse de sortie | ~49 jetons/sec | ~86 jetons/sec |
| Temps au premier jeton | 1.52s | 1.57s |
| Fenêtre contextuelle | 1,048,576 | 1,048,576 |
| Entrée d'image native | Oui | Non, basé sur un adaptateur |
| Paramètres | 320 milliards total / 18 milliards actifs | Plus grand, non entièrement divulgué |
| Licence | MIT, poids ouverts | Poids ouverts |
| Quota du plan de codage | 3x | 1x |
Les chiffres de vitesse et d'intelligence sont des mesures d'Analyse Artificielle. Le prix est le prix catalogue de Z.ai, avant la réduction de lancement abordée ci-dessous.
D'où vient l'écart de prix de neuf fois
GLM-5.3-Flash est un modèle de 320 milliards de paramètres basé sur un mélange d'experts, activant 18 milliards de paramètres par jeton, construit sur une nouvelle base avec une attention hybride linéaire et clairsemée. Z.ai rapporte environ trois fois moins de calcul d'attention que GLM-5.3 et un cache KV environ 4,4 fois plus petit.
La taille du cache KV est ce qui rend coûteux le service de contextes longs. La réduire par 4,4 est la principale raison pour laquelle Z.ai peut offrir une fenêtre de 1M de jetons pour un dixième du prix. Vous ne payez pas moins cher pour un contexte plus court ou un modèle plus faible. Vous payez moins cher parce que l'empreinte de service par requête est réellement plus petite.
C'est un véritable résultat d'ingénierie plutôt qu'une réduction promotionnelle, ce qui est important pour savoir si le prix tiendra.
Ce que signifie l'écart de trois points d'intelligence
57 contre 60 sur l'indice d'intelligence d'Analyse Artificielle est un écart étroit en termes absolus. À titre de comparaison, le modèle à poids ouverts médian de taille comparable obtient 27 points, de sorte que ces deux modèles se situent bien au-dessus de la moyenne.
Cependant, trois points, ce n'est pas rien. Des écarts d'indice de cette taille se manifestent généralement par : une performance légèrement inférieure sur les chaînes de raisonnement multi-étapes, un peu plus de dérive sur les tâches agentiques très longues et une plus grande sensibilité aux instructions ambiguës. Ils apparaissent rarement sur les tâches simples d'extraction, de classification, de résumé ou d'édition de code de fichier unique.
Le test pratique consiste à déterminer si votre tâche a une réponse vérifiable. Si vous pouvez vérifier la sortie par programmation, l'erreur occasionnelle de Flash est facile à détecter et à relancer, et à un neuvième du prix, vous pouvez retenter beaucoup. Si votre tâche produit de la prose qu'un humain doit lire et juger, la différence de qualité est plus difficile à compenser et l'écart de prix importe moins que le résultat.
La vitesse est le seul domaine où Flash perd réellement
C'est la partie où le nom est trompeur. GLM-5.3 génère environ 86 jetons par seconde. GLM-5.3-Flash gère environ 49. Le modèle plus grand et plus cher est presque deux fois plus rapide pour produire des résultats.
Le temps d'obtention du premier jeton est pratiquement égal, à 1,52 contre 1,57 seconde, donc les deux semblent tout aussi réactifs au début d'une réponse.
La conséquence dépend entièrement de la longueur de la sortie :
- Réponses courtes. Non pertinent. Les deux démarrent en environ 1,5 seconde et se terminent avant que quiconque ne remarque la différence de débit.
- Générations longues. Une réponse de 4 000 jetons prend environ 82 secondes sur Flash et environ 47 sur GLM-5.3. Dans un outil interactif, c'est un écart significatif.
- Tâches par lots avec concurrence. Également en grande partie non pertinent, car vous évoluez avec des requêtes parallèles plutôt qu'avec la vitesse par flux, et la différence de prix permet beaucoup de parallélisme.
Si vous diffusez un contenu long à quelqu'un qui attend, GLM-5.3 offre une meilleure expérience. C'est le cas le plus clair pour payer neuf fois plus cher.
La multimodalité est la véritable ligne de démarcation
GLM-5.3-Flash accepte les images, les vidéos et les fichiers comme blocs de contenu dans la même requête de complétion de chat que votre texte. GLM-5.3 ne le fait pas nativement ; la vision passe par des adaptateurs séparés.
Si votre application a besoin d'un modèle pour "regarder" quelque chose, ce n'est pas une comparaison, c'est une exigence. Flash est le seul des deux à le faire en un seul appel, dans une seule fenêtre contextuelle, sur une seule ligne de facturation.
Cette capacité se combine avec le contexte de 1M d'une manière réellement nouvelle pour cette famille de modèles : un long document de spécification et une capture d'écran du résultat construit peuvent occuper la même invite. Le positionnement de Z.ai lui-même parle d'observer les interfaces et de rendre les résultats, ce qui est un cadre d'agent de codage plutôt que de légendage d'images.
Notre guide de vision couvre la charge utile et les flux de travail. Les anciens modèles de vision dédiés sont traités dans le guide API de GLM-5V-Turbo si vous maintenez quelque chose construit sur cette voie.
L'angle du plan de codage
Pour les abonnés au plan de codage GLM, le calcul est différent et plus simple. Flash est inclus dans le plan et offrirait trois fois le quota utilisable de GLM-5.3. Z.ai note également que les appels hors pointe consomment la moitié des points standards.
Si vous utilisez Claude Code ou Cline par rapport à votre quota de plan, trois fois plus de requêtes pour une baisse de trois points d'indice est un échange facile pour le travail de routine. Gardez GLM-5.3 pour les problèmes difficiles et laissez Flash absorber le volume. La configuration des deux harnais se trouve dans notre guide Claude Code et Cline.
Vérifiez le multiplicateur de quota sur z.ai avant de planifier en conséquence, car les conditions des plans changent plus souvent que les spécifications des modèles.
La date limite de tarification
Une réduction de lancement de 50 % sur GLM-5.3-Flash est valable jusqu'au 9 septembre 2026. Jusque-là, les tarifs effectifs sont de 0,075 $ en entrée et 0,25 $ en sortie par million, ce qui élargit l'écart par rapport à GLM-5.3 à environ dix-huit fois.
Après expiration, les prix catalogue de 0,15 $ et 0,50 $ s'appliquent et l'écart se stabilise à nouveau à environ neuf fois. Dans tous les cas, Flash est considérablement moins cher. La date limite est importante pour fixer les projections de coûts, pas pour le choix entre les deux modèles. Notre analyse des prix contient les chiffres détaillés.
Une règle de décision
Utilisez GLM-5.3-Flash lorsque :
- Vos entrées incluent des images, des vidéos ou des fichiers.
- Le coût par jeton est la contrainte que vous optimisez.
- Vous effectuez des extractions, classifications ou routages à grand volume.
- Vous êtes sur le plan de codage et souhaitez étendre votre quota.
- Vous souhaitez des poids ouverts sous licence MIT que vous pouvez auto-héberger. L'exécuter localement couvre le matériel.
Utilisez GLM-5.3 lorsque :
- Vous diffusez des réponses longues à un humain en attente et que le débit est l'expérience ressentie.
- Votre travail est un raisonnement à long terme où trois points d'indice se cumulent à chaque étape.
- La qualité de la sortie est jugée par une personne plutôt que vérifiée par un test.
Utilisez les deux lorsque : vous pouvez acheminer. Envoyez la majeure partie du trafic à Flash et escaladez vers GLM-5.3 en cas d'échec, de faible confiance ou de type de tâche. L'écart de prix de neuf fois justifie la construction d'un routeur, et comme les deux modèles se trouvent derrière le même point de terminaison compatible OpenAI, le routage est un simple échange d'ID de modèle plutôt qu'une intégration.
Migrer entre les deux
Si vous utilisez déjà GLM-5.3 et évaluez un changement, la partie mécanique est triviale et la partie validation est là où se trouve le travail.
Ce qui ne change pas. L'URL de base, le schéma d'authentification, les formes de requête et de réponse, la sémantique de streaming et les schémas d'appel d'outils. Les deux modèles se trouvent derrière la même interface compatible OpenAI. Le basculement est une chaîne d'ID de modèle.
Ce qui change. Le coût par appel diminue d'environ neuf fois. La génération ralentit d'environ la moitié. La qualité du raisonnement se déplace de trois points d'indice. Et vous gagnez une entrée d'image qui n'était pas disponible auparavant.
Que vérifier avant de s'engager. Exécutez vos invites réelles sur les deux et comparez-les sur quatre axes : la justesse de la sortie dans les cas que vous pouvez vérifier, la latence de bout en bout, y compris le temps de génération plutôt que le premier jeton uniquement, le nombre de jetons de l'objet usage sur chaque réponse, et le comportement sur votre contexte réaliste le plus long.
Le quatrième point est celui qui détecte le plus de problèmes. Des modèles qui semblent équivalents sur des invites courtes peuvent diverger notablement lorsque le contexte est plein, et un tableau de référence ne vous le dira jamais pour vos propres données.
Si vous avez commencé avec le modèle de base, ce qu'est GLM-5.3 le couvre en ses propres termes, et le guide API de GLM-5.3 contient la configuration à partir de laquelle vous migrez.
Testez-le plutôt que de faire confiance au tableau
Chaque chiffre ci-dessus est soit une affirmation du fournisseur, soit une référence tierce exécutée sur la charge de travail de quelqu'un d'autre. Aucun ne vous dit comment ces deux modèles se comportent sur vos propres invites.
L'échange est une chaîne. Pointez un client compatible OpenAI vers https://api.z.ai/api/paas/v4/, exécutez vos invites réelles via glm-5.3-flash et glm-5.3, et comparez les sorties, la latence et le nombre de jetons sur le trafic qui vous intéresse. Le guide API contient la configuration.
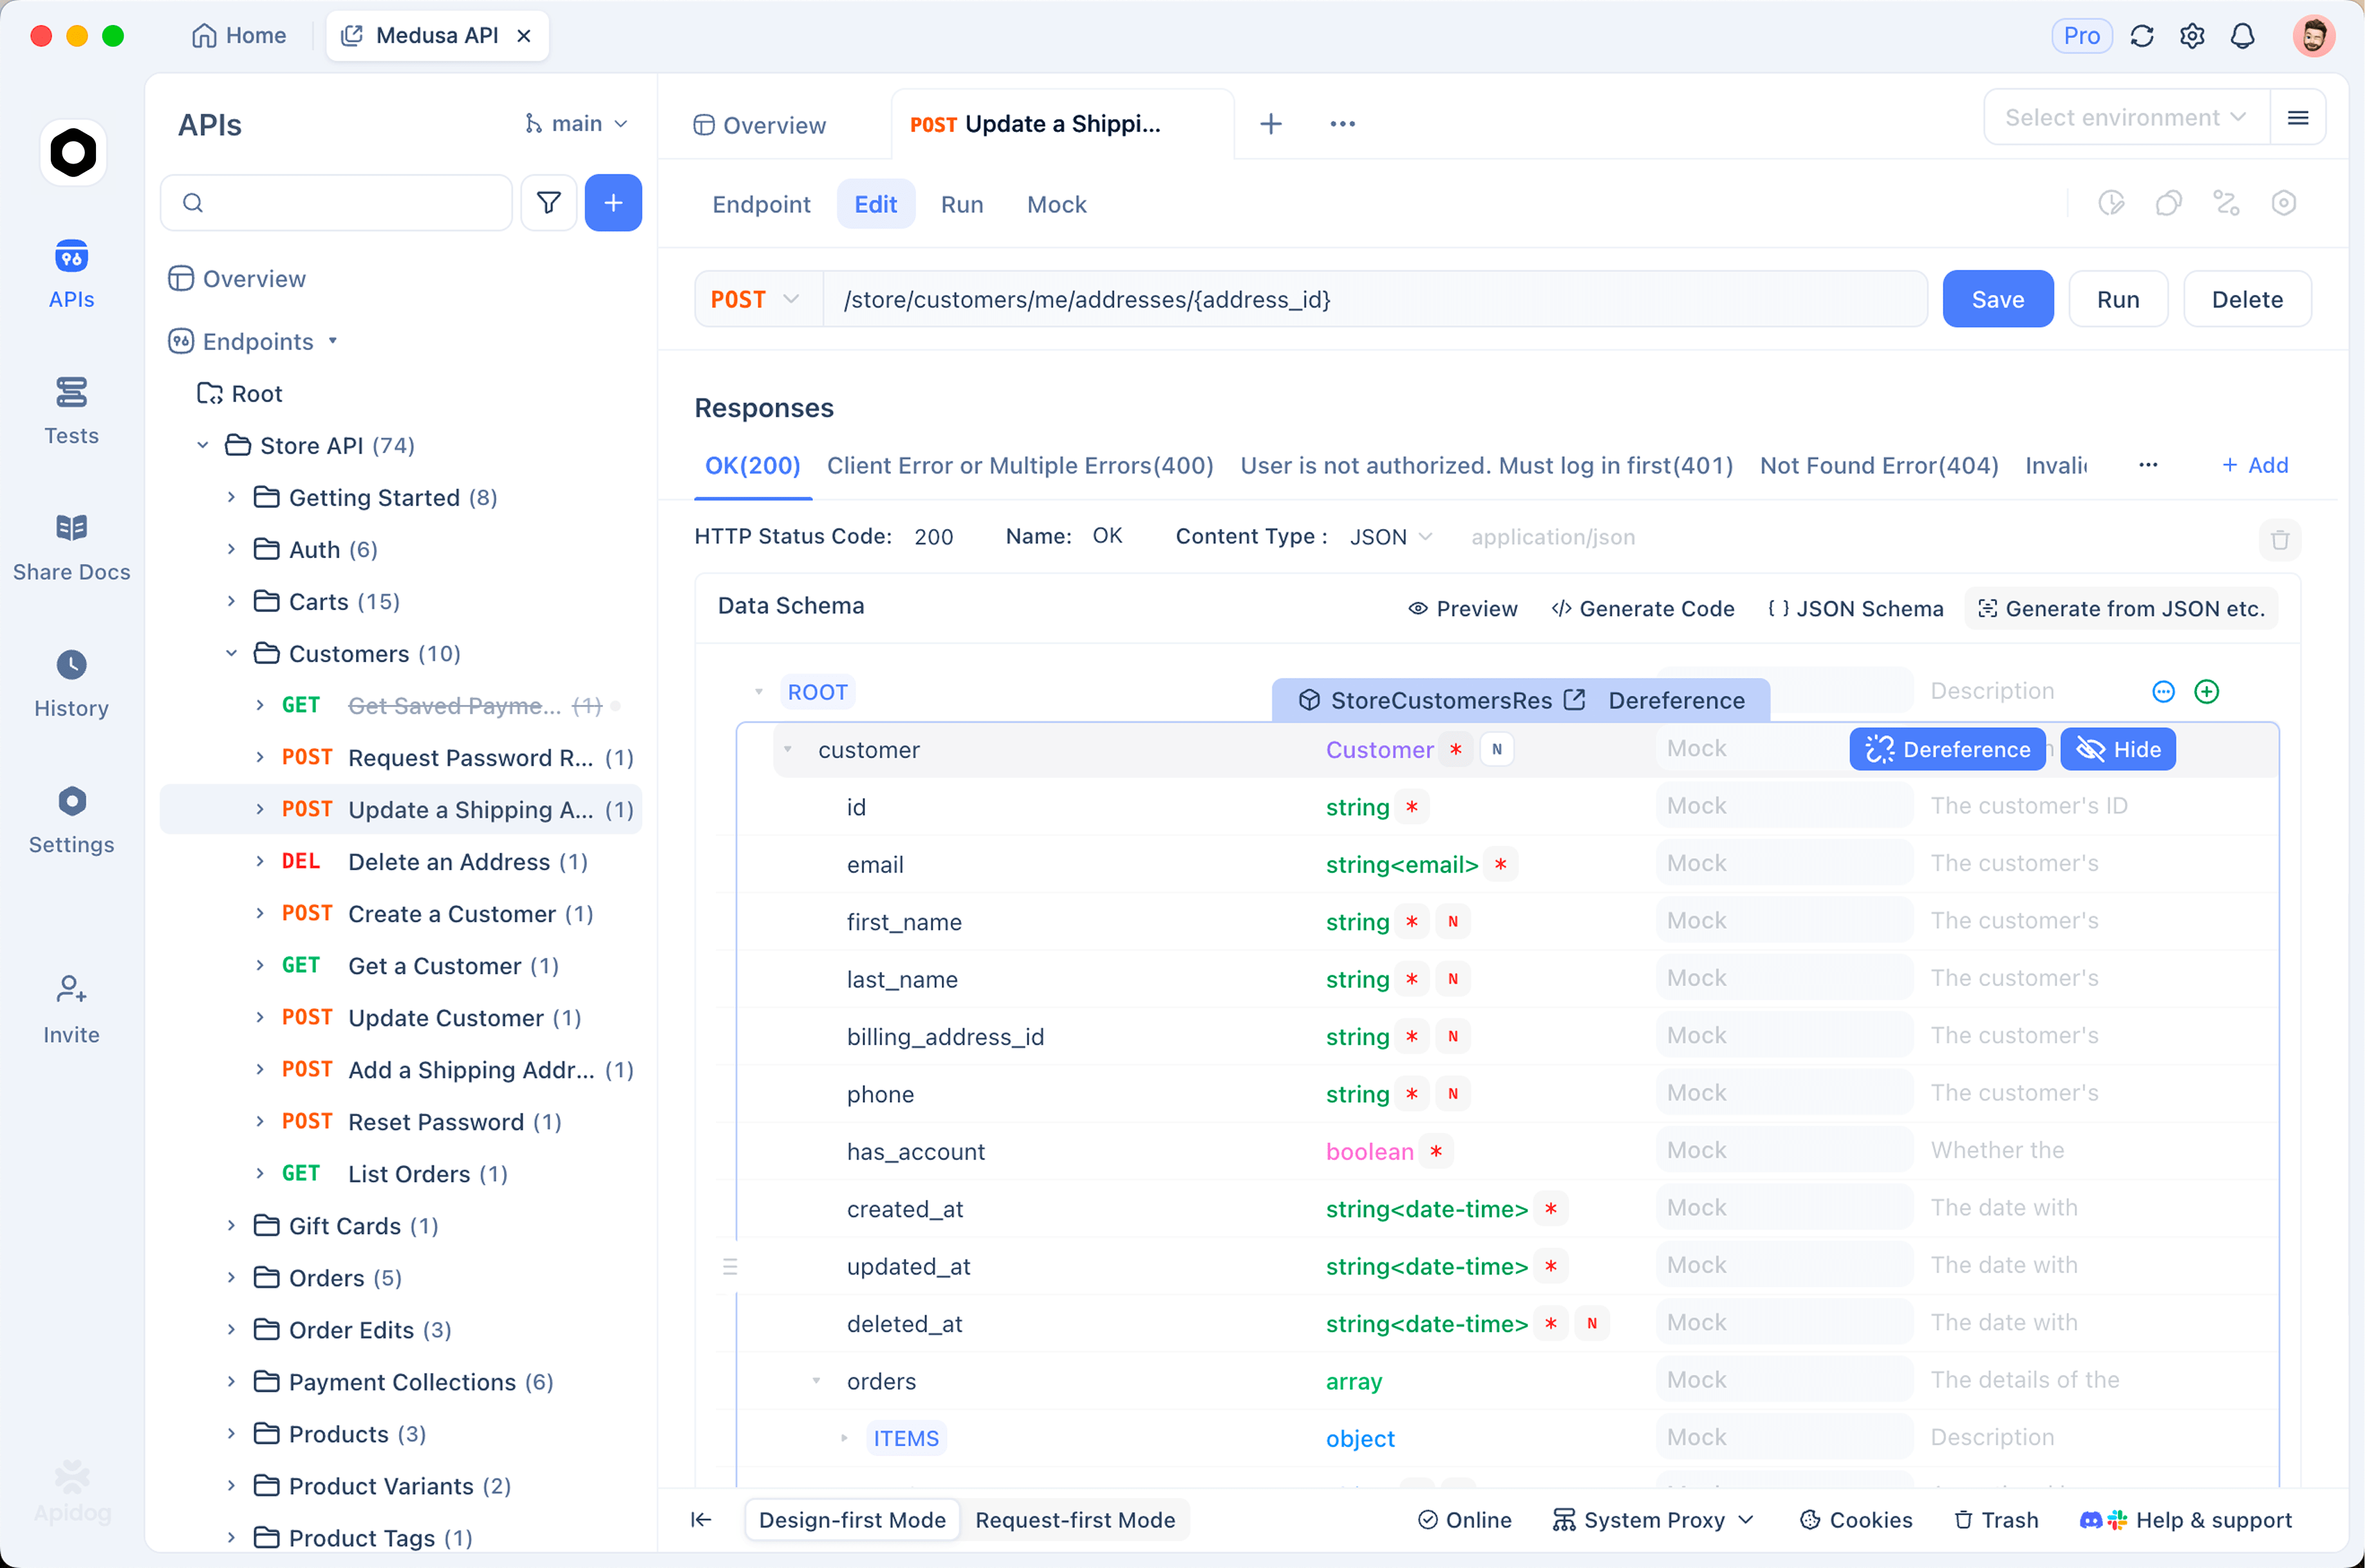
C'est là que la sauvegarde de la comparaison en tant que suite reproductible est payante. Dans Apidog, vous pouvez conserver les deux appels dans une seule collection avec l'ID du modèle comme variable d'environnement, attacher des assertions aux champs lus par votre application et tout réexécuter lorsque la réduction expire ou que Z.ai livre la prochaine révision. Un choix de modèle que vous pouvez retester en trente secondes est une décision que vous pouvez réexaminer ; un choix qui vit dans un historique de shell ne l'est pas.
FAQ
GLM-5.3-Flash est-il juste un GLM-5.3 plus petit ? Non. C'est un modèle de base entraîné séparément avec une architecture d'attention différente, pas une distillation ou une variante élaguée.
Ont-ils la même fenêtre contextuelle ? Oui, 1 048 576 jetons pour les deux.
Lequel est le meilleur pour le codage ? Flash obtient 84,3 sur Terminal-Bench 2.1 et 63,4 sur DeepSWE selon Z.ai, ce qui est fort. GLM-5.3 est un peu plus fort en raisonnement général. Pour les utilisateurs de forfaits de codage, le quota 3x est généralement décisif.
Puis-je passer de l'un à l'autre sans modifications de code ? Oui. Même point de terminaison compatible OpenAI, ID de modèle différent. Seule l'entrée d'image est exclusive à Flash.
Le modèle le moins cher restera-t-il bon marché ? Le prix reflète un cache KV plus petit et une consommation de calcul d'attention moindre plutôt qu'une promotion, donc l'avantage structurel devrait persister. La réduction de lancement supplémentaire de 50 % expire le 9 septembre 2026.