
L'API Gemini Decisions est un nouveau point de terminaison de Google qui répond à des questions fermées au lieu de générer du texte. Vous envoyez une entrée partagée (texte, images, audio, vidéo ou PDF) accompagnée de jusqu'à 1 000 questions typées, et Gemini Decision 1 (gemini-decision-1) renvoie une probabilité calibrée et un score de confiance pour chacune. Il coûte 0,10 $ par million de tokens d'entrée, la sortie fait toujours 0 token, et Google annonce une latence de 150 à 250 ms de bout en bout.
Google l'a lancée le 11 novembre 2026, en tant que point de terminaison v1beta. Pour une mise en pratique, consultez comment utiliser l'API Gemini Decisions.
Ce que Google a livré avec Gemini Decision 1
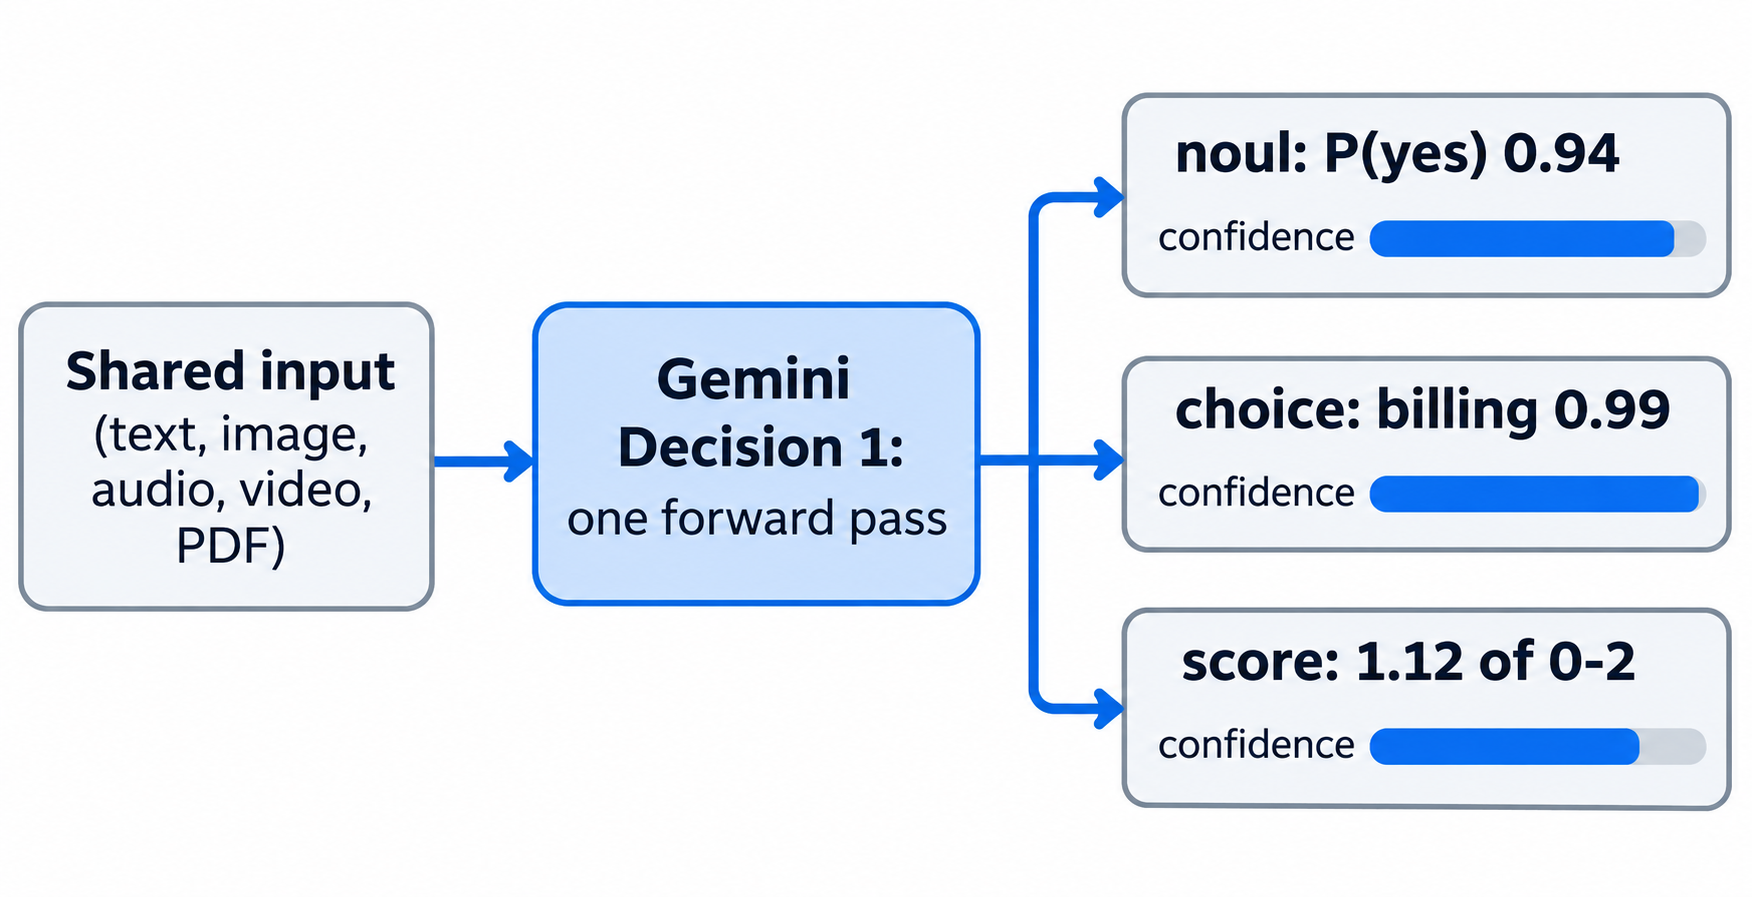
Gemini Decision 1 est un modèle qui note un ensemble fixe de réponses candidates en une seule passe, plutôt que de décoder du texte token par token. L'API Decisions l'expose, et votre code récupère des chiffres sur lesquels il peut se baser.
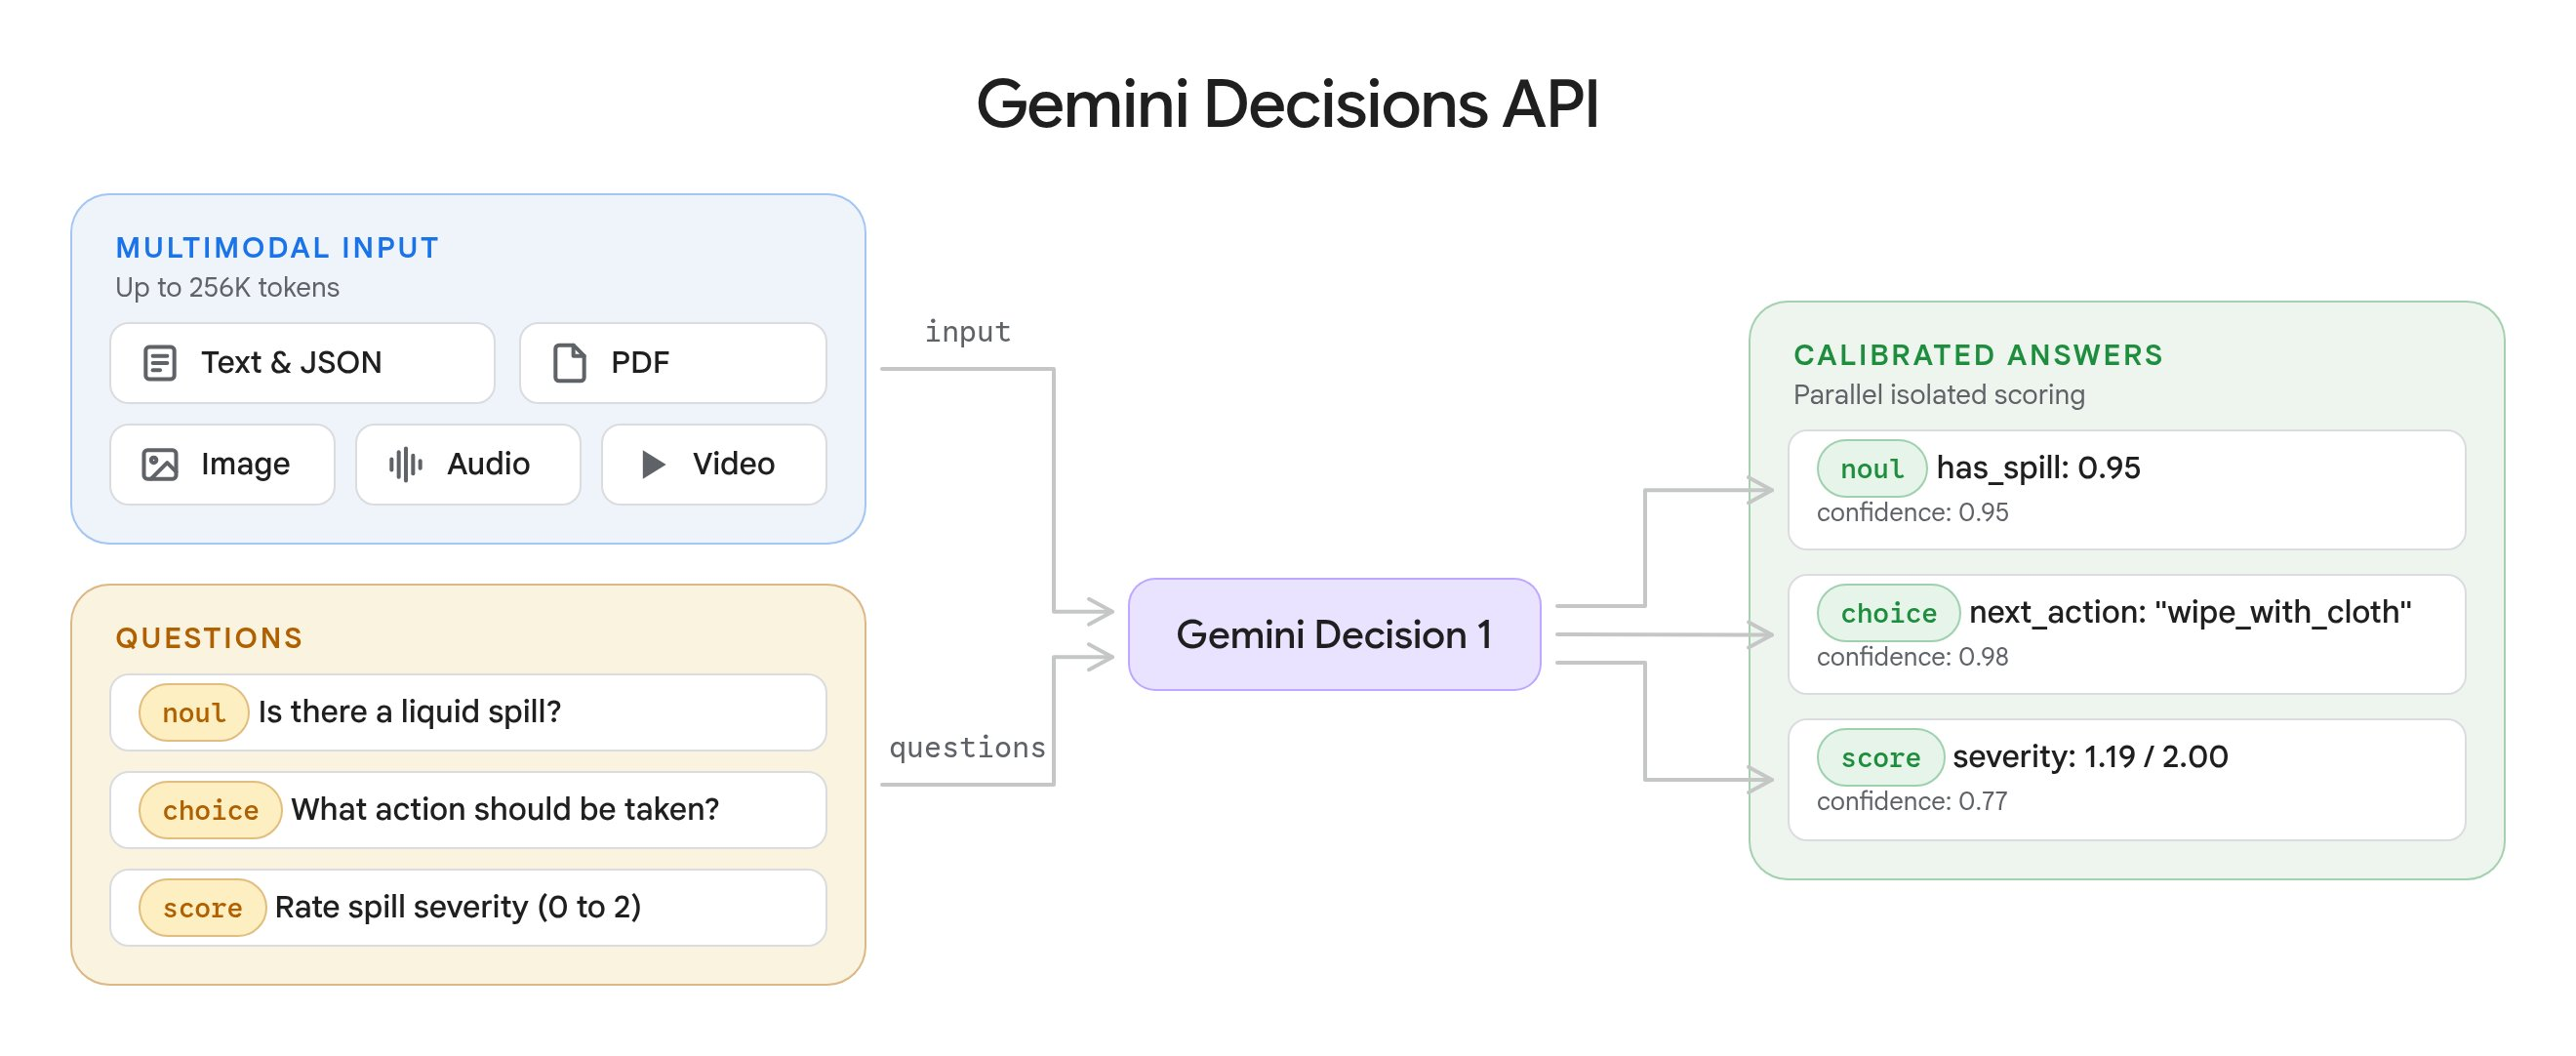
L'article de lancement, « Gemini Decisions API : Fast, calibrated multimodal decisions », énumère les points clés :
- ID de modèle
gemini-decision-1 Une entrée multimodale par requête, avec une fenêtre de contexte de 262 144 tokens partagée entre l'entrée et l'ensemble des questionsDe 1 à 1 000 questions indépendantes par requête, de trois types : noul, choice et score0,10 $ par million de tokens d'entrée, 0 $ en sortie, plus un palier gratuit pour le prototypagePrise en charge SDK dans google-genai 3.2 ou ultérieur (client.decisions.create(...)), avec des intégrationsOpenRouter, LangChain, Vercel AI SDK et LiteLLM en cours de déploiement
La prise en charge de Gemini dans Google Cloud (Vertex AI) est indiquée comme « à venir », donc aujourd'hui, il ne fonctionne que sur l'API Developer.
Pourquoi un point de terminaison de décision plutôt qu'un appel de chat
La plupart du code de « classification » appelle un modèle génératif, demande du JSON et analyse la réponse. Vous payez les tokens de sortie et de réflexion, et l'analyseur casse dès que le modèle se montre créatif.
L'API Decisions supprime l'étape de génération. La documentation de Google le dit clairement : elle « génère zéro token de texte, l'utilisation de tokens de sortie est donc toujours de 0 ». Trois choix de conception en découlent :
Notation parallèle et isolée. Chaque question est évaluée par rapport à l'entrée partagée en une seule passe. Les questions ne peuvent pas se voir entre elles, donc en ajouter ou en retirer une ne modifie pas les autres réponses.Valeur plus confiance. La valeur indique à votre code quoi faire. La confiance lui indique s'il doit le faire automatiquement ou escalader.Vérifications atomiques composées dans le code. Vous posez des questions étroites et combinez les réponses avec de simples instructions if et des pondérations.
Pour la génération de texte, l'extraction sous forme de schéma, les appels d'outils ou le raisonnement en plusieurs étapes, Google vous oriente toujours vers l'API Interactions.
Les trois types de questions
Chaque question possède un type, des instructions et, pour deux types, des criteria. Le modèle ne voit jamais les clés de vos questions : rédigez donc la question complète dans instructions.
| Type | Sert à | Critères | Renvoie |
|---|---|---|---|
noul |
Vérifier si une affirmation est vraie | true_description / false_description facultatifs |
noul (0,01 à 0,99), confidence |
choice |
Choisir une option dans une liste fixe | Map obligatoire d'ID d'option vers description, de 2 à 255 options | choice, probabilities (somme égale à 1), confidence |
score |
Noter l'entrée selon une grille ordonnée | Tableau de niveaux obligatoire, du plus bas au plus élevé, de 2 à 255 (2 à 10 recommandé) | score, probabilities, legend, confidence |
Quelques comportements sont bon à connaître avant d'écrire vos seuils :
noul n'atteint jamais 0 ni 1. Les probabilités restent entre 0,01 et 0,99 : un test « supérieur à 0,99 » ne correspondra jamais.Les clés choice sont triées par ordre alphabétique avant la notation : utilisez donc une clé fourre-tout comme other, et non none_of_the_above, qui se retrouverait en tête.choice répartit toujours la probabilité entre vos options, même quand aucune ne convient. Associez-le à une vérification de périmètre noul ou à un seuil de confiance.score est une moyenne pondérée des indices de niveaux : 1,12 signifie « principalement niveau 1, un peu niveau 2 ».
La confiance est définie de la même manière partout : la probabilité du résultat le plus probable, ou max(noul, 1 - noul) pour les questions oui/non.
Un exemple de requête et sa réponse
Le point de terminaison REST est POST https://generativelanguage.googleapis.com/v1beta/decisions, authentifié via un en-tête x-goog-api-key. Cette requête pose une question oui/non et une question à choix à propos d'un message du support client :
curl -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-decision-1",
    "input": "Audio cuts out on the left earcup. Fix it today or I cancel my membership.",
    "questions": {
      "is_defect": {
        "type": "noul",
        "instructions": "Does the message describe a hardware defect?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which department should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds.",
          "technical": "Problems using the product.",
          "shipping": "Delivery and tracking.",
          "other": "Anything outside these categories."
        }
      }
    }
  }'
La réponse contient deux champs de premier niveau, answers (indexés par vos identifiants de question) et usage :
{
  "answers": {
    "is_defect": { "type": "noul", "noul": 0.94, "confidence": 0.94 },
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": { "technical": 0.9, "other": 0.05, "billing": 0.03, "shipping": 0.02 },
      "confidence": 0.9
    }
  },
  "usage": { "total_input_tokens": 120, "total_output_tokens": 0, "total_tokens": 120 }
}
Les chiffres sont illustratifs, calqués sur les exemples de la documentation de l'API Decisions de Google.
Pour une entrée non textuelle, input devient un tableau de blocs de contenu utilisant le même schéma que l'API Interactions : text, image, audio, video et document (PDF). Les médias peuvent être en base64 en ligne (jusqu'à 100 Mo par requête), une URI de l'API Files ou une URL HTTPS (jusqu'à 15 Mo chacun). Les blocs image et vidéo acceptent un réglage resolution pour échanger du détail contre des tokens.
Si un filtre de sécurité sur les entrées bloque une requête, vous recevez un HTTP 400 avec un error.code tel que safety ou prohibited_content au lieu de answers.
Tarification, latence et limites de l'API Gemini Decisions
La tarification ne porte que sur l'entrée : 0,10 $ par million de tokens d'entrée sur le palier payant, gratuit sur le palier gratuit, et aucune ligne de sortie puisque la sortie fait toujours 0 token. Ces informations proviennent de la page de tarification de l'API Gemini Developer, vérifiée le 12 novembre 2026. La même page précise que le contenu du palier gratuit est utilisé pour améliorer les produits de Google, contrairement à celui du palier payant.
Deux détails de facturation comptent :
L'entrée partagée est facturée une seule fois par requête, quel que soit le nombre de questions. Chaque question n'ajoute que ses propres tokens d'instructions et de critères.Il n'y a pas de mise en cache de contexte, d'API Batch ni d'inférence Flex/Priority pour ce point de terminaison : la même entrée envoyée dans deux requêtes est facturée deux fois.
Ordre de grandeur : un ticket de support de 2 000 tokens avec 20 questions d'environ 40 tokens chacune représente environ 2 800 tokens d'entrée, soit environ 0,00028 $ par appel de décision sur le palier payant.
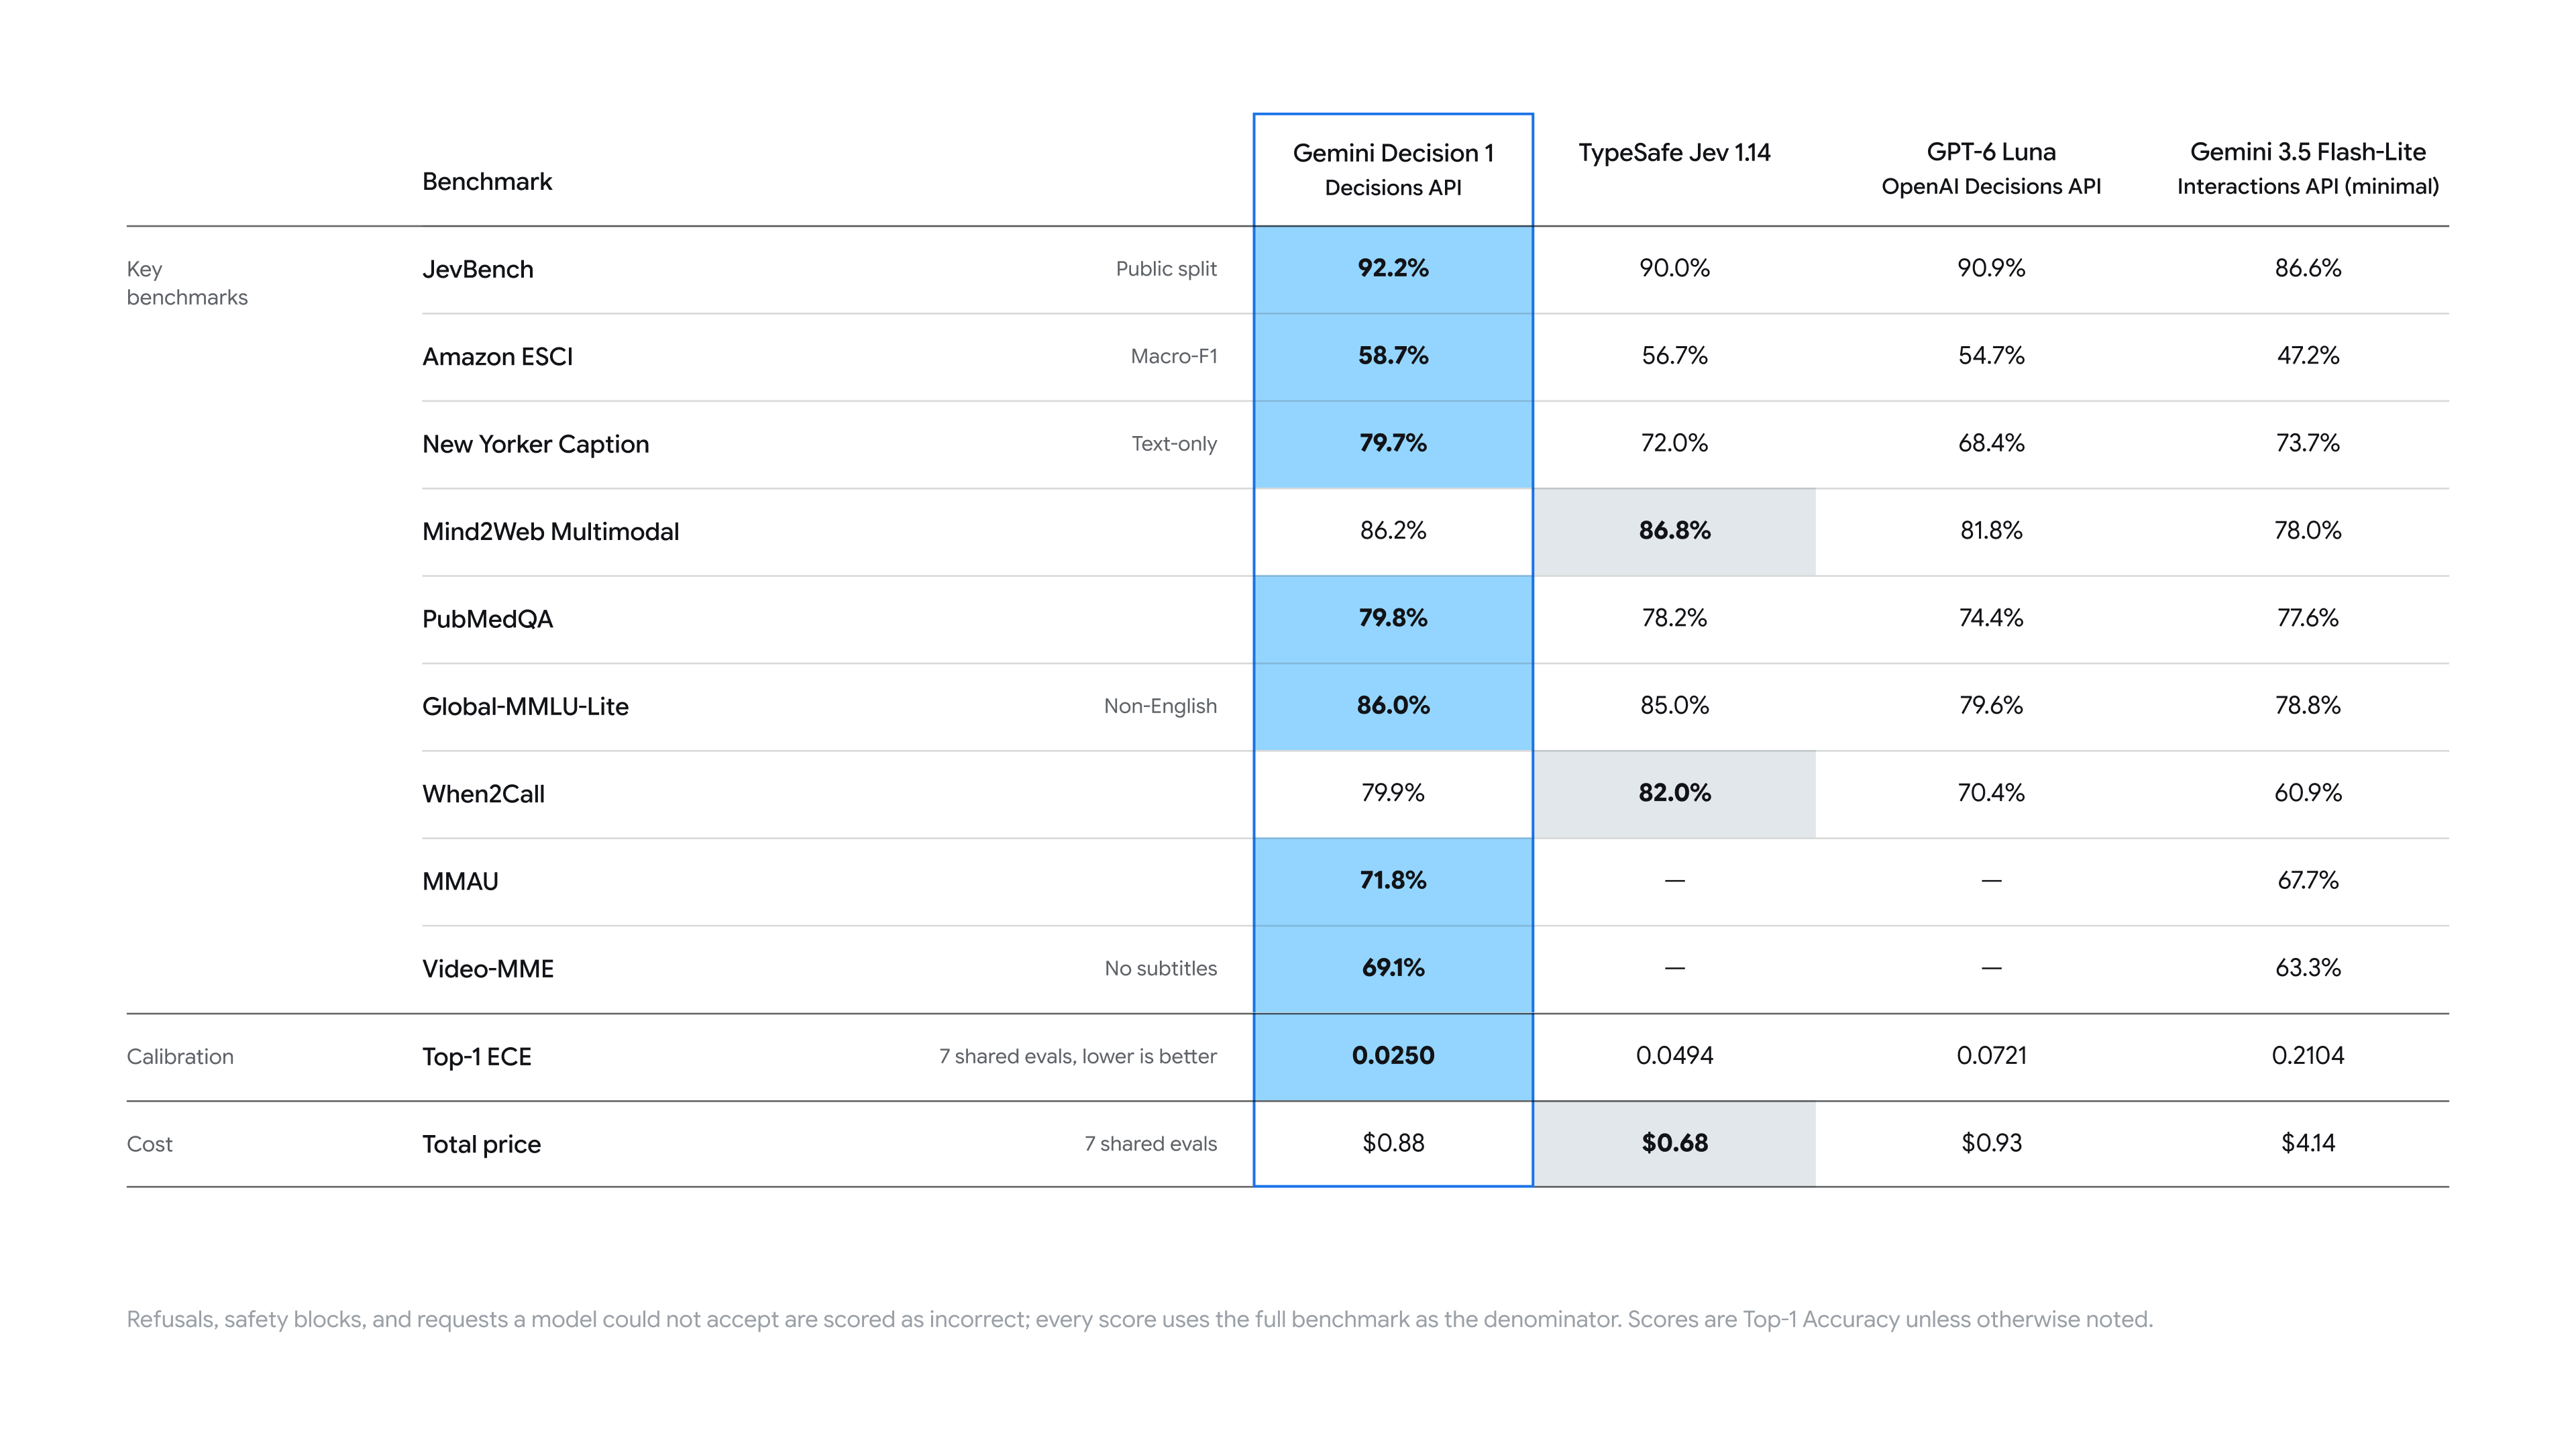
Les chiffres de latence sont ceux de Google : médiane de 50 à 100 ms de calcul du modèle, 150 à 250 ms de bout en bout, avec une durée quasi stable de 1 à 100 questions pour des entrées jusqu'à 16K tokens. Google revendique également l'erreur de calibration la plus faible sur sa suite de benchmarks et un coût presque 5 fois inférieur à celui de Gemini 3.5 Flash-Lite via l'API Interactions. Considérez ces chiffres comme des données fournisseur jusqu'à ce que vous mesuriez votre propre trafic.
Limites de débit issues de la page des limites de Google, vérifiée le 12 novembre 2026 :
| Palier d'utilisation | Requêtes/min | Tokens/min | Requêtes/jour |
|---|---|---|---|
| Gratuit | 200 | 50 000 | 10 000 |
| Palier 1 | 1 500 | 1 000 000 | 50 000 |
| Palier 2 | 5 000 | 4 000 000 | Illimité |
| Palier 3 | 15 000 | 10 000 000 | Illimité |
Le palier gratuit est détaillé dans Gemini Decisions API gratuitement.
Les cas d'usage de l'API Decisions
La documentation de Google identifie cinq modèles d'usage, auxquels correspondent des équipes internes :
Routage de modèles. Gemini Notebook route les requêtes vers un palier de modèle et un niveau de réflexion, avec une latence réduite jusqu'à 40 % sur les requêtes courantes, selon Google.Vérifications de règles. De nombreuses règles appliquées à une même entrée en un seul appel ; Google Search l'utilise comme couche de sécurité pour les outils MCP.Contrôle des agents. Quels outils charger, ou s'il faut compacter, escalader ou arrêter.Évaluation et classement. Noter des candidats ou des extraits récupérés selon une grille.Médias en temps réel. CC de Google Labs choisit un emoji parmi plus de 200 options.
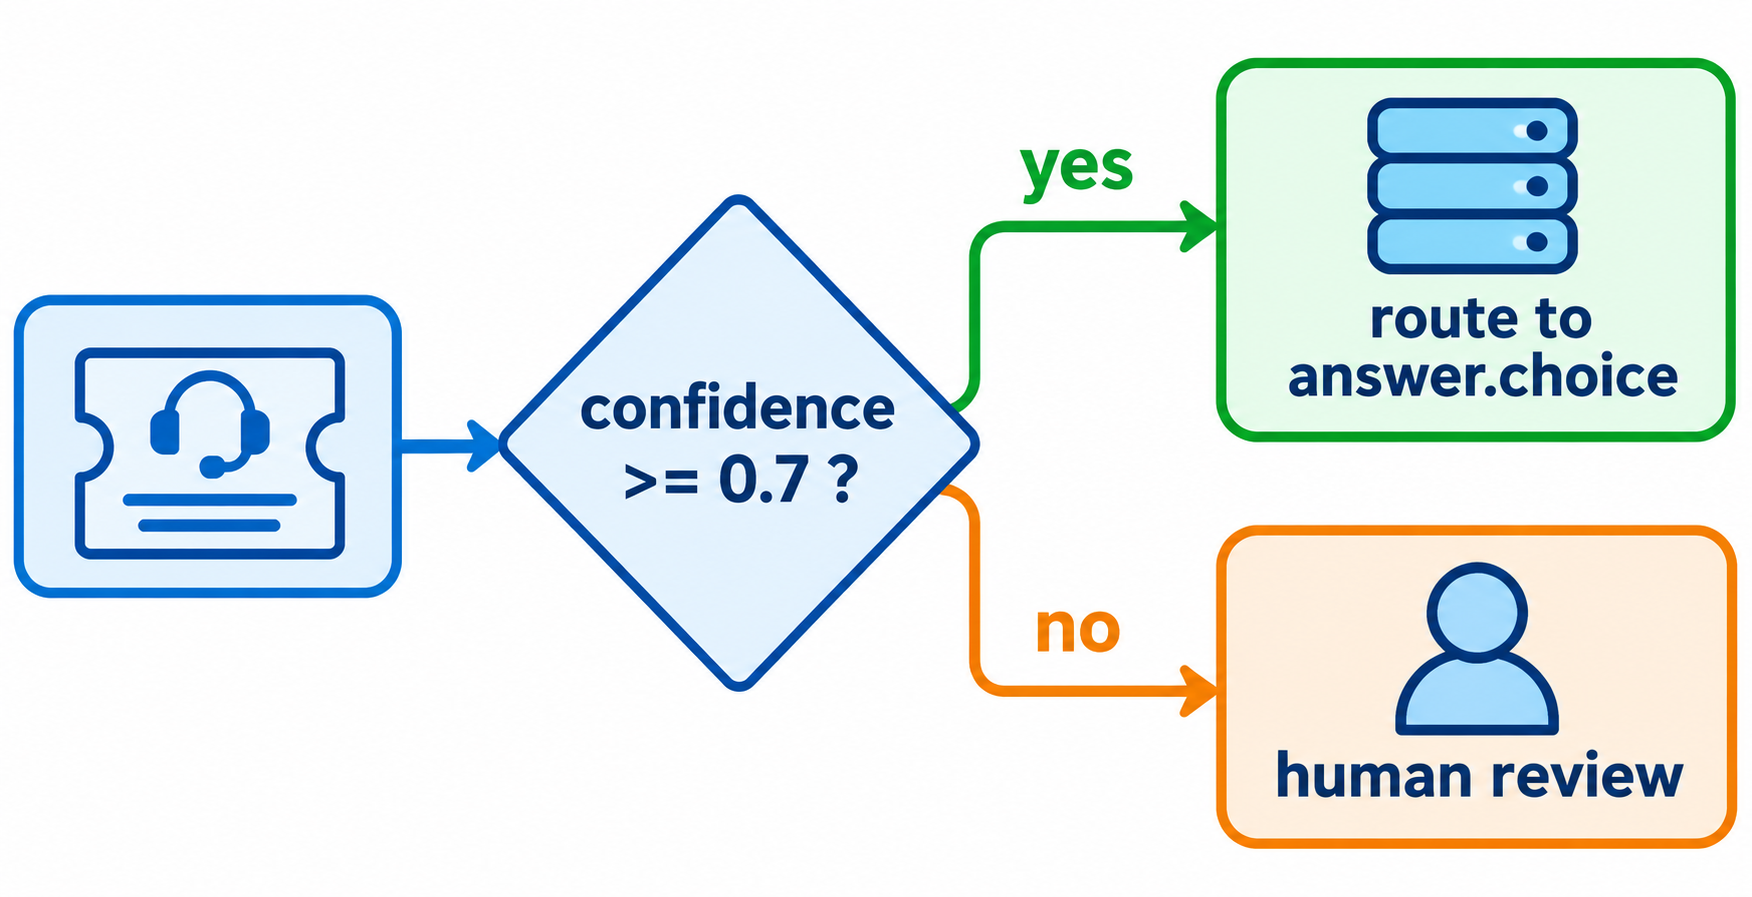
Les recommandations de Google sont de fixer ce seuil à partir d'exemples étiquetés de votre propre trafic, en pesant le coût d'un faux positif contre celui d'un faux négatif.
OpenAI a lancé un point de terminaison similaire en octobre sur GPT-6 Luna, avec des questions predicate, choice et score ; notre présentation de l'API Decisions d'OpenAI en parle. La comparaison détaillée des limites, modalités et tarifs se trouve dans Gemini Decisions API vs OpenAI Decisions API.
Limites et questions en suspens
Ce que la documentation indique aujourd'hui :
v1beta sur l'API Gemini Developer, avec Gemini Decision 1 uniquementLes instructions des questions sont textuelles uniquement ; les médias dans les questions ne sont pas pris en chargeL'historique de conversation, les blocs de réflexion et d'appels d'outils ne sont pas des entrées valides : sérialisez le contexte multi-tours en texte
Google n'a pas publié de date de disponibilité générale, de régions ni de conditions de résidence des données. Il avertit également que le texte des utilisateurs peut plaider en faveur de sa propre classification : gardez donc une vérification humaine sur les actions à enjeux élevés comme les paiements.
Testez-le avec votre agent de codage et Apidog CLI
Un point de terminaison de décision n'est utile que si son contrat est respecté : chaque confiance entre 0 et 1, chaque choice au sein de votre ensemble. Votre agent de codage peut écrire et exécuter ce test de régression avec Apidog CLI pendant que vous continuez à travailler.
Configuration en une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Donnez ensuite un seul prompt à votre agent :
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and a secret variable GEMINI_API_KEY.
Define POST /v1beta/decisions with header x-goog-api-key: {{GEMINI_API_KEY}}
and the support-ticket body from this article. Add a test case asserting:
status 200, usage.total_output_tokens == 0, every answers.*.confidence is
between 0 and 1, answers.department.choice is one of billing|technical|shipping|other,
and answers.is_defect.noul is between 0.01 and 0.99. Run it and summarize failures.
L'agent valide chaque charge utile par rapport à son schéma, puis crée et exécute le cas de test :
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <projectId> --file decisions-endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file decisions-case.json
apidog test-case create --project <projectId> --file decisions-case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Pour éviter que la clé soit enregistrée dans l'environnement, transmettez-la à l'exécution avec --env-var "GEMINI_API_KEY=..." à la place. La même commande apidog run avec -r junit s'intègre à votre CI ; la référence de la commande apidog run liste toutes les options, et Apidog CLI dans Claude Code montre la configuration complète de l'agent. Le plan Free d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
L'API Gemini Decisions est-elle gratuite ? Oui, dans les limites du palier gratuit : 200 requêtes par minute, 50 000 tokens par minute et 10 000 requêtes par jour. L'usage payant est facturé 0,10 $ par million de tokens d'entrée.
Combien de questions puis-je poser en une seule requête ? De 1 à 1 000, dans la limite de la fenêtre de contexte de 262 144 tokens partagée entre l'entrée et chaque question.
Que signifie noul ? C'est le type de question oui/non. Il renvoie la probabilité que la réponse soit oui, entre 0,01 et 0,99, ainsi qu'un score de confiance.
Peut-on l'utiliser sur Vertex AI ? Pas encore. Google indique que la prise en charge de Gemini dans Google Cloud est à venir ; aujourd'hui, c'est sur l'API Gemini Developer (v1beta).
Prend-il en charge le batch ou la mise en cache de contexte ? Non. La mise en cache de contexte, l'API Batch et l'inférence Flex ou Priority ne sont pas prises en charge : les entrées répétées sont facturées intégralement.