
Choisir entre l'API Decisions de Gemini et l'API Decisions d'OpenAI se résume aux entrées et aux limites, pas au prix. Toutes deux facturent 0,10 $ par million de tokens d'entrée et rien pour la sortie. Optez pour Gemini si vous avez besoin d'entrées audio, vidéo ou PDF, de plus de 400 questions par requête, ou d'un offre gratuite. Optez pour OpenAI si vous avez besoin d'un endpoint en GA, du prompt caching, de preuves JSON et d'appels d'outils, ou de conditions ZDR et HIPAA.
À quoi sert une API Decisions
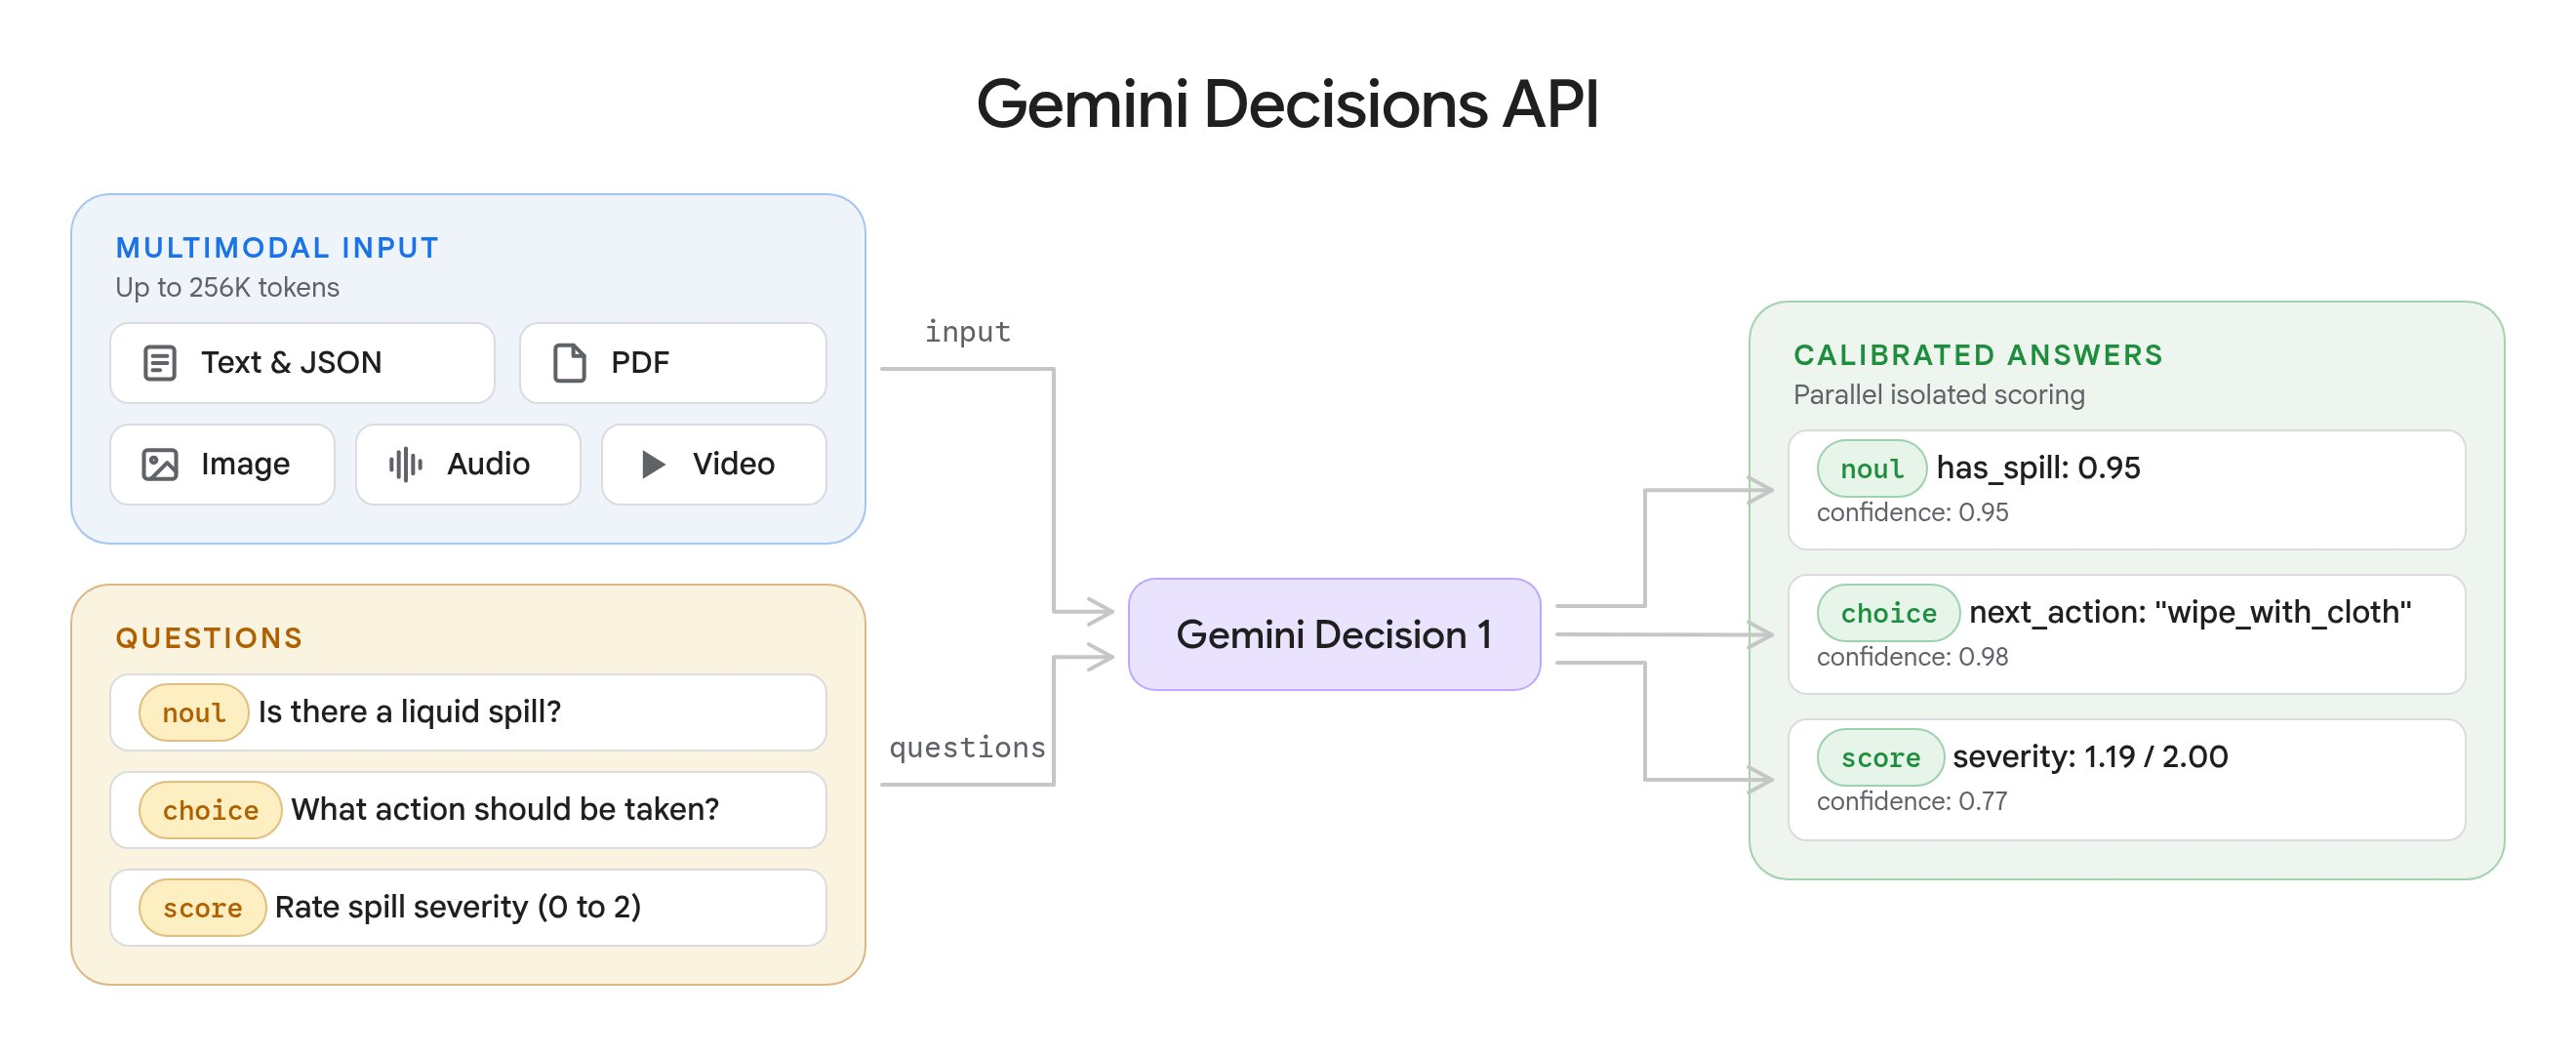
Une API Decisions est un endpoint qui répond à des questions à ensemble fermé sur votre entrée au lieu de générer du texte. Vous envoyez des preuves communes plus une liste de questions typées (oui/non, choix d'une option, notation sur une échelle) et vous recevez des probabilités et un score de confiance pour chaque réponse. Les tokens de sortie sont gratuits, vous ne payez donc que l'entrée.
OpenAI a lancé la première. Son API Decisions est passée en GA le 22 octobre 2026 avec gpt-6-luna. Google a répondu le 11 novembre 2026 avec l'API Decisions de Gemini, propulsée par un nouveau modèle, gemini-decision-1.
Toutes deux ciblent le routage, la sélection d'outils, les vérifications de politiques et la notation selon des grilles. Elles se différencient par ce que vous pouvez leur fournir et jusqu'où va une seule requête.
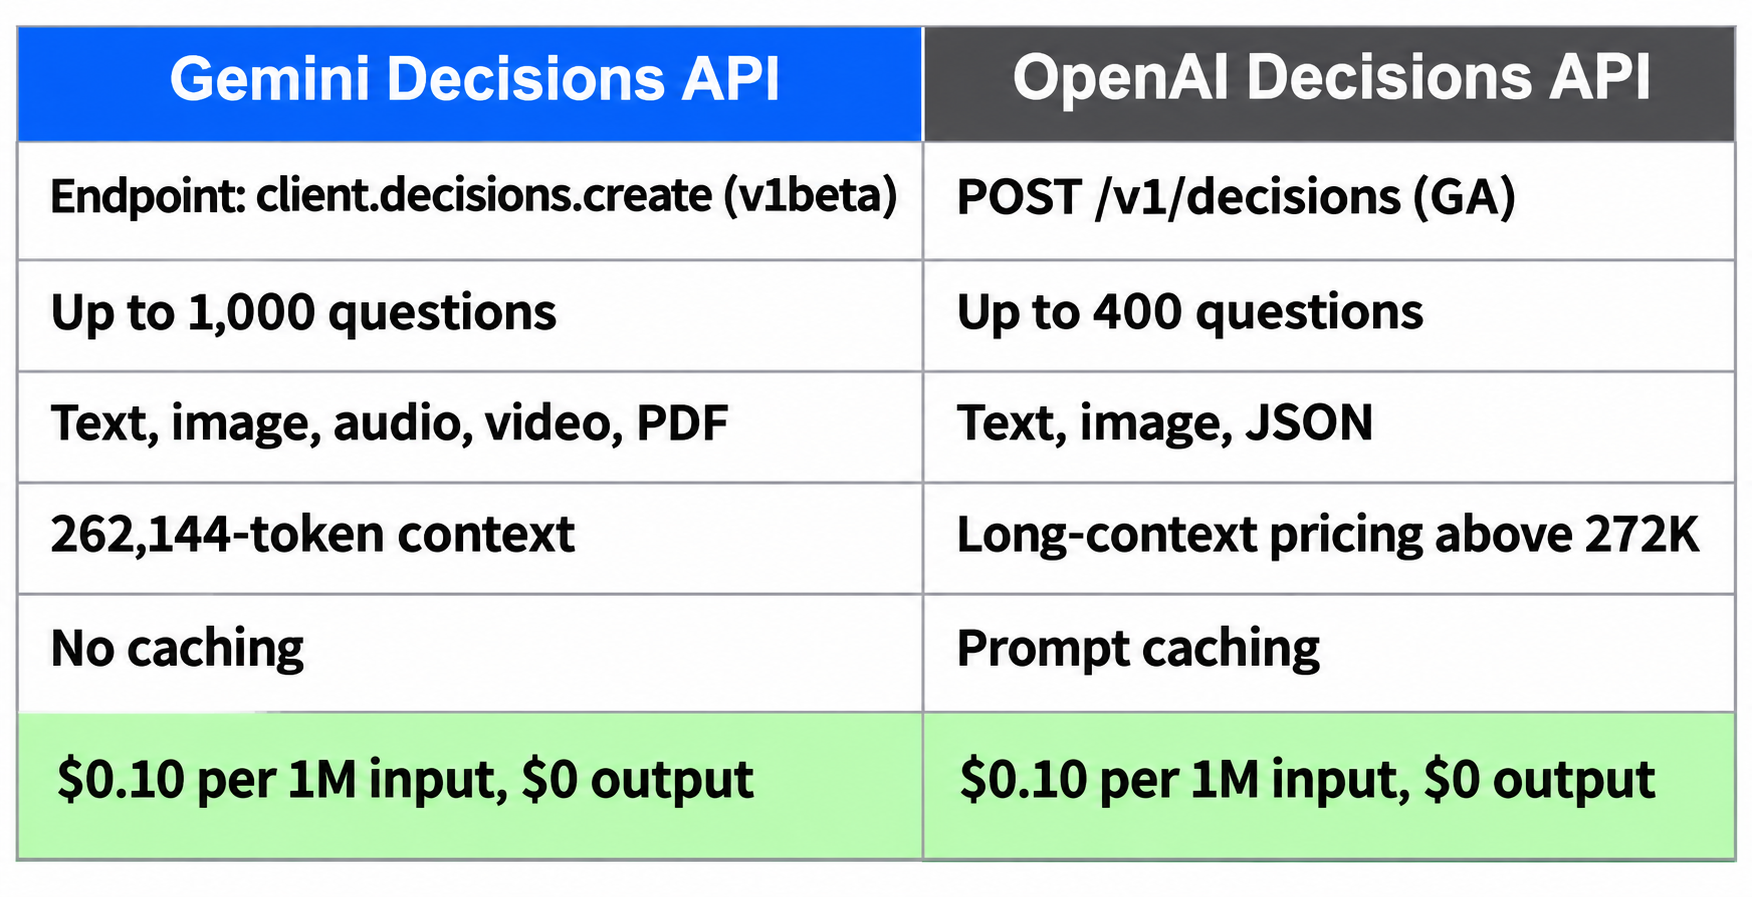
API Decisions de Gemini vs API Decisions d'OpenAI en un coup d'œil
Chaque ligne provient de la documentation de chaque fournisseur, consultée le 12 novembre 2026. « Non documenté » signifie que la documentation ne le précise pas.
| API Decisions de Gemini | API Decisions d'OpenAI | |
|---|---|---|
| Modèle | gemini-decision-1 (seule option) |
gpt-6-luna (seule option) |
| Statut | v1beta sur l'API Gemini Developer |
GA depuis le 22 octobre 2026 |
| Appel | client.decisions.create(...), SDK 3.2+ |
POST /v1/decisions |
| Questions par requête | 1 à 1 000 | 1 à 400 |
| Format des questions | Map indexée par vos propres identifiants | Tableau, chaque entrée avec un name facultatif |
| Type oui/non | noul (0,01 à 0,99) |
predicate (0 à 1) |
| Options de choix | 2 à 255 | 2 à 255 |
| Niveaux de score | 2 à 255 (2 à 10 recommandés) | 2 à 10 |
| Types d'entrée | Texte, image, audio, vidéo, PDF | Texte, image, input_json, appels d'outils et sorties |
| Médias dans le texte de question | Non, texte uniquement | Oui, images dans instructions |
| Fenêtre de contexte | 262 144 tokens | Non documenté pour cet endpoint ; tarification long contexte au-delà de 272K |
| Prix d'entrée | 0,10 $ / 1M | 0,10 $ / 1M (x2 au-delà de 272K) |
| Prix de sortie | 0 $ | 0 $ |
| Cache | Non pris en charge | Prompt caching, 0,01 $ / 1M de tokens d'entrée en cache |
| Batch / Flex | Non pris en charge | Non documenté |
| Offre gratuite | Oui, dans Google AI Studio | Non documenté pour cet endpoint |
| Latence publiée | 150 à 250 ms de bout en bout (chiffre de Google) | « Environ 10x plus rapide que l'API Responses » |
| Limites de débit | Publiées par niveau | Par organisation, non publiées par endpoint |
| ZDR / HIPAA | Non documenté | Pris en charge pour les clients éligibles |
| Traitement régional | Non documenté | États-Unis et UE, majoration de 10 % |
Format des requêtes : même idée, JSON différent
Les deux API se ressemblent jusqu'à ce que vous écriviez le payload. Gemini indexe les questions par vos propres identifiants et appelle son type oui/non noul :
result = client.decisions.create(
    model="gemini-decision-1",
    input="I was charged twice for my order.",
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this request?",
            "criteria": {"billing": "Payments and refunds.", "other": ""},
        },
    },
)
OpenAI prend un tableau ordonné, utilise predicate pour le oui/non et liste les choix comme des objets value et description. Notre guide pas à pas d'OpenAI contient la requête complète.
Trois différences comptent dans le code de production :
- Récupération des réponses. Gemini renvoie une map indexée par vos identifiants de question. OpenAI renvoie un tableau que vous faites correspondre par
name. - Refus. OpenAI peut renvoyer une réponse
refusalpour une question pendant que les autres reçoivent quand même des réponses. Gemini bloque toute la requête avec une erreur HTTP 400 et un codesafetyouprohibited_contentlorsque les filtres d'entrée se déclenchent. - Ordre des choix. Gemini trie les clés d'options par ordre alphabétique avant la notation, donc une clé comme
none_of_the_abovese retrouve avantshipping. Utilisezothercomme attrape-tout sur Gemini.
Les probabilités noul de Gemini se situent entre 0,01 et 0,99, donc un seuil > 0,99 ne se déclenche jamais. Le modèle de questions à trois types vous semblera familier si vous avez lu notre comparaison OpenAI vs Jev.
Entrées et limites : là où Gemini prend l'avantage
L'entrée de Gemini réutilise les blocs de contenu de l'API Interactions : text, image, audio, video et document (PDF). Combinez un enregistrement d'appel avec des métadonnées de compte et posez 1 000 questions dessus. Les données inline vont jusqu'à 100 Mo par requête (50 Mo pour les PDF) ; les URI de l'API Files et les URL HTTPS fonctionnent jusqu'à 15 Mo chacun. Les blocs image et vidéo acceptent un paramètre resolution pour échanger du détail contre des tokens.
OpenAI couvre moins de médias mais plus de structure. Selon le guide Decisions d'OpenAI, input accepte du texte, des images et des parties input_json, plus l'historique de conversation avec les appels de fonctions et leurs sorties. Les fichiers et l'audio ne sont pas pris en charge. Les instructions de chaque question peuvent contenir leur propre image, pratique pour comparer de nombreux candidats à une seule référence.
La répartition :
- Audio, vidéo ou PDF scannés comme preuves : Gemini.
- Transcripts d'appels d'outils ou JSON brut : OpenAI nativement ; Gemini exige une sérialisation en texte.
- Images par question : OpenAI uniquement.
Tarification : même étiquette, factures différentes
Toutes deux affichent 0,10 $ par million de tokens d'entrée sans frais de sortie, et toutes deux facturent l'entrée partagée une fois par requête. Les factures divergent sur l'entrée répétée.
La documentation de Gemini indique clairement que l'API Decisions ne prend pas en charge le context caching, Batch, Flex ni Priority, et que « l'entrée répétée entre les requêtes est facturée en totalité ». OpenAI a ajouté le prompt caching à la GA. Un préfixe d'input partagé d'au moins 1 024 tokens peut atteindre le cache à 0,01 $ par million, avec des écritures en cache facturées aux tarifs standard de Luna (0,125 $ par million pour les écritures de 30 minutes). Consultez la page de tarification d'OpenAI pour les tarifs actuels du cache.
Un exemple chiffré (notre calcul, pas un devis officiel) : chaque requête vérifie le même document de politique de 10 000 tokens avec 20 questions de 50 tokens chacune, un million de fois par mois.
- Gemini : 11 000 tokens x 1M de requêtes = 11 Md de tokens x 0,10 $ par million = 1 100 $.
- OpenAI, tous hits de cache : 10 Md de tokens en cache x 0,01 $ par million = 100 $, plus 1 Md de tokens de questions hors cache x 0,10 $ par million = 100 $, soit environ 200 $ plus les écritures en cache.
Avec une entrée fraîche à chaque requête, comme un nouveau ticket ou une nouvelle photo, le cache ne peut pas aider et les deux coûtent le même prix par token. OpenAI applique également un multiplicateur x2 au-delà de 272K tokens d'entrée et une majoration de 10 % pour le traitement régional.
L'avantage de Gemini est une offre gratuite. La page de tarification de Google liste l'entrée Gemini Decision comme « gratuit » dans AI Studio, mais les données de l'offre gratuite sont utilisées pour améliorer les produits de Google. Ce n'est pas le cas des données de l'offre payante.
Vitesse et limites de débit
Google affirme que Gemini Decision 1 évalue les options en une seule passe : 50 à 100 ms de calcul médian du modèle, 150 à 250 ms de bout en bout, quasiment constant de 1 à 100 questions, pour des entrées jusqu'à 16K tokens. Ce sont les affirmations de Google, à vérifier par vos propres mesures.
OpenAI publie un ratio, pas un chiffre : « environ 10x plus rapide que l'API Responses ». Notre analyse Decisions vs Responses API explique ce que cela signifie.
Les limites de débit suivent le même schéma. La page des limites de débit de Google liste les limites de Gemini Decision par niveau :
| Niveau | RPM | TPM | RPD |
|---|---|---|---|
| Gratuit | 200 | 50 000 | 10 000 |
| Niveau 1 | 1 500 | 1 000 000 | 50 000 |
| Niveau 2 | 5 000 | 4 000 000 | Illimité |
| Niveau 3 | 15 000 | 10 000 000 | Illimité |
OpenAI ne publie pas de limite spécifique à Decisions ; consultez la page des limites de votre organisation.
Quand choisir l'une ou l'autre
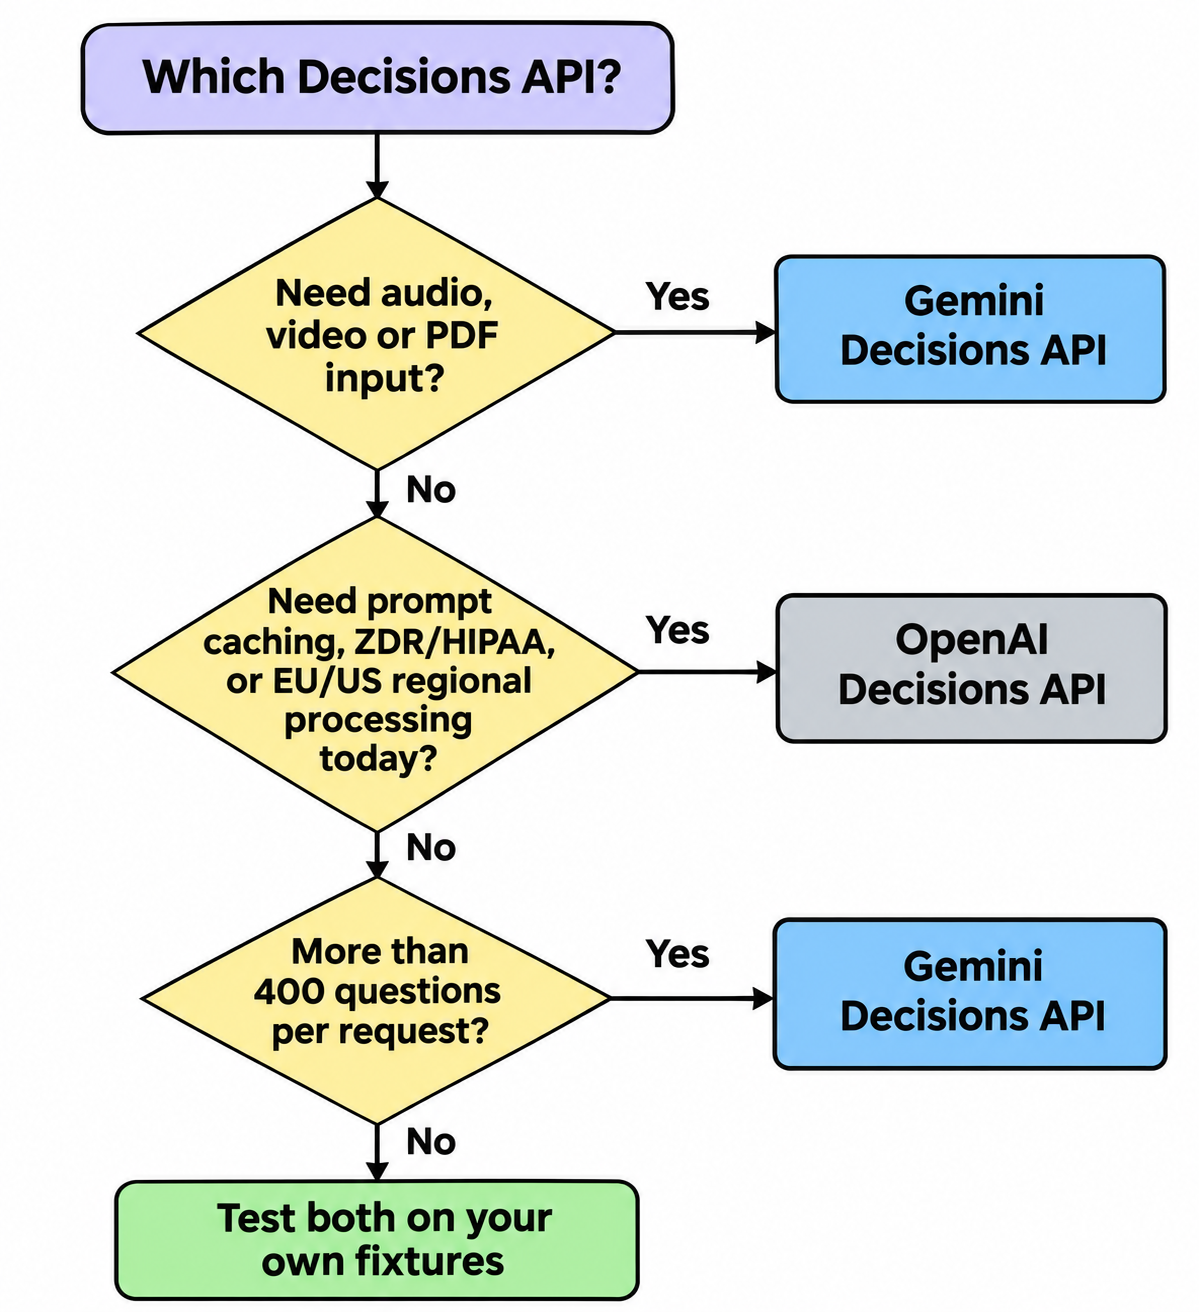
Choisissez l'API Decisions de Gemini lorsque :
- Vos preuves sont de l'audio, de la vidéo ou un PDF, sans étape de transcription ni d'OCR.
- Vous avez besoin de plus de 400 questions par requête.
- Vous voulez prototyper à 0 $ dans Google AI Studio.
Choisissez l'API Decisions d'OpenAI lorsque :
- Vous avez besoin d'un endpoint en GA dès aujourd'hui. Celui de Gemini est en
v1beta, et la prise en charge par Vertex AI arrive « bientôt ». - Vous réutilisez une grande entrée partagée et voulez que le cache réduise la facture.
- Vos preuves sont un historique d'agent avec des appels d'outils, ou du JSON brut.
- Vous avez besoin de ZDR, d'une éligibilité HIPAA, ou d'un traitement régional aux États-Unis et dans l'UE.
- Vous utilisez déjà GPT-6 Luna ou GPT-Live ; OpenAI documente un déclencheur natif GPT-Live pour Decisions.
Si aucun de ces critères ne tranche, testez les deux.
Laissez votre agent de code exécuter le test A/B avec Apidog CLI
Les benchmarks des fournisseurs ne montrent pas comment l'un ou l'autre modèle gère vos tickets. Un test A/B basé sur des jeux de données le montre, et votre agent de code peut le construire et l'exécuter avec Apidog CLI.
Configuration en une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Puis donnez un seul prompt à votre agent :
In Apidog project <id>, create two endpoints: Gemini Decisions
(take the REST path from Google's Decisions API docs, model
gemini-decision-1) and OpenAI Decisions (POST /v1/decisions,
model gpt-6-luna). Both ask the same "department" choice question
(billing, technical, shipping, other) about {{ticket}}.
Build a test scenario that calls both for each row of fixtures.csv,
asserts HTTP 200, saves each answer, confidence and response time,
and flags rows where the two answers disagree. Run it and summarize.
L'agent valide ses payloads, écrit les ressources et exécute le scénario une fois par ligne du jeu de données :
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file gemini-decisions.json
apidog endpoint create --project <id> --file gemini-decisions.json
apidog endpoint create --project <id> --file openai-decisions.json
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <id> --file decisions-ab.json
apidog run -t <scenarioId> --project <id> -e <envId> -d fixtures.csv -r cli,json
Le drapeau -d fournit une ligne CSV par itération, donc 200 tickets étiquetés deviennent 200 appels appariés, et le rapport JSON aligne les réponses, la confiance et le temps de réponse. Comparez-les à vos étiquettes et vous obtenez précision et latence sur vos propres données. Gardez les deux clés API dans l'environnement Apidog, pas dans le prompt. Consultez la référence de la commande apidog run et Apidog CLI dans Claude Code.
Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
L'API Decisions de Gemini est-elle moins chère que l'API Decisions d'OpenAI ? Pas au prix affiché : toutes deux facturent 0,10 $ par million de tokens d'entrée. OpenAI devient moins cher avec une grande entrée réutilisée (0,01 $ par million en cache). Gemini est moins cher pour le prototypage grâce à son offre gratuite.
L'API Decisions d'OpenAI peut-elle lire de l'audio ou des PDF ? Non. Elle accepte du texte, des images et du JSON. Gemini ajoute l'audio, la vidéo et les PDF.
L'API Decisions de Gemini est-elle prête pour la production ? Elle est livrée en v1beta ; la prise en charge par Google Cloud arrive « bientôt ». L'endpoint d'OpenAI est en GA depuis le 22 octobre 2026.
Combien de questions puis-je poser par requête ? Gemini autorise 1 à 1 000, dans la limite de sa fenêtre de contexte de 262 144 tokens. OpenAI autorise 1 à 400.
Puis-je passer de l'une à l'autre sans réécrire le code ? Pas directement : maps de questions vs tableaux, noul vs predicate, formats de choix différents. Placez une fine couche d'adaptation devant et testez les deux sur les mêmes jeux de données.